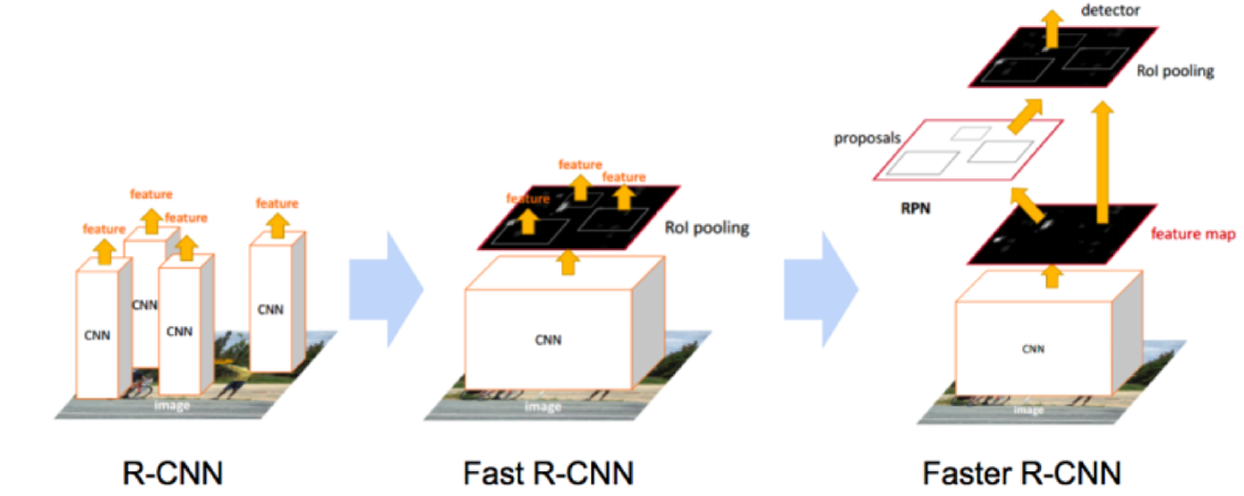
RCNN은 각각의 2000개의 region proposal을 가지고 CNN을 돌려야 하므로 굉장히 무겁고 느리다는 단점과
예측을 위한 세 가지 다른 모델, CNN, SVM, Bounding Box regression로 SVM과 regressors의 출력에 따라서 바로바로 update되지 않은 다단계의 파이프라인으로 복잡하다는 약점이 있었습니다
이에 대해서 Fast RCNN은 이미지 자체를 CNN으로로 바로 입력으로 넣음으로써 단 한번의 CNN계산을 통해 계산을 줄였으며
binary SVM대신 FC layer와 softmax를 활용해 어떤 class인지 구별해 내고 CNN Network로 추출한 feature vector를 bounding box regressor의 입력으로 사용하여서
하나의 입력(전체 이미지 + ROI)으로부터 feature 추출과
classification, bounding box regression을 하나의 모델에서 연산할 수 있어서 이와같은 문제점은 해결하였으나
기존 Fast R-CNN 모델은 여전히 Selective search 알고리즘을 통해 region proposals 추출하기 때문에 네트워크 외부에서 즉, CPU상에서 진행되므로 학습 및 detection 속도를 향상시키는데 한계가 있었습니다.
이 문제를 해결한 방법이 바로 Faster rcnn인데 설명에 앞서 이 Faster rcnn도 regional proposal자체가 시간이 걸린다는 단점과 2-stage detector로서
서로 다른 시스템이 차례로 작동하고 있기 때문에, 시스템의 성능은 이전 시스템이 어떻게 작동했는지에 달려 있다는 단점이 존재하고 이를 해결하기 위해 이후에 yolo와 같은 모델들이 나오는 것을 알 수 있습니다.
기존 Fast R-CNN 모델은 여전히 Selective search 알고리즘을 통해 region proposals 추출하기 때문에 네트워크 외부에서 즉, CPU상에서 진행되므로 학습 및 detection 속도를 향상시키는데 한계가 있었습니다.
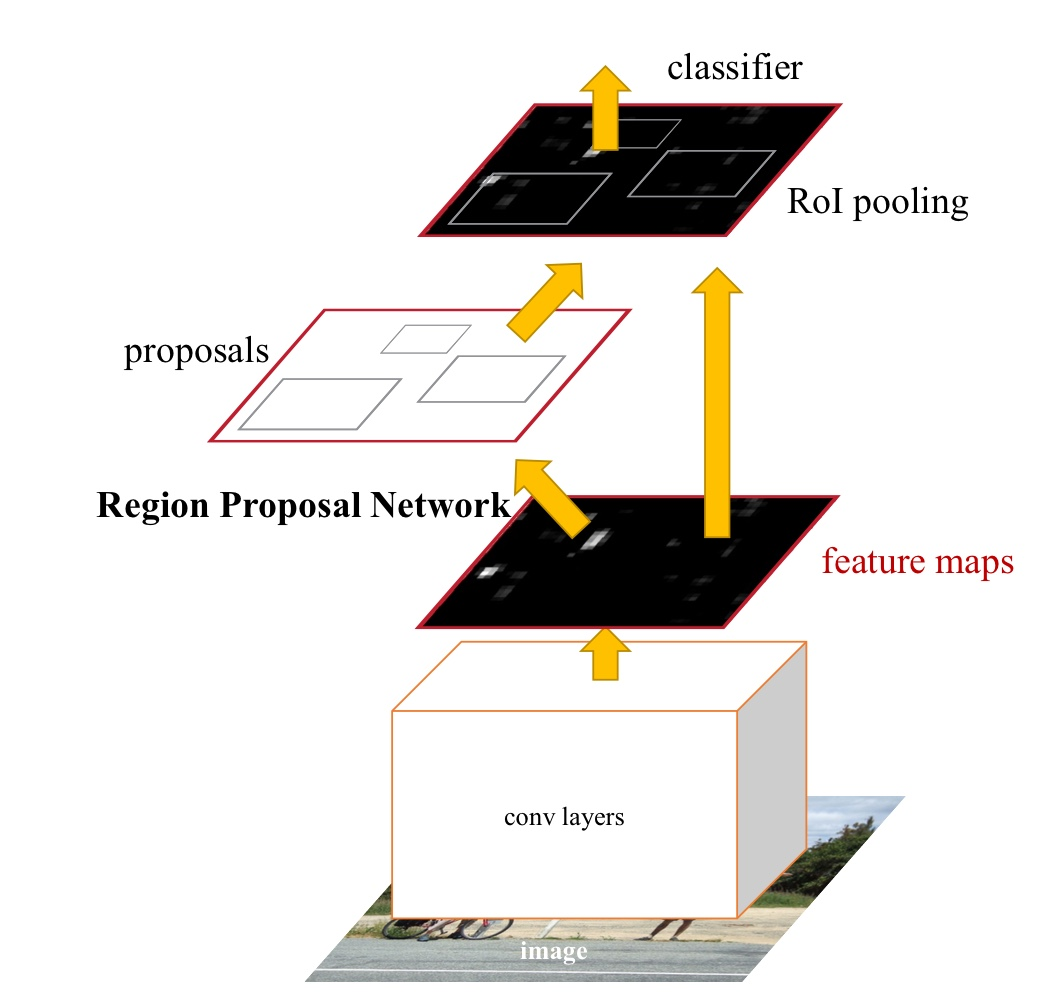
이러한 문제를 해결하고자 regional proposal 추출 작업을 수행하는 네트워크인 Region proposal network를 도입합니다. 이때 RPN즉, regional proposals를 보다 정교하게 추출하기 위해 다양한 크기와 가로세로비를 가지는 bounding box인 anchor box를 도입하여서 region proposals를 추출하기에 앞서 원본 이미지에 대하여 anchor box를 생성하는 과정이 수반되는 것을 생각할 수 있습니다. 그리고 간단하게 보면 RPN과 Fast RCNN이 합쳐진 모델이라고 볼 수 있습니다. RPN에서 region proposal를 추출하고 이를 Fast R-CNN 네트워크에 전달하여 객체의 class와 위치를 예측합니다. 이렇게 함으로써 모델의 전체과정이 GPU상에서 동작하여 end-to-end로 네트워크를 학습시키는 것이 가능해집니다.
순서로보면 다음과 같습니다.
1) 원본 이미지를 pre-trained된 CNN 모델에 입력하여 feature map을 얻습니다.
2) feature map은 RPN에 전달되어 적절한 region proposals을 산출합니다.
3) region proposals와 1) 과정에서 얻은 feature map을 통해 RoI pooling을 수행하여 고정된 크기의 feature map을 얻습니다.
4) Fast R-CNN 모델에 고정된 크기의 feature map을 입력하여 Classification과 Bounding box regression을 수행합니다.
이때,RPN은 원본 이미지에서 region proposals를 추출하는 네트워크입니다. 원본 이미지에서 anchor box를 생성하면 수많은 region proposals가 만들어집니다. RPN은 region proposals에 대하여 class score를 매기고, bounding box coefficient를 출력하는 기능을 합니다.
정리해서 다시보면 Faster RCNN의 가장 큰 특징을 보면 후보 영역 추출 작업을 수행하는 네트워크인 Region Proposal Network과 Anchor box입니다. RPN에서 region proposals를 추출하고 이를 Fast R-CNN 네트워크에 전달하여 객체의 class와 위치를 예측합니다. 이를 통해 모델의 전체 과정이 GPU 상에서 동작하여 병목 현상이 발생하지 않으며, end-to-end로 네트워크를 학습시키는 것이 가능해집니다.
Region Proposal Network(CNN)을 만드는데 이 RPN을 제일마지막에 있는 convolution layer에 삽입을 하게 되고
전단에서 CNN을 거쳐서 나온 이 Feature Map상에서 그림과 같은 3x3 sliding window를 가지고 slide를 시켜줍니다.
그렇게 함으로써 region proposal net을 생성을 하는 것인데, 이 region proposal net은 하나의 작은 convolution network이다
라고 생각을 할 수 있고,이것이 object냐 object가 아니냐에 대해서 classify를 해주고, 그리고 그 object의 location을 boundingbox를
통해서 regression을 통해 구해줍니다. 그래서 sliding window의 위치는 이미지에 대해서 localization정보를 제공하게 되는 것이고
box regression의 경우는 localization정보를 correction하게 해주는 즉, 보정해주는 역할을 하게 됩니다.
여기서 새로운 개념인 anchor-box의 개념이 나오는데 sliding window내에 존재하는 local window라고 생각할 수 있을 것 같고
논문에서의 sliding widow마다 각자다른 가로세로 비율의 9개의 anchor box가 존재.
각각의 anchor가 object인지 아닌지에 대해서 classify한 다음에 object일경우 해당 anchor를 ground truth object의 bounding box에
fit하도록 stretch를 해주는 방식을 취합니다.
따라서 regression은 anchorbox로부터 얼마나 떨어져있냐 하는 값을 우리에게 알려줄 것이고,
classification은 각각의 anchor가 object를 보이고 있는지에대한 확률을 우리에게 제공합니다.
9개의 anchorbox를 original image에 투영을 하는데 이때 featuremap의 point에 대응하는 image내의 point에 paste를 하는데
fast rcnn과 다르게 featuremap에서 image쪽으로의 투영을 하게됩니다.
정리를 하자면 4개의 loss가 발생하는 것을 알 수 있는데 region proposal network를 거친 곳에서는 classification loss에서는 각각의 region proposal
을 거친것이 object냐 아니냐에 대해서 알려주고,
Bounding-box regression loss에서는 convolution을 anchor상에 regression을 수행하게 되는 그렇게 함으로써 anchorbox로부터의
거리값을 주게되는 그런 결과를 도출하게 되는 것이고, ROIpooling을 거친 classification loss에서는 해당 object가 어떤 class인지 알려주고,
ROIpooling을 거친 boundingbox regression loss에서는 region proposal 상에서 보정 및 correction을 해주게 되는 것입니다.
testtime per image 0.2초정도 걸리는 것을 알 수 있습니다.
reference)
https://herbwood.tistory.com/10
https://www.youtube.com/watch?v=KT4iD6yiqwo
