[논문리뷰] YOLOv1
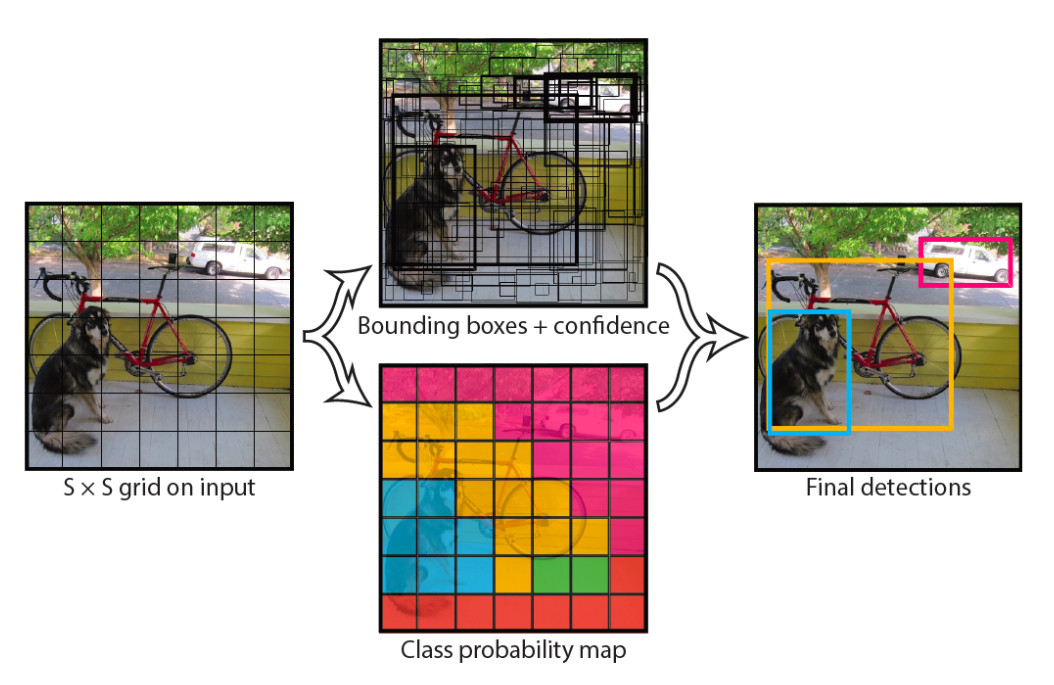
RCNN 계열의 2-stage detector는 region proposals와 같은 다양한 view를 모델에 제공하여 높은 정확도를 보여주고 있습니다.
하지만 region proposals를 추출하고 이를 처리하는 과정에서 많은 시간이 걸려 detection 속도가 느리다는 단점이 있습니다.
반면 YOLO v1은 detection을 regression으로 간주하는 1-stage detector로써 원본 이미지 전체를 통합된 네트워크로 처리하기 때문에
FPS를 개선하여 real-time에 가까운 detection 속도를 보였습니다.
YOLO v1은 localization과 classification을 하나의 문제로 정의하여 network가 동시에 두 task를 수행하도록 설계하였습니다.
이를 위해 이미지를 지정한 grid로 나누고, 각 grid cell이 한번에 bounding box와 class 정보라는 2가지 정답을 도출하도록 만들었습니다.
또한 각 grid cell에서 얻은 정보를 feature map이 잘 encode할 수 있도록 독자적인 Convolutional Network인 DarkNet을 도입합니다.
이를 통해 얻은 feature map을 활용하여 자체적으로 정의한 regression loss를 통해 전체 모델을 학습시킵니다.
이처럼 yolo는 이미지로부터 한번에 class와 bounding box를 예측하기 때문에 inference가 굉장히 빠르고
전체이미지를 보고 object detection을 수행하기 때문에 배경오류가 적고 일반화 성능이 좋습니다.
하지만 small object를 잘 탐지하지 못하는 등의 성능이 낮은 단점이 있습니다.
먼저 전체 이미지를 SxS 크기의 grid로 나눠줍니다. 각각의 grid cell은 B개의 bounding box와 해당 bounding box에 대한 confidence score를 예측합니다. confidence score는 해당 bounding box에 객체가 포함되어 있는지 여부와, box가 얼마나 정확하게 ground truth box를 예측했는지를 반영하는 수치입니다.
grid cell 내에 객체가 존재한다면 confidence score는 IoU 값과 같아지고, 객체가 존재하지 않는다면 confidence score는 0인 것을 식을 통해 알 수 있습니다.
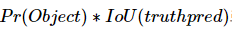
각각의 bounding box는 box의 좌표 정보(x, y, w, h)와 confidence score라는 5개의 예측값을 가집니다. 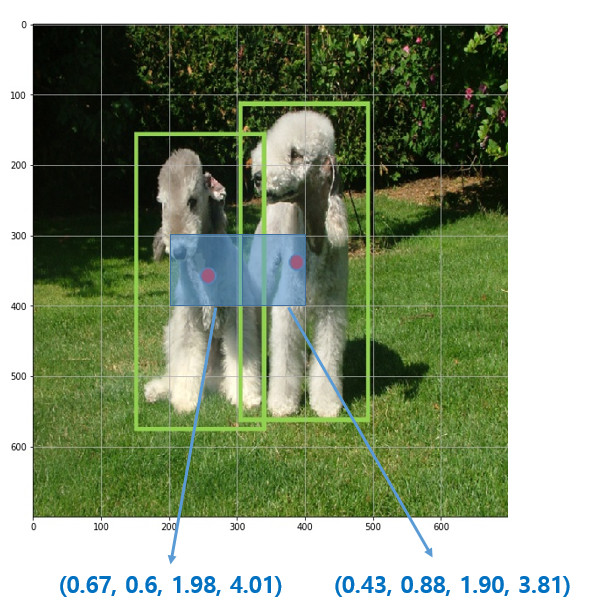
하나의 bounding box는 하나의 객체만을 예측하며, 하나의 grid cell은 하나의 bounding box를 학습에 사용합니다.
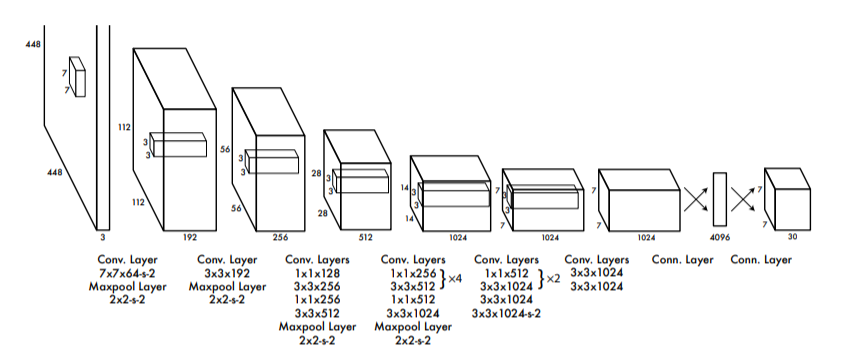
이후 모델이 detection task를 수행할 수 있도록 4개의 conv layer와 2개의 fc layer를 추가합니다. classification task를 위해 학습시켰을 때는 224x224 크기의 이미지,detection task를 위한 학습 시에는 이미지의 크기를 키워 448x448 크기의 이미지를 사용합니다.
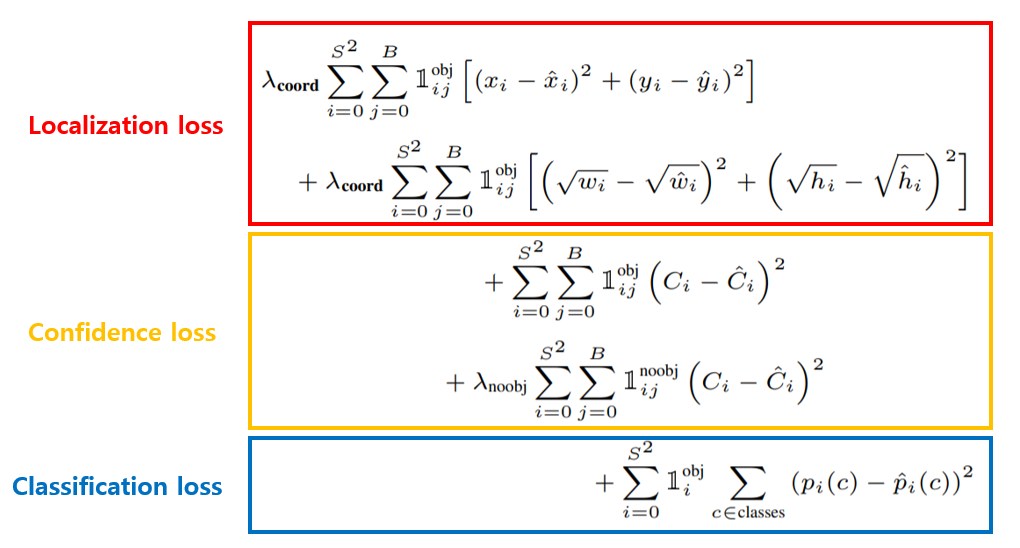
RCNN모델이 task에 맞게 서로 다른 loss function을 사용했던 것과 달리 YOLO v1 모델은 regression 시 주로 사용되는 SSE(Sum of Squared Error)를 사용합니다.
detection 시에는 최종 예측 결과에 Non Maximum Suppression 알고리즘을 적용합니다.
