1. SQL DML과 기본 쿼리 구조
1.1 DML(Data-Manipulation Language)
SQL의 DML은 테이블의 데이터를 다음과 같이 다룬다.
- 조회:
SELECT - 삽입:
INSERT - 수정:
UPDATE - 삭제:
DELETE
테이블 구조를 만드는 CREATE, 바꾸는 ALTER, 제거하는 DROP은 일반적으로 DDL(Data Definition Language) 로 분류한다.
2. SELECT 절
데이터를 조회, 검색할 때 사용하는 SELECT문이다.
2.1 기본 형식
SELECT A1, A2, ..., An  -- 속성
FROM r1, r2, ..., rm    -- 릴레이션
WHERE P; -- 조건| 절 | 질문 | 관계대수 관점 |
|---|---|---|
SELECT | 어떤 속성을 출력할 것인가? | Projection |
FROM | 어느 릴레이션에서 가져올 것인가? | 입력 릴레이션 / 카티션 곱 |
WHERE | 어떤 조건의 튜플을 남길 것인가? | Selection |
WHERE가 없으면 모든 튜플이 후보가 된다.- 최종 출력 열은
SELECT에 적은 속성으로 결정된다. - SQL 키워드와 일반적인 식별자는 보통 대소문자를 구분하지 않는다.
- 문자열 리터럴은 작은따옴표로 감싼다:
'Comp. Sci.'
2.2 원하는 열 조회
SELECT name
FROM instructor;
instructor 테이블에 실제로 존재하는 속성 이름을 사용해야 한다.
2.3 중복 처리: DISTINCT와 ALL
SQL은 기본적으로 중복 행을 유지한다.
-- 중복 학과명 제거
SELECT DISTINCT dept_name
FROM instructor;

-- 중복을 유지한다고 명시(기본 동작)
SELECT ALL dept_name
FROM instructor;| 표현 | 중복 처리 |
|---|---|
SELECT column | 유지 |
SELECT ALL column | 유지 |
SELECT DISTINCT column | 제거 |
2.4 모든 속성 조회
SELECT *
FROM instructor;- 는 해당 테이블의 모든 속성을 의미한다.
2.5 산술식 사용
SELECT ID, name, salary / 12
FROM instructor;SELECT안에서+, , ,/등의 산술 연산을 사용할 수 있다.- 위 쿼리는 연봉을 12로 나눈 값을 함께 출력한다.
- 원본 테이블의
salary값이 수정되는 것은 아니다.
3. WHERE 절
WHERE는 결과에 포함될 튜플의 조건을 지정한다.
SELECT name
FROM instructor
WHERE dept_name = 'Comp. Sci.'
  AND salary > 80000;
3.1 비교·논리 연산자
| 종류 | 연산자 |
|---|---|
| 비교 | =, <> 또는 !=, <, <=, >, >= |
| 논리 | AND, OR, NOT |
여러 조건은 논리 연산자로 결합한다. 복잡한 조건은 괄호로 우선순위를 명확히 표현하는 것이 좋다.
3.2 BETWEEN
SELECT name
FROM instructor
WHERE salary BETWEEN 90000 AND 100000;
BETWEEN a AND b는 양 끝값을 포함한다.- 위 조건은
salary >= 90000 AND salary <= 100000과 같다.
3.3 튜플 비교
SELECT name, course_id
FROM instructor, teaches
WHERE (instructor.ID, dept_name) = (teaches.ID, 'Biology');
두 튜플의 대응되는 모든 값이 같을 때 참이다. 다음 조건과 같은 의미다.
WHERE instructor.ID = teaches.ID
  AND dept_name = 'Biology'
4. FROM 절과 조인 기초
4.1 여러 테이블을 나열하면 카티션 곱
SELECT *
FROM instructor, teaches;instructor의 각 행과teaches의 각 행을 모두 조합한다.- 직접 사용할 때는 불필요한 조합이 매우 많으므로 보통 조인 조건과 함께 사용한다.
4.2 조인 조건으로 필요한 행만 선택
SELECT name, course_id
FROM instructor, teaches
WHERE instructor.ID = teaches.ID;
Relational Algebra 관점에서는 다음 순서다.
instructor × teaches로 모든 조합 생성instructor.ID = teaches.ID인 행만 선택name,course_id만 Projection
학과 조건을 추가할 수도 있다.
SELECT name, course_id
FROM instructor, teaches
WHERE instructor.ID = teaches.ID
  AND instructor.dept_name = 'Art';
4.3 모호한 열 이름 해결
두 테이블에 ID처럼 이름이 같은 속성이 있으면 테이블 이름을 붙여 구분한다.
instructor.ID
teaches.ID
현대적인 SQL에서는 같은 의미를 다음처럼 명시적
JOIN문법으로도 작성한다.SELECT i.name, t.course_id FROM instructor AS i JOIN teaches AS t ON i.ID = t.ID;
5. 이름 변경: AS
AS는 속성이나 릴레이션에 별칭(alias)을 붙인다.
5.1 열 별칭
SELECT ID, name, salary / 12 AS monthly_salary
FROM instructor;
5.2 테이블 별칭
SELECT T.name
FROM instructor AS T;- 표준 SQL과 여러 DBMS에서
AS를 생략할 수 있다:FROM instructor T
6. 문자열 연산과 패턴 검색
6.1 정확히 같은 문자열: =
WHERE dept_name = 'Comp. Sci.'6.2 패턴과 일치: LIKE
| 와일드카드 | 의미 |
|---|---|
% | 길이가 0 이상인 임의의 문자열 |
_ | 임의의 문자 정확히 1개 |
-- 이름에 dar가 포함
SELECT name
FROM instructor
WHERE name LIKE '%dar%';
패턴 예시는 다음과 같다.
| 패턴 | 일치하는 문자열 |
|---|---|
'Intro%' | Intro로 시작하며, Intro 자체도 포함 |
'%Comp%' | 중간 어디든 Comp를 포함 |
'___' | 정확히 3글자 |
'___%' | 3글자 이상 |
책에서는 패턴 비교가 대소문자를 구분한다고 설명한다.
하지만, 실제 동작은 DBMS와 collation 설정에 따라 달라질 수 있으므로 사용하는 환경을 확인해야 한다.
6.3 와일드카드 문자를 문자 그대로 검색
문자열 안의 % 자체를 찾고 싶다면 escape 문자를 지정한다.
WHERE some_text LIKE '100\%' ESCAPE '\';여기서 \%는 와일드카드가 아니라 문자 %를 뜻한다.
6.4 기타 문자열 함수
| 기능 | 예시 |
|---|---|
| 문자열 결합 | `first_name |
| 대문자 변환 | UPPER(name) |
| 소문자 변환 | LOWER(name) |
| 길이 | LENGTH(name) |
| 부분 문자열 | SUBSTRING(str, position, length) |
함수 이름과 세부 문법은 DBMS에 따라 조금씩 다를 수 있다.
7. 정렬: ORDER BY
릴레이션과 SQL 쿼리 결과에는 기본 순서가 없다. 원하는 순서를 보장하려면
ORDER BY를 써야 한다.
SELECT DISTINCT name
FROM instructor
ORDER BY name;ASC: 오름차순이며 기본값 (작은 것 → 큰 것)DESC: 내림차순
SELECT name
FROM instructor
ORDER BY name DESC;
여러 속성으로 정렬하면 왼쪽 속성부터 우선 적용한다.
SELECT dept_name, name
FROM instructor
ORDER BY dept_name ASC, name ASC;
참고: WHERE 절과 함께
WHERE와ORDER BY는 함께 사용할 수 있으며, 순서는WHERE가 먼저,ORDER BY가 나중이다.SELECT name FROM instructor WHERE dept_name = 'Comp. Sci.' ORDER BY name;
NULL의 정렬 위치는 DBMS와 정렬 방향에 따라 다를 수 있다. 필요하면 해당 DBMS가 지원하는 NULLS FIRST 또는 NULLS LAST를 명시한다.
8. 집합 연산
두 쿼리의 결과에 집합 연산을 적용할 수 있다.
| 연산자 | 의미 | 기본 중복 처리 |
|---|---|---|
UNION | 어느 한쪽에라도 있는 행 (합집합) | 제거 |
INTERSECT | 양쪽 모두에 있는 행 (교집합) | 제거 |
EXCEPT | 왼쪽 결과에만 있는 행 (차집합) | 제거 |
중복을 유지하려면 UNION ALL, INTERSECT ALL, EXCEPT ALL을 사용한다. 단, 일부 DBMS는 INTERSECT ALL이나 EXCEPT ALL을 지원하지 않을 수 있다.
8.1 2017년 가을 또는 2018년 봄에 개설된 과목 (UNION)
(SELECT course_id
 FROM section
 WHERE semester = 'Fall' AND year = 2017)
UNION
(SELECT course_id
 FROM section
 WHERE semester = 'Spring' AND year = 2018);
8.2 두 학기에 모두 개설된 과목 (INTERSECT)
(SELECT course_id
 FROM section
 WHERE semester = 'Fall' AND year = 2017)
INTERSECT
(SELECT course_id
 FROM section
 WHERE semester = 'Spring' AND year = 2018);
8.3 2017년 가을에는 열렸지만 2018년 봄에는 열리지 않은 과목 (EXCEPT)
(SELECT course_id
 FROM section
 WHERE semester = 'Fall' AND year = 2017)
EXCEPT
(SELECT course_id
 FROM section
 WHERE semester = 'Spring' AND year = 2018);
집합 연산을 하는 두 질의는 출력 열의 개수가 같고, 대응되는 열의 자료형이 서로 호환되어야 한다.
9. NULL
9. NULL의 의미
NULL은 다음과 같은 상태를 나타낸다.
- 값을 알 수 없음
- 값이 존재하지 않음
따라서 NULL은 숫자 0, 빈 문자열 '', 공백과 다르다.
9.2 산술 연산
NULL이 포함된 산술식의 결과는 NULL이다. (값을 알 수 없기 때문)
5 + NULL -> NULL9.3 NULL 확인
SELECT name
FROM instructor
WHERE salary IS NULL;NULL은 =로 비교하지 않는다.
-- 잘못된 방식
WHERE salary = NULL

-- 올바른 방식
WHERE salary IS NULL
WHERE salary IS NOT NULL
9.4 비교 결과는 UNKNOWN
따라서, NULL과 일반 비교 연산을 하면 결과는 참이나 거짓이 아니라 UNKNOWN이다.
5 < NULL      -> UNKNOWN
NULL = NULL   -> UNKNOWN
NULL <> NULL  -> UNKNOWN
9.5 3값 논리표
| 식 | 결과 |
|---|---|
UNKNOWN OR TRUE | TRUE |
UNKNOWN OR FALSE | UNKNOWN |
UNKNOWN OR UNKNOWN | UNKNOWN |
TRUE AND UNKNOWN | UNKNOWN |
FALSE AND UNKNOWN | FALSE |
UNKNOWN AND UNKNOWN | UNKNOWN |
NOT UNKNOWN | UNKNOWN |
판단 요령은 다음과 같다.
OR에서 한쪽이TRUE이면 다른 값과 관계없이TRUEAND에서 한쪽이FALSE이면 다른 값과 관계없이FALSE- 나머지 경우에는 모르는 값 때문에 결과를 확정할 수 없어
UNKNOWN WHERE에서 조건 결과가UNKNOWN인 행은 결과에 포함되지 않는다.
10. 집계 함수
집계 함수는 한 열의 여러 값을 입력받아 하나의 값을 반환한다.
| 함수 | 의미 |
|---|---|
AVG() | 평균 |
MIN() | 최솟값 |
MAX() | 최댓값 |
SUM() | 합계 |
COUNT() | 개수 |
10.1 평균
SELECT AVG(salary)
FROM instructor
WHERE dept_name = 'Comp. Sci.';
10.2 중복을 제거한 개수
2018년 봄에 수업한 서로 다른 교수의 수를 센다.
SELECT COUNT(DISTINCT ID)
FROM teaches
WHERE semester = 'Spring' AND year = 2018;
교수 한 명이 여러 과목을 가르칠 수 있으므로 DISTINCT ID가 필요하다.
10.3 전체 튜플 수
SELECT COUNT(*)
FROM course;
집계 결과가 값 하나뿐이어도 SQL 관점에서는 1행 1열의 릴레이션이며, 그 하나의 값은 스칼라 값이라고 볼 수 있다.
11. 그룹화: GROUP BY
전체 테이블이 아니라 그룹별 통계를 구할 때 사용한다.
SELECT dept_name, AVG(salary) AS avg_salary
FROM instructor
GROUP BY dept_name;
처리 개념은 다음과 같다.
dept_name이 같은 행끼리 그룹을 만든다. (기준이 되는 그룹 선택)- 각 그룹의
salary평균을 구한다. - 학과명과 해당 평균을 한 행으로 출력한다.
교수가 한 명도 없는 학과는 instructor에 그룹 자체가 없으므로 결과에 나타나지 않는다.
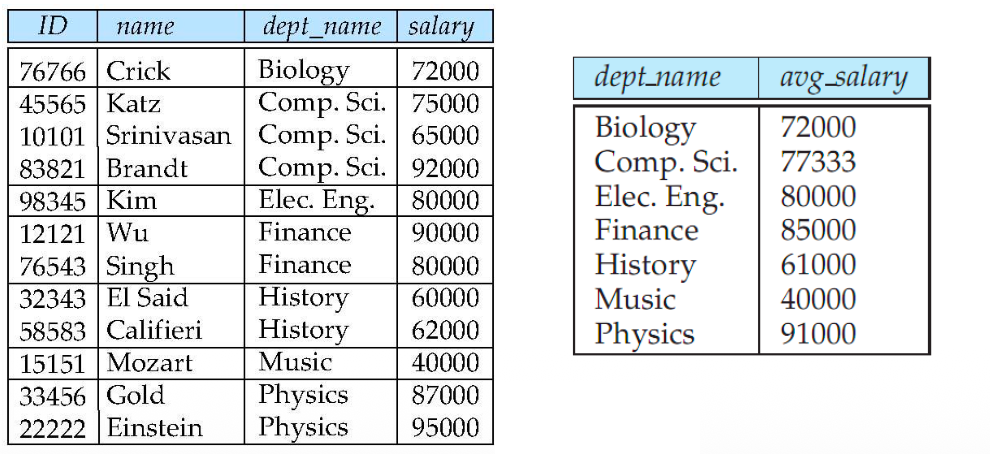
- 오른쪽이
GROUP BY를 통해avg_salary(학과 별 평균 급여) 를 뽑아낸 결과이다.
11.1 중요한 규칙
SELECT에 있는 열 중 집계 함수 밖에 있는 열은 반드시 GROUP BY에도 있어야 한다.
-- 잘못된 질의: ID는 그룹마다 여러 값일 수 있음
SELECT dept_name, ID, AVG(salary)
FROM instructor
GROUP BY dept_name;
올바른 형태는 다음과 같다.
SELECT dept_name, AVG(salary)
FROM instructor
GROUP BY dept_name;
12. 그룹 조건: HAVING
HAVING도 조건이지만, 그룹에 대해서 조건을 건다는 점에서WHERE과 쓰임새가 다르다.
예) 평균 급여가 42,000보다 큰 학과만 찾는다.
SELECT dept_name, AVG(salary) AS avg_salary
FROM instructor
GROUP BY dept_name
HAVING AVG(salary) > 42000;WHERE와 HAVING 비교
| 절 | 적용 시점 | 필터 대상 |
|---|---|---|
WHERE | 그룹을 만들기 전 | 개별 행 |
HAVING | 그룹을 만든 후 | 그룹 / 집계 결과 |
SELECT dept_name, AVG(salary) AS avg_salary
FROM instructor
WHERE salary IS NOT NULL
GROUP BY dept_name
HAVING AVG(salary) > 42000
ORDER BY avg_salary DESC;
이 쿼리는 먼저 급여가 있는 행만 남기고, 학과별 그룹을 만든 뒤, 평균이 42,000보다 큰 그룹만 골라 평균의 내림차순으로 정렬한다.
13. 집계 함수와 NULL
SELECT SUM(salary)
FROM instructor;COUNT(*)를 제외한 집계 함수는 집계 대상 열의NULL을 무시한다.COUNT(column)은 해당 열이NULL이 아닌 행만 센다.COUNT(*)는 열 값과 관계없이 행 자체를 센다.SUM,AVG,MIN,MAX에 입력할NULL이 아닌 값이 하나도 없으면 결과는NULL이다.NULL과 숫자0은 다르다.NULL은 평균 계산에서 제외되지만0은 실제 값으로 계산된다.
| 표현 | 세는 대상 |
|---|---|
COUNT(*) | 모든 행 |
COUNT(salary) | salary IS NOT NULL인 행 |
COUNT(DISTINCT ID) | NULL이 아닌 서로 다른 ID |
여기까지가 SELECT 문에 대한 기본 개념이고, 서브 쿼리에 관해서는 다음 글에서 따로 다루도록 하겠다.
14. DELETE
14.1 모든 튜플 삭제
DELETE FROM instructor;테이블 구조는 남고 모든 튜플만 삭제된다.
14.2 조건에 맞는 튜플 삭제
DELETE FROM instructor
WHERE dept_name = 'Finance';
Finance 학과 교수만 삭제한다.
14.3 서브쿼리 결과를 이용한 삭제
Watson 건물에 있는 학과의 교수를 삭제한다.
(서브쿼리에 대한 내용은 다음 글에서 자세히 설명한다.)
DELETE FROM instructor
WHERE dept_name IN (
    SELECT dept_name
    FROM department
    WHERE building = 'Watson'
);
14.4 집계 결과를 이용한 삭제
전체 교수 평균보다 급여가 낮은 교수를 삭제한다.
DELETE FROM instructor
WHERE salary < (
    SELECT AVG(salary)
    FROM instructor
);
SQL의 개념적 처리 방식: 서브쿼리 먼저
- 문장 실행 전 평균 급여 계산
- 해당 평균을 기준으로 삭제 대상 튜플 전체 결정
- 결정된 튜플 삭제
삭제를 시작하기 전에 평균과 삭제 대상을 먼저 정한다. 삭제 도중에는 평균을 다시 계산하지 않으며, 새로운 평균으로 다시 삭제하려면 DELETE 문을 한 번 더 실행해야 한다.
15. INSERT
15.1 한 튜플 삽입
INSERT INTO course
VALUES ('CS-437', 'Database Systems', 'Comp. Sci.', 4);
이 방식은 테이블 정의의 열 순서와 값 순서가 정확히 일치해야 한다.
15.2 열 이름을 명시한 삽입
INSERT INTO course (course_id, title, dept_name, credits)
VALUES ('CS-437', 'Database Systems', 'Comp. Sci.', 4);
열 이름을 명시하면 값이 어떤 열에 들어가는지 분명하고, 테이블의 물리적 열 순서에 덜 의존한다.
15.3 NULL 삽입
INSERT INTO student
VALUES ('3003', 'Green', 'Finance', NULL);tot_cred에 NULL을 넣는다. 해당 열에 NOT NULL 제약조건이 있으면 삽입은 실패한다.
15.4 질의 결과를 삽입
모든 교수를 학생 릴레이션에 추가하고 총 이수학점은 0으로 설정한다.
INSERT INTO student
SELECT ID, name, dept_name, 0
FROM instructor;
주의할 점:
SELECT의 열 개수와 대상 테이블의 열 개수가 맞아야 한다.- 대응되는 열의 자료형이 호환되어야 한다.
- 기본키, 외래키,
NOT NULL등의 제약조건을 만족해야 한다.
15.5 자기 테이블에서 읽어 같은 테이블에 삽입
INSERT INTO table1
SELECT *
FROM table1;
SQL은 먼저 SELECT 결과 전체를 계산한 뒤 삽입한다. 새로 삽입된 행을 다시 읽어 무한히 복제하지 않는다. 단, 기본키나 유일성 제약조건이 있으면 중복 때문에 문장이 실패할 수 있다.
16. UPDATE
UPDATE는 기존 튜플의 값을 바꾸는 명령어이다.
행을 삭제하지 않고, 특정 속성만 수정한다.
16.1 기본 형식
UPDATE relation
SET attribute = expression
WHERE condition;
WHERE 을 통해 특정 튜플을 선택하고, SET 을 통해 해당 튜플의 속성 값을 바꾼다.
16.2 두 문장으로 조건부 인상
- 급여가 100,000보다 크면 3% 인상
- 나머지는 5% 인상
UPDATE instructor
SET salary = salary * 1.03
WHERE salary > 100000;

UPDATE instructor
SET salary = salary * 1.05
WHERE salary <= 100000;
16.3 순서가 중요한 이유
두 문장의 순서를 바꾸면 첫 번째 인상으로 급여가 100,000을 넘은 교수가 두 번째 문장에서도 다시 인상될 수 있다.
예를 들어 원래 급여가 99,000이라면:
5% 인상 -> 103,950
3% 인상 조건도 만족 -> 다시 3% 인상
즉, 의도와 달리 두 번 갱신될 수 있다.
17. CASE를 사용한 조건부 갱신
한 번의 UPDATE 안에서 조건에 따라 서로 다른 값을 적용한다.
UPDATE instructor
SET salary = CASE
    WHEN salary <= 100000 THEN salary * 1.05
    ELSE salary * 1.03
END;
장점:
- 각 행은 한 번만 갱신된다.
- 문장 실행 순서에 따른 오류를 피할 수 있다.
- 하나의 문장 안에 조건이 모여 있어 의도가 분명하다.
CASE의 일반 형태
CASE
    WHEN condition1 THEN result1
    WHEN condition2 THEN result2
    ELSE default_result
END
다음 글에서는 서브쿼리에 대해서 자세히 다뤄보도록 하겠습니다.
Reference:
Database System Concept-7th Edition
건국대학교 김욱희 교수님 - Database 수업