저번 포스팅에 이어서 서브쿼리(하위 질의)에 대해서 알아보겠습니다.
서브쿼리(Subquery)
서브쿼리는 다른 SQL 쿼리 안에 포함된
SELECT-FROM-WHERE식
1. Nested Subquery
1.1 정의
중첩 쿼리(Nested Subquery) 는 다른 쿼리 안에 포함된 SELECT-FROM-WHERE 식
SELECT ...
FROM ...
WHERE column IN (
    SELECT ...
    FROM ...
    WHERE ...
);
주요 용도는 다음과 같다.
- 집합 소속 여부 검사:
IN,NOT IN - 집합과 값 비교:
SOME,ALL - 결과 집합이 비었는지 검사
EXISTS,NOT EXISTS - 결과의 중복 여부 검사
UNIQUE - 계산한 결과를 임시 테이블이나 단일 값으로 사용
WITH
1.2 읽는 순서
일반적인 비상관 서브쿼리는 안쪽부터 읽으면 쉽다.
1. 안쪽 SELECT 실행
2. 안쪽 질의가 값 또는 집합 생성
3. 바깥 질의가 그 결과를 조건이나 입력으로 사용
2. IN과 NOT IN
2.1 IN: 집합에 속하는가?
2017년 가을과 2018년 봄에 모두 개설된 과목을 찾는다.
SELECT DISTINCT course_id
FROM section
WHERE semester = 'Fall'
  AND year = 2017
  AND course_id IN (
      SELECT course_id
      FROM section
      WHERE semester = 'Spring'
        AND year = 2018
  );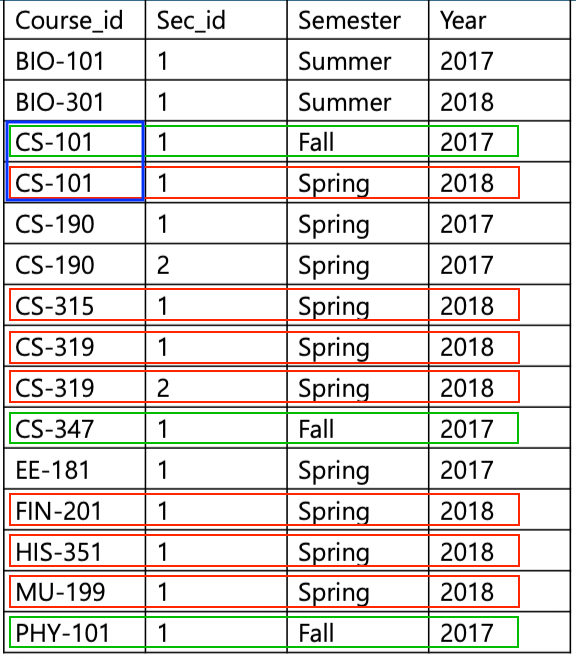
초록색이 2017년 가을에 개설된 과목
빨간색이 2018년 봄에 개설된 과목
파란색의CS-101이 공통인 과목이다.
처리 과정:
- 안쪽 질의가 2018년 봄에 개설된
course_id집합을 만든다. - 바깥 질의가 2017년 가을에 개설된 과목을 찾는다.
- 그중 안쪽 결과에도 포함된 과목만 남긴다.
Fall 2017 과목 ∩ Spring 2018 과목2.2 NOT IN: 집합에 속하지 않는가?
2017년 가을에는 개설되었지만 2018년 봄에는 개설되지 않은 과목을 찾는다.
SELECT DISTINCT course_id
FROM section
WHERE semester = 'Fall'
  AND year = 2017
  AND course_id NOT IN (
      SELECT course_id
      FROM section
      WHERE semester = 'Spring'
        AND year = 2018
  );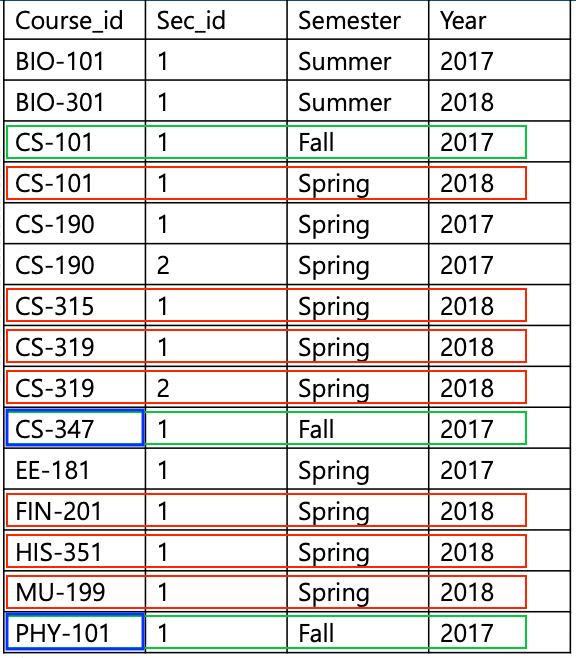
초록색이 2017년 가을에 개설된 과목
빨간색이 2018년 봄에 개설된 과목
파란색의CS-347,PHY-101이 조건을 만족하는 과목이다.
Fall 2017 과목 - Spring 2018 과목강의 예제 데이터의 결과: CS-347, PHY-101
2.3 NOT IN과 NULL 주의
서브쿼리 결과에 NULL이 있으면 NOT IN의 비교 결과가 UNKNOWN이 되어 예상과 달리 행이 선택되지 않을 수 있다.
안전한 방법:
- 서브쿼리에서
NULL을 제거한다. - 또는
NOT EXISTS를 사용한다.
WHERE course_id NOT IN (
    SELECT course_id
    FROM section
    WHERE course_id IS NOT NULL
);
3. 튜플 단위의 IN
교수 10101이 담당한 분반을 수강한 서로 다른 학생 수를 구한다.
SELECT COUNT(DISTINCT ID)
FROM takes
WHERE (course_id, sec_id, semester, year) IN (
    SELECT course_id, sec_id, semester, year
    FROM teaches
    WHERE teaches.ID = 10101
);
왜 네 속성을 함께 비교하는가?
course_id만으로는 특정 분반을 구별할 수 없다. 같은 과목이 여러 분반, 학기, 연도에 개설될 수 있기 때문이다.
(course_id, sec_id, semester, year)이 네 속성의 조합으로 특정 수업 분반을 식별한다.
처리 과정:
teaches에서 교수10101이 담당한 분반들의 복합 튜플을 구한다.takes에서 그 튜플들에 해당하는 수강 기록을 찾는다.COUNT(DISTINCT ID)로 중복 학생을 한 번만 센다.
4. 집합 비교: SOME
4.1 의미
SOME은 서브쿼리 결과 중 적어도 하나와 비교 조건을 만족하면 참이다.
F <comp> SOME r
<=> r의 원소 중 적어도 하나의 t에 대해 F <comp> t가 참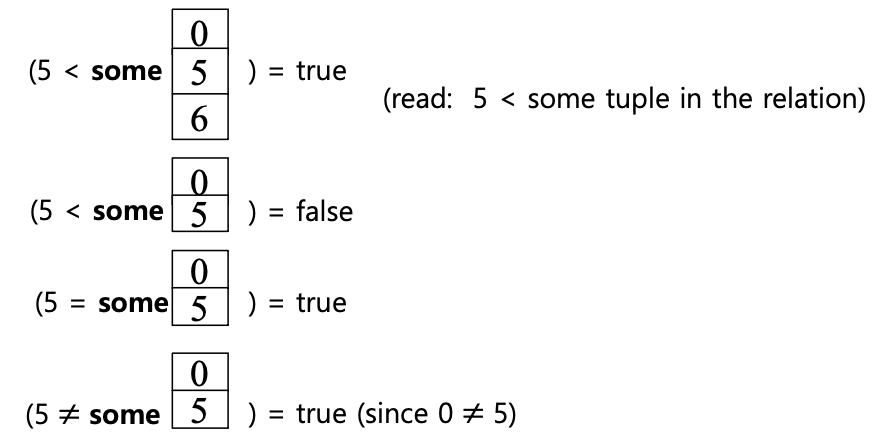
<comp>에는 <, <=, >, >=, =, <> 등을 사용할 수 있다.
4.2 예제
CSE 학과 교수 중 적어도 한 명보다 급여가 높은 교수를 찾는다.
SELECT name
FROM instructor
WHERE salary > SOME (
    SELECT salary
    FROM instructor
    WHERE dept_name = 'CSE'
);
서브쿼리 결과가 {60000, 70000, 90000}이라면, 급여가 60000보다 크기만 해도 조건을 만족한다.
4.3 자기 조인으로 표현한 같은 쿼리
SELECT DISTINCT T.name
FROM instructor AS T, instructor AS S
WHERE T.salary > S.salary
AND S.dept_name = 'CSE';SOME을 사용하면 같은 의미를 더 직접적으로 표현할 수 있다.
4.4 SOME의 중요한 등가 관계
= SOME <=> IN하지만 다음은 성립하지 않는다.
<> SOME != NOT IN예를 들어 집합이 {0, 5}일 때 5 SOME {0, 5}는 5와 다른 원소인 0이 있으므로 참이다. 반면 5 NOT IN {0, 5}는 5가 집합에 포함되어 있으므로 거짓이다.
ANY는 일반적으로SOME과 같은 의미다.
5. 집합 비교: ALL
5.1 의미
ALL은 하위 질의 결과의 모든 값과 비교 조건을 만족해야 참이다.
F <comp> ALL r
<=> r의 모든 원소 t에 대해 F <comp> t가 참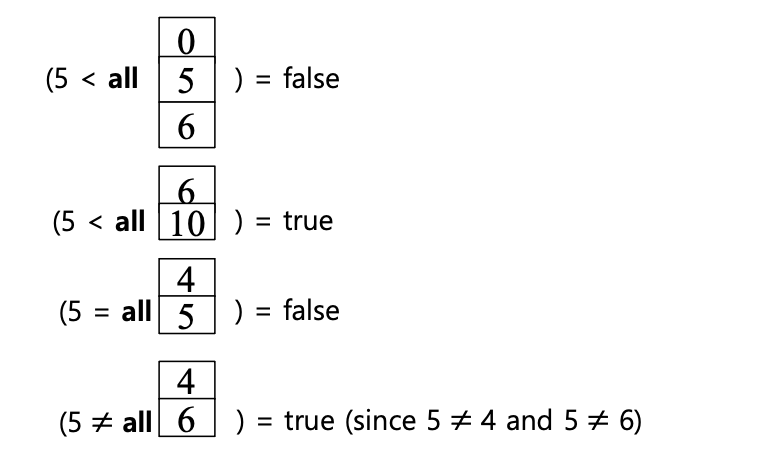
5.2 예제
Biology 학과 모든 교수보다 급여가 높은 교수를 찾는다.
SELECT name
FROM instructor
WHERE salary > ALL (
    SELECT salary
    FROM instructor
    WHERE dept_name = 'Biology'
);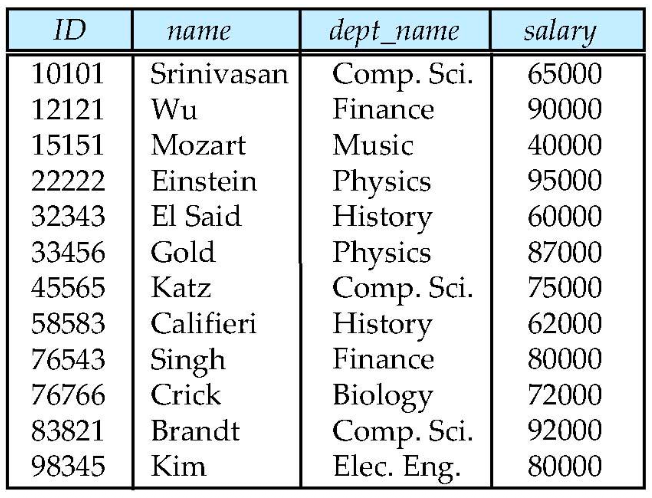
하위 질의 결과가 {60000, 70000, 90000}이라면 급여가 90000보다 커야 조건을 만족한다.
5.3 SOME과 ALL 비교
| 표현 | 의미 |
|---|---|
x > SOME (집합) | 집합의 값 중 하나보다만 크면 됨 |
x > ALL (집합) | 집합의 모든 값보다 커야 함 |
x = SOME (집합) | x IN (집합)과 같음 |
5.4 빈 집합과 NULL
- 빈 집합에 대한
SOME조건은 만족할 대상이 없으므로 거짓이다. - 빈 집합에 대한
ALL조건은 반례가 없으므로 참이다. - 서브쿼리 결과에
NULL이 있으면 3값 논리에 따라 결과가UNKNOWN이 될 수 있다.
6. EXISTS와 NOT EXISTS
6.1 정의
EXISTS는 서브쿼리 결과에 튜플이 하나라도 있으면 참이다.
NOT EXISTS는 내부 결과가 비어 있으면 참이다.
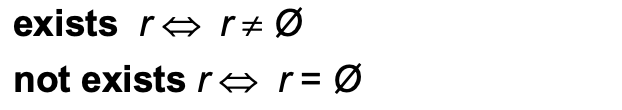
EXISTS에서는 실제 출력 값보다 행의 존재 여부가 중요하므로 보통 SELECT * 또는 SELECT 1을 사용한다.
WHERE EXISTS (
    SELECT 1
    FROM ...
    WHERE ...
);
7. Correlated Subquery
7.1 정의
상관 서브쿼리(Correlated Subquery) 는 하위 쿼리가 바깥 쿼리의 현재 튜플을 참조하는 질의다.
- 바깥 질의의 별칭을 correlation name 또는 correlation variable이라고 한다.
- 비상관 서브쿼리처럼 한 번만 독립 실행되는 것으로 이해하면 안 된다.
- 개념적으로 바깥 질의의 각 후보 행에 대해 하위 질의를 평가한다.
7.2 두 학기에 모두 개설된 과목
SELECT course_id
FROM section AS S
WHERE semester = 'Fall'
  AND year = 2017
  AND EXISTS (
      SELECT *
      FROM section AS T
      WHERE semester = 'Spring'
        AND year = 2018
        AND S.course_id = T.course_id
  );
여기서 S.course_id가 바깥 질의의 현재 과목을 하위 질의에 전달한다.
처리 개념:
- 바깥 질의에서 2017년 가을 과목
S를 하나 선택한다. - 하위 질의에서 같은
course_id가 2018년 봄에도 존재하는지 검사한다. - 존재하면 해당 과목을 결과에 포함한다.
8. NOT EXISTS로 "모두" 표현하기
Biology 학과에서 개설한 모든 과목을 수강한 학생을 찾는다.
SELECT DISTINCT S.ID, S.name
FROM student AS S
WHERE NOT EXISTS (
    (SELECT course_id
     FROM course
     WHERE dept_name = 'Biology')
    EXCEPT
    (SELECT T.course_id
     FROM takes AS T
     WHERE S.ID = T.ID)
);
8.1 집합으로 해석
A = Biology 학과의 전체 과목 집합
B = 현재 학생이 수강한 과목 집합
A EXCEPT B = 학생이 아직 수강하지 않은 Biology 과목
A EXCEPT B가 비어 있으면 빠진 과목이 하나도 없다는 뜻이다.
NOT EXISTS (A EXCEPT B)
= 수강하지 않은 Biology 과목이 존재하지 않음
= Biology의 모든 과목을 수강함
8.2 이중 부정 패턴
SQL에서 "모든 X에 대해 조건을 만족"은 다음과 같은 이중 부정으로 자주 표현한다.
조건을 만족하지 않는 X가 존재하지 않는다.9. 중복 존재 검사: UNIQUE
UNIQUE(subquery)는 서브쿼리 결과에 중복 튜플이 있는지 검사한다.
- 중복이 없으면 참
- 중복이 있으면 거짓
- 빈 결과에 대해서도 참
2017년에 최대 한 번 개설된 과목을 찾는 예:
SELECT T.course_id
FROM course AS T
WHERE UNIQUE (
    SELECT R.course_id
    FROM section AS R
    WHERE T.course_id = R.course_id
      AND R.year = 2017
);
각 과목에 대해 2017년의 개설 기록이 0개 또는 1개면 중복이 없으므로 참.
두 번 이상 개설되면 같은 course_id가 반복되어 거짓.
강의 예제 데이터에서 2017년에 두 번 개설된 CS-190만 결과에서 제외
UNIQUE(subquery)술어의 지원 여부와 문법은 DBMS마다 다르다. 실제 환경에서는GROUP BY ... HAVING COUNT(*) <= 1또는NOT EXISTS를 이용한 대체 표현을 확인하는 것이 안전하다.
10. FROM 절의 서브쿼리
서브쿼리 결과를 하나의 임시 릴레이션처럼 FROM에서 사용할 수 있다. 이를 derived table 또는 inline view라고도 한다.
학과별 평균 급여를 먼저 구한 뒤, 평균이 3,000,000보다 큰 학과를 찾는다.
SELECT dept_name, avg_salary
FROM (
    SELECT dept_name, AVG(salary) AS avg_salary
    FROM instructor
    GROUP BY dept_name
) AS dept_avg
WHERE avg_salary > 3000000;
처리 과정:
- 안쪽 쿼리가 학과별 평균 급여 릴레이션을 만든다.
- 이 결과에
dept_avg라는 별칭을 붙인다. - 바깥 쿼리가
avg_salary > 3000000인 행만 선택한다.
열 이름까지 별칭으로 지정
SELECT dept_name, avg_salary
FROM (
    SELECT dept_name, AVG(salary)
    FROM instructor
    GROUP BY dept_name
) AS dept_avg(dept_name, avg_salary)
WHERE avg_salary > 3000000;
많은 DBMS에서는
FROM절의 서브쿼리에 별칭이 필요하다.
11. WITH 절과 CTE
11.1 정의
WITH 절은 현재 SQL 문 안에서만 사용할 수 있는 임시 결과에 이름을 붙인다. 이렇게 정의한 결과를 CTE(Common Table Expression) 라고 한다.
- 유효 범위: SQL 문 하나 (
;까지)
WITH temporary_name AS (
    SELECT ...
)
SELECT ...
FROM temporary_name;
복잡한 쿼리를 단계별로 나누어 읽기 쉽게 만들고, 같은 중간 결과를 재사용할 수 있다.
11.2 최대 예산을 가진 학과
WITH max_budget(value) AS (
    SELECT MAX(budget)
    FROM department
)
SELECT department.dept_name, department.budget
FROM department, max_budget
WHERE department.budget = max_budget.value;max_budgetCTE가 전체 학과 중 최대 예산 하나를 구한다.department에서 예산이 최대값과 같은 학과를 찾는다.- 최대 예산이 같은 학과가 여러 개라면 모두 출력된다.
11.3 여러 CTE 연결
전체 학과의 총급여 평균 이상을 지출하는 학과를 찾는다.
WITH dept_total(dept_name, value) AS (
    SELECT dept_name, SUM(salary)
    FROM instructor
    GROUP BY dept_name
),
dept_total_avg(value) AS (
    SELECT AVG(value)
    FROM dept_total
)
SELECT dept_total.dept_name
FROM dept_total, dept_total_avg
WHERE dept_total.value >= dept_total_avg.value;
처리 단계:
-
첫 번째
CTE dept_total교수 데이터를 학과별로 묶어 학과별 총급여를 계산합니다.
-
두 번째
CTE dept_total_avg앞에서 만든
dept_total을 사용해 학과별 총급여의 평균을 계산합니다. -
마지막 메인 쿼리
dept_total과dept_total_avg를 비교해 총급여가 평균 이상인 학과를 선택합니다.
12. Scalar Subquery
12.1 정의
스칼라 서브쿼리(Scalar Subquery) 는 단일 값이 필요한 위치에서 사용하는 서브쿼리다.
- 결과가 정확히 1행 1열이면 그 값을 사용하는 구조
- 일반 서브쿼리의 결과가 0행이면 일반적으로
NULL로 취급 COUNT(*)와 같은 집계 함수는 대상 행이 없어도 값0을 가진 1행을 반환하므로 스칼라 값으로 사용 가능- 결과가 2행 이상이면 단일 값을 결정할 수 없어 발생하는 실행 오류
예시1) 학과별 교수 수를 열로 출력
SELECT dept_name,
       (
           SELECT COUNT(*)
           FROM instructor
           WHERE department.dept_name = instructor.dept_name
       ) AS num_instructors
FROM department;
바깥 쿼리의 각 학과에 대해 같은 학과에 속한 교수 수를 하나의 값으로 계산한다.
예시 2) 급여와 학과 예산 비교
SELECT name
FROM instructor
WHERE salary * 10 > (
    SELECT budget
    FROM department
    WHERE department.dept_name = instructor.dept_name
);
각 교수의 급여 10배가 소속 학과 예산보다 큰지 검사한다. department.dept_name이 기본키라면 하위 쿼리는 최대 한 행만 반환한다.
13. 서브쿼리 종류 한눈에 보기
| 종류 | 결과 형태 또는 검사 대상 | 대표 문법 |
|---|---|---|
| 집합 소속 서브쿼리 | 값이 결과 집합에 포함되는지 | IN, NOT IN |
| 집합 비교 서브쿼리 | 하나 이상 또는 전체 값과 비교 | SOME, ALL |
| 존재 검사 | 결과가 비었는지 | EXISTS, NOT EXISTS |
| 상관 서브쿼리 | 바깥 질의의 현재 행을 참조 | S.course_id = T.course_id |
FROM 서브쿼리 | 결과를 임시 릴레이션으로 사용 | FROM (SELECT ...) AS x |
| 스칼라 서브쿼리 | 결과를 단일 값으로 사용 | salary > (SELECT AVG(...)) |
| CTE | 이름 붙인 임시 결과 | WITH x AS (...) |
Reference:
Database System Concept-7th Edition
건국대학교 김욱희 교수님 - Database 수업