1. 데이터베이스 시스템이 필요한 이유
대학교를 예로 들면 다음과 같은 정보를 관리해야 한다.
- 학생(Students)
- 학과(Departments)
- 교수(Faculty)
- 과목(Courses)
- 학생의 수강 관계
- 교수의 강의 관계
- 교수와 학생의 지도 관계
이 데이터를 개별 파일로만 관리하면 아래의 문제가 발생한다.
아래는 데이터베이스 시스템이 필요한 이유에 대해 설명한다.
1.1 Data Redundancy and Inconsistency
데이터 중복성(Redundancy)
- 같은 교수의 정보가 여러 과목 파일에 반복해서 저장될 수 있다.
| 과목 번호 | 교수 | 연구실 | 이메일 ID |
|---|---|---|---|
| 3178 | Wookhee Kim | New Eng. Bld. 1217 | wookhee |
| 4656 | Wookhee Kim | Eng. Bld. C422 | wookhee |
교수 이름과 이메일처럼 같은 정보가 여러 곳에 복사되어 있으므로 저장 공간이 낭비되고 수정 작업이 늘어난다.
데이터 불일치(Inconsistency)
- 한쪽 파일의 연구실만 수정하면 동일한 교수에 대해 서로 다른 연구실 정보가 존재하게 된다.
중복 데이터 생성
    -> 복사본 중 일부만 수정
    -> 서로 다른 값이 공존
    -> 데이터 불일치 발생
1.2 Difficulty in Accessing Data
데이터를 다루기 편리함
- 파일 시스템에서는 새로운 형태의 데이터 조회가 필요할 때마다 별도의 프로그램을 작성해야 할 수 있다.
- 예를 들어 기존 프로그램이 전체 학생 명단만 출력한다면, 특정 학과의 학생만 찾기 위해 새 조회 로직을 추가해야 한다.
- DBMS에서는 일반적으로
SQL이라는 공통 쿼리 언어를 사용한다. - DBMS마다 일부 문법 차이는 있지만, 새로운 조회 요구가 생길 때마다 별도의 파일 처리 프로그램을 처음부터 작성하는 것보다 훨씬 적은 코드로 데이터를 접근할 수 있다.
- 또한 DBMS 엔진이 바뀌더라도 SQL 중심의 접근 방식은 대체로 유지된다.
1.3 Data Isolation
데이터가 여러 파일에 흩어져 있고 파일 형식까지 다르면 통합 처리가 어려움
- 여러 위치에 데이터가 분산됨
- 파일마다 구조와 형식이 다름
- 응용 프로그램이 각 형식을 직접 해석해야 함
- 서로 관련된 데이터를 함께 조회하기 어려움
1.4 Integrity Problems
- 무결성(Integrity)이란, 데이터가 정해진 규칙을 계속 만족해야 한다는 뜻이다.
예시:
salary >= 0급여가 음수가 될 수 없다는 규칙이 여러 프로그램에 흩어져 있으면, 일부 프로그램이 검사를 빠뜨릴 수 있다. DBMS에서는 이런 제약조건을 중앙에서 정의하고 관리할 수 있다.
성적도 마찬가지다. 최종 학점이 A+, A0, B+, B0처럼 정해진 값만 허용된다면, 허용 목록에 없는 값이 저장되지 않도록 제약조건을 둘 수 있다.
응용 프로그램마다 같은 검증 코드를 반복해서 작성하지 않아도 DBMS가 잘못된 입력을 거부한다.
1.5 Atomicity Problems
- 원자성(Atomicity)은 하나의 작업이 전부 수행되거나 전혀 수행되지 않아야 한다는 성질이다.
- DB에서 하나의 논리적 연산 단위를 트랜잭션(Transaction)이라고 함.
- 원자성이 보장된 트랜잭션은 실행되기 전 상태, 성공적으로 완료된 상태 둘 중 하나의 상태만 가능
- 실행 도중의 중간 상태가 외부에 최종 결과로 남지 않음
송금 예시
A 계좌의 500달러 중 200달러를 B 계좌로 송금한다고 하자.
| 상태 | A 계좌 | B 계좌 | 판단 |
|---|---|---|---|
| 송금 전 | 500 | 100 | 정상 |
| 송금 완료 | 300 | 300 | 정상 |
| B에만 입금 | 500 | 300 | 비일관 상태 |
| A에서만 출금 | 300 | 100 | 비일관 상태 |
- 출금과 입금은 하나의 논리적 작업으로 처리되어야 한다. (원자성 보장 필요)
- 도중에 시스템 장애가 발생하더라도 두 단계 중 하나만 반영된 상태가 남아서는 안 된다.
- 또한 두 계좌 잔액의 합이 600달러로 유지된다는 사실만으로 원자성이 보장되지는 않는다.
- 송금 전의
(500, 100)또는 송금 완료 후의(300, 300)만 정상이며, (400, 200)처럼 총합만 같은 임의의 중간 상태는 올바른 결과가 아니다.
- 송금 전의
즉, Atomicity = All or Nothing1.6 Concurrent-access Anomalies
여러 사용자가 같은 데이터를 동시에 읽고 수정하면 잘못된 결과가 생길 수 있다.
잔액이 1,000달러인 계좌에서 동시에 다음 요청이 들어온다고 하자.
- 작업 A: 100달러 출금
- 작업 B: 200달러 출금
정상적인 최종 잔액은 700달러지만, 두 작업이 모두 1,000달러를 읽은 뒤 각자 결과를 덮어쓰면 900달러 또는 800달러가 남을 수 있다.
두 작업이 같은 값 1000을 읽음
    -> A는 900을 계산
    -> B는 800을 계산
    -> 나중에 쓴 값이 앞선 결과를 덮어씀
DBMS는 동시성 제어를 통해 이러한 이상 현상을 방지해야 한다.
가장 단순한 해결 방식은 먼저 접근한 작업에 수정 권한을 주고, 그 작업이 끝날 때까지 다른 작업의 접근을 막는 것이다. 운영체제의 mutex와 유사한 lock을 사용해 두 작업을 순서대로 실행하면, 첫 출금 후 잔액을 다음 작업이 읽으므로 최종 잔액은 올바른 700달러가 된다.
1.7 Security Problems
모든 사용자가 데이터베이스의 모든 데이터에 접근할 수 있어서는 안 된다.
- 사용자별 접근 권한 부여
- 민감한 속성 비공개
- 허가되지 않은 조회와 변경 차단
1.8 정리
| 문제 | 핵심 내용 |
|---|---|
| 중복성과 불일치 | 같은 정보가 반복 저장되고 서로 다른 값이 될 수 있음 |
| 접근의 어려움 | 새로운 조회마다 프로그램 작성이 필요할 수 있음 |
| 데이터 고립 | 여러 파일과 형식에 흩어진 데이터를 통합하기 어려움 |
| 무결성 문제 | 데이터 규칙을 일관되게 적용하기 어려움 |
| 원자성 문제 | 작업 일부만 반영된 비정상 상태가 남을 수 있음 |
| 동시 접근 이상 | 동시에 갱신하면서 결과가 유실될 수 있음 |
| 보안 문제 | 사용자별 접근 범위를 통제하기 어려움 |
2. Data Abstraction
데이터베이스 시스템의 중요한 목적은 사용자에게 데이터의 추상화된 모습을 제공하는 것이다.
DBMS는 데이터가 실제로 저장되고 관리되는 복잡한 세부 사항을 숨긴다.
- 데이터는 효율적으로 검색되어야 한다.
- 이를 위해 내부적으로 복잡한 자료구조를 사용할 수 있다.
- 많은 사용자는 이러한 내부 구현을 알 필요가 없다.
2.1 내부 구조
- 응용 프로그램은 쿼리를 전달한다.
- 쿼리 엔진은 SQL을 파싱하고, 필요한 연산을 정한 뒤 실행 계획을 세운다.
- 실행 계획에 따라 메모리와 저장장치에서 데이터를 불러오고 연산을 수행한다.
- 메모리의 인덱스와 버퍼 캐시, 저장장치의 DB·로그 파일 등이 내부에서 사용된다.
이런 시스템을 사용자가 모두 이해할 필요는 없다.
2.2 추상화의 세 단계
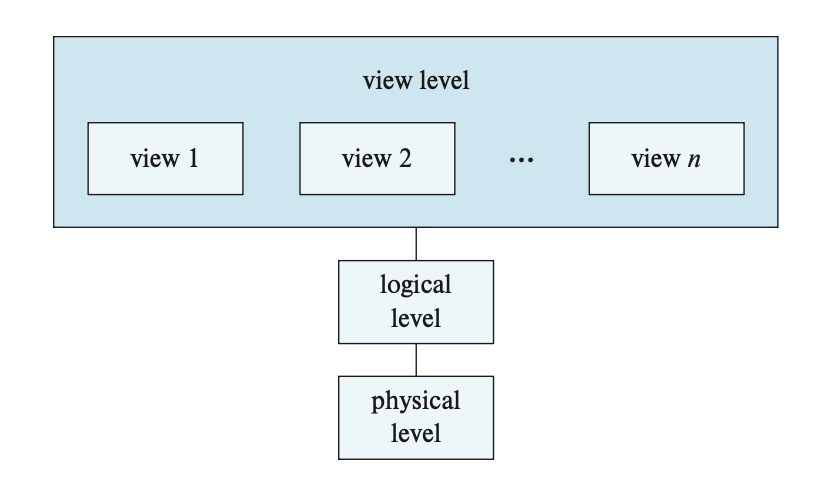
| 단계 | 설명 | 예시 |
|---|---|---|
| View level | 사용자별로 필요한 일부 데이터만 표현 | 급여가 제외된 교직원 정보 화면 |
| Logical level | 저장된 데이터와 데이터 사이의 관계를 표현 | instructor(ID, name, dept_name, salary) |
| Physical level | 데이터가 실제로 저장되는 방식을 표현 | B+-tree, 해시 테이블, slotted page |
Physical Level
- 데이터가 실제로 어떻게 저장되는지 기술
- 인덱스 구조, 페이지 배치, 복구 정보 등 저장장치와 가까운 세부 사항을 포함한다.
- 메인 메모리와 SSD·HDD 같은 하드웨어 특성을 활용해 데이터를 빠르게 읽고 효율적으로 저장하는 방법을 다룬다.
- 성능 최적화를 위해 필요한 경우 명령어 수준의 특성까지 고려할 수 있다.
Logical Level
- 데이터베이스에 어떤 데이터가 저장되는지 기술
- 여러 레코드가 어떻게 관련되는지도 나타낸다.
- 실제 저장 방식은 드러내지 않는다.
Type instructor = record
    ID        : char(5);
    name      : char(20);
    dept_name : char(20);
    salary    : numeric(8,2);
end;
View Level
- 논리 단계의 일부만 사용자에게 보여 줌
- 논리 구조의 세부 내용을 숨기고 보안 수단을 제공한다.
- 예: 학생지원팀에는 교수의 급여를 제외한 정보만 제공한다.
3. Data Models
3.1 데이터 모델의 정의
- 데이터 모델(Data Model)은 데이터가 어떻게 구조화되고 사용되는지를 나타내는 고수준 명세다.
데이터 모델은 다음 요소를 기술하는 도구들의 모음이다.
- 데이터(Data)
- 데이터 사이의 관계(Data relationships)
- 데이터의 의미(Data semantics)
- 데이터 제약조건(Data constraints)
3.2 모델을 사용하는 이유
- 모델은 현실 세계의 일부를 조사하거나 관리하기 위해 사용한다.
- 실제 대상을 직접 실험하는 것보다 모델을 이용하는 비용이 훨씬 낮은 경우가 많다.
예시:
- 비행기 시뮬레이터
- 원자력 발전소 시뮬레이터
- 분자 구조 예측과 조작
- 홍수 경보 시스템
- 미국 경제 모델
- 건축물 모형
- 지도
Reference:
Database System Concept-7th Edition
건국대학교 김욱희 교수님 - Database