Database System Concept 7th을 읽고 정리한 내용입니다.
1. Relation, Attribute, Tuple
관계형 모델에서 데이터는 릴레이션(Relation) 으로 표현한다.
릴레이션은 일반적으로 테이블이라고도 부른다.
| 관계형 용어 | 테이블 용어 | 의미 |
|---|---|---|
| Relation | Table | 데이터 전체 |
| Attribute | Column | 데이터의 속성 |
| Tuple | Row | 하나의 데이터 항목 |
예를 들어 instructor 릴레이션이 다음 구조를 가진다고 하자.
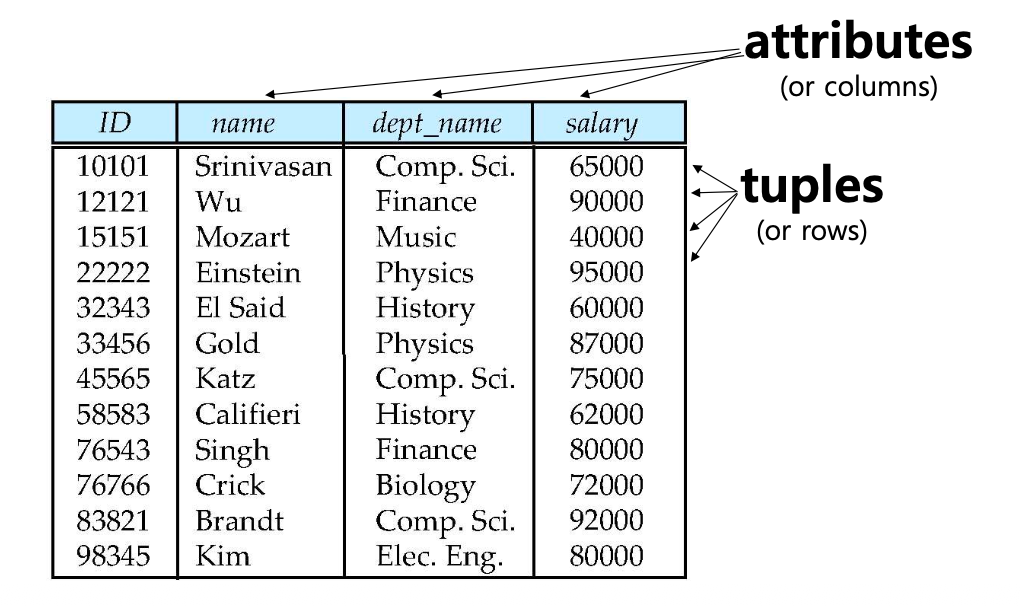
instructor(ID, name, dept_name, salary)ID,name,dept_name,salary는 속성이다.- 교수 한 명의 데이터 한 줄은 튜플이다.
2. Domain: Attribute Types
2.1 도메인이란?
- 도메인(Domain)은 각 속성에 허용되는 값들의 집합
Domain = Data Type + Constraints예를 들어 시험 점수의 도메인이 0부터 100까지라면, 101이나 문자열은 허용되지 않는다.
최종 학점의 도메인은 A+, A0, B+처럼 허용된 값의 목록으로 정의할 수 있다.
- 학번을 숫자 형식으로 제한하거나, 이메일 주소가 정해진 패턴을 따르도록 검사하는 것도 도메인과 관련된 제약의 예다.
2.2 속성 값의 원자성
속성 값은 원자적(atomic) 이어야 한다.
즉, 관계형 모델에서 하나의 속성 값은 더 나눌 필요가 없는 하나의 값이어야 한다.
예를 들면,
원자적이지 않은 구조
| Name_N_ID | Department |
|---|---|
| Alice 001 | Comp. Sci. |
| Bob 002 | Elec. Eng. |
원자적으로 분리한 구조
| Name | ID | Department |
|---|---|---|
| Alice | 001 | Comp. Sci. |
| Bob | 002 | Elec. Eng. |
이름과 학번을 별도 속성으로 분리하면 각각을 독립적으로 검색, 비교, 수정할 수 있다.
- 여기서 원자적이라는 말은 문자열을 글자 단위로 더 쪼갤 수 없다는 뜻이 아니라, 현재 데이터베이스가 다루는 의미와 연산을 기준으로 더 나눌 필요가 없는 값이라는 뜻이다.
Alice라는 이름을 문자 단위로 나누면 각 알파벳은 이름으로서 의미가 없지만,
Alice 001은 이름과 학번으로 나누었을 때 각각 독립적인 의미를 가진다.
3. Relation Schema와 Relation Instance
속성들을 A1, A2, ..., An이라고 할 때, 릴레이션 스키마는 다음과 같이 표현한다.
R(릴레이션) = (A1, A2, ..., An) 예시:
instructor = (ID, name, dept_name, salary)

student (ID, name, dept name, tot cred)| 구분 | 의미 |
|---|---|
| Relation schema | 릴레이션의 이름과 속성 구조 |
| Relation instance | 특정 시점에 존재하는 튜플들의 집합 |
4. Relations Are Unordered
릴레이션에서 튜플의 순서는 의미가 없다.
- 튜플은 임의의 순서로 저장될 수 있다.
- 화면에서 특정 순서로 보이더라도 그 순서가 보장되는 것은 아니다.
- 원하는 정렬 결과가 필요하면 SQL에서
ORDER BY를 명시해야 한다.
SELECT *
FROM instructor
ORDER BY ID;
5. Database는 여러 Relation으로 구성
하나의 데이터베이스는 여러 릴레이션으로 구성된다.
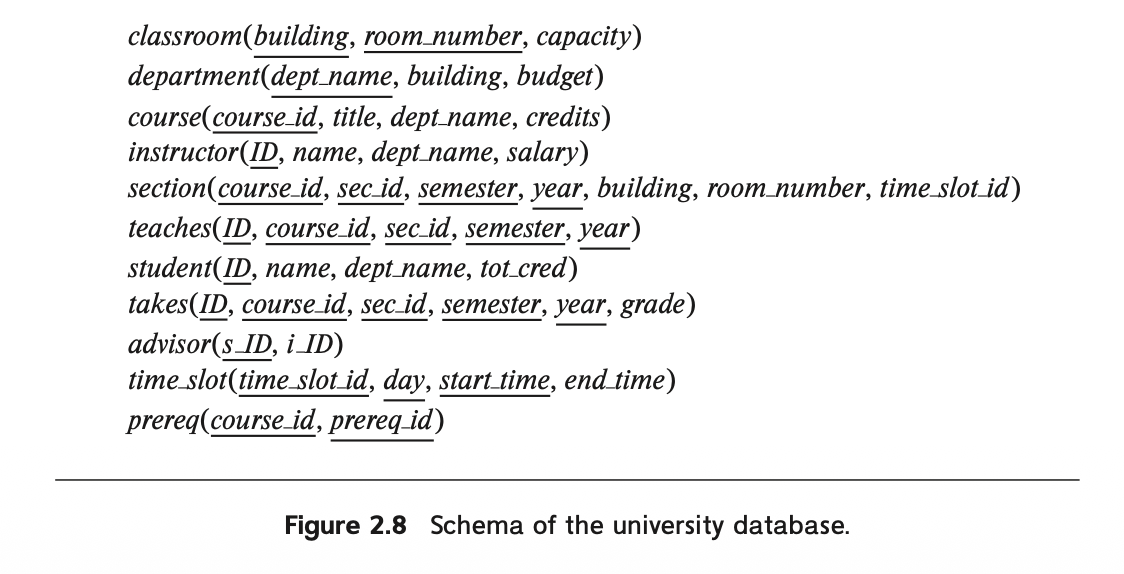
대학교 데이터베이스의 예:
instructorstudentadvisordepartmentcoursesectionteachestakes
각 릴레이션은 특정 종류의 데이터나 관계를 담당하고, 키(Keys)를 통해 서로 연결된다.
6. Keys
릴레이션 R의 속성 집합 일부를 K라고 하자.
K ⊆ R6.1 Superkey
K의 값으로 릴레이션의 튜플 하나를 유일하게 식별할 수 있으면K는 슈퍼키(Superkey) 다.
instructor에서 ID가 고유하다면 다음은 모두 슈퍼키가 될 수 있다.
{ID}
{ID, name}
두 번째 집합은 굳이 필요하지 않은 name을 포함하지만, ID 덕분에 튜플을 유일하게 식별할 수 있으므로 슈퍼키다.
6.2 Candidate Key
불필요한 속성이 없는 최소 슈퍼키를 후보키(Candidate Key)라고 한다.
{ID, name} : Superkey이지만 최소가 아님
{ID}       : Candidate key
여기서 최소란 속성 집합의 크기가 가장 작다는 뜻이 아니라, 속성을 하나라도 제거하면 더 이상 슈퍼키가 되지 않는다는 뜻이다.
6.3 Primary Key
여러 후보키 중 대표로 선택한 하나가 기본키(Primary Key) 다.
Superkey
  └─ 최소성을 만족하는 것 = Candidate key
       └─ 대표로 선택한 하나 = Primary key
6.4 Foreign Key Constraint
-
외래키:
- 다른 테이블의 행을 참조하는 속성
- 다른 테이블의 행을 참조하는 속성
-
외래키 제약조건(Foreign Key Constraint):
- 한 릴레이션의 특정 값이 참조 대상 릴레이션에도 실제로 존재해야 한다.
예시:
instructor.dept_name
        -> department.dept_name
교수의 학과 값은 department 릴레이션에 실제로 존재하는 학과를 참조해야 한다. 이 제약은 릴레이션 사이의 참조 무결성을 유지한다.
참조 방향은 비대칭이다. department는 독립적으로 학과 정보를 보유하고, instructor가 교수를 추가할 때 그 학과 값이 department에 존재하는지 확인한다. 따라서 참조 대상에 없는 학과 이름으로 교수 튜플을 추가할 수 없다.
키 비교표
| 키 | 조건 | 예시 |
|---|---|---|
| Superkey | 튜플을 유일하게 식별 | {ID}, {ID, name} |
| Candidate key | 최소 슈퍼키 | {ID} |
| Primary key | 선택된 후보키 | ID |
| Foreign key | 다른 릴레이션의 키를 참조 | instructor.dept_name |
7. Database Schema Diagram
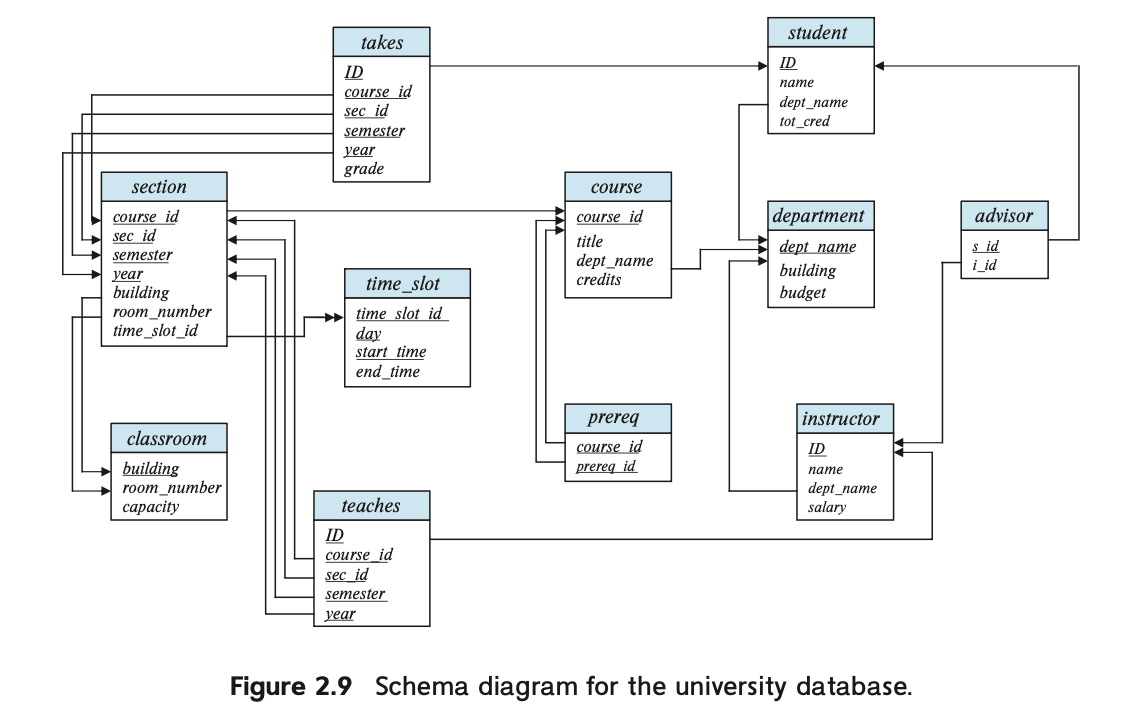
교재의 스키마 다이어그램은 대학교 데이터베이스의 릴레이션과 참조 관계를 보여 준다.
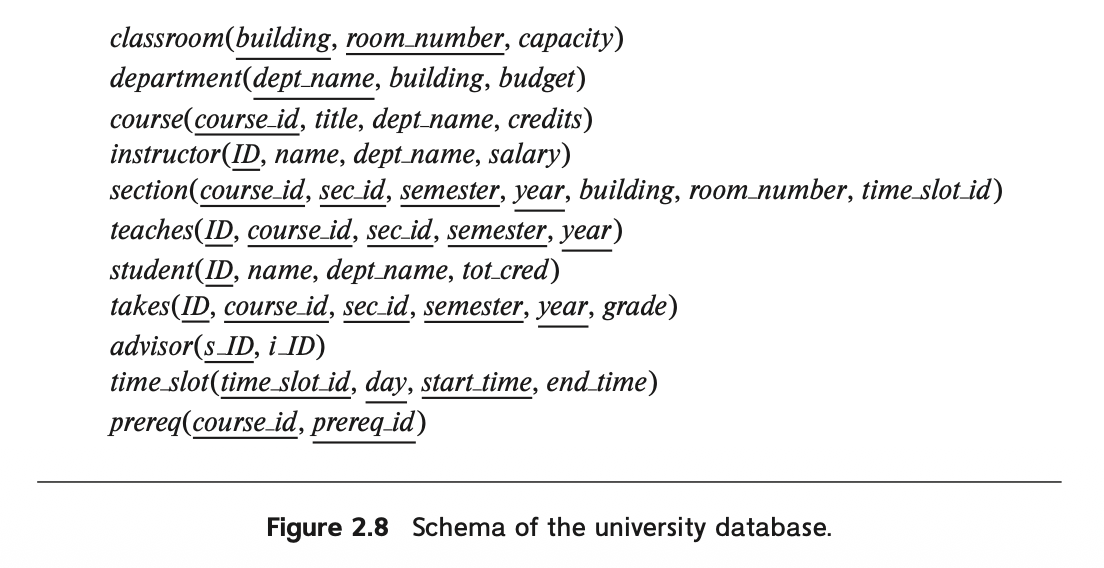
밑줄로 표시된 속성이 각 릴레이션의 기본키다.
복합키가 있는 section, teaches, takes에서는 과목 번호만으로 하나의 분반이나 수강 기록을 구분할 수 없다. 분반 번호, 학기, 연도 등을 함께 사용해야 한다.
주요 참조 관계
student.dept_name     -> department.dept_name
instructor.dept_name  -> department.dept_name
course.dept_name      -> department.dept_name
advisor.s_id          -> student.ID
advisor.i_id          -> instructor.ID
section.course_id     -> course.course_id
teaches.ID            -> instructor.ID
takes.ID              -> student.ID
출처: Database System Concept-7th Edition