1. Relational Query Languages
질의어(query language)는 사용자가 데이터베이스에 정보를 요청할 때 쓰는 언어
보통 일반 프로그래밍 언어보다 한 단계 높은 수준의 언어이고, 명령형·함수형·선언형으로 나눌 수 있다.
명령형 질의어
- 원하는 결과를 얻기 위해 데이터베이스에 어떤 연산을 어떤 순서로 수행할지 사용자가 직접 지시함.
함수형 질의어
- 계산을 함수의 평가로 표현합니다.
- 함수는 데이터베이스의 데이터를 다룰 수도 있고, 다른 함수의 결과를 입력으로 받을 수도 있음.
선언형 질의어
- 원하는 정보를 얻는 구체적인 단계나 함수 호출을 적지 않고, 어떤 정보를 원하는지만 기술함.
- 원하는 정보는 보통 수리 논리의 형태로 표현하고, 그 정보를 어떻게 가져올지는 데이터베이스 시스템이 알아서 정함.
2. Relational Algebra
- SQL과 표현력(expression power)이 동일한 "수학적으로 표현할 수 있는(pure)" 언어들
- Relational algebra (관계 대수)
- Tuple relational calculus (튜플 관계 해석)
- Domain relational calculus (도메인 관계 해석)
- Relational operators: 관계형 질의어는 5개의 단순한 연산자로 사용자 질의를 표현
- Selection, Projection, Cartesian product, Union, Set Difference
3. 관계 대수 연산자
3.1 Selection — 튜플(행) 선택
- 조건(predicate)을 만족하는 행만 반환
- 표기:
σ_조건 (r)
예) relation r
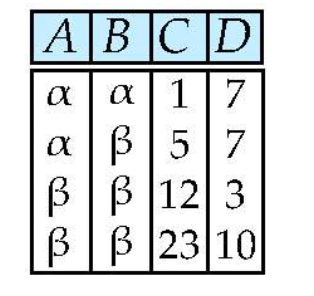
Select tuples with A=B and D > 5
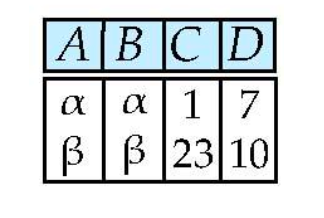
예시
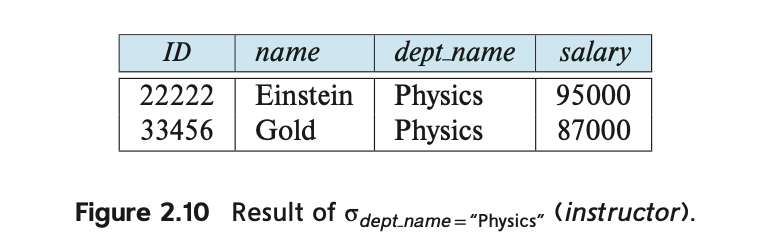
instructor릴레이션에서dept_name이 "Physics"인 것만 선택
3.2 Projection — 속성(열) 고르기
- 특정 칼럼만 뽑는 쿼리 연산자
- 결과에서 중복 튜플은 제거된다 (관계는 집합이므로)
- 표기:
예) relation r
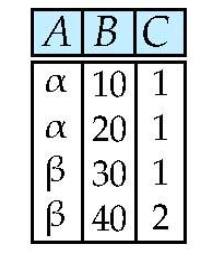
→ 먼저 (α,1), (α,1), (β,1), (β,2) 가 나오지만 중복 제거 후:
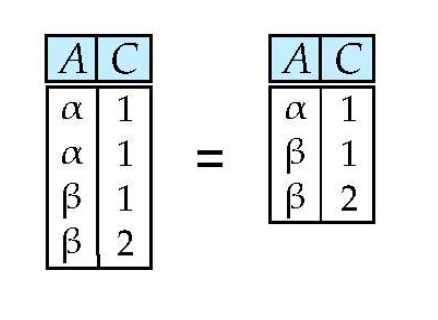
예시
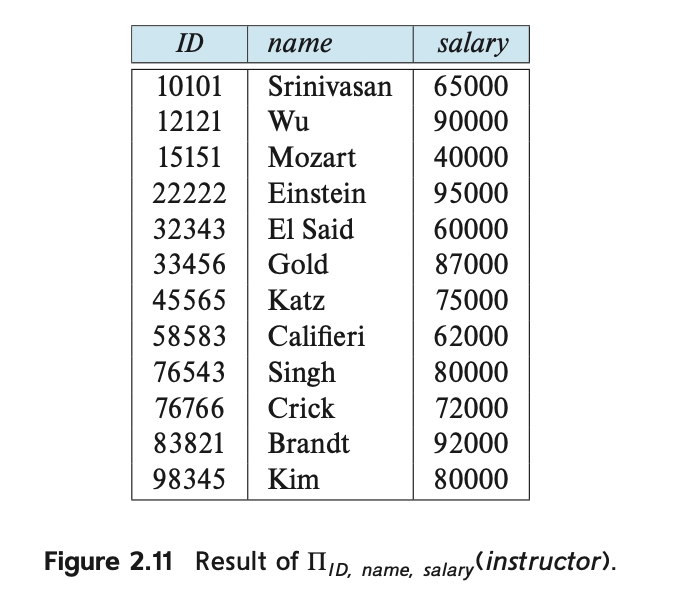
instructor릴레이션의 칼럼 중에서ID,name,salay만 반환
3.3 Cartesian Product (두 관계 붙이기)
- 두 릴레이션을 가지고 만들 수 있는 모든 튜플(행)의 쌍을 만든다 (공통 속성 값이 같든 말든 상관없음)
- 결과 크기 = |r| × |s| 행, 열은 r의 열 + s의 열
- 만약 두 관계에 같은 이름의 속성이 있어도 서로 다른 속성으로 취급하며,
r.A,s.A처럼 관계 이름을 붙여 구분한다. - 보통 모든 조합을 만든 뒤 Selection으로 조건에 맞는 행만 걸러 원하는 결과를 만든다.
예) r(A,B) 2행, s(C,D,E) 4행
→ r × s 는 8행
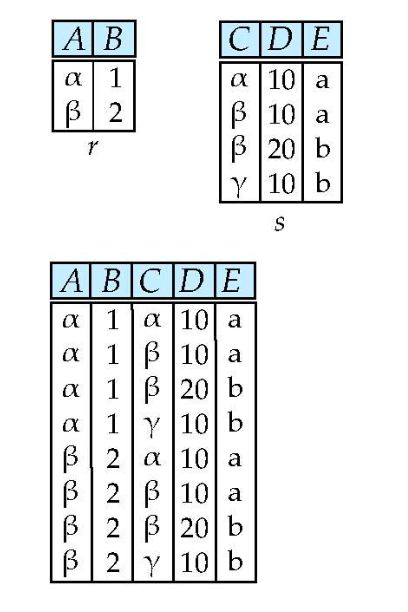
예시
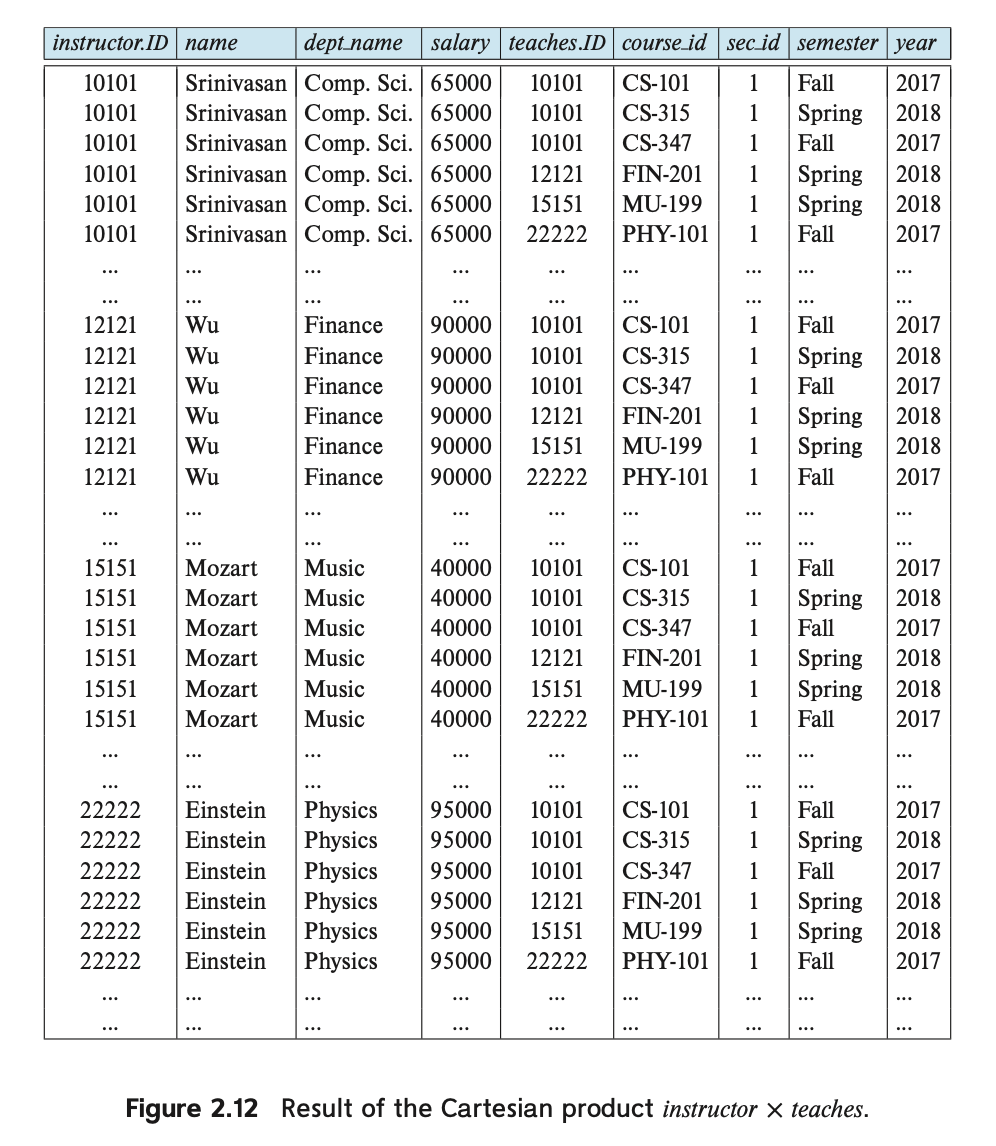
instructor과teaches의 모든 튜플 쌍을 만든다.
3.4 Union (합집합)
- 두 릴레이션의 튜플을 합침
- 두 릴레이션의 형태가 같아야 연산 가능
- 속성 개수가 같아야 하고, 같은 위치의 속성끼리 도메인도 호환돼야 함.
- 중복은 제거
r ∪ s
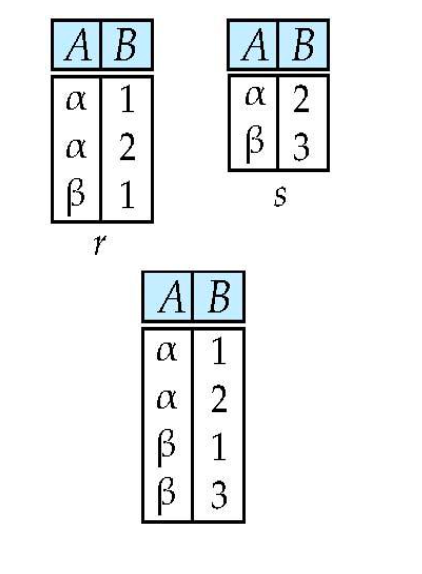
3.5 Set Difference (차집합)
- 릴레이션
r에는 있고s에는 없는 튜플
r − s
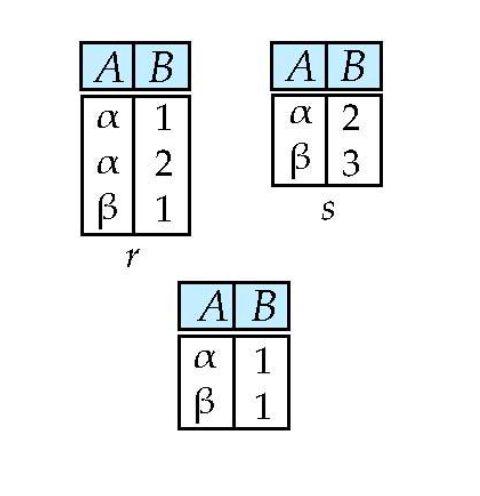
3.6 Natural Join — 공통 속성으로 자연스럽게 결합
정의 (r은 스키마 R, s는 스키마 S 위의 관계일 때)
r s 는 스키마 R S 위의 관계이며, 다음과 같이 만들어진다:
- r의 튜플 과 s의 튜플 의 모든 쌍을 고려한다.
- 과 가 R ∩ S 에 속한 모든 속성에서 값이 같으면, 결과에 튜플 t를 추가한다.
- t 는 R 부분에서 과 같은 값
- t 는 S 부분에서 와 같은 값
- 먼저 두 관계의 이름이 같은 속성을 찾고, 그 모든 속성값이 같은 튜플끼리 결합한다.
- 결과에서는 공통 속성을 한 번만 표시한다.
- 한쪽 관계가 비어 있으면 결합할 튜플이 없으므로 결과도 빈 관계가 된다.
- 조인은 한쪽 튜플과 다른 쪽 튜플을 비교·탐색해야 하므로 일반적으로 비용이 큰 연산이다.
예제 — r(A,B,C,D), s(B,D,E) → 공통 속성은 B, D
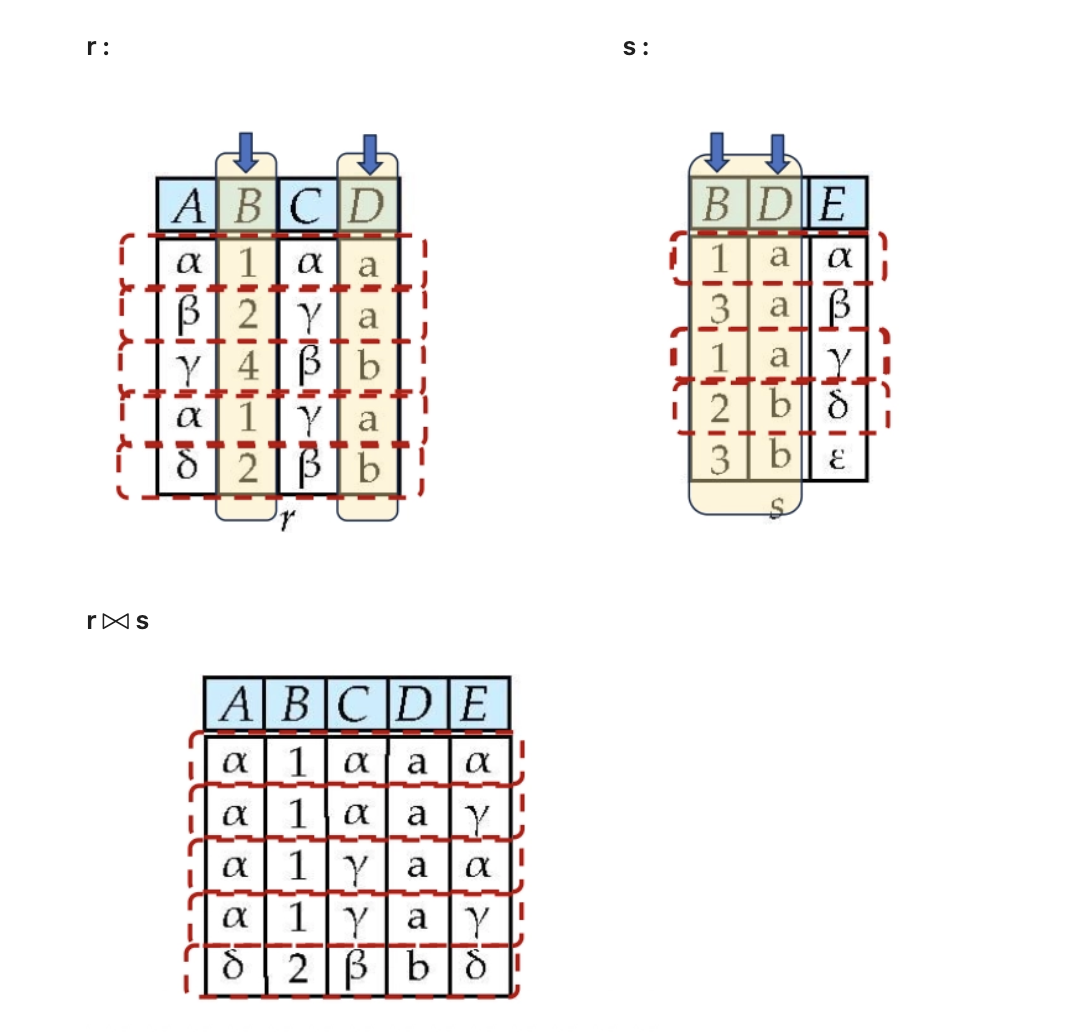
(B,D)=(1,a) 인 r의 2개 튜플 × s의 2개 튜플 = 4행이 생기고, (2,b) 짝에서 1행이 더 생겨 총 5행.
β,2,γ,a는 s에 (2,a)가 없어서 탈락,γ,4,β,b는 s에 (4,b)가 없어서 탈락.
Union vs Natural Join
| 구분 | Union (∪) | Natural Join (⋈) |
|---|---|---|
| 결합 방향 | 세로 (행 추가) | 가로 (열 추가) |
| 스키마 조건 | 두 릴레이션 구조가 같아야 함 (union-compatible) | 구조가 달라도 됨 |
| 결과 스키마 | 입력과 동일 | 두 스키마의 합 (공통 속성은 1번만) |
| 매칭 기준 | 없음 (그냥 합침) | 공통 속성 값이 같은지 |
| 중복 처리 | 중복 튜플 제거 | 공통 속성 열 중복 제거 |
| 개념적 기반 | 집합 연산 | 카티전 곱 → 선택(σ) → 투영(π) |
| 사용 예 | 2017 가을 또는 2018 봄 개설 과목 | 교수 이름 + 소속 학과 건물 |
| SQL | UNION | NATURAL JOIN |
3.7 연산자 정리
| 기호 (이름) | 예시 | 설명 |
|---|---|---|
| σ (Selection) | σ_{salary>=85000}(instructor) | 조건(predicate)을 만족하는 입력 관계의 행을 반환 |
| ∏ (Projection) | ∏_{ID, salary}(instructor) | 지정한 속성만 모든 행에서 출력. 중복 튜플 제거 |
| ⋈ (Natural Join) | instructor ⋈ department | 이름이 같은 모든 속성에서 값이 같은 두 관계의 행 쌍을 출력 |
| × (Cartesian Product) | instructor × department | 공통 속성 값의 일치 여부와 무관하게 모든 행 쌍을 출력 |
| ∪ (Union) | ∏_{name}(instructor) ∪ ∏_{name}(student) | 두 관계의 튜플 합집합을 출력 |
Reference:
Database System Concept-7th Edition
건국대학교 김욱희 교수님 - Database 수업
Data Engineer/ML Engineer