개요
Eum (이음) 개발 과정에 있어서 데모데이 이후, develop 하는 과정에 있어서 골칫거리가 하나 있었다.
그것은 바로 서버비용...!
언제나 그렇듯 서버비용은 대학생 개발자에게 가장 큰 적이다.
AWS 비용이 한달에 34만원 가량이나 나왔던 그 상황을 보고 우리는 당황하지 않을 수 없었다.
당연히 우리는 AI 관련 기능들을 모두 도맡아서 구현하신 동료를 믿었으나, 데모데이 당시에 어떤 분께서 서비비용을 듣고,
"비정상적으로 너무 서버비용이 많이 나왔다. 한번 확인해볼 필요가 있다."
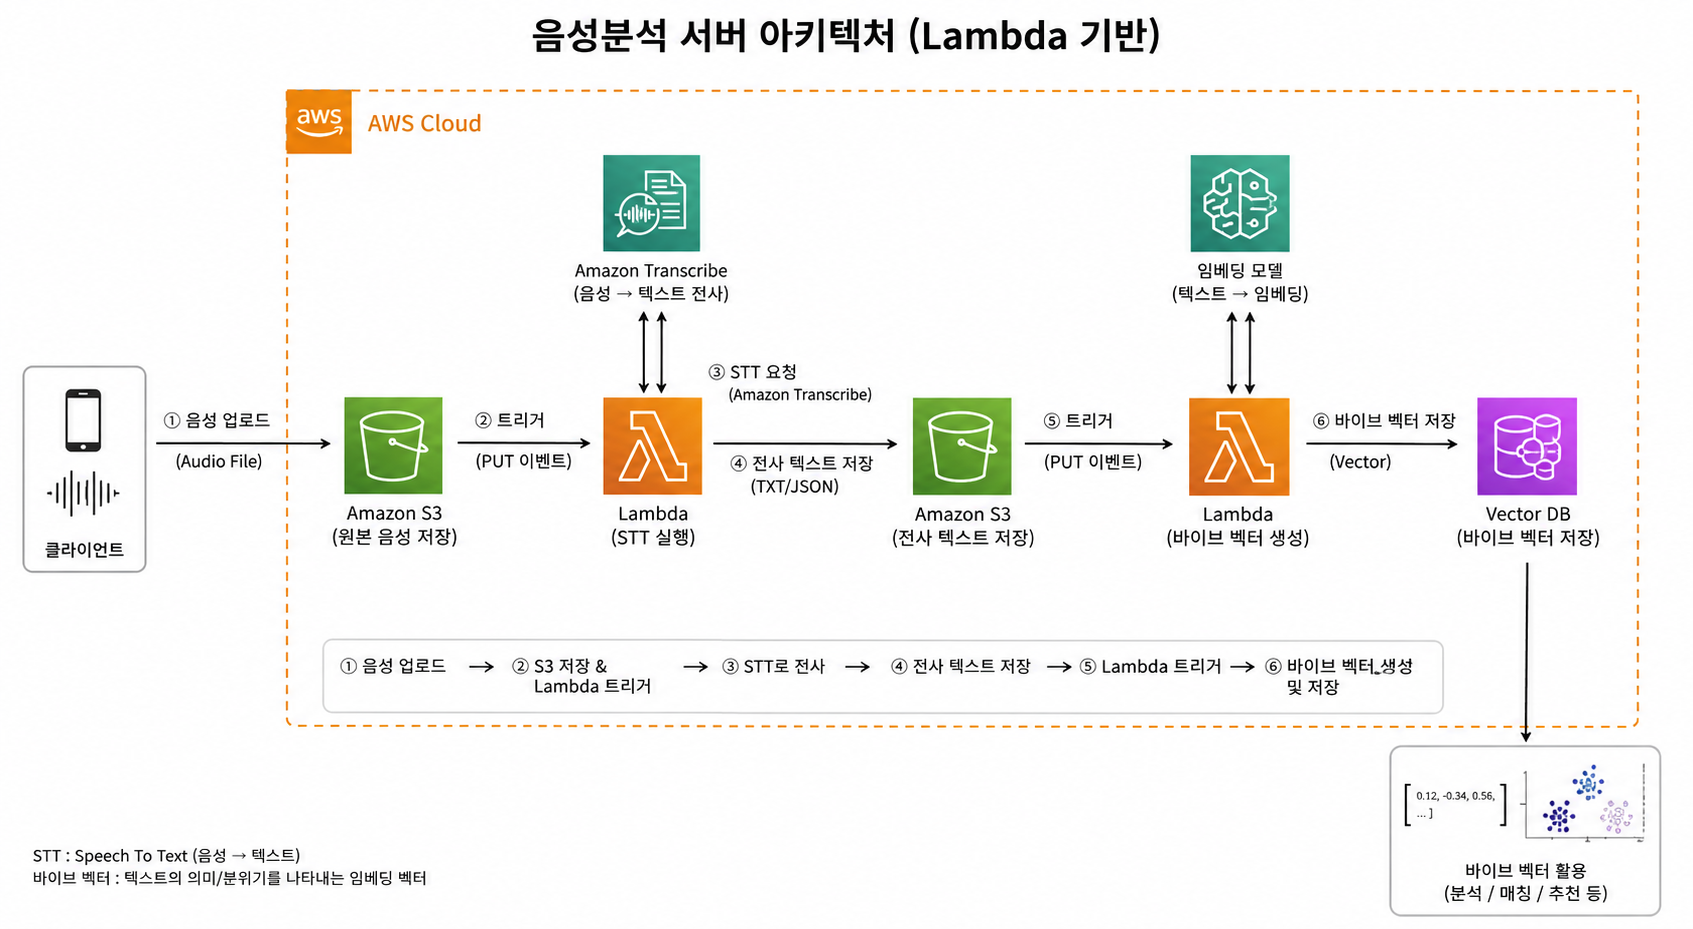
라는 말을 해주셨고, 우리는 서버리스, AWS 의 Lamda를 이용한 음성분석 방식을 버리고, AI 음성분석을 위한 서버를 하나 더 띄우기로 하였다.
아래에는 람다 함수를 적용한 음성분석 서버 아키텍처이다.
알게 된 사실 ..😅
최근에 학교에서 진행하는 온라인 교육으로 AWS CCP 자격증 공부를 하는 도중에,
람다 서비스에 대하여 알게되었는데 왜 서비비용이 많이 나왔는지 깨달았다 ..
람다 서비스는 서버리스로, 독립적인 서비스를 띄우는것이 아니라, 특정 상황, 특정 이벤트가 발생될때마다 실행되는 것이 람다 서비스이다.
즉 가장 람다 서비스가 적합한 구조는 요청이 적고, 트래픽이 몰리지 않는, 그리고 비동기 처리가 필요한 경우에 가장 적합한 것이다.
트래픽이 몰릴 경우 아래와 같은 문제가 발생하는데 ..
Warm start Vs Cold start
10:00 요청 → 환경 A 생성 → Whisper 로딩
10:01 요청 → 환경 A 재사용
10:30 환경 A 제거
11:00 요청 → 환경 B 생성 → Whisper 다시 로딩
이렇게 람다 서비스에서 모델을 재사용하는 경우를 warm start라고 하며
환경 B처럼 새로운 환경을 구축해서 다시 모델을 로딩하는 경우를 Cold Start 라고 한다.
문제는 트래픽이 몰릴 경우 , 모든 요청에 대해서 모델을 로딩해야하는 경우가 생긴다는 것.
동시에 모든 요청에 cold start를 해버리면 서버비용도 많이 나오고 자원을 비효율적으로 사용중이라는것이다.
그래서 이 람다 서비스는 24시간 띄워놓게 될 경우, 많은 요청이 몰릴 경우 매우매우 비효율 적이다.
효율이 사실 문제가 아니다. 돈이 엄청나게 많이 나가는 것이다.
이 구조로 설계한 동료분은 아마도 음성분석이 가끔 일어나는 이벤트정도라고 생각했던 것 같다 ..
하지만 이음 서비스는 음성분석이 메인 , 가장 주요한 기능이고, 프론트엔드와 백엔드 연동시에도 굉장히 많이 음성분석 테스트를 진행했던 터라 ..
사실상 24시간 람다 서비스가 구동되고 있었으며, 그래서 서버 비용이 많이 나왔던 것 같다
교훈 : 동료를 너무 믿지말자😩
Fastapi 의 목적
Fastapi란 ? 파이썬 언어로 RestFul API 서버를 구축할 수 있는 프레임 워크를 말한다.
사실 파이썬이라는 언어는 굉장히 무거운 언어이다. 파이썬은 파이썬 인터프리터로 실행되는 언어이기에 다른 자바, c언어 , TS와 같은 언어에 비해 웹개발에서 선호되는 프로그래밍언어는 아니었다.
하지만 모든 서비스에서 AI가 빠지지 않는 지금, 파이썬의 강점이 더 부각되기 시작하였고, 이를 웹서비스에 적용시키기 위해 Fastapi의 필요성이 증가하고 있다는 것이다.
이음 서비스에서 Fastapi의 목적은 다음과 같다.
외부 API인 OpenAI와의 파이프라인 구축 및 벡터 코사인 유사도 계산을 통한 추천 시스템 구축
이제 백엔드에는 두개의 서버가 존재하는 것이다.
Nestjs 백엔드 서버 , Fastapi AI 파이프라인 구현한 서버.
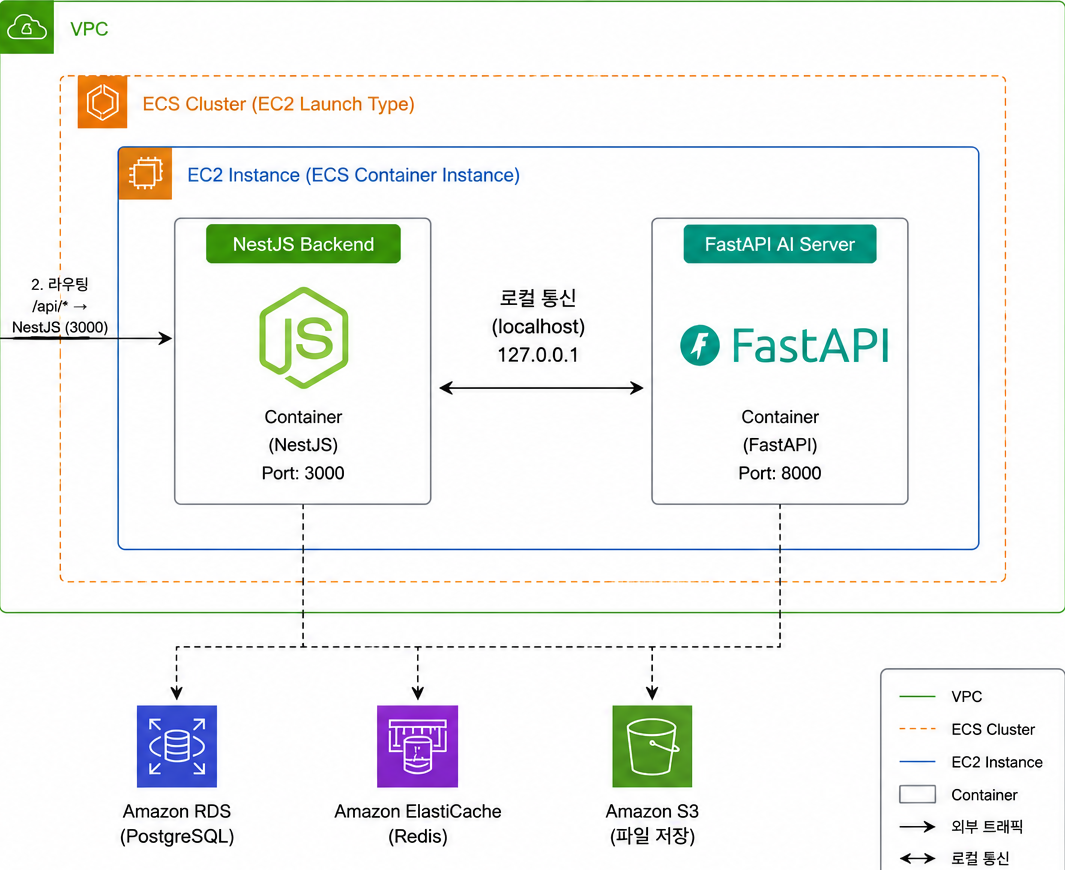
위의 그림 처럼 두개의 서버가 동일한 ECS안에서 로컬 통신으로 Nestjs 가 Fastapi를 호출하는 구조이다.동일한 DB를 공유하기 때문에, 책임분리를 위해서 Fastapi 서버는 DB에 데이터를 저장하거나 수정할 수 있는 권한을 주지 않았다.
Fastapi는 Read only만 할 수 있게 제약을 걸어두어 , Nestjs 서버에서만 데이터 생성, 수정, 삭제를 진행 할 수 있게 하였다.
Fastapi의 강점
📑 1. API 계약을 코드와 문서로 동시에 관리할 수 있다
FastAPI의 가장 큰 장점 중 하나는 API 계약(Contract) 을 코드와 문서에서 동시에 관리할 수 있다는 점이다.
요청(Request)과 응답(Response)을 Pydantic Model로 정의하면,
- ✅ Request Validation
- ✅ Response Validation
- ✅ 타입 힌트
- ✅ Swagger 문서
- ✅ 예제(Examples)
까지 자동으로 생성된다.
예를 들어 다음과 같이 Pydantic 모델만 정의하면 된다.
class AnalyzeVoiceProfileRequest(BaseModel):
    voiceUrl: str
그리고 API에서는
@app.post(
    "/voice/analyze",
    response_model=AnalyzeVoiceProfileResponse,
)
처럼 선언하기만 하면 Swagger 문서가 자동으로 생성된다.
🎯 장점
- 프론트엔드와 API 계약이 명확해진다.
- NestJS 백엔드에서도 어떤 요청을 보내야 하는지 쉽게 확인할 수 있다.
- 응답 형태가 변경되면 문서도 함께 변경된다.
- 문서와 실제 코드가 달라지는 문제를 줄일 수 있다.
즉, API 명세가 별도의 문서가 아니라 코드 자체가 되는 구조이다.
⚡ 2. 비동기 처리에 최적화되어 있다
AI 서버는 CPU 연산보다 외부 API를 기다리는 시간(I/O) 이 훨씬 많은 경우가 많다.
예를 들어 하나의 요청에서
- STT 수행
- LLM 호출
- Embedding 생성
- Keyword 추출
등이 함께 수행될 수 있다.
FastAPI는 async/await를 기본적으로 지원하기 때문에 이러한 작업을 효율적으로 처리할 수 있다.
예를 들어
embedding_task = asyncio.create_task(create_embedding())
keyword_task = asyncio.create_task(extract_keywords())

await asyncio.gather(
    embedding_task,
    keyword_task,
)
처럼 두 작업을 동시에 실행할 수 있다.
❌ 순차 실행
Embedding
    ↓
Keyword
    ↓
완료
✅ 병렬 실행
Embedding ─────┐
               ├── 완료
Keyword ───────┘
이를 통해 전체 응답 시간을 크게 줄일 수 있다.
🤖 3. AI 기능을 메인 백엔드와 자연스럽게 분리할 수 있다
프로젝트에서는 역할을 다음과 같이 분리하였다.
NestJS
├── 회원 관리
├── 인증
├── 비즈니스 로직
├── 채팅
└── API Gateway

            │

            ▼

FastAPI
├── STT
├── LLM
├── 임베딩 생성
├── 추천 시스템
└── 벡터 연산
즉,
NestJS는 서비스 로직을 담당하고,
FastAPI는 AI 연산 전용 서버 역할을 수행하는 구조이다.
🎯 장점
- AI 모델 교체가 쉽다.
- Python 생태계를 그대로 사용할 수 있다.
- AI 서버만 독립적으로 배포할 수 있다.
- 트래픽 증가 시 AI 서버만 Scale-Out 할 수 있다.
마이크로서비스 구조를 구성하기에도 매우 적합한 방식이다.
🗄️ 4. 의존성 주입(Dependency Injection)으로 DB 관리가 깔끔하다
FastAPI는 Depends()를 통해 필요한 객체를 자동으로 주입받을 수 있다.
예를 들어
db: AsyncSession = Depends(get_db)처럼 작성하면 된다.
실제 DB 연결 생성 및 종료는
yield session으로 관리된다.
즉,
요청
    ↓
DB Session 생성
    ↓
API 실행
    ↓
자동 Session 종료
개발자는 비즈니스 로직에만 집중하면 된다.
🎯 장점
- DB 연결 누수를 방지할 수 있다.
- 코드가 단순해진다.
- 테스트하기 쉬워진다.
- Session 생성 로직이 한 곳에서 관리된다.
🧠 5. Python AI 생태계를 그대로 활용할 수 있다
FastAPI의 가장 큰 강점은 Python AI 생태계를 그대로 사용할 수 있다는 점이다.
프로젝트에서는
- OpenAI SDK
- NumPy
- SQLAlchemy
- pgvector
- Async PostgreSQL
등을 함께 사용하고 있다.
예를 들어 추천 시스템에서는
cosine_similarity(...)를 이용하여 사용자 간 유사도를 계산하고,
PostgreSQL에서는
embedding <=> queryVector연산을 이용하여 벡터 검색을 수행한다.
Python에서는 이러한 라이브러리를 매우 자연스럽게 사용할 수 있다.
함께 사용할 수 있는 대표적인 라이브러리
- 🤖 OpenAI SDK
- 🧠 Transformers
- 🎙️ Whisper
- 🚀 Faster-Whisper
- 📈 NumPy
- 🐼 Pandas
- 🔍 pgvector
- 🔥 PyTorch
- 📊 Scikit-learn
AI 프로젝트에서는 Python 생태계 자체가 하나의 큰 장점이 된다.
📌 정리
FastAPI는 단순히 "빠른 웹 프레임워크" 가 아니다.
AI 서비스를 개발하는 입장에서는 다음과 같은 강점을 제공한다.
| ✅ 특징 | 장점 |
|---|---|
| 📑 API 계약 관리 | 코드와 Swagger 문서를 동시에 관리할 수 있다. |
| ⚡ 비동기 처리 | 외부 AI 호출을 병렬 처리하여 응답 시간을 줄일 수 있다. |
| 🤖 AI 서버 분리 | NestJS와 역할을 분리하여 마이크로서비스 구조를 만들기 쉽다. |
| 🗄️ 의존성 주입 | DB 세션을 안전하고 깔끔하게 관리할 수 있다. |
| 📦 공통 응답 구조 | 성공·실패 응답을 일관성 있게 관리할 수 있다. |
| 🧠 Python 생태계 | OpenAI, Whisper, NumPy, pgvector 등 AI 라이브러리를 그대로 활용할 수 있다. |
🎯 마무리
바이브 벡터 연산에 대하여 MySql 서버는 지원을 하지 않아, 벡터 자료형을 지원하는 Postgre DB로의 마이그레이션까지 진행하였다.
본래의 MySql DB를 사용할때에는 vibevector , 벡터 자료형을 지원해주지 않아, vibevector를 json형태로 직렬화하여 저장하는 형태였다.
즉 유사도 측정을 위해 벡터를 계산하기 위해서는 그 모든 벡터들을 불러와서 json 형태를 다시 벡터 형식으로 직렬화하고 계산하고 다시 json 형태로 저장해야하는 병목이 존재하였는데,
Postegre DB로의 마이그레이션으로 이 병목을 해결함과 동시에, Fastapi 접목을 통해서 비동기 처리 및 파이썬 생태계를 사용한 추천 시스템 구축을 할 수 있었다.
이제 정말 출시가 얼마 남지 않았는데, 서비스가 커지는 경우에는 STT 모델을 외부api (OpenAPI)로 끌어와서 사용하는것이 아니라, STT 모델을 Fastapi에서 직접 구축하여 외부 의존성을 줄이고 직접 구축하는 방향으로 발전시켜보아야겠다 !
지금은 MVP단계에서 많은 사용자들의 호응과 반응을 얼른 보고싶다는 마음 뿐이다.