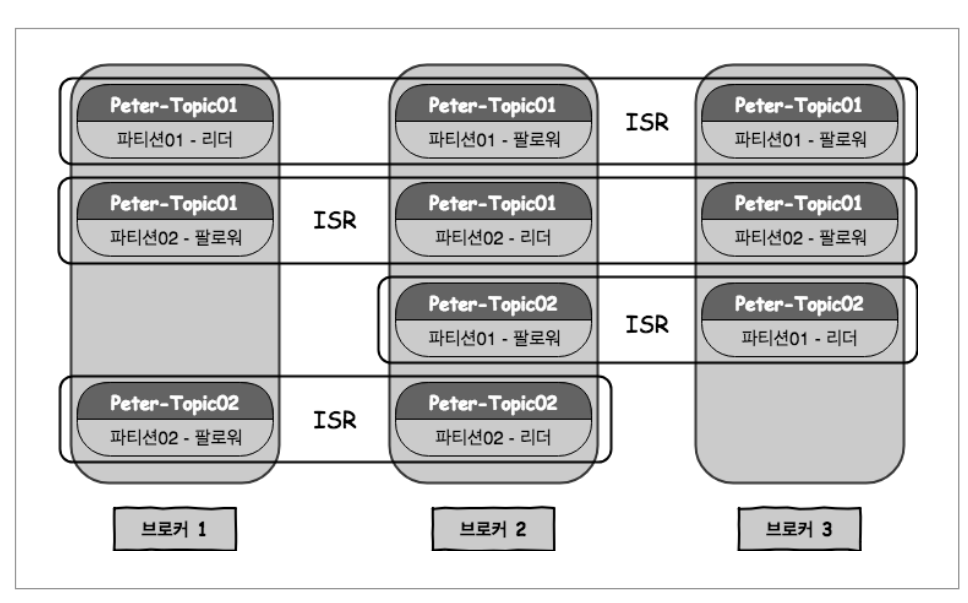
1. 카프카 디자인 특징
1.1 분산 시스템
1.2 페이지 캐시
카프카는 OS의 페이지 캐시를 사용해서 성능을 올렸다.
이 덕분에 가장 저렴한 SATA 디스크를 사용해도 무방하다.
1.3 배치 전송 처리
2. 카프카 데이터 모델
토픽
카프카 클러스터는 토픽이라는 곳에 데이터를 저장한다.
파티션
메시지 전송과 속도를 높이기 위해 파티션 수를 늘린다.
예시로 토픽 : 파티션 = 1 : 1인 상황에서 메시지 1초 처리하는 경우 4개의 메시지를 처리하는데 4초가 걸린다.
파티션이 4개라면 1초가 걸린다.
즉 병렬처리가 가능하다.
파티션을 늘리면 좋은 것인가?
- 파일 핸들러 낭비
- 장애 복구 시간 증가
오프셋과 메시지 순서
오프셋은 하나의 파티션 내에서만 유일한 숫자
3. 카프카의 고가용성과 리플리케이션
높은 가용성을 제공하기 위해 리플리케이션 기능을 제공
토픽이 아닌 파티션을 복제한다.
리플리케이션 팩터와 리더, 팔로워의 역할
리더는 쓰기, 읽기를 담당하고 팔로워는 복제만을 담당한다.
리더가 다운되면 팔로워 중 하나가 리더로 선출이 된다.
(리플리케이션 팩터)RF=3이면 한 파티션의 리더 1개 + 팔로워 2개 = 총 3개의 복제본
리더와 팔로워 관계
팔로워는 리더를 바라보며 자신에게 없는 데이터를 리더에서 가져오며 정합성을 지킨다. 이때 팔로워가 다운되어 리더에서 데이터를 못 가져오는 등의 데이터 정합성이 깨질때 해당 팔로워가 리더로 승격될 때 데이터 유실이 생긴다.
이를 해결하기 위해 ISR(In Sync Replica)이라는 개념이 도입되었다.
ISR의 중요한 규칙으로는 ISR 그룹만이 리더의 자격을 가질 수 있다.
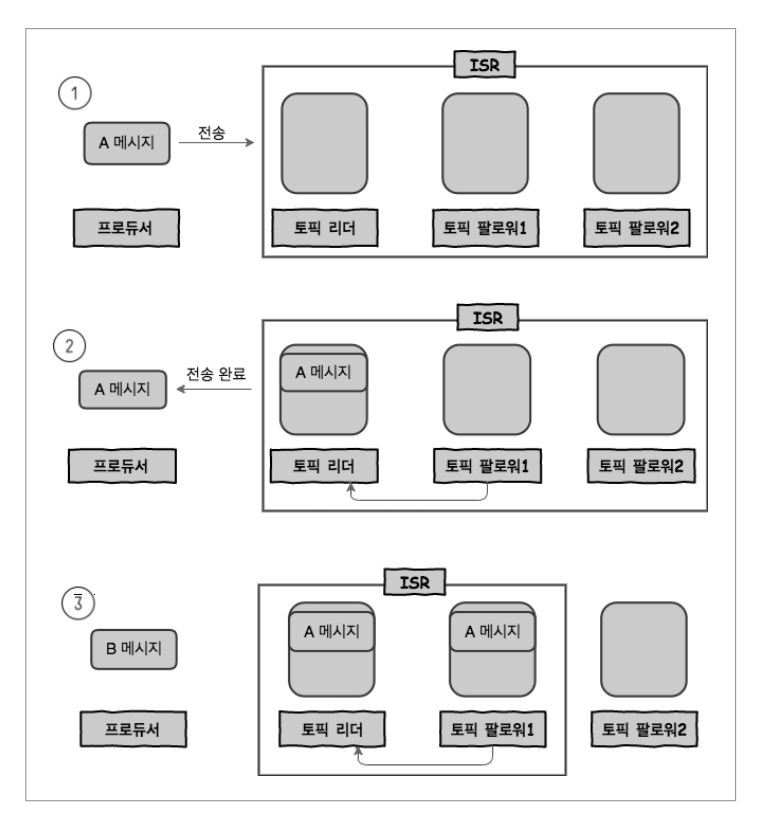
리더가 팔로워들이 데이터를 잘 갱신하는지 확인 하면서 문제가 있는 팔로워는 ISR에서 제외 시킨다.
위 이미지같이 ISR 그룹을 만들어 리플리케이션의 신뢰성을 높인다.
4. 모든 브로커가 다운 된다면?
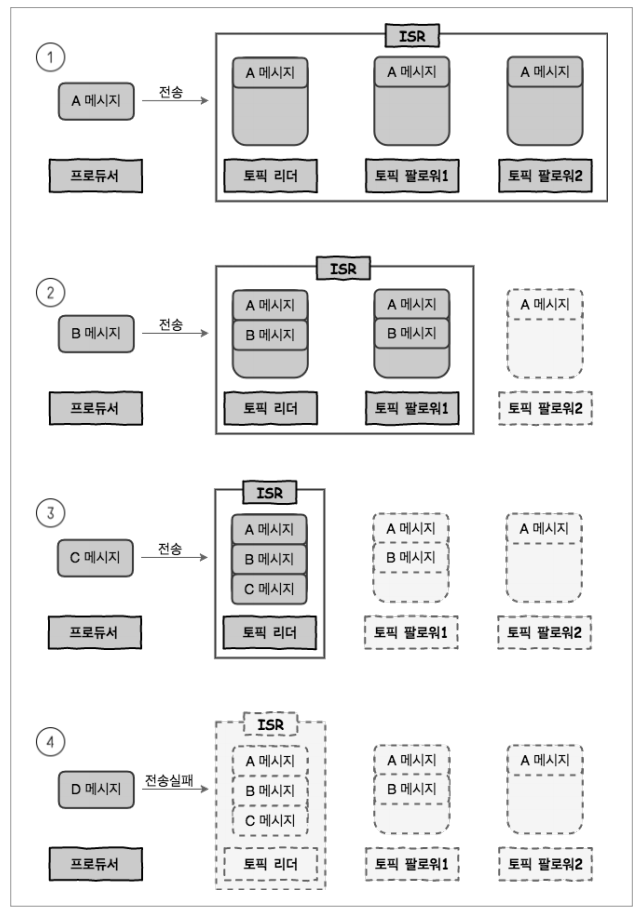
위와 같은 상황에서 할 수 있는 방법은
1. 마지막 리더를 기다린다.
2. ISR에 추방되었지만 먼저 살아나면 리더로 승격한다.
- 1번의 경우 반드시 마지막 리더를 먼저 시작되어야 하고 다른 브로커는 살아났는데 마지막 리더만 복구하는데 오래 걸리면 서비스 장애가 장기화될 수 있다. 이 경우 성공한다면 메시지 손실이 없이 서비스를 시작할 수 있다.
- 2번의 경우는 메시지 손실이 발생한다. 팔로워 2가 살아난다면
B, C 메시지는 손실이다. 이 방법은 빠르게 서비스를 시작할 수 있다.
unclean.leader.election.enable = true -> 2번 방안
unclean.leader.election.enable = false -> 1번 방안
가용성과 일관성을 고려해서 선택해야 한다.
파티션과 리플리케이션