1. 복제
필요성
- 시스템 장애가 발생하더라도 지속적인 동작
- 처리량 증가 및 서버의 부하 분산
- 지역 사용자에게 빠른 서비스 제공
A-서울, master
B-부산, 복제
C-제주, 복제
위와 같은 지역에 데이터 센터를 운영한다면 가까운 지역의 DB를 사용하면 더 빠르다.
3곳의 데이터 센터로 부하가 분산된다.
A가 장애가 발생해도 B,C가 살아 있어 지속적으로 동작할 수 있다 (가용성)
어려움
데이터 일관성을 맞추는 것이 힘들다.
이것을 해결하기 위해 단일 리더, 다중 리더, 리더 없는 복제 알고리즘을 설명한다.
2. 단일 리더 복제
리더와 팔로워
카프카에서 배웠던 내용과 유사하다.
- 쓰기는 리더에서만 한다.
- 읽기는 리더와 팔로워 둘다 가능하다.
- 리더는 데이터를 변경하고 복제로그 or 복제 스트림을 팔로워에게 전송한다.
- 팔로워는 리더와 같은 흐름으로 쓰기를 적용하여 데이터베이스를 갱신한다.
동기식 복제
모든 팔로워가 데이터를 저장할 때 까지 기다린다.
장점: 높은 일관성
단점: 전체 성능에 영향
비동기식 복제
리더가 변경된 로그를 팔로워에게 전송하고 완료를 기다리지 않는다.
장점: 데이터 변경 성능이 높다.
단점: 낮은 일관성
반동기식 복제
n개의 팔로워가 데이터 변경을 성공할 때 까지 기다린다.
장점 : 동기식 복제 보다 빠르다.
단점 : 비동기식 보다는 느리고 일관성도 낮다.
장애 처리하기
- 팔로워 장애
- 마지막 트랜잭션을 확인한다.
- 복구 후, 리더에게 장애 동안 받지 못한 데이터를 받는다.
- 정상적으로 진행한다.
- 리더 장애
-
팔로워 중에 하나를 리더로 승격한다.
-
리더가 장애인지 확인한다.
-
리더를 선택하고 팔로워를 리더로 사용하기 위해 시스템을 설정해준다.
- 비동기식 복제일 때 데이터 일관성의 문제로 데이터가 누락될 수 있다.
- 카프카에서는 ISR등으로 해결했다.
복제 로그 방식
- 구문기반 복제
- WAL(write-ahead log) : 쓰기 전 로그 저장 후 로그 파일을 팔로워에게 전송
- Row 기반 복제 : 테이블에서 변경된 row를 식별하고 데이터를 복제하는 방법 CDC(change data capture)
- 트리거 기반 복제 : 데이터가 변경 되면 application에서 트랜잭션 처리
2,3 번을 많이 사용한다.
복제 지연 시(비동기 복제 방식) 해결 방법
-
쓰기 후 읽기 일관성
리더에 쓰기 후, 특정 시간 또는 타임스탬프를 활용하여 일정 시간 동안 리더에서 값을 읽는 방법 -
단조 읽기 : 동일한 팔로워에서 읽기가 동작되도록 한다.
복제를 할때 데이터 베이스의 상황에 따라 A-1분 B-10분으로 처리 시간이 달라질 수 있다.
이 경우 A와 B에서 읽기가 발생하면 데이터가 있다가 없어지는 문제가 발생하는데 이를 해결하는 방법이다. -
일관된 순서로 읽기
샤딩된 데이터 구조에서 흔히 발생된다.
일련의 데이터가 순서대로 읽을 수 있도록 보장한다.
예시로 리뷰는 보이는데 게시글이 안보이는 문제가 없도록 하는 것.
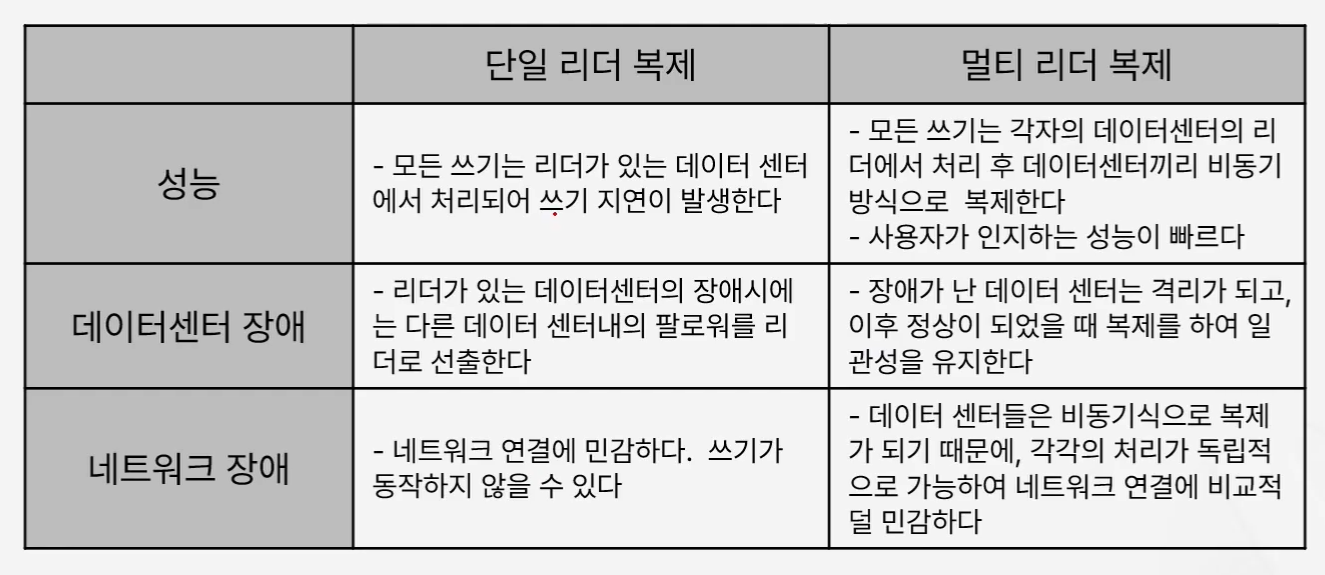
3. 멀티 리더 복제
데이터 센터를 예시로
데이터 센터 마다 리더가 있는 형식을 가정한다.
데이터 센터의 각 리더들은 서로의 변경 사항을 비동기식 변경 사항으로 복제한다.
단일 리더 복제와의 차이
멀티 리전 복제 환경에서 해결하기 어려운 쓰기 충돌
각 데이터 센터에서 같은 데이터를 변경할 때, 정상적으로 수행이 된다.
하지만 이후 리더들은 복제할 때 어떤 데이터를 반영할지 충돌이 생긴다.
- 전략
-
쓰기에만 리더간 동기식 복제를 한다.
멀티 리전을 사용의 주요한 장점을 잃는다. 독립적인 처리가 불가능 -
특정 데이터는 특정 데이터 센터로 라우팅한다.
데이터 센터 장애 발생시 다시 라우팅 해야 하고 복잡하다. -
마지막 기록만을 저장한다. last write win 전략
데이터 유실의 가능성이 존재한다. -
애플리케이션으로 사용자가 정의하는 전략 (모든 쓰기 충돌을 기록하거나 자동으로 충돌 해소)
코드에 따라서 예외가 발생할 수 있다.
4. 리더 없는 복제
- 리더가 존재하지 않으면 모든 복제 서버들은 client로 부터 쓰기를 직접 처리가 가능하다.
- 장애 복구가 필요하지 않다.
쓰기
- client는 모든 복제 서버에 쓰기를 요청한다.
- 복제 서버는 응답을 한다.
- n개 이상의 응답을 받으면 쓰기 성공으로 처리한다. 나머지 DB는 신경 쓰지 않는다.
읽기 일관성 보장
- client는 모든 복제 DB에 질의를 한다.
- 복제 DB는 가장 최신의 데이터를 client에게 응답한다.
- 읽기 시점에 데이터가 다른 경우, 해당 db를 최신 데이터로 복구한다.(읽기 복구)
주기적으로 DB를 비교하여 최신 버전으로 업데이트한다.(anti entropy)- 정족수 w(쓰기 성공 수) + r(읽기 요청 수) > n(복제 DB 수) => 최신값 얻을 수 있다.
쓰기 충돌 발생 가능
네트워크 지연등으로 쓰기 이벤트는 서로 다른 순서로 도착할 수 있다.
-
마지막 기록만을 저장한다. last write win 전략
데이터 유실의 가능성이 존재한다. -
애플리케이션으로 사용자가 정의하는 전략 (모든 쓰기 충돌을 기록하거나 자동으로 충돌 해소)
코드에 따라서 예외가 발생할 수 있다.
요약
- 복제는 고가용성, 부하 분산, 지역적 처리를 위해서 사용한다.
- 데이터 복제의 방식에는 단일 리더, 멀티 리더, 리더 없는 복제 방식이 있다.
- 단일 리더는 클러스터에 리더 하나로 되어있다. 리더에서만 쓰기를 하고 변경 로그를 팔로워에 전송한다. 리더 장애시 팔로워 중에 리더 승격을 해야한다.
- 멀티 리더는 클러스터에 데이터 센터 마다 리더가 있다. 리더들 간 데이터 변경 로그를 전송하는 단계가 있다.
- 리더 없는 복제는 쿼럼(정족수)를 고려하여 여러개의 노드에 쓰기, 읽기 처리와 일관성을 위한 데이터 현행화 작업을 수행한다.
- 멀티 리더와 리더 없는 복제는 쓰기 충돌이 발생하므로 해결 방법을 생각해야 한다.
