개요
친절한 SQL을 학습하면서 파티셔닝의 중요성을 알게 되었는데 정작 이론만 알고 있지 대용량 데이터 경험이 없다보니 사용해본적도 없고 이와 유사한 샤딩에 대한 개념도 제대로 알고 있지 않아서 정리해 보고 싶어 작성하게 되었다.
0. 상황
고객 1000만명
월 평균 1억건 구매
레코드 당 100 bytes인 경우
년간 1.2 테라 데이터 누적
1. 데이터 증가에 따른 문제점
성능 문제
- 응답 지연 발생(테이블과 인덱스 사이즈 증가, 처리하는 범위 증가)
- DML 성능 문제 (Lock)
관리적인 어려움 발생
- 데이터 로드, 인덱스 생성 및 재구축, 마이그레이션 시간 증가 복잡도 증가
- 데이터 백업 및 복구 난이도 증가
2. 파티셔닝 장점
월별로 쪼개서 관리한다.
- 파티션 단위로 처리가 가능하기 때문에 백업&삭제가 유리하다.
- 데이터 처리가 분산되어 자원경합이 줄어들 수 있다.
- 파티셔닝된 테이블의 접근 속도가 증가한다.
3. 파티셔닝 전략
수평, 수직 파티셔닝 방법이 있는데, 수평 파티셔닝을 다루겠다.
범위 파티셔닝
CREATE TABLE 구매이력 (
구매번호 varchar(10),
구매일자 varchar(8),
고객ID INT,
PRIMARY KEY (`구매번호`, `구매일자`)
)
PARTITION BY RANGE (구매일자) (
partition p202401 values less than ('20240201')
,partition p202402 values less than ('20240301')
,partition p202403 values less than ('20240401')
,partition p999912 values less than ('MAXVALUE')
);
범위 기반이 대부분인 경우, 균등한 데이터 분포, 특정 기간 마다 데이터 관리가 필요한 경우
가장 많이 사용하는 파티셔닝 전략이다.
개념
지정한 범위 값에 따라 데이터를 분할하는 방식.
예시
주문일자 컬럼을 기준으로 1월~3월 데이터는 파티션1, 4월~6월은 파티션2 … 이런 식으로 나눔.
장점
날짜나 숫자와 같이 순차적으로 증가하는 값에 적합.
특정 구간의 데이터를 조회할 때 효율적.단점
데이터가 특정 범위에 집중되면(예: 최근 일자) 한쪽 파티션에만 데이터가 몰릴 수 있음 → 데이터 불균형 문제 발생.
해시 파티셔닝
CREATE TABLE 구매이력 (
구매번호 varchar(10),
구매일자 varchar(8),
고객ID INT,
PRIMARY KEY (`구매번호`, `구매일자`))
PARTITION BY HASH(고객ID) partitions 4;
개념
특정 컬럼 값에 해시 함수를 적용하여 파티션을 결정하는 방식.
예시
회원ID % 4 → 나머지 값(0~3)에 따라 4개 파티션으로 분산.
장점
데이터가 균등하게 분산됨 → 특정 파티션에 쏠림 방지.
조인이나 검색 시 병렬 처리 효율적.단점
범위 조회(예: 1월~3월 주문) 시 비효율적 → 모든 파티션을 다 뒤져야 할 수도 있음.
리스트 파티셔닝
CREATE TABLE 구매이력 (
구매번호 varchar(10),
구매일자 varchar(8),
고객ID INT,
구매상품카테고리ID varchar(10)
PRIMARY KEY (`구매번호`, `구매일자`))
PARTITION BY LIST(구매상품카테고리ID) (
partition p_item01 values ('ELECTRONICS')
,partition p_item01 values ('DEFAULT')
);
개념
미리 정의한 특정 값의 집합(List)에 따라 데이터를 분할.
예시
지역 기준으로 서울/경기 → 파티션1, 충청/강원 → 파티션2, 부산/경상 → 파티션3 …
장점
범위로 표현하기 어려운 불연속적인 값 처리에 유용.
단점
새로운 값(예: 새로운 지역 코드)이 추가되면 파티션 정의를 수정해야 함 → 관리 비용 증가.
결합 파티셔닝
범위 + 해시를 가장 많이 사용한다.
개념
두 가지 이상의 파티셔닝 방식을 조합해서 사용.
예시
1차: 주문일자 기준 범위 파티셔닝
2차: 각 범위 파티션 내에서 회원ID 기준 해시 파티셔닝장점
각 파티셔닝 방식의 단점을 보완 가능.
대규모 데이터셋에서도 균형과 효율성 확보.단점
설계와 관리가 복잡해짐.
4. 인덱스 파티셔닝
prefixed : 테이블의 파티션 키와 인덱스 leading 컬럼이 같은 경우
prefixed 파티셔닝 로컬 : 이력성 데이터를 효과적으로 사용할 수 있다.
nonprefixed 파티셔닝 로컬 : 범위검색 조건일 때 효과적일 수 있다.
비파티션 인덱스 : 일반 인덱스 (OLTP 환경에서 유리하다.)
5. kafka 파티셔닝
kafka-topics
--create
--bootstrap-
server
localhost:9092
--replication-
factor 1
--partitions 4
-- topic database
이벤트는 토픽에 저장된다. 토픽은 파티션으로 나누어져 있다. 새 이벤트는 하나의 파티션에 저장된다.
해시 파티셔닝을 적용한다. 파티셔너에 의해 이벤트가 토픽에 해시값으로 분배해서 파티션에 저장을 한다.
6. 샤딩
파티셔닝 범주이나 데이터를 여러 개의 서버로 분산 저장하는 개념
몽고DB는 샤딩을 통해 수평적 확산을 지원한다.
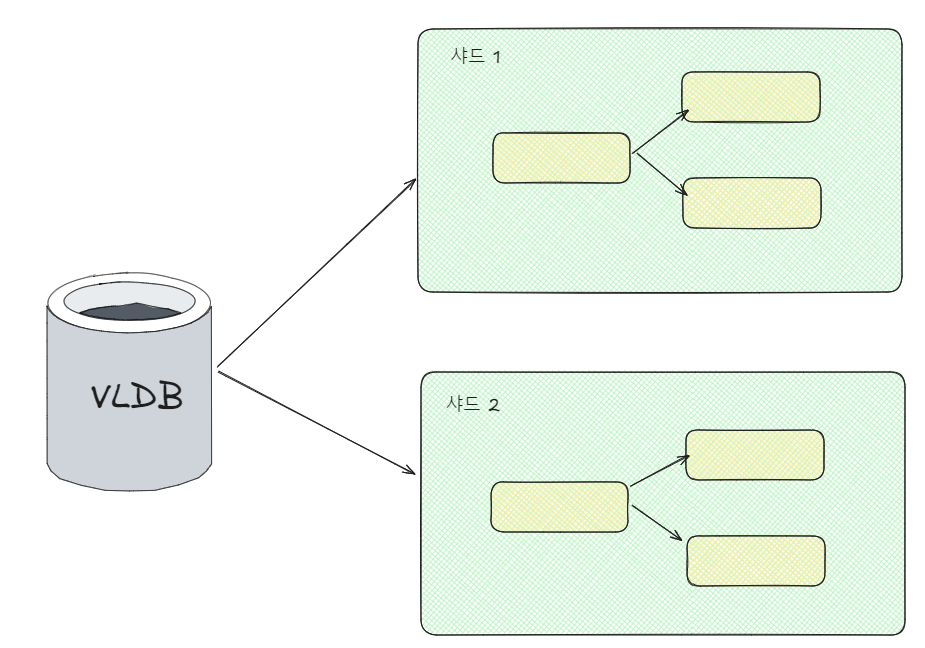
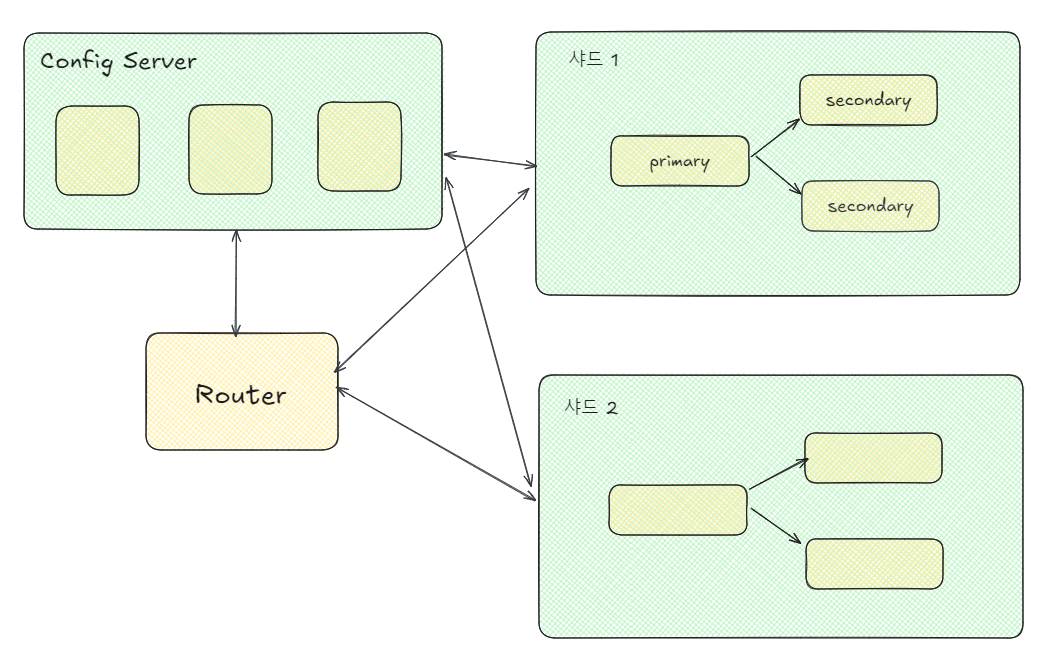
샤드 클러스터
몽고DB
Router : 쿼리를 받는 부분
config server : 메타데이터 저장
shard : 저장 부분
샤드 키로 인한 문제
- Jumbo Chunk: 샤드 키의 cardinality가 낮은 경우(중복이 많다) 거대한 처크를 만들어 효율적으로 분산하지 못한다.
- Uneven Load Distibution: 고르지 못한 저장으로 hot shard, hot chunk 현상 발생
- Decreased Query prerformance Over Time: 샤드 키가 포함되지 않는 쿼리가 발생하는 문제
