Pytorch에서 제공하는 nn.Module Transformer 모델을 이용하여 주가예측을 해보는 프로젝트입니다. 이번엔 코드 분석 위주로 작성하였고, 추후 성능 개선을 통해 그럴듯한 예측을 할 수 있을지 확인 해보려고 합니다.
1. load_and_preprocess_data() 정의
데이터를 다운로드하고 전처리한 뒤 학습 데이터와 평가 데이터를 나누는 부분이다.
def load_and_preprocess_data(ticker, start_date, end_date, features=['Close', 'Volume', 'Open', 'High', 'Low'], split_ratio=0.8):
    """
    yfinance를 사용하여 주가 데이터를 다운로드하고, 지정한 features를 선택 후 정규화 및 학습/테스트 분할을 수행합니다.
    """
    df = yf.download(ticker, start=start_date, end=end_date)
    data = df[features].values  # shape: [num_samples, num_features]
    scaler = MinMaxScaler(feature_range=(0, 1))
    data_scaled = scaler.fit_transform(data)
    split_idx = int(len(data_scaled) * split_ratio)
    train_data = data_scaled[:split_idx]
    test_data = data_scaled[split_idx:]
    return train_data, test_data, scaler
1) data는 데이터프레임 df을 values로 처리하여 만든 numpy배열이다. 크기는 [num_samples, num_features] 가 된다.
data = df[features].values

		data :
        [
          ...
          [120.15, 30000000, 119.50, 121.00, 119.10],
          [121.45, 35000000, 120.80, 122.50, 120.50],
          [119.90, 40000000, 120.00, 121.50, 118.80],
          ...
        ]
2) MinMaxScaler는 최소 최대값을 정해 정규화하는데, 여기서 0과 1 사이의 값으로 정규화한다. 여기서 data를 그대로 넣는데, 이러면 각 features별로 정규화된다.
	scaler = MinMaxScaler(feature_range=(0, 1))
    data_scaled = scaler.fit_transform(data)
3) 학습 데이터 80%, 평가 데이터 20% 비율로 정규화된 data를 분리한다.
    split_idx = int(len(data_scaled) * split_ratio)
    train_data = data_scaled[:split_idx]
    test_data = data_scaled[split_idx:]
2. TimeSeriesDataset(Dataset) 정의
데이터를 학습하기 위한 형태로 Dataset을 만드는 부분이다.
class TimeSeriesDataset(Dataset):
    def __init__(self, data, seq_length):
        self.data = torch.tensor(data, dtype=torch.float32)
        self.seq_length = seq_length

    def __len__(self):
        return len(self.data) - self.seq_length

    def __getitem__(self, idx):
        src = self.data[idx:idx + self.seq_length]  # [seq_length, num_features]
        tgt = self.data[idx + self.seq_length]       # [num_features]
        return src, tgt

def create_dataloader(data, seq_length, batch_size, shuffle=True):
    dataset = TimeSeriesDataset(data, seq_length)
    loader = DataLoader(dataset, batch_size=batch_size, shuffle=shuffle)
    return loader
1) __init__에서는 인자로 받은 train_data를 텐서로 변환한 self.data객체를 생성하고, 하나의 샘플로 사용될 시퀀스 길이 self.seq_length를 생성한다.
2) __len__에서는 유효 샘플 개수를 반환하는 부분인데, 전체 data 개수에서 시퀀스 길이만큼 빼주는 이유는 전체 학습 데이터에서 시퀀스 길이만큼은 그 다음 시점이 존재하지 않으므로 실제값과 예측값 비교를 할 수 없어 학습에 유효하지 않은 샘플이기 때문이다.
[예시]

전체 데이터 인덱스: 0, 1, 2, 3, 4, 5, 6, 7, 8, 9 (총 10개)
시퀀스 길이 : 3

초기 입력 시퀀스 (샘플1 = idx0) : 0, 1, 2 -> 예측값 3 <-> 실제값 3
다음 입력 시퀀스 (샘플2 = idx1) : 1, 2, 3 -> 예측값 4 <-> 실제값 4
다음 입력 시퀀스 (샘플3 = idx2) : 2, 3, 4 -> 예측값 5 <-> 실제값 5
다음 입력 시퀀스 (샘플4 = idx3) : 3, 4, 5 -> 예측값 6 <-> 실제값 6
다음 입력 시퀀스 (샘플5 = idx4) : 4, 5, 6 -> 예측값 7 <-> 실제값 7
다음 입력 시퀀스 (샘플6 = idx5) : 5, 6, 7 -> 예측값 8 <-> 실제값 8
다음 입력 시퀀스 (샘플7 = idx6) : 6, 7, 8 -> 예측값 9 <-> 실제값 9
다음 입력 시퀀스 (샘플8 = idx7) : 7, 8, 9 -> 예측값 ? <-> 실제값 ?  <<<<<<<<<< 유효하지 않은 샘플

만약 idx = 7을 시도한다면, src = [7, 8, 9]까지는 가능하지만,
그 다음 시점(인덱스 10)의 데이터가 존재하지 않기 때문에 샘플을 만들 수 없다.
3) __getitem__에서는 시계열 데이터를 일정 길이(\text{seq_length})만큼 잘라서 입력(src)으로 쓰고, 그 다음 시점에해당하는 값(tgt)을 타겟으로 설정한다.
self.data[idx:idx + self.seq_length] : 현재 인덱스(idx)부터 idx + seq_length 직전까지의 데이터를 잘라서 입력 시퀀스로 사용 (길이가 있는 시퀀스임)
self.data[idx + self.seq_length] : 위 입력 시퀀스가 끝난 다음 시점의 데이터로 target에 해당 (어느 한 시점임)
-> 유효한 샘플 개수가 몇개인지 그리고 현재 인덱스(시점)에 따라 입력 시퀀스와 타겟을 설정하여 dataset 객체에 담는다.
그리고 loader를 생성하여 학습 시 배치 사이즈 32와, 셔플을 하도록 설정해준다
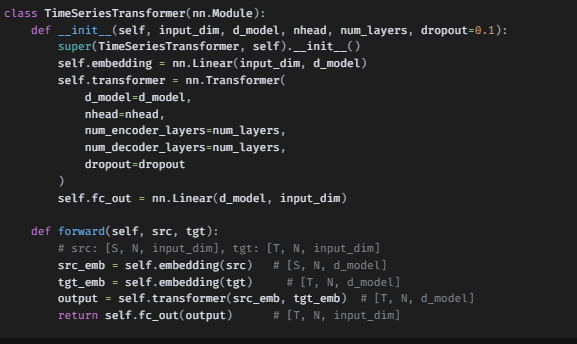
3. TimeSeriesTransformer(nn.Module) 정의
Transformer 기반 시계열 예측 모델을 정의하는 부분이다.
class TimeSeriesTransformer(nn.Module):
    def __init__(self, input_dim, d_model, nhead, num_layers, dropout=0.1):
        super(TimeSeriesTransformer, self).__init__()
        self.embedding = nn.Linear(input_dim, d_model)
        self.transformer = nn.Transformer(
            d_model=d_model,
            nhead=nhead,
            num_encoder_layers=num_layers,
            num_decoder_layers=num_layers,
            dropout=dropout
        )
        self.fc_out = nn.Linear(d_model, input_dim)

    def forward(self, src, tgt):
        # src: [S, N, input_dim], tgt: [T, N, input_dim]
        src_emb = self.embedding(src)   # [S, N, d_model]
        tgt_emb = self.embedding(tgt)     # [T, N, d_model]
        output = self.transformer(src_emb, tgt_emb)  # [T, N, d_model]
        return self.fc_out(output)      # [T, N, input_dim]
1) 초기 Linear layer :
우리가 설정한 Feature를 참고해서 보면, 하나의 시퀀스 안에 어느 한 시점은 5차원(Close, Volume, Open, High, Low) 으로 되어 있다. 그래서 임배딩 벡터(d_model) 차원으로 변환이 필요하다.
2) Transformer 블록 :
인코더-디코더 구조로, 실제 시계열 상호작용을 학습하는 부분으로 멀티 헤드 어텐션, 피드 포워드 네트워크 등을 통해 d_model 차원의 텐서를 입력 받아, 같은 d_model 차원의 출력을 내보낸다.
3) 최종 Linear layer :
Transformer의 d_model 차원 출력을 다시 5차원(Close, Volume, Open, High, Low)으로 되돌리는 작업이다.
4. train_model() 정의
train_loader로부터 src, tgt를 튜플로 가져와 모델 학습을 진행한다.
def train_model(model, train_loader, device, epochs, learning_rate=0.001):
    model.train()
    criterion = nn.MSELoss()
    optimizer = optim.Adam(model.parameters(), lr=learning_rate)
    scheduler = StepLR(optimizer, step_size=20, gamma=0.5)  # 20 에폭마다 lr 0.5배 감소

    for epoch in range(epochs):
        epoch_loss = 0
        for src, tgt in train_loader:
            src = src.to(device)   # [batch, seq_length, input_dim]
            tgt = tgt.to(device)   # [batch, input_dim]

            # Transformer 입력은 [sequence_length, batch, feature]
            src = src.transpose(0, 1)  # [seq_length, batch, input_dim]
            # 디코더 입력: 단일 스텝 예측을 위해 0 벡터 사용 (shape: [1, batch, input_dim])
            tgt_decoder = torch.zeros(1, src.size(1), src.size(2)).to(device)

            optimizer.zero_grad()
            output = model(src, tgt_decoder)  # [1, batch, input_dim]
            output = output.squeeze(0)         # [batch, input_dim]
            loss = criterion(output, tgt)
            loss.backward()
            optimizer.step()
            epoch_loss += loss.item()

        scheduler.step()  # 스케쥴러 업데이트
        current_lr = scheduler.get_last_lr()[0]
        print(f"Epoch {epoch+1}/{epochs}, Loss: {epoch_loss / len(train_loader):.6f}, LR: {current_lr:.6f}")
1) src와 tgt의 size :
src는 [batch, seq_length, input_dim] 크기의 텐서
[[[x, x, x, x, x], [x, x, x, x, x], [x, x, x, x, x], ... [x, x, x, x, x]],
[[x, x, x, x, x], [x, x, x, x, x], [x, x, x, x, x], ... [x, x, x, x, x]],
...
[[x, x, x, x, x], [x, x, x, x, x], [x, x, x, x, x], ... [x, x, x, x, x]]]tgt는 [batch, input_dim]크기의 텐서
[[x, x, x, x, x],
[x, x, x, x, x],
...
[x, x, x, x, x]]
2) transpose을 이용해 src 입력 시퀀스 모양 수정 필요
기본적으로 PyTorch의 nn.Transformer는 첫 번째 차원을 시퀀스 길이( sequence_length ), 두 번째 차원을 배치 크기( batch_size ), 세 번째 차원을 특성 차원( feature_dim, 즉 d_model )으로 가정하고 내부 연산(멀티 헤드 어텐션 등)을 수행한다.
3) 디코더 초기 입력 값 zero 텐서로 생성
디코더의 입력으로 시퀀스 길이 1로 설정해야하는 이유는 디코더가 토큰 단위로 입력과 출력이 autoregressive하게 진행되기 때문이다. 여기서 설정하는 입력이 start_token (<SOS> (Start Of Sequence)) 이다.
(autoregressive : 이전의 출력이 현재의 입력, 그리고 현재의 출력이 다음의 입력으로 진행되는 것을 의미)
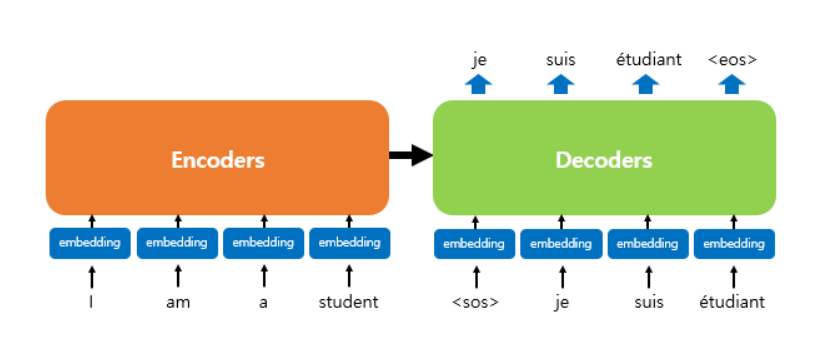 (이미지 출처: https://wikidocs.net/31379)
5. predict_future() 정의
평가 시에는 rollout방식으로 직접 모델에 src 시퀀스와 start_token을 입력해 진행된다.
def predict_future(model, test_data, seq_length, num_prediction, device):
    model.eval()
    test_input = torch.tensor(test_data[:seq_length], dtype=torch.float32).to(device)  # [seq_length, input_dim]
    predictions = []
    with torch.no_grad():
        for _ in range(num_prediction):
            src = test_input.unsqueeze(1)  # [seq_length, 1, input_dim]
            tgt_decoder = torch.zeros(1, 1, test_input.size(-1)).to(device)
            out = model(src, tgt_decoder)    # out shape: [1, 1, input_dim]
            # 두 차원만 squeeze해서 [input_dim] 형태로 변경
            pred = out.squeeze(0).squeeze(0)   # [input_dim]
            predictions.append(pred.cpu().numpy())  # 5개 피처 예측값 저장
            # 시퀀스 업데이트: 가장 오래된 값 제거 후 예측값 추가
            test_input = torch.cat([test_input[1:], pred.unsqueeze(0)], dim=0)
    return np.array(predictions)  # shape: [num_prediction, input_dim]
1) test_input 테스트 입력 시퀀스로 이루어진 test_data[:sequence] 부분을 텐서로 변환해서 담는다.
2) predictions는 빈배열로 생성해둔다.
3) 예측하려는 갯수 num_prediction 만큼 반복하여 진행
4) src는 평가단계기 때문에 batch_size 차원을 추가해주기 unsqueeze 처리해준다. (트랜스포머 모델의 입력 형태를 맞춰주기 위해)
5) 트랜스포머의 출력 shape은 [1, batch_size, input_dim]이므로 평가시에는 [1, 1, input_dim]이며, squeeze처리하여 1차원 텐서 [input_dim] 로 만들어준다.
6) predictions 배열에 [input_dim] 결과를 담는다.
7) 슬라이딩 윈도우 개념을 적용해 가장 오래된 값을 버리고, 새로 예측한 값을 뒤에 이어 붙인다.
test_input = torch.cat([test_input[1:], pred.unsqueeze(0)], dim=0)test_input[1:]: 맨 앞(인덱스 0)을 제외한 뒤의 모든 시점을 가져옴pred.unsqueeze(0):pred는 [input_dim]의 1차원 텐서인데, 앞에 차원을 추가하여 [1, input_dim]을 만듬torch.cat([test_input[1:], pred.unsqueeze(0)], dim=0): 위 두 텐서를 첫 차원을 기준으로 이어붙여 [seq_length, input_dim] 형태로 만들어 다음 입력test_input을 갱신함
6. plot_predictions() 정의
실제값과 예측치 비교를 위한 시각화 부분이다.
def plot_predictions(actual, predictions, seq_length):
    plt.figure(figsize=(12,6))
    # actual: [num_samples, num_features], predictions: [num_prediction, num_features]
    plt.plot(actual[:, 0], label="Actual Close Price")
    plt.plot(range(seq_length, seq_length + len(predictions)), predictions[:, 0],
             label="Predicted Close Price", linestyle="dashed")
    plt.xlabel("Time Step")
    plt.ylabel("Price")
    plt.title("Tesla Stock Price Prediction using Transformer")
    plt.legend()
    plt.show()
7. main() 정의 및 main() 실행
각 기능별로 모듈화하여 main()에서 호출하여 동작하는 방식으로 구현되어 있다.
def main():
    # 설정값
    ticker = "TSLA"
    start_date = "2015-01-01"
    end_date = "2025-02-05"
    seq_length = 50       # 입력 시퀀스 길이 (예: 50일)
    batch_size = 32
    epochs = 100
    num_prediction = 600   # 예측할 미래 시점 개수
    device = torch.device("cuda" if torch.cuda.is_available() else "cpu")

    # 데이터 로딩 및 전처리 (5개의 피처 사용)
    train_data, test_data, scaler = load_and_preprocess_data(
        ticker, start_date, end_date, features=['Close', 'Volume', 'Open', 'High', 'Low'], split_ratio=0.8
    )

    # DataLoader 생성
    train_loader = create_dataloader(train_data, seq_length, batch_size)

    # 모델 생성 (입력 차원 수정: 5개의 피처)
    model = TimeSeriesTransformer(input_dim=5, d_model=252, nhead=4, num_layers=3).to(device)

    # 모델 학습 (스케쥴러 포함)
    train_model(model, train_loader, device, epochs, learning_rate=0.001)

    # 미래 주가 예측
    predictions = predict_future(model, test_data, seq_length, num_prediction, device)  # shape: [num_prediction, input_dim]
    # 역정규화: 모든 피처 역정규화 (시각화는 Close 피처만 사용)
    predictions_inverse = scaler.inverse_transform(predictions)
    actual_test = scaler.inverse_transform(test_data)

    # 결과 시각화 (Close price만)
    plot_predictions(actual_test, predictions_inverse, seq_length)

if __name__ == "__main__":
    main()