들어가며
주차별로 남겨온 KT-Aivle 회고도 이제 마지막이다. (수료 후 문서정리와 따로 면접 서류 정리하다보니 블로그 글을 늦게 작성하게 되었다...) 1주차부터 12주차까지, 그리고 그 사이 미니프로젝트와 공모전 이야기까지 하나씩 적어왔는데, 이번 글은 그 모든 주차의 결과물인 최종 프로젝트 FOWOCO를 마무리하며 쓰는 글이다. 8주 동안 있었던 일을 다 담으려니 글이 꽤 길어질 것 같다.
FOreign WOrker COmmunication, 줄여서 FOWOCO.
FOWOCO는 한 문장으로 요약하면 이렇다. E-9 외국인근로자를 고용한 중소 제조업체의 HR 담당자가 반복적으로 처리하는 체류·계약·서류 업무를, AI가 기한을 감지하고 초안을 준비하고 근로자에게 다국어로 안내한 뒤 응답까지 관리해주는 업무보조 SaaS다.
8명이 한조가 되어 프로젝트를 진행했고 나는 그중 Frontend와 Platform·Infra를 혼자 맡아 진행하게 되었다.
배경
 |
 |
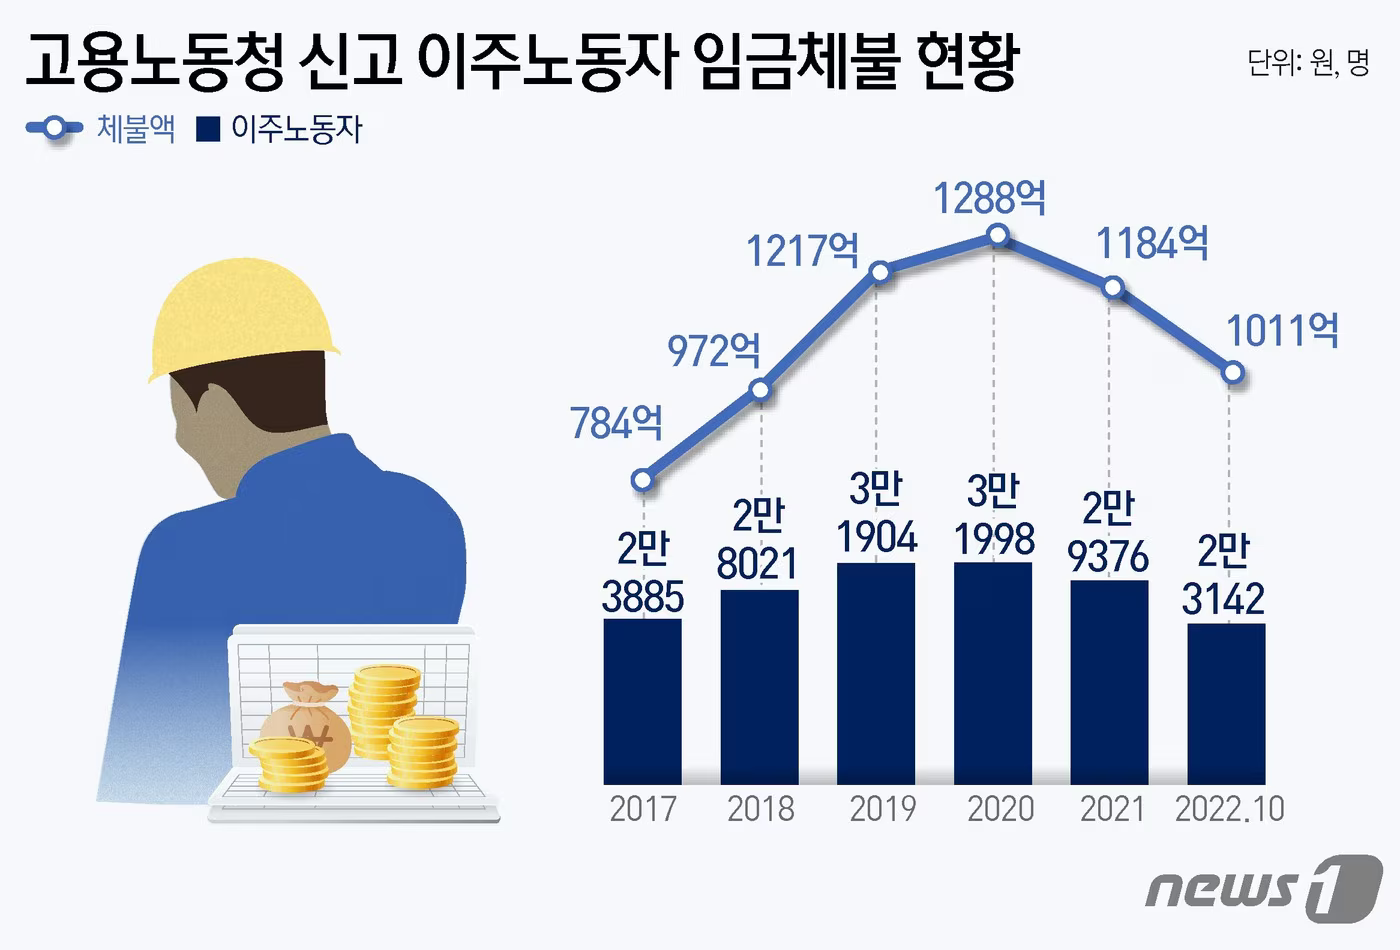
우리 팀(수도권 05반 14조)이 프로젝트를 기획하며 많은 기사와 자료들을 스크랩했었다. 그 자료중 2024년 12월 기준 국내 E-9(비전문취업) 사업장은 60,785개소, 근로자는 203,121명이다. 업종별로는 제조업이 72.3%로 압도적이었다. EPS(고용허가제) 연간 도입 쿼터도 2021년 5.2만 명에서 2025년 13만 명으로 계속 늘고 있었다. 그런데 정작 이 근로자들을 관리하는 쪽을 들여다보면, 실태조사에서 짧은 체류 허용 기간(47.4%), 복잡한 채용 절차(36.9%), 관련 정보 부족(23.4%)이 나란히 애로사항으로 꼽혔다. 임금체불 진정은 매년 3만 건 이상 접수되는데 그중 80% 이상이 10인 미만 소규모 사업장에서 나왔고, 외국인 근로자의 산재율은 내국인 대비 1.8배였다.
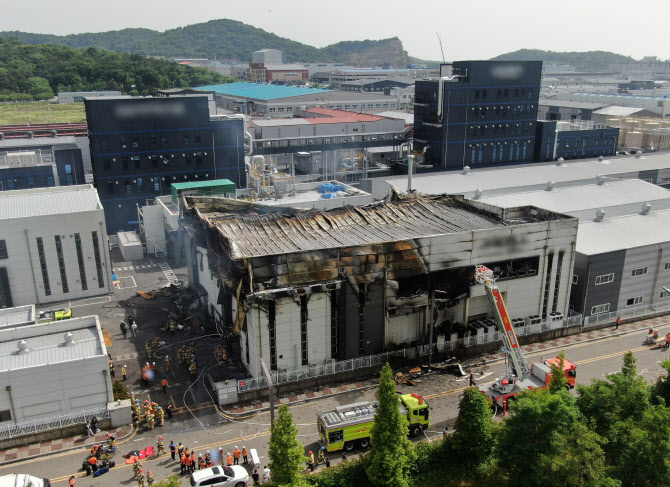
이 문제의식을 결정적으로 굳힌 건 하나의 사건이었다. 2024년 6월 24일 화성 아리셀 공장 화재로 23명이 숨졌는데, 그중 18명이 외국인 근로자였다. 언어 장벽이 대피 실패의 한 원인으로 지목됐다. 회사 안에 통역 인력이 1명뿐이었고, 안전 안내조차 그 한 사람에게 전적으로 의존하는 구조였다는 사실이 우리 문제 정의의 핵심 근거가 됐다.
한편 EPS 시스템 자체에는 이미 외국인들이 사용하는 다국어 표현 DB가 존재한다. 하지만 실제 현장에서 오가는 문장은 "그 서류", "저쪽 라인", "다음 주"처럼 맥락이 없으면 이해하기 힘든 경우가 많다. 이런 문장을 그대로 번역기에 넣어봐야 근로자는 정확히 이해하기 어렵고, HR 담당자는 그걸 확인했는지 안 했는지 따로 추적해야 한다. 그래서 우리는 단순 번역이 아니라, 업무 유형을 분류하고 모호한 표현에 대해 되묻고, 다국어 안내와 근로자 확인·티켓 기록까지 이어지는 HR 업무 Agent가 필요하다고 판단했다. 경쟁 서비스도 찾아봤는데, 국내 고용24·시프티·플렉스 같은 HR SaaS 어디에도 E-9 근로자에 특화된 기능은 없었다. 국내 서비스시장에 공백이라고 생각했다.
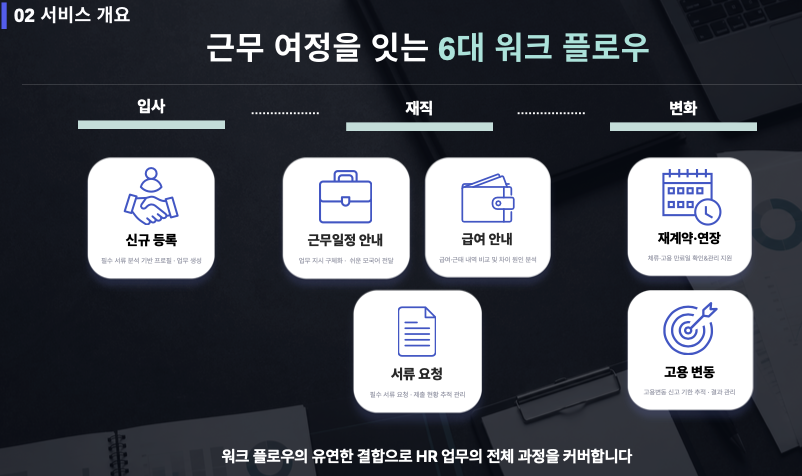
FOWOCO의 서비스 흐름은 결국 이렇게 정리됐다.
기한·문서 자동 점검 → Case·Task 생성 → 신청서 초안 작성 → HR 승인 → 근로자 안내·응답 → 완료 증빙
MVP로는 재계약·취업활동·체류연장, 신규 근로자 등록·초기 행정, 퇴사·고용변동 신고라는 세 가지 큰 시나리오를 잡고, 서류 요청·급여 설명·근무 안내라는 공통 서브플로우를 그 밑에 깔았다. 서비스 범위도 명확히 그었다. 준비·초안·검토·공식 링크 연결·결과 추적까지는 지원하지만, 법률 최종판단이나 기관 자동제출, 급여 계산은 범위 밖으로 뺐다. 할 수 있는 것과 할 수 없는 것을 처음부터 구분해둔 게 나중에 기능 범위를 다툴 때마다 기준이 됐다.
기술 스택은 4계층으로 나뉜다. Presentation(React·TypeScript·Tailwind·Vite), Application(Spring Boot 서버 + FastAPI·LangGraph·Hugging Face·PyTorch·Qdrant·CLOVA OCR로 구성된 AI 서버), Infra(Docker·AWS EC2·k3s), Data(PostgreSQL·S3)다. 최종적으로는 Intent 분류에 KLUE-RoBERTa(메인)와 A.X-4.0-Light QLoRA(보조)를 계단식(Cascade)으로 엮어 분류 정확도 93%를 냈고, 서류 업무 처리 시간을 기존 1~2시간에서 1분으로, 98% 단축하는 걸 파일럿 목표로 잡았다.
FOWOCO는 실제로 이렇게 동작한다
 |
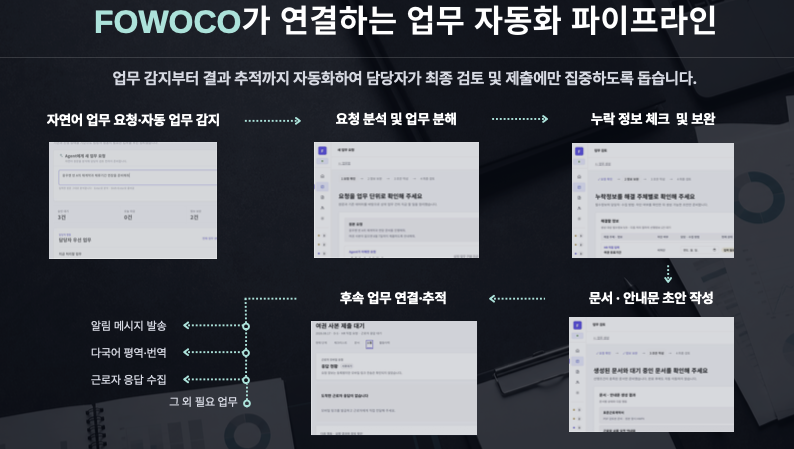 |
FOWOCO는 두 개의 얼굴을 가진 서비스다. HR 담당자는 PC 웹으로 접속해서 쓰고, 근로자는 앱을 따로 설치할 필요 없이 문자나 카카오로 받는 보안 링크 하나로 모바일 웹에서 확인·응답만 하면 된다. 근로자 입장에서는 매일 쓰는 도구가 아니라 가끔 확인하고 답하는 용도라, 설치·로그인 부담을 지우는 게 우선이라고 판단했다.
HR 담당자는 로그인하면 Today 대시보드부터 본다. 오늘 마감인 업무, 승인 대기 중인 건, 정보가 부족해서 막힌 업무가 우선순위별로 한 화면에 정리돼 있다. 여기서 "아르준 타파 씨 체류연장 준비해줘"처럼 자연어로 한 줄만 입력하면, AI가 그 문장을 해석해서 어떤 업무 유형인지, 대상 근로자가 누구인지 후보를 만들어 보여준다 — AI가 알아서 확정하는 게 아니라, HR이 그 해석이 맞는지 먼저 확인해야 다음 단계로 넘어간다.
필요한 정보가 빠져 있으면 그 정보를 누가 채워야 하는지(HR이 직접 입력할지, 근로자에게 물어봐야 할지, 이미 DB에 있는지)부터 구분해서 보여준다. 근로자에게 물어봐야 하는 값이면 앞서 말한 보안 링크가 나가고, 근로자가 모바일에서 답하거나 서류를 올리면 그 값이 다시 HR 화면으로 돌아온다. 필요한 정보가 다 모이면 문서 초안이 자동으로 만들어지고, HR이 최종 검토해서 승인하면 신청서가 완성된다. 이 전체 과정 — 감지·준비·승인·연결·추적 — 이 하나의 Case로 묶여서 근로자별 이력에 남는다.
이 흐름을 재계약·체류연장, 신규 근로자 등록, 퇴사·고용변동 신고라는 3개 대표 시나리오에 얹고, 서류 요청·급여 설명·근무 안내라는 공통 기능까지 더해 최종적으로 8개의 세부 워크플로우로 쪼갰다.
FOWOCO의 서비스 흐름은 결국 이렇게 정리됐다.
기한·문서 자동 점검 → Case·Task 생성 → 신청서 초안 작성 → HR 승인 → 근로자 안내·응답 → 완료 증빙
MVP로는 재계약·취업활동·체류연장, 신규 근로자 등록·초기 행정, 퇴사·고용변동 신고라는 세 가지 큰 시나리오를 잡고, 서류 요청·급여 설명·근무 안내라는 공통 서브플로우를 그 밑에 깔았다. 서비스 범위도 명확히 그었다. 준비·초안·검토·공식 링크 연결·결과 추적까지는 지원하지만, 법률 최종판단이나 기관 자동제출, 급여 계산은 범위 밖으로 뺐다. 할 수 있는 것과 할 수 없는 것을 처음부터 구분해둔 게 나중에 기능 범위를 다툴 때마다 기준이 됐다.
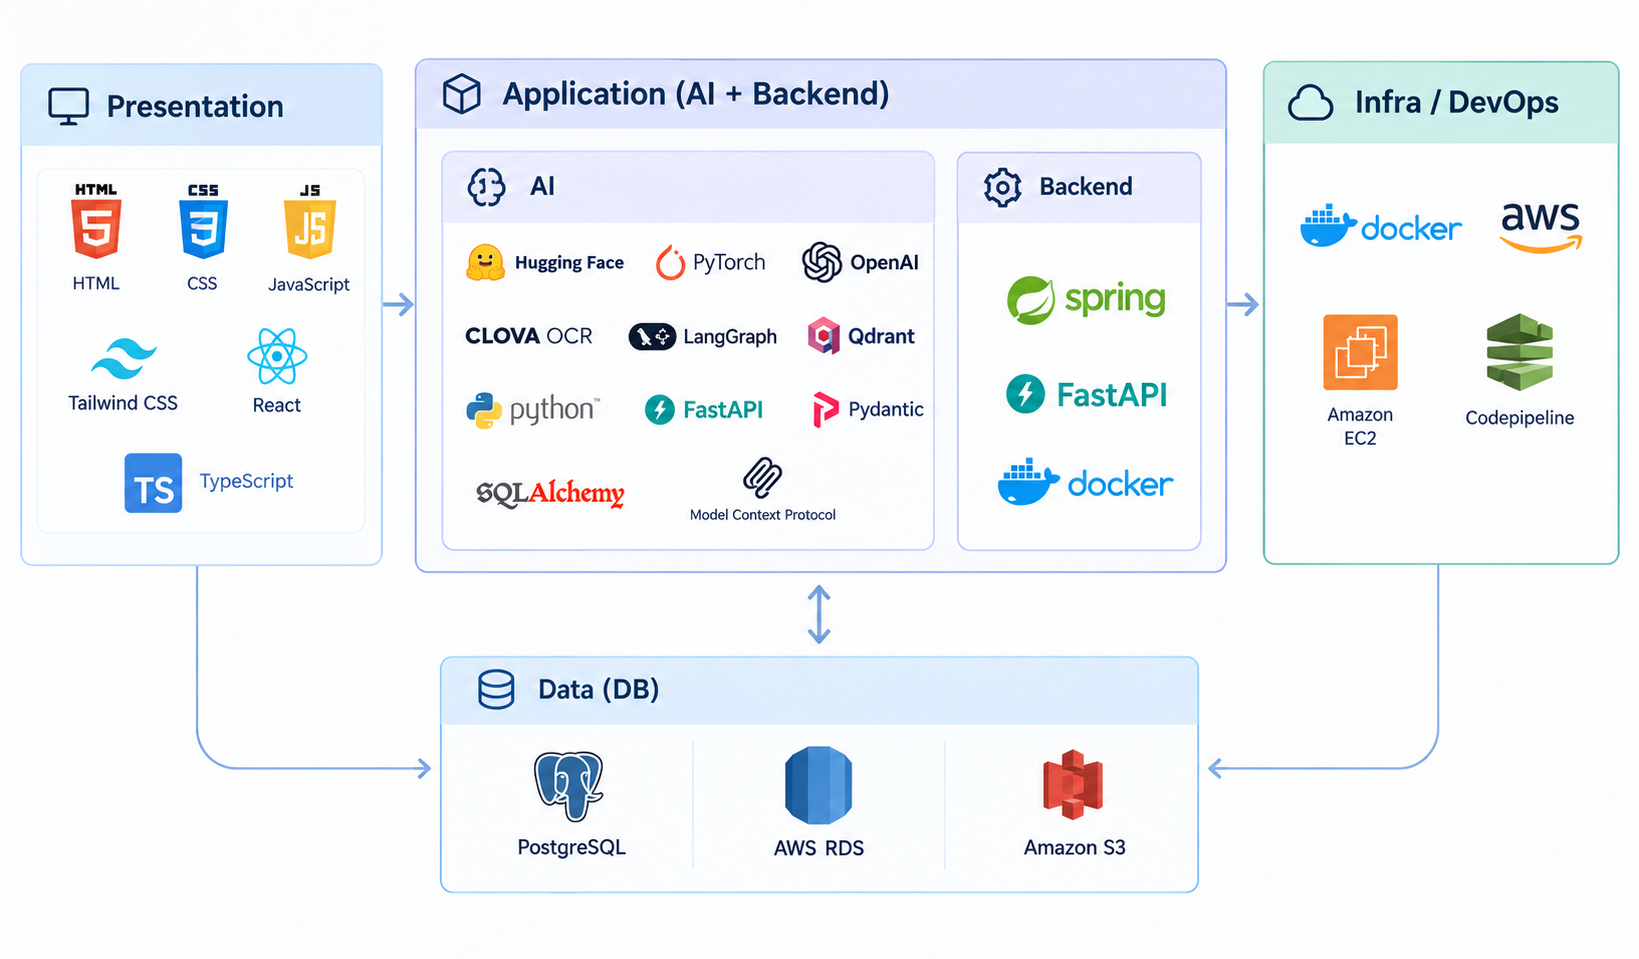
기술 스택은 4계층으로 나뉜다. Presentation(React·TypeScript·Tailwind·Vite), Application(Spring Boot 서버 + FastAPI·LangGraph·Hugging Face·PyTorch·Qdrant·CLOVA OCR로 구성된 AI 서버), Infra(Docker·AWS EC2·k3s), Data(PostgreSQL·S3)다. 최종적으로는 Intent 분류에 KLUE-RoBERTa(메인)와 A.X-4.0-Light QLoRA(보조)를 계단식(Cascade)으로 엮어 분류 정확도 93%를 냈고, 서류 업무 처리 시간을 기존 1~2시간에서 1분으로, 98% 단축하는 걸 파일럿 목표로 잡았다.
기획안이 뽑히기까지
이 프로젝트가 원래부터 지금 모습이었던 건 아니다. 1주차에 팀원 8명이 각자 후보 주제를 하나씩 들고 왔고, 그중에서 논의와 투표를 거쳐 내가 낸 기획안이 최종적으로 선정됐다. 그런데 선정되고 끝이 아니라, 2주차 내내 코치님 피드백을 받으며 주제 타당성에 대해 계속 흔들렸었다. 가장 크게 흔들린 지점은 "번역"이었다. 7월 9일 4차 피드백에서 코치님은 이렇게 짚었다. "LLM 통역 말고 다른 기능은? → 기존에는 종합적인 HR 관리인데 지금은 메인 기능이 번역으로 느껴진다. 스코프가 줄어들었다는 느낌이고, 이전 메인 기능(HR) + 의사소통 문제 해결로 가는 것이 좋아보인다." 다국어 안내라는 기능 하나가 눈에 띄다 보니, 어느새 서비스 전체가 "번역 도구"로 좁아져 보이고 있었던 거다. 이 피드백을 받고서야 서류 관리·업무 승인 같은 HR 기능을 다국어 안내와 동등한 축으로 다시 세웠다.
목표 고객의 규모도 여러 번 좁혔다 넓혔다를 반복했다. 7월 7일 3차 피드백에서는 "E-9 근로자 5명 이상, 전체 근로자 20~100명 규모"로 논의됐고, 다시 "E-9 제조업 / 50~300인 제조업체"까지 갔다가, 최종적으로는 "외국인근로자 10~40명, HR·총무 1~3명이 Excel·문서 폴더로 관리하는 중소 사업장"으로 정리됐다. 매번 기준이 바뀔 때마다 "이 정도 규모면 실제로 돈을 낼까"라는 질문이 따라붙었다.
이 과정에서 EPS·고용24·하이코리아·KOSHA 같은 정부 시스템은 결국 "신고가 들어와야만 그 시점의 상태를 기록"할 뿐, 사업장 안에서 매일 쌓이는 근태·급여·상담 이력 같은 비신고 영역의 데이터는 애초에 볼 권한도 이유도 없다는 점을 조사했었다. 그래서 "근로자가 왜 떠나는지"는 정부 시스템이 구조적으로 볼 수 없는 데이터에서만 나오는 신호라고 정리했고, 이걸 근거로 이탈 위험을 사전에 우선순위화하는 방향을 제안한 적이 있다. 이 아이디어 자체가 최종 FOWOCO에 그대로 들어가지는 않았지만, "정부 시스템이 못 보는 지점이 우리의 자리"라는 문제의식은 남아 최종 문제 정의의 뼈대가 됐다.
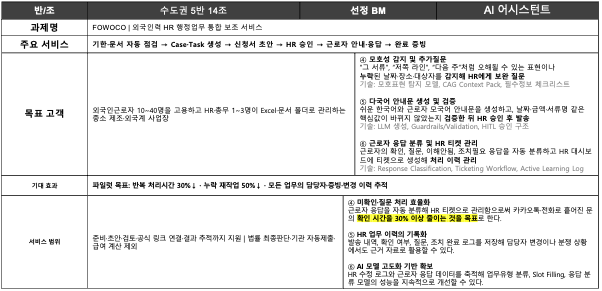
이렇게 몇 차례의 피드백과 논의를 거쳐 합의된 게 지금 소개한 조별 과제 정의서다. 그때 썼던 원안 일부를 그대로 옮겨본다.
목표 고객: 외국인근로자 10~40명을 고용하고 HR·총무 1~3명이 Excel·문서 폴더로 관리하는 중소 제조·외국계 사업장
기대 효과 — 파일럿 목표: 반복 처리시간 30%↓ · 누락 재작업 50%↓ · 모든 업무의 담당자·증빙·변경 이력 추적
선정 근거[실무] 숙련 담당자도 신고·서류 관리에 주 1~2시간 사용
[인터뷰] 서류 만료 검증·다국어 직접 전달·순차 업무 안내에 도입 가치 확인
[실현성] 공식 서식·EPS 문장·Flyway DB·Intent/OCR/문서 Agent를 현재 개발 자산으로 연결 가능
[검증] 2주 파일럿에서 처리시간·재요청·오류 유형·사용 의사를 측정
원안에는 지금 서비스의 핵심 기능 세 가지도 이미 들어 있었다. 모호한 표현("그 서류", "저쪽 라인", "다음 주")을 감지해서 HR에게 되묻는 기능, 쉬운 한국어와 근로자 모국어로 안내문을 생성하되 날짜·금액·서류명 같은 핵심값이 바뀌지 않았는지 검증하는 기능, 그리고 근로자의 응답(확인/질문/이해안됨/조치필요)을 자동 분류해서 HR 티켓으로 관리하는 기능이다. 8주가 지난 지금 다시 읽어보니, 세부 구현은 훨씬 정교해졌지만 뼈대는 그때 쓴 것과 크게 다르지 않다. 처음 이 문제를 발견하고 구조화한 방식이 곧 팀 전체가 8주를 걸어간 방향이 됐다는 게, 돌아보면 이 프로젝트에서 가장 뿌듯한 지점이다.
역할 분담(R&R)도 이때 정했다.
| 이름 | 역할 |
|---|---|
| 최현준 | 팀장 · PM · Product Design · Backend |
| 김재성 | Backend · DB |
| 김채린 | Backend |
| 박태정 | Language · Document Agent |
| 안주현 | OCR Agent |
| 이채은 | ML Engineering · Project Operations |
| 이휘 | Supervisor Agent · AI Serving |
| 김경민 | Frontend · Platform · Infrastructure |
1주차(06.29~07.05) 주제 선정 및 사전조사
2주차(07.06~07.12) 주제 기획·유저 리서치·요구사항 정의서 작성
3주차(07.13~07.19) 데이터 수집 / 서비스 Mid 와이어프레임
4주차(07.20~07.26) 모델링 / FE-BE 계획 및 개발 착수
5주차(07.27~08.02) 모델링 API / FE-BE 개발 (AI-서비스 병합)
6주차(08.03~08.09) AI Agent 개발 / QA 및 AI agent 병합
7주차(08.10~08.16) 최종 QA 및 통합 테스트
8주차(08.17~08.23) 버그 수정 및 발표 준비
파파고보다 낫다는 걸 증명해야 했다
7월 14일 피드백에서는 방향이 한 번 더 흔들렸다. "소통 문제를 1차적인 개발 배경으로는 넣되, 너무 소통으로 치우치면 경쟁력이 없어 보이니 HR 중심으로 가면 좋겠다"는 지적이었다. 이 피드백을 계기로 팀 내에서 역할을 다시 나눴는데, 나한테 떨어진 과제가 하나 있었다. "파파고보다 더 모호성·정확성 면에서 나은 번역이라는 걸 근거로 보여줘라."
말은 쉬운데 막상 해보려니 만만치 않았다. 우리 서비스가 대상으로 하는 16개 국적 중 10개 언어를 추려서, 무료로 누구나 쓸 수 있는 파파고·구글 번역과 비교했을 때 우리가 왜 더 나은지를 언어별로 표로 정리해야 했다. 결국 답은 "번역 품질 자체"가 아니라 앞서 코치님이 짚어준 것과 같은 방향이었다. 범용 번역기는 "그 서류", "저쪽 라인" 같은 맥락 의존 표현을 일반 문장으로 처리해버리지만, 우리는 그 문장이 어떤 업무 맥락(Workflow ID, Slot)에서 나왔는지 알고 번역하기 때문에 모호한 표현을 놓치지 않고 되물을 수 있다는 것. 번역기와 경쟁하는 게 아니라 애초에 다른 걸 하고 있다는 걸 근거로 보여줘야 했다.
서비스를 8개의 워크플로우로 쪼개다
7월 15일 개발 회의에서는 앞서 소개한 3개 큰 시나리오를 더 잘게, 실제 개발 단위로 쪼갰다. 최종적으로 8개 워크플로우가 나왔다.
| ID | 워크플로우 | 트리거 | 산출물 |
|---|---|---|---|
| WF-REG-01 | 근로자 등록·정보 갱신 | Excel·PDF 업로드 | 컬럼 매핑·OCR·중복 확인 후 등록 초안 |
| WF-DEADLINE-01 | 계약·체류기간 점검 | 매일 자동 실행 | D-day 계산, 만료 예정 업무카드 |
| WF-DOC-01 | 필수서류 점검·요청 | 누락 감지 | 서류 요청 링크·제출 현황 |
| WF-PROC-01 | 행정업무 준비 | "체류연장 준비해줘" | 문서 초안 |
| WF-CHANGE-01 | 입사·퇴사·고용변동 관리 | — | 신고 준비 업무카드 |
| WF-PAY-01 | 급여·근태 조회·설명 | — | HR 검토용 설명문 |
| WF-COMM-01 | 근로자 안내·응답 회수 | — | 모바일 링크, 확인/질문/파일제출 |
| WF-BRIEF-01 | HR 업무 브리핑·보고 | 매일/매주 | 우선순위 요약 |
Intent·Slot 라벨링 기준도 회의를 진행하며 합의했다. 인텐트 6종(WORK_INSTRUCTION, DOCUMENT_REQUEST, PAY_ATTENDANCE, CONTRACT_STAY, ON_OFFBOARDING, GENERAL_ADMIN) 기준으로 Gold-set 문장 80개(인텐트당 12~14개)를 모으기로 했는데, 회의 시점에 모인 건 27개뿐이었다. 워크플로우 ID에도 규칙을 정해뒀다. WF(Workflow) + 도메인 3글자 코드(CON=계약, DOC=서류, STY=체류) + 일련번호 3자리. 그리고 각 워크플로우 안에는 법적 기한과는 별개로 FOWOCO 자체의 "내부 준비 사다리"를 뒀다. 체류기간 만료일을 기준으로 D-90(마스터 Case 생성, 계속고용 여부 검토 시작), D-60(준비 Task 개방), D-30(우선순위 상향), D-7(긴급 상태), D-day 이후(기한 경과, 수동 조치 필요) 순으로 단계를 올렸다. 이건 법이 정한 신고 기한이 아니라, "법정 기한에 쫓기기 전에 우리가 먼저 알아채자"는 목적으로 만든 순전히 내부용 일정표다.
회의를 진행하며 방향성을 갖추기
기술 코치님과의 첫 문답을 가지는 시간을 가졌다.
Q. 모호성 감지는 어떻게 판단하나요? 주체·기한·수량이 빠졌는지를 기준으로 판단하려고 합니다.
A. 이미 어느 정도 고려가 잘 됐다.
Q. 보안은 어디까지 신경 써야 할까요? 지금 다루는 게 실제 개인정보가 아니라 더미 데이터인데, 그래도 마스킹까지 해야 할까요?
A. 더미 데이터라면 기본 계층(인증·권한 분리, 전송 구간 HTTPS, 마스킹)이면 충분하다. 다만 실제로 개인정보가 API로 흘러간다면, 마스킹을 왜 풀 수 있어야 하는지부터 설명할 수 있어야 한다.
Q. AI 응답을 얼마나 신뢰할 수 있는지 정량적으로 어떻게 보여줄까요?
A. 숫자로 된 confidence 임계값을 쫓지 말아라. 이건 사람이 검토하는 "보조 도구"이기 때문에, 정확도(%)가 아니라 에러 유형으로 분류하는 게 맞다. AI가 틀린 답을 확정 짓는 대신 되물어서 확인 질문을 던졌다면, 그건 검토 단계에서 걸러지니 문제가 안 된다. 법령·통계처럼 AI가 흔히 잘못 아는(hallucination) 영역도 마찬가지로 검토에서 대부분 걸러진다. 그러니 진짜 신뢰도 지표는 정확도가 아니라 "검토 단계에서 실제로 걸러지는 hallucination 비율"이어야 한다.
Q. 번역 품질은 어떻게 검증하나요?
A. 언어적으로 매끄러운지를 기준으로 채점하지 마라. 원문의 핵심 정보(행동·날짜)가 번역 후에도 살아있는지만 확인하면 된다. 표현이 좀 어색한 건 괜찮다.
Q. 실사용 데이터가 없는 초기 단계에서는 어떻게 하나요?
A. 통계 기반으로 가중치를 미리 정해두고, 실제 사용 데이터가 쌓이면 그걸로 다시 학습하는 방향은 말이 된다. 다만 "대충 이 정도"가 아니라 처음 가중치를 왜 그렇게 잡았는지 근거와 검증 계획이 있어야 한다.
"AI가 틀렸는지 맞았는지가 아니라, 틀렸을 때 어떤 방식으로 틀렸는지를 본다"는 이 대답이 특히 오래 남았다. 이후 우리가 신뢰도를 "정확도 93%"라는 숫자 하나로 퉁치지 않고 confidence margin에 따라 다른 모델로 라우팅하는 구조(뒤에서 다시 설명한다)를 짜야한다.
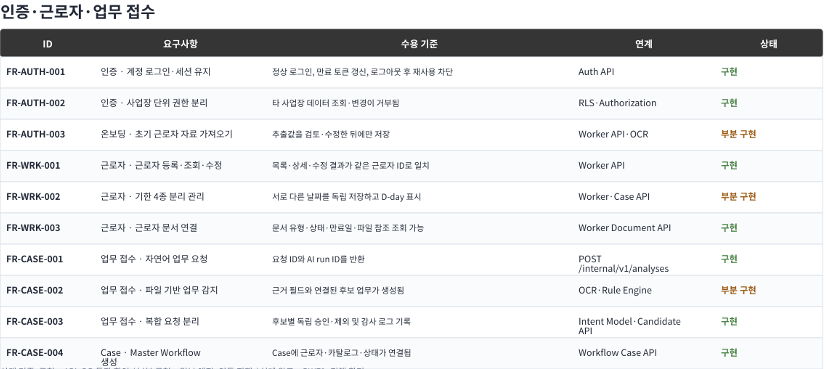
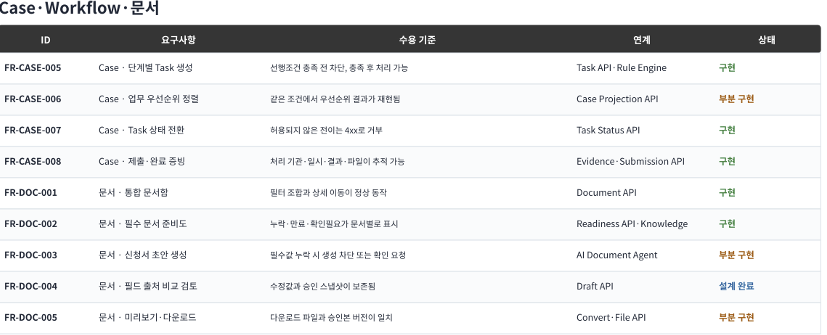
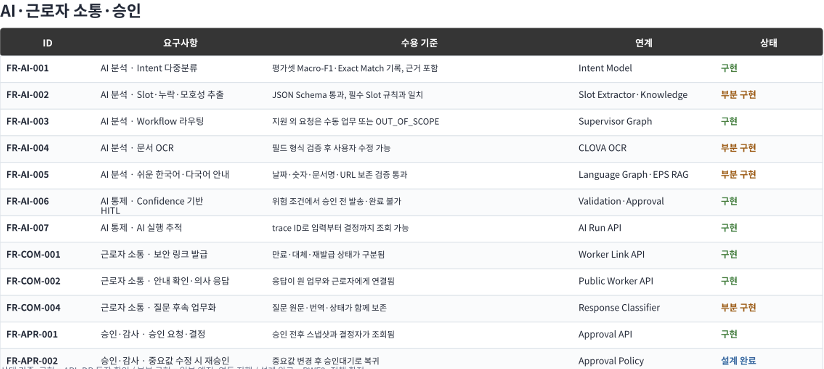
요구사항 정의서
 |
 |
 |
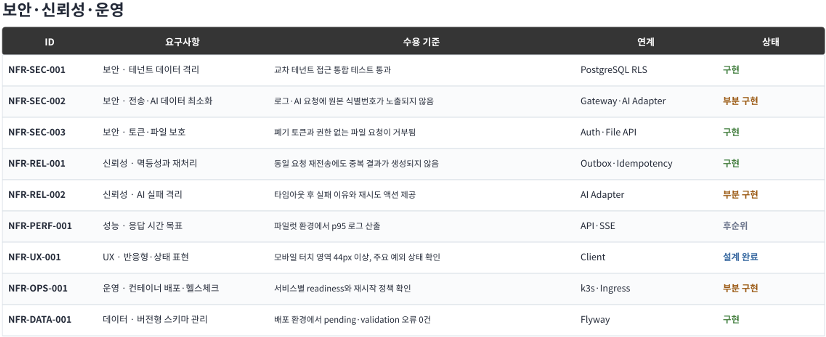 |
기획안이 정해진 뒤 곧바로 한 일은 그 아이디어를 요구사항 43개(기능 34, 비기능 9)로 쪼개는 것이었다. 그냥 목록만 만든 게 아니라 "업무 문제 → 요구사항 → 설계·개발 → 수용 기준 → 진척 증명"이라는 5단계 추적 체계를 세워서, 요구사항 하나하나가 실제 화면·API·AI 로직 중 무엇으로 구현됐는지, 그리고 그게 "구현 완료"인지 "부분 구현"인지 "설계만 완료"인지를 매주 갱신했다.
NFR-SEC-001(PostgreSQL RLS로 테넌트 데이터 격리)과 NFR-OPS-001(컨테이너 배포·헬스체크)은 정확히 내가 인프라 쪽에서 겪은 사건들 (DB 역할 분리, probe timeout 사고)과 맞닿아 있다. 요구사항 문서에 적힌 "수용 기준"이 나중에 실제로 겪은 장애의 재현 조건이 됐다는 게, 문서 작업이 그냥 형식이 아니었다는 걸 배웠다. 범위도 이 단계에서 명확히 그었다. 기관 자동 제출·법률 최종판단·급여 계산은 명시적으로 제외하고, 준비·초안·검토·공식 링크 연결·결과 추적까지만 구현하기로 못 박았다. 나중에 "이것도 되나요?" 같은 기능 요청이 나올 때마다 이 경계선이 판단 기준이 됐다.
개인정보는 어디까지 다룰지
7월 27일, 백엔드 팀 세 명이 "민감정보 처리 방향 결정"이라는 이름의 기술 회의를 진행하고 기록했다.이름·전화번호·여권번호 같은 실제 개인정보를 FOWOCO가 언제, 어디에, 누구 권한으로 저장할지를 정하는 자리였다. 그때까지 우리 시스템은 이미 근로자 테이블에 실명 대신 닉네임·국적·언어·상태·날짜만 넣고 있었고, 문서는 원본 대신 제출 상태·만료일 같은 메타데이터만, AI·이벤트 레이어에는 worker_id만 넘기고 있었다. 회의에서는 이 원칙을 더 구체화했다. MVP 단계에서 수집 범위를 어디까지 할지(데모에 실명·연락처를 넣을지, 여권·외국인등록번호는 영구히 제외할지), 저장 구조를 어떻게 나눌지(worker_sensitive_data 별도 테이블?), 접근 권한을 어떻게 가를지(VIEWER는 마스킹, HR·ADMIN만 원문 조회하되 사유 입력과 감사 로그를 강제할지), 암호화를 어떤 방식으로 할지(SensitiveDataCipher라는 포트를 Spring에 두고 운영에서는 Vault·Cloud KMS, 로컬은 테스트용 어댑터), 필드별 보관·삭제 주기까지 경계를 세웠다.
세 가지 선택지를 표로 비교했다.
| 옵션 | 설명 | 평가 |
|---|---|---|
| 데모에 실개인정보 없음 | 가명 + 문서 메타데이터만 | MVP 권장 — 가장 안전하고 단순하지만 실제 문서 자동 채움은 제한됨 |
| 처음부터 암호화 적용 | 필드 단위 암호화 + KMS | 파일럿 단계용 — 전체 권한·감사·삭제 체계가 다 갖춰져야 함 |
| 전용 개인정보 마이크로서비스 | 별도 서비스로 완전히 분리 | 보류 — 지금 팀 규모에 운영 부담이 너무 큼 |
설계는 크게 짰는데, 실제로 나온 건 훨씬 단순했다
문서 생성 계약(Contract)을 서버가 소유하는 Schema Contract, AI가 소유하는 Renderer Manifest, 이 둘을 합친 Rendering Contract 세 겹으로 나누고, 계약 내용 전체를 정규화한 뒤 SHA-256으로 해시(composed_contract_digest)를 찍어 무결성을 검증하고, 계약 상태를 ACTIVE/DEPRECATED/BLOCKED 세 단계로 관리하는 상태 머신까지 설계한 문서였다. 테이블 스키마만 4개를 새로 그렸다. 그런데 문서 안에 스스로 "범용 Expression DSL이나 동적 폼 엔진은 Phase 1A에서 구현하지 않는다"고 선을 그은 걸 보면, 설계하다가 스스로도 이게 지금 필요한 범위를 넘어섰다는 걸 알아챈 것 같다. 실제로 이후 ERD에는 이 3계층 계약 시스템 대신 worker_document, stored_file, task_evidence, document_request_draft 같은 훨씬 단순한 테이블 몇 개로 정리됐다.
ERD 자체도 처음 설계와 실제 구현 사이에 차이가 꽤 있었다. company_name으로 조인하던 걸 전부 company_id FK로 바꿨고, password 컬럼은 password_hash로, 이메일 중복 체크용 normalized_email 컬럼이 새로 생겼다. 권한 등급도 원래 OWNER/HR_MANAGER/HR_STAFF 세 단계였던 게 ADMIN/HR/VIEWER로 단순해졌다. 애초에 있던 document, ticket 테이블은 최종적으로 존재하지 않는다. -> document는 6개 테이블로 쪼개졌고, ticket은 아예 빠졌다. access_audit_log는 audit_event로 이름이 바뀌면서 task·user 전용 컬럼 대신 범용 actor_id/target_id/target_type 구조로 일반화됐다. 처음 그린 설계도가 그대로 구현되는 경우보다, 만들면서 계속 깎여나가는 경우가 훨씬 많았다.
8주, 내가 맡은 자리
앞서 말했듯이 나는 이번 프로젝트에서 Frontend와 Infrastructure를 맡아 개발을 진행했다. 클라이언트 화면을 실제 서버 API와 연결하려면 결국 그 서버가 어딘가에 배포되어 있어야 했고, 팀에서는 그 ‘어딘가’를 책임질 사람이 필요했다. 그렇게 자연스럽게 배포 파이프라인과 클라우드 인프라를 구축하고, 이후에는 모니터링까지 담당하게 되면서 내 역할의 범위가 넓어졌다. 돌아보면 Frontend와 Infrastructure는 성격이 꽤 달랐다. Frontend에서는 Figma의 디자인을 픽셀 단위로 맞춰가며 사용자가 직접 보고 누르는 화면을 만드는 데 집중했다면, Infrastructure에서는 그 화면 뒤에서 서버와 배포 환경이 안정적으로 동작하도록 관리했다.
물론 Frontend와 Infrastructure 사이에 있는 DB 설계하는 부분에서도 참여했다. 7월 22일, 재성님과 함께 「DB 좀만 간략하게 나눠보자」라는 제목으로 초기 스키마 초안인 FOWOCO_ERD_mini와 이후 버전인 FOWOCO-ERD-miniv2를 작성했다. 화면을 구현하려면 어떤 데이터가 필요한지 가장 먼저 확인하는 사람이 프론트 담당자였고, 그 요구사항을 실제 테이블 구조로 옮기는 과정에도 초반부터 함께 참여했던 셈이다. 당시 설계한 뼈대는 이후 여러 차례 이름과 구조가 변경되었지만, 앞서 살펴본 ERD 변경 이력처럼 초기 구조를 함께 설계해본 경험은 이후 인프라 작업에서도 도움이 됐다. 특히 DB 역할을 fowoco_migration과 fowoco_runtime으로 분리하는 과정에서 기존 스키마와 데이터 구조를 낯설게 느끼지 않고 다룰 수 있었던 것도 이때의 회의 덕분이라고 생각한다.
Frontend
스택을 정하고 뼈대를 세우다
첫 주는 결정의 연속이었다. Next.js 대신 React 18 + Vite를 골랐다. FOWOCO는 내부 HR 도구라 SSR이 굳이 필요하지 않았고, 팀 컨벤션이 이미 React Query를 전제하고 있어서 Vue보다는 React가 자연스러웠다. (팀원들이 react를 부트캠프하며 학습해서 더 친화적이라고 생각했다.) Figma에서 9개 화면 카탈로그를 먼저 정리하고, ESLint·Prettier·Vitest에 react-query와 zustand까지 얹은 스캐폴드를 세웠다.
그다음 만든 게 PWF(우리 팀 디자인 시스템) 컴포넌트 라이브러리다. Button, StatusLabel, AgentSourceLabel, WorkflowStep, DecisionGate, EmptyState — 이 여섯 개가 이후 8주 내내 모든 화면의 기본 재료가 됐다. 로그인, HR 대시보드, 업무함, 작성·검토·케이스 화면, 근로자 관리, 근로자용 모바일 보안링크 화면까지 초기 화면들을 이 위에 얹었다. 아직 백엔드가 준비되지 않은 버튼에는 전부 TODO(backend) 주석을 달아두는 컨벤션을 이때 세웠는데, 이게 나중에 실제 API를 하나씩 연결할 때 빠뜨림 없이 체크리스트 역할을 해줬다.
데모 상태를 흉내 내는 법
초반에 만든 패턴 중 가장 오래 살아남은 건 useAsyncDemoData 훅이다. URL에 ?demoState= 쿼리 파라미터만 붙이면 로딩→성공/빈 상태/에러 전환을 그대로 재현할 수 있게 만든 훅인데, 백엔드가 없는 상태에서 화면의 모든 상태를 눈으로 확인하고 싶어서 만들었다. 이후 거의 모든 리스트 화면이 이 패턴을 그대로 따라갔다.
// src/hooks/useAsyncDemoData.ts
// TODO(backend): 실제 API 연동 시 이 훅을 React Query의 useQuery로 교체.
export type AsyncStatus = 'loading' | 'success' | 'empty' | 'error'

export function useAsyncDemoData(isEmpty: boolean, delayMs = 400) {
  const [searchParams] = useSearchParams()
  const forced = searchParams.get('demoState') as AsyncStatus | null

  const [status, setStatus] = useState<AsyncStatus>(forced ?? 'loading')

  useEffect(() => {
    if (forced) {
      setStatus(forced)
      return
    }

    setStatus('loading')
    const timer = setTimeout(() => {
      setStatus(isEmpty ? 'empty' : 'success')
    }, delayMs)

    return () => clearTimeout(timer)
  }, [forced, isEmpty, delayMs])

  return status
}
훅 하나 만들어놓고 나니 테스트도 편해졌다. 화면 테스트에서 ?demoState=loading, ?demoState=empty를 그냥 URL로 넘겨주면 로딩 문구나 "업무 만들기" 버튼이 뜨는 빈 상태를 그대로 검증할 수 있었다. Mock을 따로 세팅할 필요가 없어진 거다.
그 밖에도 이 시기엔 자잘하지만 쌓이면 큰 작업들을 했다. <select> 태그로는 스타일링에 한계가 있어서 커스텀 Dropdown을 직접 만들었고, Figma로 사전에 만들지 않았던 화면(/documents, /agent, /tickets)은 기존 리스트 페이지 톤을 참고해 스스로 설계했다. 필터 UI를 만들어놨는데 실제로 걸러지지 않는 버그가 몇 번 있었는데, 알고 보니 deadlineLabel처럼 화면엔 "D-12 체류"로 보이지만 실제로는 숫자로 비교할 필드가 데이터 모델에 아예 없는 경우였다. 표시용 문자열과 필터링용 필드를 분리해서 만들었다.
진짜 서버에 연결하기 시작하다
7월 말, 데모 로그인을 실제 /api/v1/auth/* 호출로 바꾸면서 첫 실제 연동이 시작됐다. Bearer 토큰 자동 첨부, refresh 쿠키, 401을 만나면 한 번만 갱신을 시도하고 재요청하는 API 클라이언트 레이어(apiFetch)를 먼저 만들고 그 위에 화면들을 하나씩 옮겼다. 핵심은 "동시에 여러 요청이 401을 받아도 refresh 호출은 딱 한 번만 나가야 한다"는 부분이었다.
// src/api/client.ts
let refreshPromise: Promise<boolean> | null = null

async function refreshAccessToken(): Promise<boolean> {
  // 동시에 여러 요청이 401을 받아도 refresh 호출은 한 번만 나가도록 single-flight로 묶는음
  if (!refreshPromise) {
    refreshPromise = (async () => {
      try {
        const response = await fetch(`${API_BASE_URL}/auth/refresh`, {
          method: 'POST',
          credentials: 'include',
        })
        if (!response.ok) return false
        const body = (await response.json()) as { access_token: string }
        setAccessToken(body.access_token)
        return true
      } catch {
        return false
      }
    })()
  }

  try {
    return await refreshPromise
  } finally {
    refreshPromise = null
  }
}

export async function apiFetch<T>(path: string, options: ApiFetchOptions = {}): Promise<T> {
  const { skipAuthRetry, ...init } = options

  let response: Response
  try {
    response = await rawFetch(path, init)
  } catch {
    throw networkApiError(path)
  }

  if (response.status === 401 && !skipAuthRetry) {
    const refreshed = await refreshAccessToken()
    if (refreshed) {
      try {
        response = await rawFetch(path, init)
      } catch {
        throw networkApiError(path)
      }
    } else {
      setAccessToken(null)
      authExpiredHandler?.()
      throw await parseErrorBody(response, path)
    }
  }

  if (!response.ok) {
    throw await parseErrorBody(response, path)
  }

  if (response.status === 204) {
    return undefined as T
  }

  return (await response.json()) as T
}refreshPromise를 모듈 스코프에 캐시해두고, 먼저 도착한 요청이 refresh를 진행하는 동안 뒤이어 도착한 401들은 그 Promise를 같이 기다리게 만들었다. 화면 하나에서 리스트 3개를 동시에 호출했다가 토큰이 만료된 순간에도, 서버에는 /auth/refresh가 딱 한 번만 날아간다.
single-flight 패턴이란? 동시에 여러 곳에서 같은 요청(여기서는 "토큰을 갱신해줘")이 발생했을 때, 실제 네트워크 호출은 딱 한 번만 내보내고 나머지는 그 하나의 결과를 같이 기다리게 만드는 패턴이다. Go 진영에서
golang.org/x/sync/singleflight패키지로 유명해진 이름인데, 자바스크립트에서는 "진행 중인 Promise를 변수에 저장해뒀다가 재사용"하는 방식으로 같은 효과를 낼 수 있다. 이 패턴이 없으면 토큰 만료 순간 화면에 떠 있는 API 호출 개수만큼 refresh 요청이 동시에 나가서, 서버 입장에서는 똑같은 refresh token으로 경쟁 상태(race condition)가 발생할 수 있다.
근로자 API를 붙이면서는 서버에 자유 텍스트 검색 파라미터가 없다는 걸 알게 돼서, 최대 100건을 가져온 뒤 클라이언트에서 걸러내는 방식으로 타협했다. Task API를 붙이던 중엔 더 근본적인 문제를 발견했다. 서버 Task API에는 담당자·승인자라는 개념 자체가 없었다. 화면은 이미 "담당자 배정"을 전제로 설계돼 있었는데, 그 개념이 백엔드에 없다는 걸 연동 도중에야 알게 된 거다. 결국 이 기능의 범위를 다시 조정해야 했다. Audit 로그를 붙일 때는 그 엔드포인트가 ADMIN 권한 전용이라 다른 역할에서는 403이 난다는 걸 확인하고 기존 에러 매핑으로 자연스럽게 처리했고, 서버의 ActorType 4종에 "근로자 응답"이라는 값이 없어서 AgentSourceLabel에 새 항목을 하나 추가해야 했다.
서버가 아직 못 만든 기능은 클라이언트가 흉내 냈다. HWP 업로드 화면은 서버에 파일 업로드 코드가 아예 없어서, 드래그앤드롭과 확장자·용량 검증까지는 진짜로 만들되 업로드 자체는 setTimeout으로 흉내 냈다. 팀원 초대나 4단계 대량 파일 임포트 마법사(컬럼 매핑, 충돌 해결, 실패 행 재시도까지)도 서버에 대응하는 API가 없어서 전부 클라이언트에서만 완결된 시뮬레이션으로 구현했다. 반대로 온보딩 투어는 "실제로 완성된 기능"이라고 PR 설명에 따로 적어뒀는데, 백엔드 의존성이 전혀 없는 몇 안 되는 기능이라서였다.
기존 디자인 전체적으로 변경하기
7월 말 Figma가 v3로 재정렬되면서 인트로 랜딩 페이지(스크롤에 따라 점이 채워지는 네비게이션은 Figma에 없던 걸 직접 추가), 로그인·회원가입 화면(비밀번호 강도 미터, 약관 체크, 원클릭 데모 로그인), 4단계 비밀번호 재설정 플로우를 새로 만들었다. 헤더에 알림 벨과 프로필 드롭다운을 달고 /profile 페이지를 신설해 그동안 눌러도 404였던 "내 프로필" 링크를 살려냈다.
이 시기 가장 과감했던 결정은 SettingsPage를 통째로 삭제한 것이다. 탭 6개로 된 화면이였는데 사용자(팀) 요청으로 "설정" 메뉴를 프로필 페이지로 흡수시키고 지웠다. 같은 시기에 타임존 버그도 하나 잡았다. "YYYY-MM-DD" 형식의 날짜 문자열을 new Date()로 파싱하면 UTC 자정으로 해석되는데, 비교 대상인 "오늘"은 로컬 자정이었다. 그래서 비UTC 시간대에서는 항상 하루가 밀리는 오차가 났다. 테스트 헬퍼 코드에도 같은 실수가 있어서 같이 고쳤다.
 // src/utils/urgency.ts
 export function daysUntil(dateString: string | null): number | null {
   if (!dateString) return null
-  const target = new Date(dateString)
+  // "YYYY-MM-DD"를 new Date()로 바로 파싱하면 UTC 자정으로 해석되어, 이후 로컬 자정 기준
+  // today와 비교할 때 타임존에 따라 하루 오차가 생긴다. Y/M/D를 직접 꺼내 로컬 자정으로 만든다.
+  const [year, month, day] = dateString.split('-').map(Number)
+  const target = new Date(year, month - 1, day)
   const today = new Date()
   today.setHours(0, 0, 0, 0)
-  target.setHours(0, 0, 0, 0)
   return Math.round((target.getTime() - today.getTime()) / (1000 * 60 * 60 * 24))
 }
new Date("2026-08-13")처럼 문자열만 넘기면 JS는 이걸 ISO 8601로 인식해서 UTC 자정(2026-08-13T00:00:00Z)으로 해석한다. 반면 new Date(2026, 7, 13)처럼 숫자 세 개로 넘기면 로컬 자정으로 만들어진다. 한국 시간(UTC+9)에서는 이 차이가 항상 마감일을 하루 당겨서 보여주는 방향으로 오차를 만들었다 — D-1이어야 할 서류가 화면에서는 계속 D-0으로 보이는 식이었다.
화면마다 스펙을 문서로 남기다
8월 7일, 화면이 웬만큼 쌓인 시점에 "Client v2.0.0"이라는 버전을 찍고 화면 13개 전부에 스펙 문서를 붙였다. 각 화면에 AUTH-001, DASH-001, TASK-002처럼 고유 ID를 매기고, 그 화면이 어떤 API에 의존하는지, 핵심 기능이 뭔지(보통 4개 이내로), 그리고 화면 전환 규칙이 뭔지를 표로 정리했다. 그냥 화면을 만들고 끝이 아니라 "이 화면이 왜 이렇게 생겼는지"를 문서로 남기는 작업이었다.
몇 개만 옮겨보면 이렇다.
DASH-001 (Today 대시보드, /dashboard, Task·Case API)
기한·승인·정보 보완 상태를 한 화면에서 우선순위로 재구성하고, 자연어 업무 요청을 바로 Case 후보로 연결한다.
주요 전환: 업무 요청 →/tasks/new· 우선 업무·검토 버튼 →/tasks/{taskId}· 상태 카드 →/tasks?status=…
TASK-002 (자연어 업무 생성, /tasks/new, Analysis·Task API)
HR 원문을 그대로 남긴 채 Agent 해석, 복합 요청 분해, 필수정보 출처를 함께 보여주고 생성 전 확인을 받는다.
운영 기준: Agent 분석만으로 업무를 자동 확정하지 않음 — 후보 Task는 HR이 확인한 뒤에야 확정된다.
REVIEW-001~003 (정보 보완 → 문서 초안 준비 → 문서 최종 검토)
REVIEW-001: 누락정보를 HR 직접 입력·근로자 보안 링크·기존 DB 조회 세 경로로 구분하고, 근로자가 보안 링크로 제출한 값은 "HR이 적용하기 전까지는 확정하지 않는 후보 상태"로 유지한다.
REVIEW-003: 수정은 화면에서 필드를 직접 고치는 게 아니라, 구조화된 필드 값을 고친 뒤 문서를 다시 생성하고 검증을 재실행하는 방식으로만 허용한다. "PDF 직접 편집은 제공하지 않음"이라고 못 박아뒀다 — 편집 결과와 검증된 필드값이 어긋나는 사고를 원천적으로 막기 위해서였다.
사용자처럼 눌러보다가 발견한 것들
8월 중순, 실제로 화면을 클릭해가며 QA를 하다가 꽤 심각한 문제 세 개를 연달아 발견했다. 사이드바에 "근로자" 메뉴 항목 자체가 빠져 있어서, 근로자 목록 화면은 만들어놨는데 실사용 흐름에서는 사실상 도달할 방법이 없었다. 대시보드 우선순위 카드에는 "이름 미제공"이 자주 떴는데, 알고 보니 근로자 이름을 다른 API 응답과 우연히 겹치는 방식으로만 구해오고 있어서 그 우연이 어긋나면 이름이 사라지는 구조였다. 데모 로그인 버튼은 다른 계정을 가리키고 있었고, 프로필 페이지는 실제 로그인한 사람과 전혀 무관한 가짜 데이터를 보여주고 있었다. 셋 다 코드 리뷰만으로는 절대 못 잡았을, 실제로 눌러봐야만 보이는 버그였다.
프로필 페이지의 걷어내기
이 마지막 사건이 이어져서 몇 주짜리 작업이 됐다. 처음 만든 프로필 페이지는 표시 이름, 연락처, 최근 로그인, 계정 상태, 비밀번호 변경일, 알림 설정까지 전부 profileData.ts에 하드코딩된 값이었다. 화면만 보면 그럴싸했지만 전부 가짜였다. 이걸 실제 데이터로 바꾸는 작업을 서버 팀과 맞춰가며 진행했다. 서버 쪽에서 phone 컬럼과 프로필 API, 로그인 기록용 user_login_event 테이블(User-Agent로 기기 정보까지 요약), password_changed_at, 알림 설정 테이블을 순서대로 만들어줬고, 나는 그때그때 클라이언트를 붙였다. 원칙은 하나였다. 서버에 대응하는 개념이 없는 필드는 지어내지 않고, 화면에서 지운다. 예를 들어 "담당 영역" 같은 필드는 서버에 대응 개념이 없어서 그냥 삭제했다. 이 원칙을 지키다 보니 자연스럽게 화면이 서버 데이터 모델과 일치하게 됐다.
그 밖에 남긴 작업들
npm에서 bun으로 마이그레이션하면서 Husky·lint-staged·Dependabot을 추가했다. 이 과정에서 Windows 환경에서만 Vitest 워커 풀이 멈추는 버그를 만나 pool: threads로 고정해 해결했다. ESLint를 메이저 버전으로 올릴 때는 React Compiler를 아직 쓰지 않는 프로젝트라 관련 룰이 useApiQuery 패턴(fetch 후 setState)을 오탐지하는 걸 확인하고 해당 룰만 비활성화했다. 회원가입 관련해서는 실서비스에 영향을 주는 버그도 하나 잡았다. 서버가 agreements 필드를 @NotNull로 요구하도록 바뀌었는데, 클라이언트는 그 필드를 아예 보내지 않고 있었다. 그 결과 실제로는 모든 회원가입 요청이 400 에러로 실패하고 있었다. curl로 직접 재현해서 필드 없이 보내면 400, 넣으면 201이 되는 걸 확인하고 바로 고쳤다.
 // src/pages/SignupPage/SignupPage.tsx
+// 화면에 표시된 약관 버전. 약관 문구가 바뀌면 같이 올린다.
+const TERMS_VERSION = '1.0'
+
 body: JSON.stringify({
   company_name: workplace,
   display_name: name,
   email,
   password,
+  agreements: {
+    service_terms: { agreed: termsAgreed, version: TERMS_VERSION },
+    privacy_policy: { agreed: privacyAgreed, version: TERMS_VERSION },
+    marketing: { agreed: marketingOptIn, version: TERMS_VERSION },
+  },
 }),
화면에는 이미 약관 체크박스 세 개(서비스 이용약관, 개인정보처리방침, 마케팅 수신)가 다 붙어 있었다. 문제는 그 체크 상태(termsAgreed, privacyAgreed, marketingOptIn)를 실제 요청 바디에 담아 보내는 코드가 빠져 있었다는 것뿐이었다. 화면만 보면 정상 작동하는 회원가입 폼처럼 보이는데, 제출 버튼을 누르는 순간 서버가 매번 400을 돌려주고 있었던 셈이다.
Infra
k3s
FOWOCO는 client·server·ai·postgres, 딱 4개 배포 단위로 구성된 모듈러 모놀리스다. 서비스 수십 개가 서로 호출하며 얽히는 마이크로서비스 구조가 아니고, 실사용자도 평가 기간 동안 소수(5~20명 수준)만 붙는 데모·파일럿 성격이 짙었다. 그러니 인프라 도구를 고를 때 기준은 "얼마나 강력한가"가 아니라 "이 규모에 이 정도 복잡도가 정당한가"였다. 그 기준으로 봤을 때 k3s(경량 쿠버네티스)가 맞아떨어졌다. 단일 서버 한 대로 4개 배포 단위를 충분히 감당하면서도, kubectl과 매니페스트 문법은 실제 프로덕션 쿠버네티스와 100% 동일해서 지금 배우는 게 그대로 실무 지식이 된다고 생각했다. 인프라를 혼자 맡아 몇 주 안에 배우면서 동시에 운영까지 끝내야 했던 일정도 무시할 수 없는 조건이었다. (학습 곡선이 가파른 도구를 골랐다면 도구를 익히는 데 시간을 다 쓰고 정작 서비스를 안정적으로 띄우는 데는 못 썼을 것이라고 생각한다.)
k3s란?
Rancher Labs(현 SUSE)가 만든 경량 쿠버네티스 배포판이다. etcd 대신 기본적으로 내장 SQLite를 쓰고, 클라우드 프로바이더용 플러그인이나 레거시 알파 API 같은 걸 빼서 바이너리 하나가 100MB가 안 된다. 그래서 단일 서버 한 대에도 무리 없이 올라가면서,kubectl로 다루는 방식이나 매니페스트 문법은 실제 쿠버네티스와 100% 동일하다.
공식 문서: docs.k3s.io
Oracle
원래 계획은 Oracle Cloud Always Free의 Ampere A1(ARM) 인스턴스 2대로 k3s 클러스터를 무료로 굴리는 것이었다. VCN·서브넷·인터넷 게이트웨이·API 키까지 다 준비했는데, 문제는 도쿄 리전에서 인스턴스를 만들 때마다 Out of host capacity가 떴다는 거다. 수동 클릭과 90초 간격 자동 재시도를 합쳐 5일 동안 138회 이상 시도했지만 전부 실패했다. (처음 계정을 선택할꺠 도쿄를 잘못 눌렀다..)
원인을 추적해보니 Oracle이 2026년 6월 15일 Always Free ARM 할당량을 4 OCPU/24GB에서 2 OCPU/12GB로 아무 공지 없이 줄여버린 상태였다. 줄어든 공급에 수요가 몰리니 재고가 남아날 리 없었다. 리전을 도쿄에서 춘천으로 옮겨보려 했지만, Oracle은 테넌시 생성 시점의 홈 리전에 IAM 데이터를 고정해버려서 계정을 새로 만들지 않는 이상 리전 이전이 불가능했다. 게다가 나중에 확인해보니 Ampere A1 Always Free 자체가 한국 춘천 리전에서는 아예 제외 대상이었다.
이 과정에서 자잘한 삽질도 많았다. 인스턴스 생성 마법사 안의 "새 퍼블릭 서브넷 만들기" 옵션은 실제로는 인터넷 게이트웨이·라우팅을 만들어주지 않는 반쪽짜리 기능이라, 별도로 VCN 마법사를 완주해야 했다. API 키/지문이 완벽히 일치하는데도 OCI CLI가 계속 401을 뱉었는데, 알고 보니 새로 만든 API 키가 Oracle 인증 서버에 전파되는 데 시간이 걸리는 문제였다(콘솔엔 바로 보이지만 실제 인증까지는 1~2분). 자동 재시도 스크립트를 짜면서는 에러 메시지를 "Out of capacity"로 매칭하도록 짰는데 실제 API 메시지는 "Out of host capacity."였다. 한 단어 차이로 모든 실패가 "예상치 못한 에러"로 잘못 분류되고 있었다. 노트북이 절전 모드에 들어가면서 백그라운드 프로세스는 살아있는데 실제 재시도 간격이 몇 시간으로 늘어져버린 것도 138회라는 숫자에 한몫했다.
비용을 생각하자
Oracle, GCP e2-micro, AWS, Hetzner, DigitalOcean, Vultr Seoul, 여러 cloud를 조사하며 가격과 조건을 비교했다.KT 에이블스쿨은 클라우드 크레딧을 별도로 지원하지 않았기에 처음엔 Vultr Seoul(월 $10~20, 국내 리전, 재고 걱정 없음)로 잠정 결론을 냈다. 그런데 Oracle 실패 원인을 명확히 진단하고 나니 AWS를 다시 봐야겠다는 생각이 들었다. AWS는 신규 계정에 6개월간 $200 크레딧을 지급하고, t3/t4g 계열 프리티어 인스턴스는 Oracle의 ARM처럼 재고 부족을 겪는 일이 거의 없었다. 2~3주짜리 짧은 데모 기간이라면 이 크레딧만으로 사실상 무료였다. 결국 같은 날 안에 계획을 다시 뒤집어 AWS로 최종 결정했다.
AWS
IAM 사용자(fowoco-admin)를 만들고, 기본 VPC를 그대로 쓰고(Oracle처럼 VCN을 직접 만들 필요가 없었다), 보안 그룹에 22/80/443/6443 포트를 열었다. 신규 계정은 임의 인스턴스 타입을 못 쓰고 프리티어 대상만 launch할 수 있다는 제약이 있었는데, describe-instance-types 필터로 확인해보니 m7i-flex.large(2vCPU/8GB)가 프리티어 대상이었다. Oracle에서 다운사이징까지 고민했던 것과 비교하면 훨씬 넉넉한 스펙을 그대로 받은 셈이다. fowoco-node-1이라는 이름으로 서울 리전에 인스턴스를 띄우고 --tls-san <퍼블릭 IP> 옵션으로 k3s를 단일 노드로 설치했다(이 옵션이 없으면 로컬 kubectl이 퍼블릭 IP로 붙을 때 인증서 에러가 난다). 더 이상 재고 부족 때문에 노드를 나눌 이유가 없어져서 2노드 계획을 단일 노드로 단순화했고, 비용 부담이 사라진 김에 외부 관리형 DB 대신 Postgres를 컨테이너로 직접 운영하기로 되돌렸다.
"다른 저장소는 건드리지 않는다"는 원칙
클러스터가 뜨자마자 세운 원칙이 하나 있다. 작업하다 보면 client/server/ai 래포 저장소까지 손대고 싶어지는 순간이 자주 왔는데, 그 저장소들은 팀원들이 매일 커밋하는 곳이라 인프라 작업이 충돌을 일으킬 수 있었다. 그래서 "다른 저장소는 건드리지 않고 infra 저장소에만 작업한다"는 원칙으로 전환했다. 정말 필요한 변경(Dockerfile 개선, CI/CD)은 문서로 남겨 나중에 팀과 논의한 뒤 적용하기로 했다. infra 저장소는 이후 이슈를 먼저 등록하고 PR을 여는 방식으로 26개의 PR을 작성하며 팀원들에게 물어보고 진행했다.
k8s 매니페스트(네임스페이스·Postgres StatefulSet·서버/AI/클라이언트 Deployment·Ingress)를 채워 PR #1을 올리고, 문서는 저장소 README 대신 GitHub Wiki로 옮겼다.
초록불인데 아무것도 배포되지 않고 있었다
세 저장소(client/server/ai)의 배포 워크플로우가 전부 kubectl set image ... || echo "..." 형태로 짜여 있었는데, 이 || echo가 rollout 실패를 조용히 성공으로 둔갑시키고 있었다. CI는 몇 주 내내 초록불이었는데, 실제로는 단 한 번도 제대로 배포된 적이 없었다. client부터 self-heal 패턴(배포할 때마다 infra 매니페스트를 다시 apply하는 방식)으로 바꾸고 나서야 rollout이 실제로 타임아웃되는 게 보였고, 원인을 진단해보니 GHCR 이미지가 기본값으로 private이라 클러스터가 이미지를 못 당겨오는 ImagePullBackOff였다. private→public 전환은 API로는 항상 404가 나고 웹 UI에서만 가능하다는 것도 이때 알았다. 고치고 나서 curl로 200을 확인했다. 같은 날 client에 PR 병합 전 검증용 CI(lint/test/build)를 처음 추가했는데, 그 첫 실행에서 기존에 있던 flaky 테스트(비동기 fetch 후 라우팅되는 화면에서 동기 assertion을 쓰다 보니 타이밍에 따라 실패)를 바로 잡아냈다. findByText로 바꿔 해결했다.
3개의 래포 서빙하기
server와 ai의 첫 실배포일이다. server는 이미 팀원이 준비해둔 PR(#97)이 기다리고 있었고, ai에도 client와 같은 self-heal 패턴을 적용했다. 이날 보안 그룹도 정리했다. SSH(22)는 완전히 차단했는데, kubectl이 KUBE_CONFIG로 직접 붙는 구조라 실제로 SSH를 쓰는 사람이 없었기 때문이다. 반면 k3s API 포트(6443)는 계속 열어둘 수밖에 없었다. GitHub Actions 러너가 7,300개가 넘는 IP 대역에서 오기 때문에 화이트리스트가 사실상 불가능했고, 대신 TLS 클라이언트 인증서가 실질적인 방어선이라고 판단했다.
server 최초 부트스트랩에서는 DB 계정을 마이그레이션용(fowoco_migration)과 런타임용(fowoco_runtime)으로 분리하는 작업까지 함께 했다. fowoco_migration은 Flyway가 테이블을 만들고 고치는 권한을 갖고, fowoco_runtime은 서버가 평소에 데이터를 읽고 쓰는 것(DML)만 할 수 있다. —> 스키마 자체를 건드릴 권한은 없다. 이렇게 나눠두면 서버 코드에 SQL 인젝션 같은 취약점이 있어도, 뚫린 계정으로는 테이블 구조 자체를 망가뜨릴 수 없다.
PostgreSQL RLS(Row-Level Security)란?
같은 테이블 안에서도 접속한 사용자(정확히는 세션의 role)에 따라 어떤 행(row)을 볼 수 있는지를 DB 엔진 레벨에서 강제하는 기능이다. 애플리케이션 코드가
WHERE company_id = ?를 매번 정확히 넣어준다고 믿는 대신, DB 자체가 정책(POLICY)으로 "이 role은 자기 회사 행만 본다"를 강제하기 때문에, 서버 코드에 실수로 필터를 빼먹는 버그가 있어도 다른 사업장 데이터가 새어나가지 않는다. FOWOCO는 이 정책을 이용해 사업장(company) 단위 테넌트 격리를 구현했다.
공식 문서: postgresql.org/docs — Row Security Policies
이 과정에서 새 버그 두 개를 만났다. 하나는 쿠버네티스가 Service 이름을 그대로 따서 자동 주입하는 SERVER_PORT 환경변수가 Spring Boot의 server.port 설정과 충돌해 부팅이 깨지는 문제, 다른 하나는 AI_RUNTIME_SERVICE_CREDENTIAL이라는, 선택값처럼 보이지만 실제로는 필수인 값이 빠져 있던 문제였다.
첫 번째 버그의 원인은 쿠버네티스의 아주 오래된 레거시 기능이었다. 같은 네임스페이스에 떠 있는 모든 Service에 대해, 쿠버네티스는 Docker Link 시절의 호환성을 위해 <서비스이름>_PORT 형태의 환경변수를 파드마다 자동으로 주입한다. 그런데 우리 Service 이름이 그냥 server였다.
# k8s/02-server.yaml
# SERVER_PORT(예: tcp://10.43.x.x:8080)가 Spring Boot의 server.port 프로퍼티랑
# 이름이 충돌해서 부팅 자체가 실패한다 (2026-08-06 실제로 겪음). 다른 서비스도 예방 차원에서 동일하게 끔.
apiVersion: apps/v1
kind: Deployment
metadata:
  name: server
spec:
  template:
    spec:
      enableServiceLinks: false   # 이 한 줄이 없으면 SERVER_PORT=tcp://10.43.x.x:8080 이 주입된다
      containers:
        - name: server
          image: ghcr.io/fowoco/server:latest
SERVER_PORT=tcp://10.43.178.92:8080 같은 문자열이 자동으로 주입되니, Spring Boot는 이걸 자기 설정 프로퍼티 server.port로 착각하고 Invalid value 'tcp://...' for configuration property 'server.port' 에러를 내며 부팅 자체를 거부했다. 서버 코드에는 아무 문제가 없는데, 순전히 Service 이름과 Spring 프로퍼티 이름이 우연히 겹쳐서 난 사고였다. enableServiceLinks: false를 네 개 워크로드 전부에 걸어 예방했다. (이 자동 주입 동작은 쿠버네티스 공식 문서의 "Discovering services" 절에 정확히 나온다: 파드 시작 이전에 존재하던 모든 Service가 도커 링크 스타일의 {SVCNAME}_SERVICE_HOST/{SVCNAME}_PORT 환경변수로 자동 노출된다 — kubernetes.io/docs — Environment Variables)
이 두 개를 고치고 나서야 4개 파드가 전부 1/1 Running 상태가 됐고, Flyway가 테이블 30개를 만들었고, Ingress의 /api 라우팅이 확인됐다.
세 개의 운영 장애
8월 10일, server의 self-heal PR(#97)이 GitHub Actions 자체 플랫폼 장애로 두 번 실패한 뒤 세 번째 시도에서야 병합됐다. 그리고 그날 실제 운영 장애 세 개를 연달아 만나서 수정했다.
- 시크릿을 병합하는
awk스크립트 버그로 모든 값 앞에 공백이 하나씩 붙어서DB_URL이" jdbc:postgresql://..."형태가 됐고, Spring의 URL 접두사 검증에 걸려 부팅이 실패했다. - 부트스트랩 함수 7개에 자동으로 권한을 부여하는 PR이 있었는데, 이 PR은 빈 데이터 디렉터리(initdb 시점)에만 적용되는 마이그레이션이라 이미 떠 있던 운영 DB에는 조용히 적용되지 않고 있었다. 살아있는 DB에 같은 GRANT 7개를 수동으로 실행해야 했다.
/app/data디렉터리에 볼륨이 없는 채로 논루트(UID 10001) 프로세스가 쓰기를 시도해AccessDeniedException이 났다. PVC와fsGroup: 10001을 추가해 해결했다.
같은 날 진짜 구멍도 몇 개 찾았다. Postgres와 파일 데이터가 전부 로컬 디스크에만 있는데 EBS 스냅샷이 단 하나도 없었다. AWS Data Lifecycle Manager로 매일 저녁 6시(KST) 자동 스냅샷, 7일 보관 정책을 만들었다. 4개 워크로드 전부 readinessProbe만 있고 livenessProbe가 없어서, 멈췄지만 죽지는 않은 파드는 영원히 트래픽만 못 받을 뿐 재시작되지 않는다는 걸 알고 추가했다. EC2 종료 보호가 꺼져 있던 것도 켰고, 비용 알람이 하나도 없다는 것도 확인해서 월 $20 기준 CloudWatch·SNS 알림을 추가했다.
개선하기
모니터링 대시보드를 만들면서 /actuator 경로가 이제껏 외부에서 아예 안 보이고 있었다는 걸 발견해 라우팅을 뚫었다. 그런데 대시보드가 브라우저에서 서버 상태를 직접 호출하려니 CORS에 막혔다. 이건 의도된 제한이라 우회 경로를 만들었다. 10분마다 헬스체크를 하는 GitHub Actions 워크플로우가 status.json을 별도 브랜치에 커밋하면, raw.githubusercontent.com이 Access-Control-Allow-Origin: *를 내려주기 때문에 그걸 대신 읽는 식이다. 실제 파드 상태를 보여주기 위해서는 관리자 kubeconfig를 그대로 쓰는 대신, 파드 조회 권한만 있는 status-reader ServiceAccount를 새로 만들었다. 시크릿 접근이나 파드 삭제는 실제로 Forbidden이 뜨는지 직접 테스트까지 한 뒤에 등록했다.
# .github/workflows/status-check.yml
#
# KUBE_CONFIG는 클러스터 관리자 kubeconfig가 아니라, fowoco 네임스페이스 파드
# get/list만 되는 별도 ServiceAccount(status-reader)의 스코프 kubeconfig다 —
# secrets 조회·삭제 등은 전부 Forbidden으로 막혀있는 걸 직접 확인하고 등록함.
- name: Fetch pod status
  run: |
    mkdir -p ~/.kube
    echo "${{ secrets.KUBE_CONFIG }}" | base64 -d > ~/.kube/config
    kubectl -n fowoco get pods -o json > /tmp/pods-raw.json || echo '{"items":[]}' > /tmp/pods-raw.json
    jq '[.items[] | {
          name: .metadata.name,
          app: .metadata.labels.app,
          ready: ([.status.containerStatuses[]?.ready] | all),
          restarts: ([.status.containerStatuses[]?.restartCount] | add // 0),
          phase: .status.phase,
          age_started: .status.startTime
        }]' /tmp/pods-raw.json > /tmp/pods.json
이 작업 도중 관리자 kubeconfig를 그대로 꺼내 쓰려던 시도가 세션 자체의 자율 실행 정책에 막힌 적이 있었는데, 돌아보면 그 제약 덕분에 더 안전한 방식을 찾았다. 새로 스코프를 좁힌 자격증명을 만드는 우회가 정책과도 부딪히지 않고 보안상으로도 더 낫다는 걸 이때 배웠고, 이후로도 같은 패턴을 계속 썼다. 디스크 문제도 해결했다. ai 재배포 때마다 반복되던 디스크 압박을 없애려고 EBS 루트 볼륨을 30GB에서 100GB로 무중단 온라인 확장했다. 그런데 이 노드는 SSH를 이미 막아둔 상태라, kubectl run으로 호스트 루트(/)를 마운트한 특권 파드를 띄운 뒤 chroot와 nsenter --target 1로 호스트에 진입해 리사이즈 명령을 실행하는 방식을 새로 만들었다. GitHub의 시크릿 스캐닝·푸시 보호 기능도 5개 저장소에 한 번에 켰다.
HTTP를 HTTPS로 강제 전환하는 작업에서는 사소하지만 결과가 전부였던 실수도 겪었다. k3s 내장 Traefik에 HelmChartConfig를 얹어 301 리다이렉트를 걸었는데, 첫 PR에서 쓴 values 키 경로가 실제 스키마보다 한 단계 얕았다.
 # k8s/07-traefik-https-redirect.yaml
 valuesContent: |-
   ports:
     web:
-      redirections:
-        entryPoint:
-          to: websecure
-          scheme: https
-          permanent: true
+      http:
+        redirections:
+          entryPoint:
+            to: websecure
+            scheme: https
+ permanent: trueports.web.redirections.entryPoint라고 썼는데 실제 Traefik Helm 차트 스키마는 그 밑에 http가 한 단계 더 있는 ports.web.http.redirections.entryPoint였다. 문제는 Helm이 스키마에 없는 키를 만나도 에러를 내지 않고 그냥 조용히 무시한다는 점이다. helm upgrade는 매번 "성공"이라고 출력했고, 리소스도 정상적으로 갱신됐지만, 정작 HTTP→HTTPS 리다이렉트는 단 한 번도 실제로 적용된 적이 없었다. 겉으로 보이는 신호(성공 로그)와 실제 동작이 어긋난다는 걸 브라우저에서 http://로 직접 접속해보고서야 알아챘다. 이후로는 Traefik처럼 커뮤니티 차트를 건드릴 때 helm show values traefik/traefik으로 실제 스키마를 먼저 뽑아보고, 그 경로를 그대로 복사해서 쓰는 습관이 생겼다. 쿠키·CORS도 같이 강화했다. REFRESH_TOKEN_COOKIE_SECURE=true로 바꾸고, 허용 CORS origin에서 http://를 없앴고, WORKER_PORTAL_BASE_URL을 HTTPS로 바꾸면서 그동안 실제 휴대폰에서 안 열리던 SMS 링크 문제도 함께 풀렸다.
AI 관련 버그도 수정했다. "Agent" 업무 요청 기능이 어떤 근로자 이름을 넣어도 항상 TARGET_NOT_FOUND가 났는데, 원인은 AI가 추출한 대상 이름에 한국어 조사가 그대로 붙어 있던 것이었다(예: "체아의"). 처음엔 이/가/을/를/은/는 같은 조사를 무조건 잘라내려 했는데, 이렇게 하면 "리웨이" 같은 외국인 음역 이름이 "리웨"로 잘못 잘려나가는 부작용이 있었다.
# app/agents/pipeline.py
#
# 받침 유무에 따라 짝이 갈리는 조사. 값은 "이 조사가 오려면 앞 음절에
# 받침이 있어야 하는가". 예: "이"(주격)는 받침 있는 음절 뒤에만 오고,
# 받침 없는 음절 뒤에는 "가"가 온다. 이 규칙에 안 맞으면 조사가 아니라
# 음역 인명의 마지막 음절로 보고 자르지 않는다 (예: "리웨이"의 "이"는
# "웨"(받침 없음) 뒤에 왔으니 규칙상 "가"여야 함 -> 조사 아님, 안 자름).
_NAME_JOSA_PAIRS: dict[str, bool] = {
    "이": True, "가": False,   # 주격
    "은": True, "는": False,   # 보조사
    "을": True, "를": False,   # 목적격
}
_NAME_JOSA_INVARIANT = ("의",)  # 받침 유무와 무관하게 항상 같은 형태 (예: "체아의" -> "체아")


def _has_batchim(ch: str) -> bool | None:
    code = ord(ch) - 0xAC00
    if code < 0 or code > 11171:
        return None  # 한글 음절이 아님 (영문/숫자 등) -> 판단 불가
    return code % 28 != 0


def _strip_trailing_josa(tok: str) -> tuple[str, bool]:
    if len(tok) < 2:
        return tok, False
    last = tok[-1]
    if last in _NAME_JOSA_INVARIANT:
        return tok[:-1], True
    needs_batchim = _NAME_JOSA_PAIRS.get(last)
    if needs_batchim is None:
        return tok, False
    prev_has_batchim = _has_batchim(tok[-2])
    if prev_has_batchim is None or prev_has_batchim != needs_batchim:
        return tok, False
    return tok[:-1], True
한글 완성형 음절은 유니코드 상에서 (초성 × 21 + 중성) × 28 + 종성 + 0xAC00이라는 규칙적인 구조로 배열돼 있다. 그래서 음절 코드에서 0xAC00을 뺀 값을 28로 나눈 나머지가 0이면 받침이 없고, 아니면 받침이 있다는 걸 계산으로 바로 알 수 있다. 이 계산으로 "조사 후보 글자의 받침 요구 조건"과 "그 앞 글자의 실제 받침 유무"가 서로 맞아떨어질 때만 진짜 조사로 인정하고 잘라냈다. "체아의"는 받침 무관 조사라 바로 잘리고, "리웨이"는 "웨"(받침 없음)인데 "이"는 받침 있는 음절 뒤에만 오는 조사라 조건이 안 맞아 그대로 남는다. 회귀 테스트도 두 케이스를 나란히 박아뒀다.
def test_plan_strips_trailing_josa_from_target_display_name() -> None:
    # 회귀 재현: "속 체아의" -> 조사 "의"가 안 떨어져서 server의 exact-match 조회가
    # 항상 TARGET_NOT_FOUND로 실패했던 문제 (2026-08-13).
    ...
    assert res.context_requirement.target_display_name == "속 체아"


def test_plan_does_not_truncate_names_ending_in_a_particle_like_syllable() -> None:
    # "리웨이"처럼 마지막 음절이 조사(이/가 등)와 우연히 겹치는 음역 인명은 안 잘려야 한다.
    ...
마지막으로 그날 크래시가 두 건 더 있었다. ai는 언어 지원 기능(임베딩 모델)이 붙으면서 OOMKilled가 나서 메모리 한도를 512Mi에서 2048Mi로 올렸다. server는 두 가지 이유로 크래시 루프에 빠졌는데, 하나는 예전 데모 시드 가드가 남아있던 UUID 13개를 보고 오탐한 것(데모 시드를 끄는 것으로 해결), 더 근본적인 원인은 probe timeout이 기본값 1초인데 /actuator/health 응답이 실제로는 1.3~1.4초 걸려서 구조적으로 영원히 실패할 수밖에 없었던 것이었다.
 # k8s/02-server.yaml
 readinessProbe:
   httpGet:
     path: /actuator/health/readiness
     port: 8080
   initialDelaySeconds: 20
   periodSeconds: 10
+  timeoutSeconds: 5
 livenessProbe:
   httpGet:
     path: /actuator/health/liveness
     port: 8080
   initialDelaySeconds: 30
   periodSeconds: 15
   failureThreshold: 5
+  timeoutSeconds: 5
readinessProbe·livenessProbe란?
쿠버네티스가 파드가 살아있는지 주기적으로 확인하는 두 가지 헬스체크다. readinessProbe는 "지금 트래픽을 받을 준비가 됐는가"를 봐서 실패하면 그 파드로 요청을 안 보내고(파드는 안 죽인다), livenessProbe는 "이 프로세스가 아예 멈췄는가"를 봐서 실패하면 kubelet이 컨테이너를 강제로 재시작한다. 두 probe 모두
timeoutSeconds(응답을 기다리는 최대 시간, 기본값 1초)를 넘기면 그 시도는 "실패"로 기록된다.
공식 문서: kubernetes.io/docs — Configure Liveness, Readiness and Startup Probes
timeoutSeconds를 안 적으면 쿠버네티스는 기본값 1초를 쓴다. 그런데 /actuator/health는 DB 커넥션 풀·디스크·외부 연동까지 다 확인하고 응답하느라 1.3~1.4초가 걸렸다. 즉 이 파드는 정상적으로 살아있고 응답도 하는데, 그 응답이 쿠버네티스가 기다려주는 시간보다 0.3~0.4초 항상 더 걸렸던 것뿐이다. probe는 영원히 "실패"로 기록되고, kubelet은 그걸 보고 계속 파드를 재시작시킨다. (겉으로는 끝없는 크래시 루프처럼 보이지만 애플리케이션 코드에는 버그가 하나도 없는 상황이었다. timeoutSeconds: 5로 넉넉하게 늘려주는 것만으로 postgres·server·ai 네 워크로드 전부의 재시작이 멈췄다.)
겉보기엔 "AI 파이프라인이 고장 난 것 같다"는 증상이었지만, 실제 원인은 완전히 다른 레이어에 있었던 경우가 이 8월 13일 하루에만 세 번(조사 버그, SERVER_PORT류 문제, probe timeout) 반복됐다. 증상만 보고 짐작하지 말고, 항상 실제 로그와 스택트레이스로 정확한 실패 지점을 먼저 확인한다는 점을 많이 배웠다.
로컬 데모 환경, 터널링
배포된 클러스터와 별개로, 개발 중에는 로컬 컴퓨터에서 띄운 화면을 팀원이나 근로자 역할을 맡은 테스트 참여자의 휴대폰으로 바로 열어봐야 하는 상황이 잦았다. 처음엔 localhost.run 같은 무료 터널링 서비스를 썼는데, 응답이 느린 데다 접속 주소가 재시작할 때마다 바뀌어서 그때마다 CORS 허용 목록을 다시 고쳐야 했다. 더 큰 문제는 데모 도중 뭔가 안 열리면 그게 터널링 서비스 문제인지 우리 앱 문제인지부터 구분이 안 됐다는 거다. Tailscale Funnel로 바꾸고 나서야 이 문제가 해결됐다. 개인 무료 플랜으로도 PC이름.tailnet이름.ts.net 형태의 고정 주소를 받을 수 있고, 컴퓨터를 껐다 켜도 주소가 안 바뀌고, HTTPS도 자동으로 붙고, 무엇보다 근로자 역할 테스트 참여자 휴대폰에 별도 앱을 깔 필요가 없었다.
tailscale funnel 5173이 한 줄 말고도 두 군데를 더 고쳐야 했다. client/vite.config.ts의 server.allowedHosts에 터널 주소를 추가해야 Vite 개발 서버가 그 호스트로 오는 요청을 거부하지 않았고, server/.env.local의 CORS_ALLOWED_ORIGINS와 WORKER_PORTAL_BASE_URL도 같은 주소로 맞춰야 했다.
Terraform, 모니터링, 백업 리허설
이 시기 ai 이미지 용량 문제도 하나 있었다. 배포 노드에는 GPU가 없는데 PyPI 기본 torch는 CUDA 번들까지 통째로 끌고 와서 이미지가 7.5GB까지 불어나 있었다. torch.cuda.is_available()을 찍어보니 CUDA 휠을 쓰든 안 쓰든 이 노드에서는 항상 False였다 — 애초에 안 쓰는 수 GB짜리 짐을 매번 pull하고 있었던 거다.
# pyproject.toml
#
# 배포 노드는 GPU가 없는 CPU 전용 EC2 인스턴스이므로, torch는 PyPI 기본(CUDA 번들) 대신
# PyTorch 공식 CPU 전용 휠에서 받는다. cuda-toolkit/nvidia-cu*/triton 등 수 GB 크기의
# 미사용 CUDA 의존성이 빠져 이미지 크기가 크게 줄어든다. 동작은 동일 — 어차피 이 노드에는
# GPU가 없어 torch.cuda.is_available()은 CUDA 휠을 쓰든 안 쓰든 항상 False다.
[[tool.uv.index]]
name = "pytorch-cpu"
url = "https://download.pytorch.org/whl/cpu"
explicit = true

[tool.uv.sources]
torch = { index = "pytorch-cpu" }uv의 인덱스를 하나 더 등록해서 torch만 그 인덱스에서 받도록 지정했다. 이 한 줄로 uv.lock에서 nvidia-cu*, triton 같은 CUDA 관련 패키지 18개가 통째로 사라졌고, 동작은 완전히 동일했다. 원래 안 쓰던 걸 안 받게 된 것뿐이니 회귀 테스트도 따로 필요 없었다.
8월 14일 이후로는 Prometheus·Grafana·Loki로 모니터링 스택을 갖췄다(Loki 앞단은 처음엔 Promtail을 썼는데, 이유를 알 수 없는 실패가 반복돼 후속 버전인 Grafana Alloy로 교체했다). 8월 19일에는 그동안 AWS CLI·콘솔로 손수 만들어온 EC2·IAM·DLM·CloudWatch·SNS·Budgets 리소스를 terraform import로 코드화했다.
terraform import란?Terraform은 보통 코드를 먼저 쓰고 그걸로 리소스를 만드는 도구지만,
terraform import는 반대로 이미 콘솔·CLI로 만들어진 실제 리소스를 Terraform의 상태 파일(state)에만 등록시키는 명령이다. 코드(.tf 파일)는 리소스의 실제 설정과 최대한 똑같이 손으로 맞춰 써야 하고, 그 뒤terraform plan을 돌려서 "0 to add, 0 to destroy"가 나오는지로 코드가 실제 상태와 완전히 일치하는지 검증한다.
공식 문서: developer.hashicorp.com/terraform — import
# terraform/ec2.tf
resource "aws_instance" "fowoco_node" {
  ami                    = "ami-0195f90f654bc4d8e"
  instance_type          = "m7i-flex.large"
  subnet_id              = data.aws_subnet.main.id
  vpc_security_group_ids = [aws_security_group.fowoco.id]
  # ...

  lifecycle {
    # AMI가 이후에 deprecated/교체돼도 이미 떠서 운영 중인 인스턴스를
    # terraform apply가 재생성하려 들면 안 됨 — 이미지·userdata는 최초
    # 부팅 시점 값으로 고정, 실제 변경은 항상 in-place(k3s 자체 업그레이드 등).
    ignore_changes = [ami, user_data]
  }
}
전부 aws CLI로 손으로 만든 인스턴스를 terraform import로 그대로 끌어왔기 때문에, 잘못 쓰면 terraform apply 한 번에 지금 3.5주째 돌고 있는 운영 인스턴스가 통째로 재생성될 위험이 있었다. lifecycle { ignore_changes = [ami, user_data] }를 걸어서 AMI나 유저데이터가 나중에 바뀌어도 이 인스턴스를 건드리지 않도록 안전장치를 먼저 박아두고 나서야 terraform plan을 돌렸다. 결과는 "0 to add, 0 to destroy"였다.
백업 복구도 실제로 리허설했다. DLM 스냅샷으로 임시 볼륨을 만들어 별도 인스턴스에 마운트하고 실제 Postgres 데이터와 업로드 파일이 온전한지 확인하는 데 약 5분이 걸렸는데, 이 과정에서 리사이즈 이전 스냅샷은 예전 30GB 크기로 복원된다는 것도 알게 돼 런북에 남겨뒀다.
서버와 맞붙은 순간들
인프라가 주 업무였지만, 실제 서비스가 눈앞에서 500 에러를 뱉으면 저장소를 가리지 않고 들어가서 고쳤다. 그중 가장 기억에 남는 건 실사용 클릭 테스트 중 발견한 버그다. 대시보드에서 자연어로 "아르준 타파의 계약 갱신 준비해줘"라고 요청하면 AI가 PLAN/ANALYZE를 정상적으로 수행하고 후보까지 만들어내는데, 마지막 "선택한 업무 생성" 버튼을 누르면 항상 500 에러가 났다. 로그를 따라가 보니 org.springframework.jdbc.BadSqlGrammarException — pgjdbc가 java.time.Instant 타입을 SQL 타입으로 추론하지 못한다는 에러였다.
 // JdbcTaskCaseRegistrar.java
+import java.sql.Timestamp;
+
 INSERT INTO workflow_case (
     ...
 ) VALUES (?, ?, ?, ?, ?, ?, ?, ?)
 """,
     ...
     first.workflowCatalogVersion(),
     snapshot(orderedTasks),
     first.createdBy(),
-    first.createdAt(),
-    first.updatedAt()
+    Timestamp.from(first.createdAt()),
+    Timestamp.from(first.updatedAt())
);JdbcTaskCaseRegistrar.registerComposite()이라는 클래스가 workflow_case 테이블에 INSERT를 할 때 Instant를 그대로 넘기고 있었는데, 같은 패키지의 다른 클래스(JdbcAiCandidateDecisionRepository)에는 이미 Timestamp.from(instant)로 감싸는 헬퍼가 있었다. 딱 이 클래스 하나만 그 패턴을 놓치고 있었던 거다.
왜
Instant는 SQL 타입 추론이 안 될까?JDBC 4.2 표준(JSR 221)이
PreparedStatement.setObject()에서 자동 매핑을 보장하는 자바 타입 목록에는java.sql.Timestamp,java.time.LocalDateTime,java.time.OffsetDateTime등은 있지만java.time.Instant는 빠져 있다.Instant는 시간대 정보가 없는 순수 시점(UTC epoch 기준)이라 SQL의TIMESTAMP/TIMESTAMPTZ중 어느 쪽에 대응시켜야 하는지 드라이버가 스스로 결정할 수 없기 때문이다. pgjdbc는 이 경우 타입 추론을 포기하고PSQLException: Can't infer the SQL type을 던진다.
참고: PostgreSQL JDBC Driver 문서 — Java 8 Date and Time classes
jdbcTemplate.update(...)에 파라미터를 넘길 때, pgjdbc는 java.sql.Timestamp나 OffsetDateTime처럼 JDBC가 이미 아는 타입은 SQL 타입으로 바로 매핑할 수 있지만, java.time.Instant는 JDBC 4.2 표준에 없는 타입이라 "이걸 SQL의 뭘로 넣어야 할지" 추론 자체를 포기하고 예외를 던진다.
기존 코드의 관례를 그대로 따라 두 줄만 고쳤고, 이번 기회에 이 경로를 검증하는 통합 테스트를 새로 추가했다.
// JdbcTaskCaseRegistrarPostgreSqlIntegrationTest.java
@Test
void registersCompositeCandidateCaseWithInstantTimestampsOnPostgreSql16() throws SQLException {
    // H2가 아니라 실제 PostgreSQL 16 커넥션으로 붙여야 이 클래스의 버그가 재현된다 —
    // H2는 Instant를 훨씬 관대하게 받아준다.
    ...
    registrar.registerComposite(
        List.of(caseTask(companyId, actorId, workerId, caseId, 1), ...),
        LocalDate.of(2026, 8, 13)
    );

    StoredCase stored = jdbcTemplate.queryForObject(
        "SELECT created_at, updated_at, workflow_snapshot_json FROM workflow_case WHERE case_id = ? AND company_id = ?",
        (rs, i) -> new StoredCase(
            rs.getObject("created_at", OffsetDateTime.class).toInstant(),
            rs.getObject("updated_at", OffsetDateTime.class).toInstant(),
            rs.getString("workflow_snapshot_json")
        ),
        caseId, companyId
    );
    assertThat(stored.createdAt()).isEqualTo(CREATED_AT);
}
이 테스트를 @EnabledIfEnvironmentVariable(named = "POSTGRES_TEST_ENABLED", matches = "true")로 표시해둔 것도 이유가 있다. 회사 CI에서 기본적으로 도는 단위 테스트는 대부분 가볍고 빠른 H2를 쓰는데, H2는 이 버그를 재현하지 못한다 — Instant를 훨씬 관대하게 받아준다. 실제 pgjdbc의 타입 추론 실패는 진짜 PostgreSQL 16에 붙어야만 드러났다. PR 설명에도 솔직하게 적었다. "이 경로에 대한 테스트가 현재 전혀 없어서 이번에 놓친 것 같습니다." 완벽한 척하기보다 무엇을 놓쳤는지 밝히고 그 구멍을 메우는 게 더 낫다고 생각했다.
팀이 고른 AI 모델 — BERT와 LLM을 둘 다 쓴 이유
나는 인프라·프론트를 맡았지만, 데이터·AI 팀(이채은 님 중심)이 이 문제를 어떻게 풀었는지는 깃PR과 노션글에서 계속 지켜봤고 인프라 쪽(모델 서빙 리소스, GPU 없는 배포 노드)과도 맞물려 있어서 정리해둘 가치가 있다. 문제는 단순했다. HR 담당자의 자연어 요청 하나에서 최대 7개까지 겹칠 수 있는 업무 의도(Intent)를 분류해야 했다.
처음엔 두 모델을 각각 테스트했다. 한국어 특화 생성형 LLM인 A.X-4.0-Light(SKT, 7B)를 few-shot 프롬프팅으로 돌려보니 분류 정확도 0.7에 응답 1건당 7초(Colab T4 기준)가 걸렸다. 반대로 KLUE-RoBERTa-base(0.1B, 인코더 기반)는 파인튜닝 없이도 응답이 0.002초로 훨씬 빨랐지만 정확도는 0.5에 그쳤다. 각자 하드 레이블로 파인튜닝을 마치자 두 모델 다 정확도가 크게 뛰었다 — RoBERTa는 (순서 무관 기준) 0.95, A.X는 0.92. 그런데 RoBERTa는 CPU에서도 평균 0.12초, A.X는 GPU를 꼭 써야 하고 그래도 5.5초가 걸렸다.
여기서 팀이 발견한 진짜 문제는 속도가 아니라 신뢰도였다. RoBERTa는 임계값을 못 넘겨서 사실상 여러 후보 Intent와 confidence가 거의 동률인 채로 그냥 1등을 골랐을 뿐인데 우연히 정답을 맞히는 케이스가 섞여 있었다. 정확도 숫자는 좋아 보이는데 "왜 이 답이 맞았는지" 설명할 근거가 하나도 안 남는 것이다. 반대로 A.X는 답을 낼 때 근거(evidence)가 같이 남아서 사람이 검토할 단서가 있었다.
그래서 팀이 최종적으로 택한 건 Cascade(계단식) 구조다. 대부분의 요청은 빠르고 가벼운 KLUE-RoBERTa(메인, Full Fine-tuning)로 처리하고, 다음 세 조건 중 하나에 걸리는 요청만 A.X-4.0-Light(보조, QLoRA)로 넘긴다. (1) 활성 Intent가 3개 이상 겹치는 복합 요청이거나, (2) BERT가 계속 틀리는 걸로 확인된 특정 경계 단어("완료", "없음", "급여계좌", "접수", "서류", "배치·라인·지시" 등)가 문장에 들어있거나, (3) confidence margin이 0.76 미만인 경우다.
이 0.76이라는 숫자도 감으로 정한 게 아니라, 검증 데이터 268건을 margin 구간별로 쪼개서 실제 정확도를 확인하고 잡은 값이다.
| Confidence margin 구간 | 실제 정확도 |
|---|---|
| 0.70 ~ 0.76 | 81.8% |
| 0.76 ~ 0.85 | 94.6% |
| 0.85 ~ 1.0 | 97.6% |
0.76을 넘어가는 순간부터 정확도가 눈에 띄게 뛰어오르는 구간이 보였고, 그 경계를 그대로 라우팅 기준으로 삼았다. 이 구조로 최종 분류 정확도 93%를 냈다. 그리고 GPU를 못 쓰는 환경(우리 배포 노드가 정확히 이 경우였다 — CPU 전용 EC2였다는 건 앞서 얘기한 대로다)에서 A.X 호출이 실패하면, 라우팅 규칙에 걸리더라도 자동으로 RoBERTa 단독 결과로 전환해서 서비스가 멈추지 않도록 폴백 로직까지 넣었다. "느리고 비싼 모델을 아예 못 쓰게 되는 상황"까지 감안한 설계였다는 게, 인프라를 맡았던 입장에서 보면 특히 고마운 지점이었다.
데이터 쪽도 만만치 않았다. Intent 학습 데이터 1,340건(학습 1,072건/테스트 268건)을 팀이 직접 검수해서 만들었는데, 처음엔 seed 40건짜리 DRAFT 상태로 시작해서 독립 Smoke 평가 18건으로 먼저 검증하고, 학습·평가 데이터 사이에 겹치는 템플릿이 없는지(데이터 누수 방지)까지 확인한 뒤에야 확정했다. QLoRA를 적용하면서 Exact Match가 0.76에서 0.93으로, Macro-F1이 0.9587까지 올라간 게 최종 수치다. 문서 생성 방식에도 초반에 정해둔 원칙이 하나 있다. "LLM이 문서 전체를 생성하게 하지 말고, 검증된 데이터만 템플릿에 주입하는 방식이 제일 안전하다"는 조언이었다.
CAG(Context-Augmented Generation)란?
RAG(Retrieval-Augmented Generation)가 요청이 들어올 때마다 매번 관련 문서를 검색해서 컨텍스트로 붙이는 방식이라면, CAG는 이미 정해진 고정 기준(업무유형, 필수정보, 자주 나오는 모호 표현 같은 것들)을 미리 컨텍스트로 준비해두고 매번 검색 없이 그대로 활용하는 방식이다. FOWOCO의 업무 유형·필수정보·모호표현 판단 기준은 요청마다 달라지는 게 아니라 이미 8개 워크플로우로 고정돼 있었기 때문에, 매번 검색하는 RAG보다 고정 컨텍스트를 미리 넣어두는 CAG 쪽이 우리 문제에 더 맞는다고 판단했다. 그래서 HWP/HWPX 문서는 AI가 처음부터 끝까지 글을 쓰는 게 아니라, DB·OCR·HR 입력에서 나온 값들을 검증한 뒤 정해진 서식의 빈칸에 채워 넣는 방식으로 만들어진다. 같은 자리에서 Spring 서버가 AI 서버를 여러 번 호출하며 오케스트레이션하는 구조도 다시 확인했는데, 이 구조 덕분에 PLAN→ANALYZE→RESOLVE 같은 각 단계 사이마다 HR이 끼어들어 승인하거나 되돌릴 지점이 자연스럽게 생겼다. "AI가 알아서 다 하지 않는다"는 원칙이 아키텍처 단위로 강제돼 있었던 셈이다.
이 비동기 처리 뒤에는 Transactional Outbox라는 패턴이 깔려 있다. 서버 팀 문서에 나온 비유가 이해하기 좋아서 그대로 옮긴다 — Event는 "편지", Outbox 테이블은 "발송함", Worker는 "편지를 가지러 오는 집배원"이다. 이벤트는 상태(PENDING→PROCESSING→COMPLETED, 실패하면 RETRY_WAIT, 그래도 안 되면 사람이 봐야 하는 REVIEW_REQUIRED)를 가진 채 DB 테이블에 먼저 "발송함"에 넣어두고, Worker가 그걸 주기적으로 가지러 온다. 이렇게 하면 AI 호출이 실패해도 이벤트 자체가 유실되지 않고, 재시도 로직을 각 레이어(Outbox 재시도 / AiRun 재시도 / AI 런타임 프로바이더 재시도)마다 따로 예산을 두고 관리할 수 있다. 이 패턴을 실제로 넣다가 겪은 버그도 하나 있었다고 한다 — 재시도 시각을 비교할 때 DB의 CURRENT_TIMESTAMP와 자바 코드의 Clock이라는 서로 다른 시계 두 개를 섞어 써서, 테스트가 가끔씩만 실패하는 flaky한 상태가 됐다. 재시도 시각 비교를 자바 Clock 기준의 확실히 과거인 시점으로 고정해서 해결했다고 한다. "REVIEW_REQUIRED 상태는 DB에서 직접 PENDING으로 되돌리면 안 된다"는 규칙도 명시돼 있었는데, 사고가 난 우편물을 아무나 재발송 처리하면 안 되는 것과 같은 이유였다.
결과
발표 자료도 개발만큼이나 여러 번 갈아엎었다. 6주차 피드백에서는 "전문 용어 자제!!"라는 말을 두 번이나 강조로 들었고, 로그인·회원가입처럼 흔한 기능은 시연에서 빼고 부록으로 돌리라는 조언을 받았다. 7주차에는 6개 워크플로우 중 재계약·연장 하나만 보여주면 얇아 보이니 기능이 아니라 "무슨 AI 기술이 어떻게 FE·BE와 연결되는지" 구조로 설명하라는 피드백을 받았고, 숫자를 말할 때는 그 숫자를 어떻게 계산했는지까지 같이 보여주라는 "추정 원칙"도 이때 배웠다. 마지막 8주차 피드백에서는 오히려 심사위원들이 "지금은 가상이지만, 나중에 실제 정부 시스템(EPS·고용24 등)과 직접 연동한다면 더 설득력 있겠다"는 확장 방향을 제안해줬는데, 이게 향후계획 슬라이드에 그대로 들어갔다.
모니터링 스택(Prometheus)을 이미 만들어둔 김에 "AI Workflow 정량 측정"이라는 이름으로 인프라 관점에서 직접 벤치마크를 돌려봤다. 그냥 몇 번 눌러보고 "빠른 것 같다"로 끝내지 않고, 재현 가능한 측정으로 남기고 싶었다. 방법은 이랬다. "응웬반A 체류연장 준비해줘" 같은 정상 요청을 POST /api/v1/ai-runs로 10번 반복 호출하고, 각 요청이 PLAN(Intent 판별) → Slot 조회 → ANALYZE(Workflow 후보 생성) → 저장까지 거치는 전체 과정을 Prometheus로 단계별로 쪼개서 쟀다. 모델은 실제 Hugging Face BERT Intent 분류기를 그대로 썼고(A.X는 이번 측정에서는 비활성화), cold start 영향을 빼기 위해 모델을 미리 로딩해둔 뒤 측정했다.
10회 모두 성공(10/10)했고, 실제 호출별 수치는 이랬다.
| 실행 | 202 응답(ms) | 최종 확인(ms) |
|---|---|---|
| 1 | 60 | 143 |
| 2~10 평균 | ~39 | ~76 |
202 Accepted 응답까지는 평균 40.7ms(중앙값 40.0ms, p95 51.4ms), 클라이언트가 폴링(20ms 간격)으로 최종 결과를 확인하기까지는 평균 82.0ms(중앙값 77.5ms, p95 114.2ms)였다. Prometheus로 더 잘게 쪼갠 단계별 평균은 이랬다.
| 단계 | 평균 | 설명 |
|---|---|---|
| PLAN_RUNTIME_CALL | 22.35ms | 원문을 실제 BERT 모델로 분류 |
| PLAN RESULT_PERSIST | 1.43ms | PLAN 결정 저장 |
| SLOT_RESOLUTION | 2.11ms | 근로자·체류일·문서 상태를 서버 DB에서 보충 |
| ANALYZE_RUNTIME_CALL | 2.61ms | Workflow 후보 생성 |
| ANALYZE RESULT_PERSIST | 1.71ms | 후보·결과 저장 |
| 파이프라인 전체 | 33.67ms | p50 30.76ms · p95 58.72ms |
PLAN·ANALYZE 두 단계(모델 호출 구간)의 합이 전체 평균의 약 74%를 차지했다. 병목이 서버의 DB 처리가 아니라 모델 호출 자체에 있다는 걸 "느낌"이 아니라 숫자로 확인한 것이다. (앞서 설명한 Cascade 구조(빠른 모델을 기본으로, 느린 모델은 애매한 경우에만)가 실질적인 응답 속도에도 그대로 영향을 준다는 뜻이다.)
일부러 실패 케이스도 하나 넣어봤다. "존재하지않는근로자 체류연장 준비해줘"라고 보내니 예상대로 실패했는데, 그냥 500 에러로 뭉개지지 않고 fowoco_ai_pipeline_failures_total{phase="ANALYZE", stage="SLOT_RESOLUTION", failure_code="TARGET_NOT_FOUND"}라는 Prometheus 지표로 정확히 어느 단계, 어떤 이유로 실패했는지가 집계됐다. 이 측정에서 얻은 PromQL 몇 개는 이후에도 계속 재사용했다.
p95: histogram_quantile(0.95, sum by (le, phase, stage) (fowoco_ai_pipeline_stage_seconds_bucket{status="SUCCESS"}))
실패 집계: sum by (phase, stage, failure_code) (fowoco_ai_pipeline_failures_total)
이 측정 결과를 발표 자료에 정리하면서 한 가지는 꼭 구분해서 적어두려고 했다. “HR 업무시간을 몇 % 절감했다”라고 표현하면 안 된다는 것이다. 이번에 측정한 건 어디까지나 시스템 처리시간과 안정성이었고, 실제 HR 업무시간이 얼마나 줄었는지는 기존 수작업과 같은 조건으로 따로 측정해야 했다. 숫자가 좋게 나왔다고 해서 우리가 처음부터 측정하려던 지표까지 좋아졌다고 생각하면 안 된다고 봤다. 다만 기대 효과는 분명했다. 기존에 1~2시간 정도 걸리던 서류 업무를 시스템을 통해 약 1분 안에 처리하는 것을 목표로 했고, 이를 기준으로 업무 처리 시간을 최대 98% 단축할 수 있을 것으로 예상했다. 여기에 반복적인 서류 업무에서 발생할 수 있는 법적 리스크까지 고려해 연간 약 700만 원의 비용 절감 효과가 있을 것으로 추산했다.
온라인 수료식
 |
 |
오프라인 수료식
 |
 |
생각정리
8주 동안 FOWOCO를 만들면서 가장 많이 배운 건 새로운 기술을 사용하는 방법보다 무엇을 만들고, 어디까지 만들어야 하는지를 판단하는 방법이었다. 처음에는 좋은 서비스를 만들려면 최대한 많은 기능을 넣고, 기술적으로도 더 복잡하고 정교하게 만드는 것이 중요하다고 생각했다. 실제로 초반 설계에서는 지금 당장 필요하지 않은 부분까지 꽤 크게 설계했고, 만들다 보니 실제 구현에서는 하나씩 걷어내고 단순하게 다시 만드는 일이 반복됐다. 처음 그린 설계도가 그대로 구현되는 경우보다, 실제 문제와 마주하면서 계속 바뀌는 경우가 훨씬 많았다. 결국 중요한 건 처음부터 완벽한 설계를 만드는 것이 아니라 현재 문제에 정말 필요한 복잡도만 선택하는 것이라는 걸 배웠다.
특히 Frontend와 Infrastructure를 함께 맡으면서 "내 코드만 잘 작성하면 된다"는 생각도 많이 바뀌었다. 화면 하나를 만드는 일도 결국 API와 데이터 모델, 인증, 배포 환경까지 연결되어 있었고, 반대로 인프라에서 발생한 문제가 결국 사용자가 보는 화면의 장애로 이어지기도 했다. 실제로 개발 과정에서 화면과 서버의 데이터 모델이 맞지 않거나, CI는 성공하고 있는데 실제 배포는 되지 않고 있거나, 파드가 정상적으로 떠 있는 것처럼 보이지만 probe 설정 때문에 계속 재시작되는 문제들을 직접 겪었다. 이런 경험을 통해 서비스는 각각의 코드를 따로 만드는 것이 아니라 하나의 시스템으로 바라봐야 한다는 것을 체감했다.
또 하나 크게 느낀 것은 "동작한다"와 "사용할 수 있다"는 전혀 다르다는 것이다. 코드 리뷰에서는 발견하기 어려웠던 사이드바의 잘못된 메뉴, 실제 사용자와 연결되지 않은 프로필 데이터, 잘못된 데모 계정 같은 문제들은 직접 사용자의 입장에서 서비스를 눌러봤을 때 비로소 발견할 수 있었다. 결국 좋은 개발은 코드를 작성하는 데서 끝나는 것이 아니라, 실제 사용 흐름에서 무엇이 깨지는지를 확인하는 과정까지 포함한다는 걸 배웠다.
AI를 바라보는 관점도 조금 달라졌다. 처음에는 정확도 93% 같은 숫자가 모델의 성능을 설명하는 가장 중요한 지표라고 생각했지만, 프로젝트를 진행하면서 AI가 얼마나 자주 맞히는가보다 틀렸을 때 어떻게 실패하는가가 더 중요할 수 있다는 것을 배웠다. FOWOCO 역시 AI가 업무를 마음대로 확정하는 구조가 아니라, 후보를 제시하고 HR이 확인하도록 만들었다. 애매한 상황에서는 다시 질문하고, 실패하면 재시도하거나 사람이 확인할 수 있도록 설계했다. 결국 AI 서비스를 만든다는 것은 좋은 모델 하나를 붙이는 것이 아니라, AI의 불확실성을 포함한 전체 시스템을 설계하는 일에 가깝다는 생각이 들었다.
그리고 이번 프로젝트에서 개인적으로 가장 크게 남은 건 숫자를 말할 때 그 숫자를 어디까지 증명할 수 있는지 생각하게 된 것이다. 실제 측정을 통해 시스템의 처리시간과 안정성은 확인할 수 있었지만, 그것을 곧바로 "HR 업무시간 98% 절감"이라고 말할 수는 없었다. 우리가 측정한 것과 아직 측정하지 못한 것을 구분하고, 좋은 결과를 보여주는 것만큼 그 결과가 무엇을 의미하지 않는지도 설명할 수 있어야 한다는 것을 배웠다.
돌아보면 FOWOCO는 처음부터 완성된 서비스가 아니었다. 기획도 여러 번 바뀌었고, 설계도 계속 단순해졌고, 배포 과정에서는 예상하지 못한 장애를 수도 없이 만났으며, 발표 직전까지도 화면과 API를 맞춰가며 수정했다. 하지만 오히려 그 과정 덕분에 단순히 "React로 화면을 만들었다", "k3s로 서비스를 배포했다"는 것보다 훨씬 많은 것을 경험할 수 있었다. 이번 프로젝트를 끝으로 KT Aivle School의 긴 여정도 마무리됐다. 12주 동안 미니프로젝트부터 최종 프로젝트까지 여러 서비스를 만들면서 처음보다 확실히 달라진 점이 있다면, 이제는 새로운 기술을 봤을 때 "이걸 써보고 싶다"보다 "이 문제에 정말 필요한가?"를 먼저 생각하고, 방안을 찾고 행동으로 옮겨 서비스를 만든다는 것이다.
FOWOCO를 통해 배운 것들을 앞으로의 프로젝트에서도 계속 가져가고 싶다. 기술을 많이 아는 개발자보다, 문제를 정확하게 정의하고 필요한 기술을 선택하며, 실제 사용자가 끝까지 사용할 수 있는 서비스를 만드는 개발자가 되고 싶다. 8주 동안 같이 고민하고, 만들고, 부수고, 다시 만들었던 우리 14조의 FOWOCO도 이렇게 마무리한다.
프로젝트가 궁금한다면?
👻 Github