오늘은 PyTorch를 공부하면서 Tensor indexing → Autograd → nn.Module → 모델 구성 → Torchviz → Parameter → Activation Function까지 이어서 정리했다.
단순히 API 사용법을 외우기보다는,
PyTorch가 내부에서 어떤 방식으로 Tensor와 계산 그래프를 관리하는가?
를 중심으로 이해해보자.
1. NumPy와 PyTorch Tensor의 차이
📌 NumPy는 CPU, Tensor는 GPU?
큰 흐름에서는 맞지만 정확하게는 조금 다르다.
NumPy ndarray- 주로 CPU 기반 수치 연산
- 데이터 과학, 행렬 계산 등에 널리 사용
PyTorch Tensor- CPU에서도 사용 가능
- GPU(CUDA) 연산 가능
- Autograd를 통한 자동 미분 지원
- 딥러닝에 필요한 연산과 결합되어 있음
즉 Tensor는 단순히 GPU용 NumPy가 아니다.
💡 PyTorch Tensor는 NumPy와 비슷한 수치 연산 기능에 GPU 연산과 자동 미분 기능을 추가한 구조라고 이해하면 편하다.
딥러닝 파이프라인 안에서는 굳이 NumPy로 갔다가 다시 Tensor로 돌아오기보다 Tensor를 계속 유지하는 경우가 많다.
2. @와 torch.matmul()
PyTorch에서
A @ B와
torch.matmul(A, B)는 기본적으로 같은 행렬곱을 의미한다.
즉 @는 torch.matmul()의 연산자 표현이라고 생각하면 된다.
3. Tensor Indexing
a = torch.tensor([
    [1, 2, 3],
    [4, 5, 6]
])
shape은 (2, 3)이다.
axis 0 → 행 방향
axis 1 → 열 방향
📌 A[0][1]과 A[0, 1]
A[0][1]은:
temp = A[0]
result = temp[1]
처럼 한 번 가져온 뒤 다시 indexing하는 방식이다.
반면:
A[0, 1]은:
axis 0 → index 0
axis 1 → index 1
을 한 번에 지정한다.
💡
A[0][1]= 가져오고 다시 indexing
💡A[0,1]= 각 axis의 index를 한 번에 지정
4. 쉼표 ,가 중요하다
a[index0, index1, index2]는:
index0 → axis 0
index1 → axis 1
index2 → axis 2
를 의미한다.
예를 들어:
a[
    torch.tensor([0]),
    torch.tensor([1])
]
은 (0,1) 좌표를 가져오므로:
tensor([2])가 된다.
5. Tensor 하나만 index로 넣으면?
idx = torch.tensor([
    [0,1],
    [1,1]
])

a[idx]
여기서 idx가 2차원이라고 해서:
첫 번째 차원 → axis 0
두 번째 차원 → axis 1
이 되는 것은 아니다.
a[idx]에서 index가 하나이므로 idx 전체가 axis 0을 indexing한다.
0 → [1,2,3]
1 → [4,5,6]

1 → [4,5,6]
1 → [4,5,6]
결과:
tensor([
    [[1,2,3],
     [4,5,6]],

    [[4,5,6],
     [4,5,6]]
])
🚨 Index Tensor의 차원 수가 어느 axis를 접근할지 결정하는 것이 아니다.
핵심:
a[idx]
→ axis 0 하나를 indexing

a[idx1, idx2]
→ axis 0과 axis 1을 indexing
6. 여러 Tensor Index를 넣으면 좌표가 된다
a[
    torch.tensor([0,1]),
    torch.tensor([1,2])
]
은 같은 위치끼리 묶어서:
(0,1) → 2
(1,2) → 6
을 가져온다.
결과:
tensor([2,6])7. ... Ellipsis
g = torch.randn(2,3,4,5,6)에서:
g[1,2,...]는 사실상:
g[1,2,:,:,:]와 같다.
즉:
axis 0 → index 1
axis 1 → index 2
axis 2 → 전부
axis 3 → 전부
axis 4 → 전부
이므로 결과 shape은:
torch.Size([4,5,6])이다.
💡
...= 나머지 모든 axis를 그대로 가져와라.
8. Autograd와 requires_grad
x = torch.tensor([1.], requires_grad=True)

y = x ** 2

y.backward()

print(x.grad)
결과:
tensor([2.])수식은:
이므로:
현재 x=1이므로:
이다.
requires_grad=True는:
이 Tensor가 참여하는 연산을 Autograd가 추적하도록 하겠다.
라는 의미다.
9. Leaf Tensor
Leaf Tensor는 단순히 입력 Tensor를 뜻하는 것이 아니다.
정확히는:
Autograd가 추적하는 다른 연산의 결과로 만들어진 것이 아니라 직접 생성된 Tensor
이다.
예:
z = torch.tensor([1.], requires_grad=True)

x = z * 2
y = x ** 2
z → leaf
↓
×2
↓
x → non-leaf
↓
square
↓
y → non-leaf따라서:
z.is_leaf   # True
x.is_leaf   # False
이다.
10. Gradient는 어디에 저장되는가?
Backward 과정에서 중간 Tensor의 gradient도 계산된다.
하지만 기본적으로 .grad에 저장되는 것은 leaf Tensor다.
z = torch.tensor([1.], requires_grad=True)

x = z * 2
y = x ** 2

y.backward()
이 경우:
z.grad에는 값이 저장되지만:
x.grad는 기본적으로 None이다.
중간 Tensor의 gradient도 보고 싶다면:
x.retain_grad()를 사용한다.
11. Forward에서 무엇을 저장하는가?
Forward 과정에서 미분값을 미리 저장하는 것이 아니다.
Backward에 필요한:
activation
입력값
출력값
중간값
연산 정보
등을 저장한다.
예를 들어:
에서:
를 계산하려면 forward에서 사용했던 x가 필요하다.
따라서 흐름은:
Forward
↓
Activation / 중간값 저장

Backward
↓
저장된 값을 이용해 local gradient 계산
↓
Chain Rule
↓
이전 layer로 gradient 전달
이다.
12. Gradient는 누적된다
PyTorch의 .grad는 기본적으로 누적된다.
그래서 학습에서는:
optimizer.zero_grad()를 사용해 이전 gradient를 초기화한다.
13. Transfer Learning
Transfer Learning은:
이미 다른 데이터로 학습된 모델의 지식을 새로운 문제에 재사용하는 방법론
이다.
장점:
학습 시간 감소
데이터 요구량 감소
초기 성능 향상
이미 학습한 feature 재사용
Transfer Learning 안에는 크게:
Transfer Learning
│
├─ Feature Extraction
│   └─ Backbone Freeze
│      Classifier만 학습
│
└─ Fine-Tuning
    └─ Backbone 일부 또는 전체까지 재학습
이 있다.
즉:
Transfer Learning = 더 큰 개념
Fine-tuning = Transfer Learning의 한 방식
이다.
14. nn.Module
PyTorch에서 모델은 보통:
class CustomModel(nn.Module):
    def __init__(self):
        super().__init__()

    def forward(self, x):
        ...
형태로 만든다.
📌 __init__()
모델이 사용할 layer를 정의한다.
self.fc1 = nn.Linear(10,20)
self.fc2 = nn.Linear(20,1)
📌 super().__init__()
부모 클래스인 nn.Module의 __init__()을 호출한다.
이를 통해 PyTorch가:
Parameter 관리
Submodule 관리
state_dict
.to("cuda")
.train()
.eval()
등을 위한 내부 상태를 준비한다.
부모 method를 사용할 수 있게 되는 것은 상속 자체이고,
super().__init__()은 부모 클래스의 초기 상태를 설정하는 것이다.
15. nn.Sequential
fc1 = nn.Linear(1,3)
fc2 = nn.Linear(3,1)
에서:
model = fc2(fc1(x))는 모델이 아니라 이미 계산된 Tensor 결과다.
하나의 모델로 만들려면:
model = nn.Sequential(
    fc1,
    fc2
)
로 만든다.
그러면:
model(x)는 내부적으로:
fc2(fc1(x))를 수행한다.
16. list is not a Module subclass
잘못된 예:
nn.Sequential([
    nn.Linear(10,20),
    nn.ReLU()
])nn.Sequential은 nn.Module들을 기대하지만 Python list 하나가 들어갔기 때문에 에러가 난다.
올바른 방식:
nn.Sequential(
    nn.Linear(10,20),
    nn.ReLU()
)
또는:
layers = [
    nn.Linear(10,20),
    nn.ReLU()
]

nn.Sequential(*layers)
17. Layer 자체와 실행 결과
self.linear1은 Layer 자체다.
반면:
self.linear1(x)은 x를 해당 Layer에 넣어 실제 연산한 결과다.
따라서 forward()에서는:
def forward(self, x):
    x = self.linear1(x)
    x = self.linear2(x)
    return x
처럼 사용해야 한다.
18. 클래스와 객체
model = CustomModel은 클래스 자체다.
실제 모델 객체를 만들려면:
model = CustomModel()이어야 한다.
CustomModel
→ 설계도

CustomModel()
→ 실제 생성된 모델 객체
19. 학습 가능한 Parameter 수
모델 구조:
Linear(1,3)
Sigmoid
Linear(3,4)
Sigmoid

Linear(4,4)
Sigmoid
Linear(4,1)
Sigmoid
Linear(in, out)의 parameter는:
이다.
| Layer | Weight | Bias | Parameter |
|---|---|---|---|
| Linear(1,3) | 3 | 3 | 6 |
| Linear(3,4) | 12 | 4 | 16 |
| Linear(4,4) | 16 | 4 | 20 |
| Linear(4,1) | 4 | 1 | 5 |
총:
개다.
PyTorch에서:
sum(
    p.numel()
    for p in model.parameters()
    if p.requires_grad
)
로 확인할 수 있다.
20. Bias도 학습되는가?
그렇다.
nn.Linear(1,3)은 기본적으로:
nn.Linear(1,3,bias=True)이다.
따라서 weight, bias 모두 학습 대상이다.
반면 Sigmoid에는 학습 가능한 parameter가 없다.
21. Torchviz
torchviz는:
PyTorch의 Autograd 계산 그래프를 시각화하는 라이브러리
이다.
예:
x = torch.tensor([4.], requires_grad=True)

y = x ** 2
z = y + 1
f = z * 4
g = f ** 2 + zmake_dot(g)를 실행하면 g가 어떤 연산으로 만들어졌는지 계산 그래프로 볼 수 있다.
< 예시 이미지 >
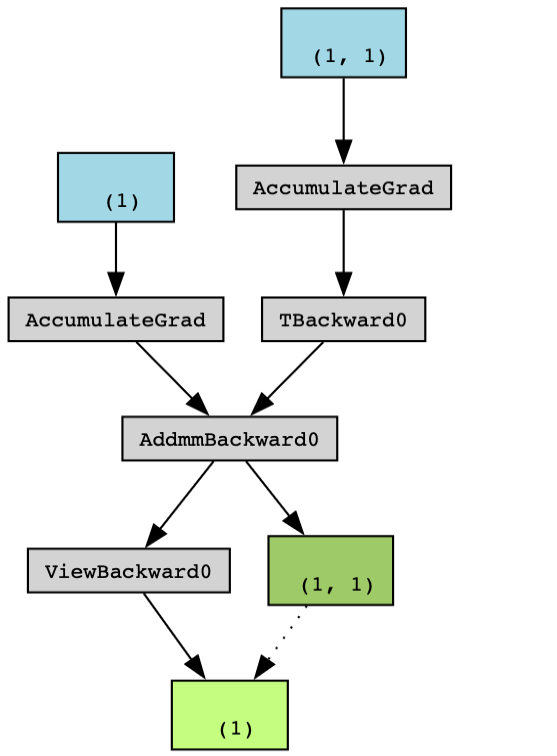
22. make_dot()
make_dot()에는 시각화하고 싶은 최종 Tensor를 넣는다.
make_dot(g)는 g에서 역으로 따라가면서 Autograd graph를 보여준다.
중간 Tensor를 넣으면:
make_dot(z)z까지의 계산 그래프만 보여준다.
📌 왜 make_dot(model)은 안 되는가?
model은 nn.Module 객체일 뿐, 실제 계산 결과 Tensor가 아니다.
먼저:
result = model(x)로 forward를 수행한 다음:
make_dot(result)을 사용해야 한다.
Parameter 이름까지 보고 싶다면:
make_dot(
    result,
    params=dict(model.named_parameters())
)
처럼 사용할 수 있다.
23. Graphviz dot 에러
다음 에러:
ExecutableNotFound:
failed to execute PosixPath('dot')
는 PyTorch 문제가 아니라 시스템에 Graphviz의 dot 실행파일이 없어서 발생한 것이다.
Mac에서는:
brew install graphviz설치 후:
dot -V로 확인할 수 있다.
pip install graphviz= Python 패키지
brew install graphviz= 실제 Graphviz 실행 프로그램
24. Torchviz에서 AccumulateGrad
다음 연산:
x = torch.tensor([4.], requires_grad=True)

y = x ** 2
z = y + 1
f = z * 4
g = f ** 2 + z
구조:
x
↓
y = x²
↓
z = y + 1
├────────────────┐
↓                │
f = z × 4        │
↓                │
f²               │
↓                │
└────── + ←──────┘
        ↓
gz에서 두 경로로 분기된다.
Backward에서는 두 경로의 gradient가 합쳐진다.
현재:
첫 번째 경로:
따라서:
두 번째 경로에서는:
따라서:
이다.
📌 왜 z에 AccumulateGrad가 없는가?
AccumulateGrad는 분기된 gradient를 합치는 노드가 아니다.
AccumulateGrad는:
Leaf Tensor의
.grad에 최종 gradient를 누적해서 저장하는 역할
이다.
z는 연산 결과로 만들어진 non-leaf Tensor이므로 기본적으로 z.grad를 저장하지 않는다.
반면 x는 leaf Tensor이므로 x.grad에 최종 gradient를 저장한다.
최종적으로:
이고:
이므로:
따라서:
그래서:
g.backward()
print(x.grad)
결과는:
tensor([4360.])이다.
25. Sigmoid는 Element-wise Activation
Sigmoid는 각 element에 독립적으로 적용된다.
라면:
처럼 계산한다.
ReLU, GELU, SiLU 등의 일반적인 activation도 대부분 element-wise 방식이다.
26. 다른 Element 관계를 고려하는 Activation
전통적인 activation은:
처럼 현재 element만 본다.
하지만 현대 연구에서는:
다른 channel
주변 spatial feature
global context
등을 이용해 activation을 동적으로 결정하는 방법들도 연구되고 있다.
개념적으로:
처럼 볼 수 있다.
현재 feature
   +
주변 feature / 다른 channel 정보
   ↓
activation 결정
다만 이런 방식은 아직 ReLU나 GELU처럼 기본값으로 널리 쓰이는 것은 아니고, dynamic activation / gating / channel interaction / attention 등의 형태로 연구되고 있다.
27. 오늘 배운 PyTorch 전체 흐름
Tensor
↓
Indexing / Shape 이해
↓
nn.Module로 모델 정의
↓
Forward
↓
Tensor 연산 수행
↓
Autograd Graph 생성
↓
중간 Activation 저장
↓
Loss
↓
Backward
↓
Chain Rule
↓
Gradient 계산
↓
Leaf Tensor / Parameter의 .grad에 저장
↓
Optimizer
↓
Parameter Update
Torchviz는 이 과정 중:
Forward
↓
Autograd Graph
를 눈으로 확인할 수 있게 해주는 도구다.
28. 오늘 반드시 기억할 핵심
💡 Tensor indexing에서 axis를 결정하는 것은 Index Tensor의 차원이 아니라
a[idx1, idx2, ...]에서 쉼표로 구분된 index의 위치다.
💡
requires_grad=True는 연산 그래프를 추적하게 만들고,backward()는 그래프를 역으로 따라가며 gradient를 계산한다.
💡 Forward에서는 미분값을 저장하는 것이 아니라 backward에 필요한 activation과 중간값을 저장한다.
💡 중간 Tensor의 gradient도 backward 과정에서 계산되지만 기본적으로
.grad에는 leaf Tensor의 gradient만 저장된다.
💡
nn.Module은 모델의 구조를 관리하고,forward()는 실제 Tensor가 어떤 연산을 거칠지를 정의한다.
💡
super().__init__()은 부모인nn.Module이 필요한 내부 상태를 초기화한다.
💡
model과model(x)는 다르다. 전자는 Module이고 후자는 실제 forward 연산 결과 Tensor다.
💡
make_dot()은 모델 자체가 아니라 실제 연산 결과 Tensor를 받아 Autograd Graph를 시각화한다.
💡
AccumulateGrad는 분기된 gradient를 합치는 노드가 아니라 leaf Tensor의.grad에 gradient를 누적하는 역할이다.
💡 Linear에서는 weight뿐 아니라 bias도 기본적으로 학습 가능한 parameter다.
💡 전통적인 activation은 element-wise지만, feature/channel/context 간 관계를 고려하는 activation이나 gating 방식도 연구되고 있다.
마무리
오늘은 단순히 PyTorch API를 사용하는 법보다 PyTorch 내부에서 Tensor → Forward → Computational Graph → Backward → Gradient가 어떻게 연결되는지를 깊게 다뤘다.
핵심 흐름은 다음과 같다.
Tensor가 들어온다
→ Module이 Tensor를 연산한다
→ 연산 그래프가 만들어진다
→ Forward 중 필요한 값이 저장된다
→ Backward가 그래프를 역으로 탄다
→ Chain Rule로 Gradient가 계산된다
→ Parameter의 .grad에 저장된다
→ Optimizer가 Parameter를 업데이트한다
이 흐름이 잡히면 이후에 배우게 될 Loss Function, Optimizer, CNN, Transformer, Fine-Tuning, Gradient Checkpointing도 하나의 학습 시스템 안에서 연결해서 이해할 수 있다.