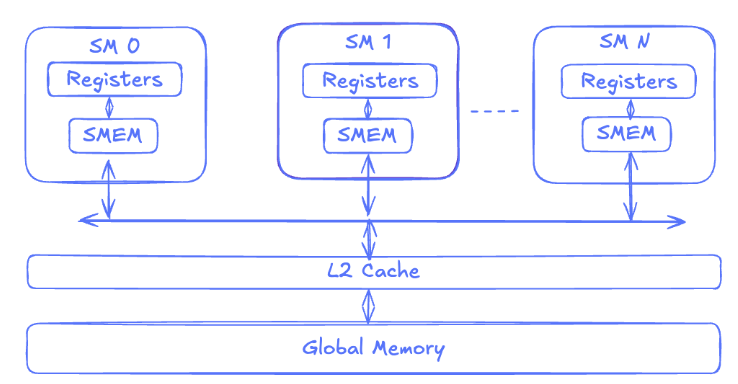
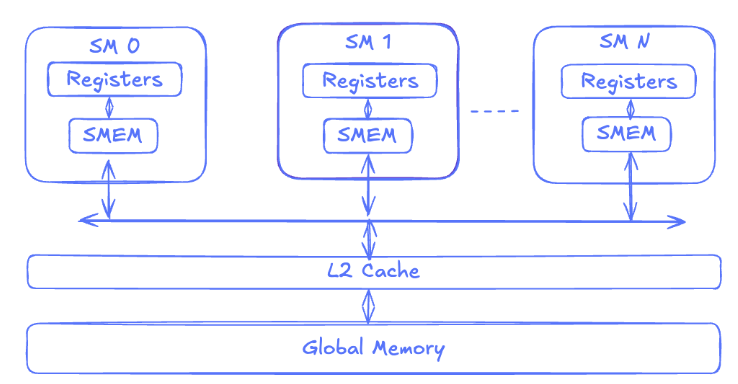
GPU architecture
CUDA
GPU를 그래픽 처리기뿐만 아니라 범용 연산 장치로 쓸 수 있도록, NVIDIA가 만든 프로그래밍 환경
구성요소
언어 확장: C/C++/Fortran 확장
라이브러리: cuBLAS(행렬연산), cuDNN(딥러닝), cuFFT(푸리에 변환)
툴킷: NVCC컴파일러, 디버거, 프로파일러
드라이버: GPU 하드웨어 제어
딥러닝에서 CUDA가 필요한 이유
딥러닝 모델은 매트릭스 곱셈, 합성곱(Convolution), 벡터 연산 같은 대규모 수학 계산을 반복합니다.
이 연산들은 병렬화가 가능해서, GPU의 수천 개 코어로 동시에 처리하면 CPU보다 훨씬 빠르게 실행됩니다.
예: 1만 장의 이미지를 학습 → CPU는 순차적으로 처리, GPU는 CUDA를 이용해 동시에 병렬 연산
CUDA 병렬 연산
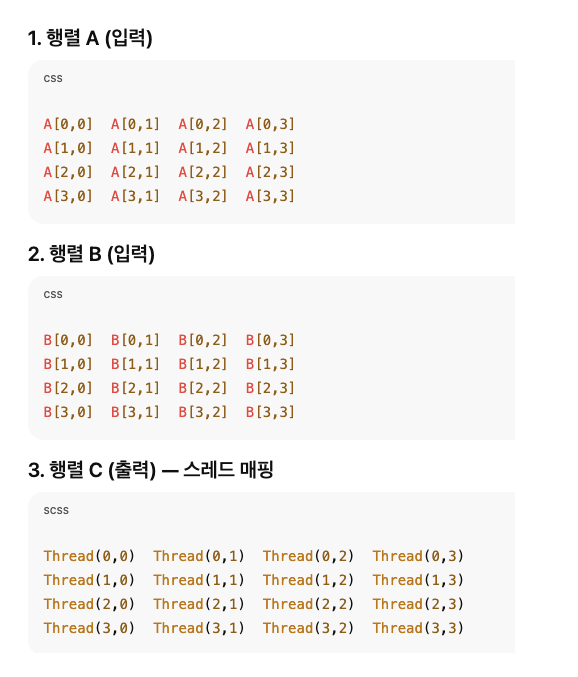
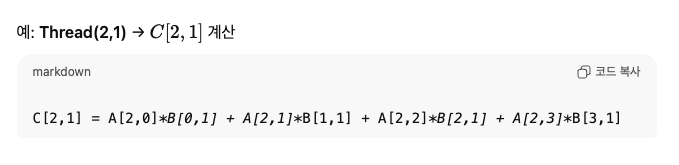
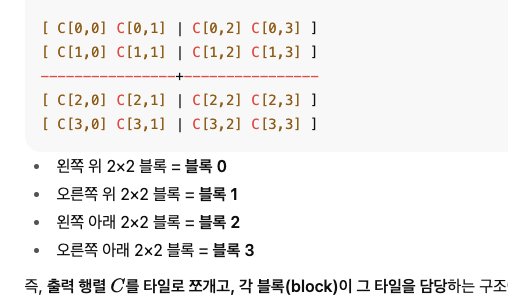
행렬 곱셈(A x B = C) 커널
행렬과 행렬을 곱해 행렬을 만드는 코드
__global__ void matMulKernel(float A, float B, float* C, int M, int K, int N) {
// 1. 현재 스레드가 담당할 결과 행렬 C의 위치(row, col)를 정합니다.
int row = blockIdx.y * blockDim.y + threadIdx.y; // C의 행 번호 (0 ~ M-1)
int col = blockIdx.x * blockDim.x + threadIdx.x; // C의 열 번호 (0 ~ N-1)

// 2. 결과 행렬 C의 범위 안인지 확인합니다.
if (row < M && col < N) {
    float sum = 0.0f;

    // 3. 루프를 돌며 A의 한 행과 B의 한 열을 내적(Dot Product)합니다.
    for (int k = 0; k < K; k++) {

        // ★ 여기서 각 행렬의 offset(번지수)을 계산합니다! ★

        // A의 주소: row번째 행의 k번째 열
        int offset_A = row * K + k;

        // B의 주소: k번째 행의 col번째 열
        int offset_B = k * N + col;

        // VRAM에서 데이터를 가져와 곱한 뒤 누적합니다.
        sum += A[offset_A] * B[offset_B];
    }

    // 4. 최종적으로 계산된 한 점(sum)을 C의 자기 자리에 저장합니다.
    int offset_C = row * N + col;
    C[offset_C] = sum;
}
}
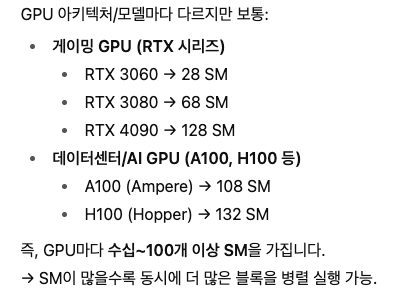
GPU에서 SM(Streaming Multiprocessor)의 개수
ai_tech_blog