vLLM의 PagedAttention 아키텍처와 GPU 메모리 최적화 원리
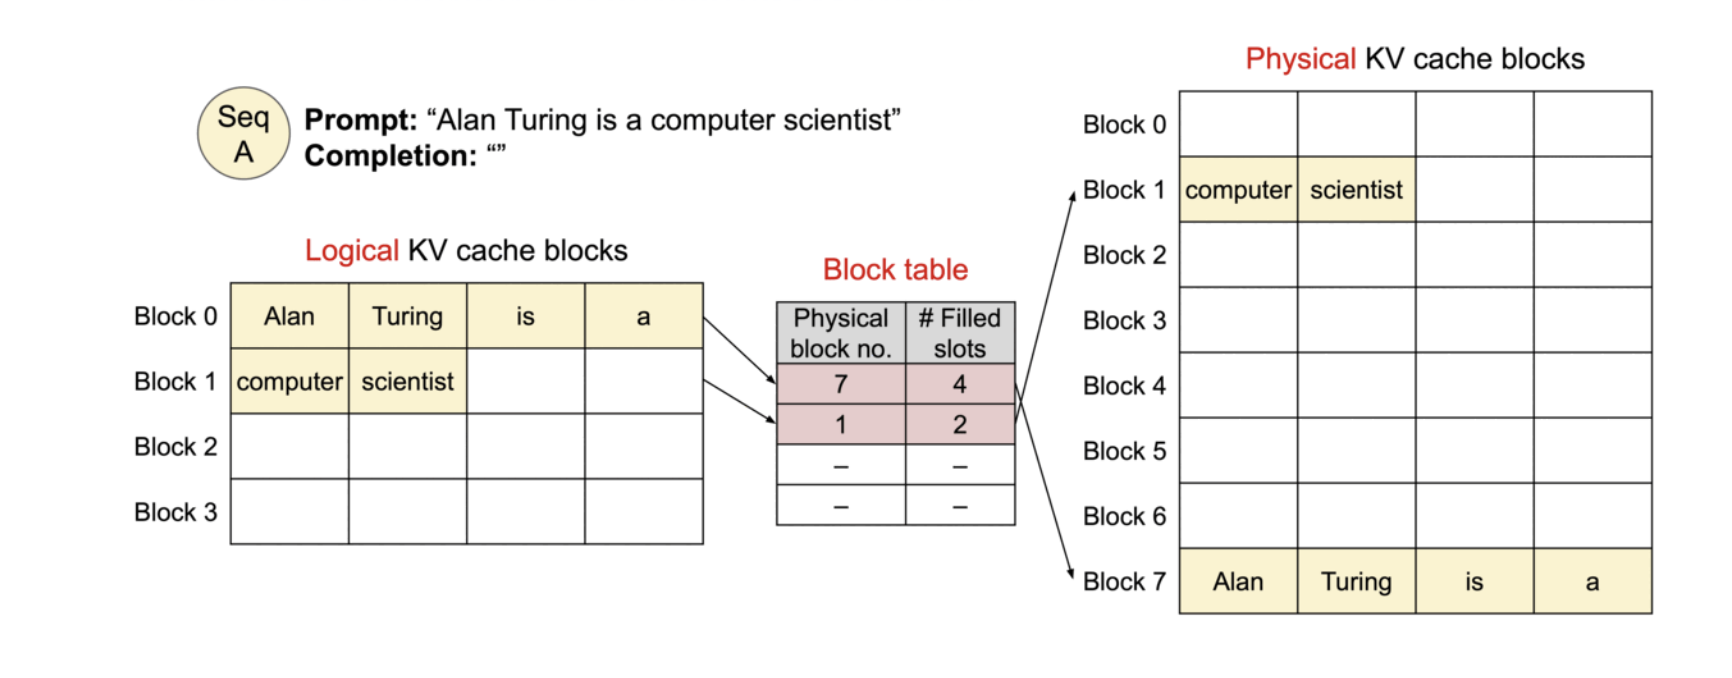
LLM(Large Language Model)의 추론(Inference) 효율성은 대규모 서비스 운영의 핵심입니다. 특히 KV 캐시(Key-Value Cache) 관리의 비효율성은 GPU 메모리 부족과 처리량(Throughput) 저하의 주된 원인이 됩니다. vLLM은 운영체제의 가상 메모리 기법을 차용한 PagedAttention을 통해 이 문제를 해결했습니다.
1. KV 캐싱과 증분 디코딩(Incremental Decoding)
트랜스포머 디코더 모델의 추론 과정은 이전에 생성된 토큰들을 기반으로 다음 토큰을 하나씩 예측하는 자기회귀(Auto-regressive) 방식을 따릅니다.
- 연산의 효율성: 새로운 토큰이 입력될 때마다 전체 문장에 대한 를 재계산하지 않습니다. 새로 들어온 토큰에 대해서만 벡터를 투영(Projection)하고, 이전 토큰들의 값은 메모리에 저장된 값을 재사용합니다.
- 문제점: 기존 프레임워크는 문장의 최대 길이(Max Sequence Length)에 맞춰 메모리를 미리 정적 할당(Static Allocation)합니다. 이는 실제 사용되지 않는 메모리 공간을 점유하여 내부 파편화(Internal Fragmentation)를 유발하고, 동시 처리 가능한 배치 크기를 제한합니다.
2. PagedAttention: 동적 메모리 할당의 구현
vLLM의 핵심인 PagedAttention은 고정된 크기의 블록(Block) 단위로 KV 캐시를 관리합니다.
- 블록 단위 관리: KV 캐시를 연속된 공간이 아닌, 일정한 토큰 개수(Block Size, 예: 16)를 담는 블록들로 쪼갭니다.
- 블록 테이블(Block Table): 논리적인 토큰 순서와 물리적인 GPU 메모리 주소를 매핑하는 페이지 테이블 역할을 합니다. 데이터가 물리적으로 흩어져 있어도 모델은 지도를 참조하여 논리적으로 연속된 데이터처럼 읽어 들일 수 있습니다.
3. GPU 하드웨어 가속과 커널 최적화
- VRAM(Global Memory): 모든 KV 블록이 저장되는 메인 저장소입니다.
- Shared Memory (On-chip): 연산 장치인 SM(Streaming Multiprocessor) 내부에 위치한 초고속 메모리입니다. vLLM 커널은 페이지 테이블을 참조해 필요한 블록을 VRAM에서 Shared Memory로 가져옵니다.
- Tiling & Parallelism: 각 SM은 서로 다른 블록들을 병렬로 맡아 처리합니다. 쉐어드 메모리에 로드된 벡터들과 현재 쿼리()의 내적(Dot Product) 연산이 Registers에서 수행되며, 이는 높은 하드웨어 점유율(Occupancy)을 유지하며 처리됩니다.
4. KV 캐시의 물리적 구조: 4차원 텐서 레이아웃
vLLM은 물리적 메모리를 다음과 같은 4차원 텐서( Tensor) 구조로 선언하여 관리합니다.
- Block (): 할당된 총 블록의 개수입니다.
- Head (): 멀티 헤드 어텐션의 헤드 수입니다. 각 헤드는 독립적인 파라미터를 가지므로 별도 저장됩니다.
- Block_Size (): 한 블록에 포함된 토큰의 개수입니다. 연산의 규칙성을 보장합니다.
- Head_D (): 각 헤드별 임베딩 차원의 크기입니다.
이러한 레이아웃은 GPU 가속기가 메모리 스라이드(Stride)를 통해 데이터를 읽어올 때 최적의 성능을 낼 수 있도록 설계된 결과입니다.
5. 결론: vLLM이 서빙 효율에 미치는 영향
vLLM은 PagedAttention을 통해 메모리 낭비를 거의 0%에 가깝게 줄였습니다.
- 연속 배치(Continuous Batching): 요청의 종료 시점이 달라도 빈 블록을 즉시 새로운 요청에 할당할 수 있어 처리량이 비약적으로 상승합니다.
- 복합 요청 처리: 영수증 OCR과 같이 비전 토큰이 대량으로 발생하는 경우에도, 효율적인 블록 관리를 통해 대규모 동시 요청을 안정적으로 소화합니다.
ai_tech_blog