안녕하세요, 미니지식공간입니다.
Muse Spark 1.2 가격표를 먼저 보면 이번 발표의 성격이 드러난다. 메타가 2026년 8월 5일 공개한 터미널 코딩 에이전트 Muse Code와 그 구동 모델 Muse Spark 1.2는, 성능 그래프보다 요금 티어와 런타임 설계에서 더 할 말이 많은 릴리스다. 이 글은 개발자 관점에서 런타임 구조 → 요금·리밋 → 평가 방법론 순으로 뜯어본다.
결론부터
- Muse Code는 append-only 로컬 이벤트 로그 위에서 도는 터미널 에이전트다. 메타는 이를 "replay-exact, restart-safe"라고 설명하며, 크래시 후 정확히 멈춘 지점부터 재개된다고 밝혔다(2026-08-05 공식 블로그).
- Muse Spark 1.2는 harness(에이전트 실행 껍데기)인 Muse Code와 함께 학습(co-training)됐다. 모델과 harness를 분리 가능한 제품으로 보지 않는 최근 흐름을 그대로 따른다.
- 요금은 표준 $1.25/$4.25(입력/출력, 1M 토큰당)와 컨트리뷰터 $0.10/$0.20 두 갈래다. 후자는 프롬프트·응답의 학습 사용 허용이 조건이고 60 RPM으로 제한된다.
1. 런타임 설계 — 이벤트 로그가 먼저다
Muse Code의 구조에서 먼저 볼 것은 성능이 아니라 상태 관리다. 메타 공식 블로그에 따르면 모델 호출, 툴 실행, 승인, 편집이 전부 로컬 이벤트 로그에 append된다. 이 로그가 단일 진실 공급원(single source of truth) 역할을 해서 런타임이 replay-exact하고 restart-safe해진다. 장시간 도는 작업이 중간 실패로 통째로 날아가는 문제를 로그 재생으로 푸는 방식이다.
여기에 붙는 것이 async background agents다. 하위 작업마다 서브에이전트를 생성·소멸시키는 대신, 특화된 백그라운드 에이전트가 세션 전체 동안 살아 있는다. 이들이 다음 단계를 수행하고 메인 에이전트에 보고할 시점을 스스로 고른다. 메타는 이 영속성이 중복 정보 수집을 줄여 레이턴시와 조종(steering) 필요를 낮춘다고 설명한다. 다만 이는 설계 의도에 대한 자사 설명이며, 독립 측정치는 아직 공개되지 않았다.
작업 규모가 커지면 격리된 git worktree에서 도는 병렬 서브에이전트로 팬아웃되고, 작업 사본(working copy)은 건드리지 않는다. 저커버그는 2026년 8월 5일 X 게시글에서 테스트 중 게임 기능 6개를 충돌 없이 동시에 만들었다고 밝혔다. 이 시연 결과 역시 메타 측 주장이다.
2. 설치와 번들 스킬 — 공식 문서 기준 스니펫
설치는 공식 블로그에 명시된 한 줄이다. macOS와 Linux를 지원한다.
# 출처: https://research.meta.ai/blog/introducing-muse-code-and-muse-spark-1-2 (2026-08-05)
curl -fsSL https://dev.meta.ai/install.sh | bash
기본 제공 스킬은 세 개이며, 각각의 역할도 공식 블로그에 정의되어 있다.
# 출처: 위와 동일 (Bundled Skills 섹션)
/plan    작업을 승인 게이트가 붙은 계획으로 변환
/grill   그 계획이 버틸 때까지 스트레스 테스트
/goal    지정한 목표의 달성까지 작업을 수행
Meta Model API의 요청 예제 코드는 developer.meta.com의 모델·제품 페이지가 본문을 서버 렌더링으로 내려주지 않아 2026-08-06 현재 원문 형태로 인용하기 어렵다. 문서에 없는 코드를 지어내는 대신, 확정된 파라미터만 정리하면 다음과 같다.
# Muse Spark 1.2 — 공개 확인된 사양 (2026-08-06 기준)
model            muse-spark-1.2
context_window   1,000,000 tokens        # developer.meta.com 모델 페이지
access           Muse Code / Meta Model API (public preview, 글로벌 접근 확대)
weights          공개 언급 없음 → 호스팅 의존 (self-host 불가)
platforms        macOS, Linux            # Windows 네이티브는 확인 필요
distribution     Meta Model API, OpenRouter
3. 요금과 레이트 리밋 — 계산이 갈리는 지점
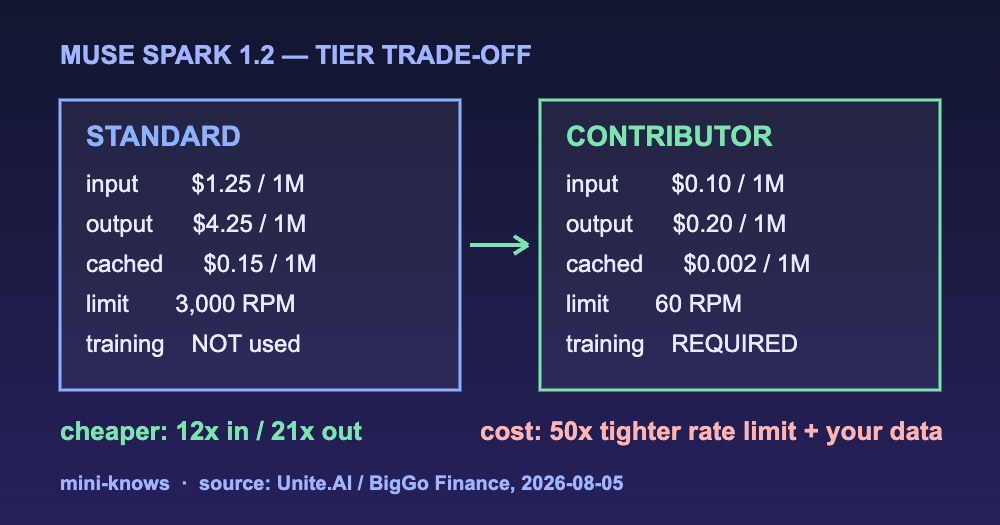
두 티어의 차이는 단순한 할인율이 아니라 데이터 정책의 차이다. 아래 수치는 Unite.AI와 BigGo Finance가 동일하게 보도한 값이며, 100만 토큰당 USD 기준이다(2026-08-05).
| 항목 | Standard | Contributor | 배수 |
|---|---|---|---|
| input | $1.25 | $0.10 | 약 12.5x |
| cached input | $0.15 | $0.002 | 75x |
| output | $4.25 | $0.20 | 약 21x |
| rate limit | 3,000 RPM / 4M TPM (팀당) | 60 RPM | 50x |
| 학습 데이터 사용 | 사용 안 함(메타 명시) | 사용 허용이 조건 | — |
레이트 리밋 격차가 가격 격차만큼 크다는 점이 실무적으로 중요하다. 60 RPM은 CI 파이프라인이나 다중 에이전트 팬아웃을 돌리기에는 빠듯한 수치다. Muse Code 자체가 백그라운드 에이전트와 병렬 서브에이전트를 전제로 하는 도구라는 점을 생각하면, 컨트리뷰터 티어에서는 이 도구의 설계 강점을 그대로 쓰기 어려울 가능성이 있다. 이 리밋 수치는 현재 BigGo Finance가 정리한 VentureBeat 보도 계열 출처에 근거하므로, 실제 계정 대시보드에서 재확인하는 편이 안전하다.
또 하나, 컨트리뷰터 티어도 결제 수단 등록이 선행된다. VentureBeat는 맥 미니 환경에서 설치 스크립트는 정상 동작했지만 "모델이 보이지 않으며 계정 설정 완료를 위해 결제가 필요하다"는 메시지로 에이전트가 실제 실행에 들어가지 못했다고 보도했다. 온보딩 시간을 잡을 때 감안할 부분이다.
4. 평가 방법론 — 숫자보다 조건을 먼저 본다
메타는 벤치마크 결과를 막대그래프 이미지로만 실었고, 별도 PDF로 방법론을 공개했다. 방법론 문서가 상당히 구체적이라 조건을 먼저 읽는 편이 낫다.
| 벤치마크 | 규모 | 채점 방식 |
|---|---|---|
| Terminal-Bench 2.1 (Stanford × Laude Institute) | 공식 89개 과제 전부 | 5회 시도 pass@1 평균, Daytona 격리 샌드박스 |
| DeepSWE v1.1 (Datacurve) | 91개 저장소·5개 언어(TS/Go/Python/JS/Rust) 113개 과제 | 기능 검증 + 회귀 체크 동시 통과 시에만 성공, 5회 pass@1 |
| Meta Internal Coding Bench | 사내 PR 기반 440개 과제 | 과제당 2회 시도, 과제별 성공률 평균 |
| GDPVal-AA v2 (Artificial Analysis) | 44개 직군·9개 산업 220개 과제 | LLM 심판 블라인드 쌍대비교 Elo, 인간 기준 1,000 |
| MCP Atlas (Scale AI) | 36개 MCP 서버·220개 툴, 1,000개 과제 | claim별 1/0.5/0 채점, 커버리지 0.75 이상 통과 |
읽을 때 반드시 붙여야 할 조건이 세 가지다.
첫째, 모델별로 각자의 에이전트 제품을 붙였다(Muse Spark 1.2는 Muse Code, Muse Spark 1.1은 mini-swe-agent, Grok은 Grok Build, Opus는 Claude Code, GPT는 Codex, Gemini는 Antigravity, Kimi는 Kimi Code). 추론 강도는 각 모델의 최대치를 썼다(1.2·1.1은 xhigh, Grok·Gemini는 high, Opus·GPT·Kimi는 max). 둘째, DeepSWE 공식 리더보드는 모든 모델에 mini-swe-agent를 쓰지만 메타 평가는 그렇지 않아 harness-identical이 아니다. 셋째, 메타 스스로 "우리 평가 셋업(에이전트 툴·시스템 프롬프트)이 서드파티 모델에 맞게 튜닝되지 않았을 수 있다"고 문서에 적었다.
Muse Spark 1.2의 구체적 점수는 텍스트로 공개되지 않아 2026-08-06 현재 인용 가능한 형태로 확정되지 않았다(확인 필요). 참고 기준선으로 MarkTechPost는 메타 모델 페이지상 Muse Spark 1.1의 Terminal-Bench 2.1 점수를 80.0으로 적었다.
5. 장기 작업 케이스 스터디 — GPU 커널 최적화
메타가 long-horizon 능력의 근거로 든 것은 커널 최적화 실험이다. Muse Code 환경에서 모델이 커널을 작성·컴파일·프로파일링하고 기준선 대비 성능을 반복 개선하는 루프를 1,000회 이상의 툴 호출, 최대 24시간 동안 돌렸다. 대상은 NVIDIA Hopper GPU의 KDA·MLA 커널이다.
KDA는 FLA의 Triton 구현이 기준선이고, FLA 같은 서드파티 커널 라이브러리를 직접 import하는 것은 금지됐다. 즉 알고리즘을 Triton으로 직접 구현해야 한다. 메타 설명에 따르면 모델은 chunk-parallel 준비 커널과 순차 inter-chunk scan을 결합했고, 게이트된 누적 감쇠(gated cumulative decay)를 청크 중간점에서 재중심화하는 KDA 특화 최적화를 적용했다. MLA는 배치 1, 헤드 64, 시퀀스 길이 8192, 잠재 차원 512의 PyTorch 참조 구현이 기준이며, 공유 KV latent를 K와 V로 재사용하는 2커널 Triton 파이프라인을 설계했다.
기술적으로 흥미로운 부분은 "24시간 동안 개선이 멈추지 않았다"는 주장이다. 코딩 에이전트에 대한 대표적 비판이 초반 이후 정체·표류라는 점을 정확히 겨냥한 시연이다. 다만 속도 향상 수치와 개선 지속 여부 모두 메타 자사 발표이므로, 자기 워크로드에서의 재현은 별도로 확인해야 한다.
6. 데이터 정책이 곧 아키텍처 결정이 된다
이번 요금 설계는 단순한 가격 경쟁이 아니라 도입 아키텍처를 강제한다. 사내 코드가 학습에 쓰이면 안 되는 조직이라면 컨트리뷰터 티어는 선택지에서 빠지고, 남는 것은 $1.25/$4.25의 표준 티어다. 이 가격대에서는 Muse Spark 1.2가 다른 프런티어 코딩 모델 대비 어떤 실측 우위를 보이는지가 관건이 된다.
메타의 방향 전환 자체도 맥락으로 볼 만하다. 라마(Llama) 계열은 가중치 공개로 생태계를 키우는 전략이었지만, 2026년 4월 첫 Muse Spark부터는 가중치 비공개 호스팅 모델로 바뀌었다. 이번에도 오픈소스 언급은 없다. 이전 단계의 정리가 필요하면 Meta Model API 첫 공개와 Muse Spark 1.1 정리를, 비교군인 앤스로픽 쪽 API 변화는 Claude Opus 5 API 마이그레이션 노트를 참고하면 된다.
자주 묻는 질문
Q. Muse Code는 기존 CLI 에이전트를 바로 대체할 수 있나?
현재는 베타이고 macOS·Linux 한정이며, 결제 수단 등록이 선행된다. 실측 비교 데이터가 부족하므로 교체보다 병렬 벤치마킹이 현실적이다.
Q. 컨트리뷰터 티어를 회사 코드에 써도 되나?
프롬프트와 응답을 메타 모델 학습에 사용하도록 허용하는 것이 이 티어의 조건이다. 비밀 유지 의무가 있는 코드에는 적합하지 않으며, 표준 티어는 학습에 사용하지 않는다고 메타가 명시했다.
Q. Muse Spark 1.2 가중치를 받아 self-host할 수 있나?
2026년 8월 5일 발표에는 다운로드 가능한 가중치 언급이 없다. 호스팅 의존 서비스로 보는 편이 맞고, 이후 정책 변경 여부는 확인이 필요하다.
마무리
정리하면 이번 릴리스의 기술적 핵심은 이벤트 로그 기반 복구 가능한 런타임과 harness 공동 학습이고, 도입 판단의 핵심은 요금 티어에 붙은 데이터 조건이다. 두 축을 분리해서 검토하시길 권합니다. 읽어주셔서 감사합니다.
출처
- Meta AI Research, "Introducing Muse Code and Muse Spark 1.2" (2026-08-05) — https://research.meta.ai/blog/introducing-muse-code-and-muse-spark-1-2
- Meta, "Muse Spark 1.2 & Muse Code Evaluation Methodology" (2026-08-05) — https://research.meta.ai/static/muse-spark-1-2-methodology
- TechCrunch (2026-08-05) — https://techcrunch.com/2026/08/05/meta-launches-muse-code-an-ai-agent-for-large-code-bases/
- Unite.AI (2026-08-05) — https://www.unite.ai/meta-ships-muse-code-coding-agent-with-co-trained-muse-spark-1-2-model/
- BigGo Finance (2026-08-05) — https://finance.biggo.com/news/202608052250_Meta_launches_Muse_Code_AI_coding_agent
- MarkTechPost (2026-08-05) — https://www.marktechpost.com/2026/08/05/meta-superintelligence-labs-releases-muse-code/
본 글은 공개 자료를 바탕으로 정리했으며, 세부 내용·수치는 원 출처·공식 문서와 대조 확인을 권장합니다. 성능·시연 관련 수치는 별도 표기가 없는 한 메타의 자사 발표 기준입니다.