안녕하세요, 미니지식공간입니다.
Qwen3.8-Max API가 2026년 8월 3일부터 열렸다. 이 글은 릴리스 소식 자체보다 Qwen API 요금과 컨텍스트·레이트 리밋, Responses 내장 툴처럼 붙이기 전에 확인해야 할 스펙에 초점을 맞춘다.
결론부터
- 붙이는 비용은 낮다. QwenCloud는 OpenAI 호환 Chat Completions·Responses와 Anthropic 호환 인터페이스를 모두 제공하므로, 대개 엔드포인트와 모델 ID 교체로 끝난다.
- 청구서를 결정하는 건 컨텍스트 길이가 아니라 프리픽스 안정성이다. 캐시 읽기 단가가 신규 입력의 8분의 1이다.
- 오픈웨이트는 예고 단계다. 2.4T 체크포인트는 자체 호스팅 단가를 계산할 근거가 아직 없고, 현실적인 온프레미스 후보는 함께 공개될 27B 쪽이다.
아키텍처와 규모
Qwen3.8-Max는 Qwen 3.5 아키텍처 위에 올린 희소 MoE(Mixture-of-Experts, 전문가 혼합) 모델이다. 총 2.4조 파라미터 중 추론 시 활성화되는 것은 950억으로, 알리바바는 하이브리드 어텐션을 함께 적용해 동급 규모의 밀집(dense) 모델 대비 연산 비용과 지연을 줄였다고 설명했다.
여기서 한 가지 짚어둘 부분이 있다. 활성 파라미터 95B는 알리바바 발표문과 이를 인용한 TNGlobal·TestingCatalog 보도에서 나온 값이다. 같은 날 게시된 MarkTechPost 분석은 발행 시점 기준으로 활성 파라미터 수가 미공개라고 적었다. 공식 기술 리포트가 나오기 전까지는 95B를 알리바바 주장으로 다루는 편이 안전하다.
입력은 텍스트·이미지·영상을 받고 출력은 텍스트다. 200페이지가 넘는 문서나 100시간 규모의 영상을 구조화된 지식베이스로 정리하는 것이 알리바바가 내세운 대표 시나리오다.
컨텍스트와 레이트 리밋
문서에 적힌 숫자는 1M 컨텍스트라는 한 줄보다 훨씬 구체적이다.
| 항목 | 값 |
|---|---|
| 컨텍스트 | 1M 토큰 |
| 최대 입력 | 991K |
| 최대 입력(thinking 활성) | 983K |
| 최대 출력 | 131K (양쪽 모드 동일) |
| 최대 reasoning 예산 | 262K |
| TPM (분당 토큰) | 2M |
| RPM (분당 요청) | 15K |
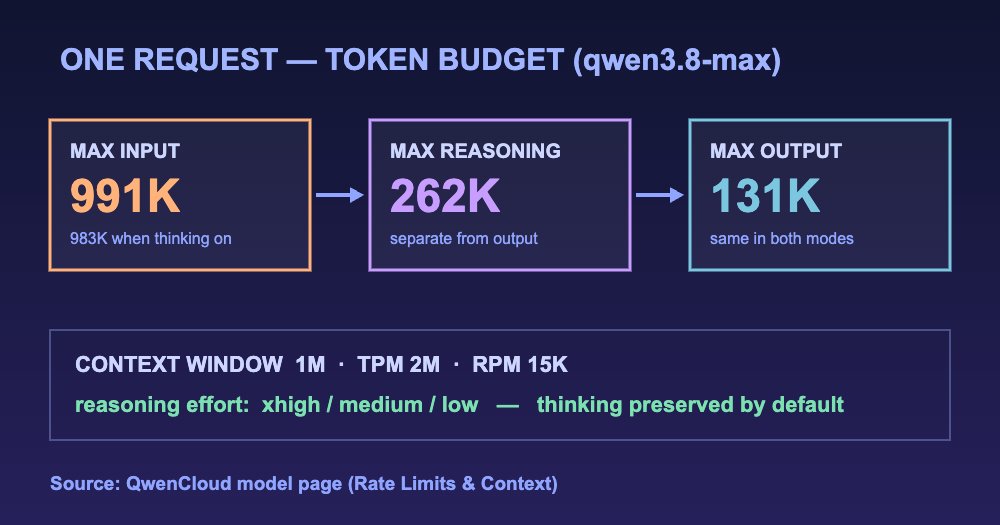
thinking을 켜면 입력 상한이 991K에서 983K로 줄어든다. reasoning 예산 262K는 출력 상한 131K와 별개 항목이므로, 장시간 에이전트 루프를 설계할 때 두 값을 따로 잡아야 한다. reasoning effort는 xhigh / medium / low 중에서 고를 수 있고, 사고 이력은 기본적으로 보존된다.
호출 예시
QwenCloud 모델 페이지가 제공하는 공식 Python 예제다. DashScope SDK로 이미지와 텍스트를 함께 넣는 멀티모달 호출이다.
import os
import dashscope
dashscope.base_http_api_url = "https://dashscope-intl.aliyuncs.com/api/v1"

messages = [
    {
        "role": "user",
        "content": [
            {"image": "https://help-static-aliyun-doc.aliyuncs.com/file-manage-files/zh-CN/20241022/emyrja/dog_and_girl.jpeg"},
            {"text": "What is depicted in the image?"}]
    }]
response = dashscope.MultiModalConversation.call(
    api_key=os.getenv("DASHSCOPE_API_KEY"),
    model="qwen3.8-max",
    messages=messages
)
print(response.output.choices[0].message.content[0]["text"])
출처: QwenCloud 모델 페이지 API Reference — https://www.qwencloud.com/models/qwen3.8-max
base_http_api_url이 dashscope-intl 도메인인 점을 눈여겨볼 만하다. 국제 리전 엔드포인트이며, 모델 ID는 qwen3.8-max다. OpenAI 호환 경로를 쓸 경우에는 같은 페이지의 OpenAI 탭에 정리된 base URL을 사용하면 된다.
Responses API 내장 툴
Responses API에는 다섯 가지 툴이 기본 탑재돼 있다. 별도 함수 정의 없이 호출 옵션으로 켜는 방식이다.
| 툴 | 용도 |
|---|---|
code_interpreter | 코드 실행 |
web_search | 실시간 웹 검색 |
web_extractor | 웹 페이지 본문 추출 |
t2i_search | 텍스트 기반 이미지 검색 |
i2i_search | 이미지 기반 이미지 검색 |
이 외에 function calling, structured outputs, batches, prefix completion(partial mode), fine-tuning, context cache가 지원 목록에 올라 있다. 즉 웹 검색·스크래핑용 툴을 직접 구현해 붙이던 파이프라인이라면 그 계층을 걷어낼 여지가 생긴다.
요금 설계 — 캐시를 못 살리면 손해다
| 구분 | 100만 토큰당 |
|---|---|
| 입력 | $2.00 |
| 출력 | $6.00 |
| 입력(암묵적 캐시 읽기) | $0.25 |
| 명시적 캐시 생성 | $2.50 |
| 명시적 캐시 읽기 | $0.17 |
설계상 함정이 두 가지 있다.
하나는 명시적 캐시의 손익분기다. 생성 단가가 $2.50으로 신규 입력 $2보다 오히려 비싸다. 한 번 만들어 여러 번 읽어야 $0.17 단가의 이득이 회수되므로, 재사용 횟수가 적은 프리픽스라면 암묵적 캐시($0.25)에 맡기는 편이 낫다.
다른 하나는 출력 단가다. 입력 대비 3배인 $6이고, reasoning 예산이 262K까지 열려 있다. 사고 토큰을 넉넉히 주는 설정으로 에이전트를 오래 돌리면 입력 최적화로 아낀 금액이 출력 쪽에서 상쇄될 수 있다. reasoning effort를 태스크별로 낮춰 잡는 튜닝이 실질적인 비용 통제 수단이 된다.
벤치마크의 유효 범위
아래 수치는 전부 알리바바 자사 발표다. 하네스와 채점 조건이 공개되지 않았으므로 절대 비교로 읽으면 안 된다.
| 벤치마크 | Qwen3.8-Max | 자사 표기 비교군 |
|---|---|---|
| Terminal-Bench 2.1 | 86.6 | Opus 4.8 / Fable 5 84.6 · GPT-5.6 Sol(max) 88.8 |
| SWE-bench Pro | 67.7 | Fable 5 80.0 |
| FrontierSWE | 73.5 | Fable 5 88.8 |
| PaperBench | 93.0 | 비교군 1위 주장 |
| IFBench | 82.8 | 비교군 1위 주장 |
| GPQA Diamond | 92.6 | Qwen3.7-Max 92.4 |
| OSWorld-Verified | 86.1 | 비전 상위 |
| Parametric CAD Bench | 91.5 | 비전 상위 |
| OmniDocBench 1.5 | 92.1 | 비전 상위 |
세대 간 개선폭은 에이전트 축에 몰려 있다. DeepSWE 1.1이 21.6에서 56.6으로, FrontierSWE가 40.7에서 73.5로, JobBench가 31.3에서 53.4로 올랐다. 반면 GPQA Diamond는 92.4에서 92.6으로 사실상 변화가 없다. 순수 추론 성능을 기대하고 교체하면 체감이 크지 않을 수 있다는 뜻이다.
주의할 각주도 두 개다. 첫째, 멀티모달 표의 비교 기준이 Qwen3.7-Max가 아니라 한 등급 아래인 Qwen3.7-Plus여서 세대 격차가 부풀려 보인다. 둘째, 알리바바가 함께 공개한 RL 스케일링 곡선은 학습 환경 약 4,000개에서 0.725로 정점을 찍은 뒤 0.719, 0.689로 하락한다. 환경 수 확대가 단조 증가로 이어지지 않는다는 자체 데이터다.
알리바바는 코드 생성과 GUI 조작을 결합해 블랙박스 애플리케이션을 재구성하게 하는 RecreationBench도 함께 공개했다. 사내 테스트에서는 약 16일간 자율로 oh-my-cli 프로젝트를 운영하며 커밋 265건, PR 127건, 이슈 151건을 처리했다고 밝혔다. 역시 자사 설계·자사 채점이다.
오픈웨이트가 갖는 의미
알리바바는 발표에서 Qwen3.8-Max와 Qwen3.8-27B의 가중치를 다음 주 허깅페이스·ModelScope에 공개하겠다고 예고했다. Max 등급 모델의 가중치 공개는 Qwen 계열에서 처음이다. 다만 2026년 8월 5일 현재 실제 공개 여부와 라이선스 조건은 확인 필요 상태다.
실무 관점에서 더 중요한 건 27B 쪽이다. 2.4T 체크포인트는 다중 노드 데이터센터 자산이라 일반 GPU 서버에 올릴 수 없고, 활성 파라미터가 확정되기 전에는 서빙 원가 모델링도 불가능하다. 자체 호스팅을 검토한다면 27B가 현실적인 출발점이다. 오픈웨이트 흐름 자체가 궁금하다면 Kimi K3 API 뜯어보기와 DeepSeek V4-Flash-0731 정리도 같은 맥락에서 참고할 수 있다.
자주 묻는 질문
Q. Qwen3.8-Max API 요금은 얼마인가?
100만 토큰당 입력 $2, 출력 $6이다. 암묵적 캐시로 읽히는 입력은 $0.25, 명시적 캐시 읽기는 $0.17이며 명시적 캐시 생성은 $2.50이다.
Q. 기존 OpenAI SDK 코드를 그대로 쓸 수 있나?
QwenCloud가 OpenAI 호환 Chat Completions와 Responses API를 제공하므로 대개 base URL과 모델 ID 교체로 동작한다. 다만 reasoning effort 옵션과 Responses 전용 내장 툴은 Qwen 문서를 별도로 확인해야 한다.
Q. 1M 컨텍스트를 다 쓰면 비용이 그만큼 늘어나나?
프리픽스가 반복돼 캐시에 적중하면 그 구간은 $0.25 또는 $0.17 단가로 계산된다. 따라서 컨텍스트 길이보다 프롬프트 앞부분을 얼마나 고정적으로 유지하느냐가 비용에 더 큰 영향을 준다.
마무리
교체를 검토한다면 순서는 이렇다. OpenAI 호환 경로로 최소 변경 연결을 확인하고, 자기 워크로드의 프리픽스 재사용률을 측정해 캐시 이득을 계산한 뒤, reasoning effort를 낮춘 조건에서 품질이 유지되는지 본다. 벤치마크는 전부 자사 수치이므로 판단 근거로는 자체 A/B 결과가 앞선다.
출처
- Qwen 공식 블로그 — https://qwen.ai/blog?id=qwen3.8 (2026-08-03)
- QwenCloud 모델 페이지(가격·컨텍스트·툴·API 예제) — https://www.qwencloud.com/models/qwen3.8-max
- MarkTechPost — https://www.marktechpost.com/2026/08/03/alibaba-qwen-releases-qwen3-8-max/ (2026-08-03)
- TNGlobal — https://technode.global/2026/08/04/chinas-alibaba-launches-qwen3-8-max-ai-model-with-2-4t-parameters-1m-token-context-window/ (2026-08-04)
- TestingCatalog — https://www.testingcatalog.com/qwen-released-qwen3-8-max-with-open-weights-coming-soon/ (2026-08-04)
본 글은 공개 자료를 바탕으로 정리했으며, 세부 내용·수치는 원 출처·공식 문서와 대조 확인을 권장합니다.