안녕하세요, 미니지식공간입니다.
claude-fable-5-1은 Fable 5와 표시 가격이 완전히 같은데도 실제 청구액이 내려간다. Claude Fable 5.1의 캐시 읽기 단가 하나가 100만 토큰당 1달러에서 0.25달러로 바뀌었기 때문인데, 이 글에서는 그 배수가 어떻게 계산되는지와 전환 전에 확인해야 할 항목을 공식 문서 기준으로 정리한다.
결론부터
- 앤트로픽(Anthropic)이 2026년 9월 1일 Claude Fable 5.1과 Claude Mythos 5.1을 공개했다. 두 모델은 동일 가중치이며 세이프가드 수준만 다르다.
- 입력 $10 / 출력 $50(100만 토큰당)은 Fable 5와 동일하다. 바뀐 건 캐시 읽기 배수 하나다. 다른 Claude 모델이 기본 입력가의 0.1배를 쓰는 반면 Fable 5.1과 Mythos 5.1만 0.025배를 적용한다.
- 앤트로픽 자사 추산으로 전형 워크로드 약 25%, 고도 에이전틱 워크로드 최대 약 45% 절감이다. 캐시 읽기 비중이 낮으면 체감은 거의 없다.
배수 하나가 만드는 차이
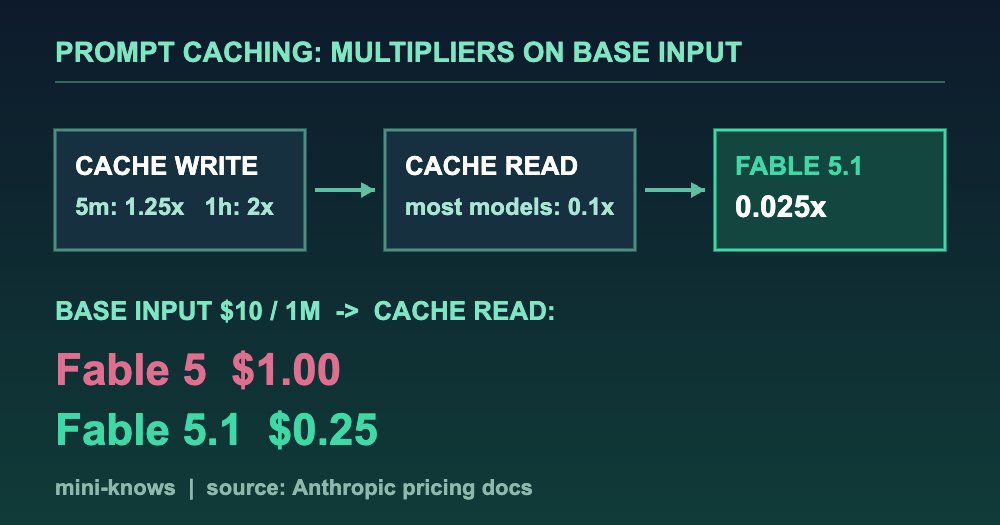
프롬프트 캐싱 요금은 세 갈래로 나뉜다. 공식 문서에 명시된 배수는 다음과 같다.
| 캐시 연산 | 배수 | 유효 기간 |
|---|---|---|
| 5분 캐시 쓰기 | 기본 입력가 × 1.25 | 5분 |
| 1시간 캐시 쓰기 | 기본 입력가 × 2 | 1시간 |
| 캐시 읽기(적중) | 기본 입력가 × 0.1 (Fable 5.1·Mythos 5.1은 × 0.025) | 직전 쓰기와 동일 |
출처: Claude Platform Docs, Pricing
Fable 5.1의 기본 입력가는 $10이므로 캐시 읽기는 $10 × 0.025 = $0.25다. Fable 5는 $10 × 0.1 = $1이었다. 실제 단가를 모델별로 놓고 보면 순위가 뒤집힌다.
| 모델 | 기본 입력 | 캐시 읽기 | 5분 쓰기 | 1시간 쓰기 | 출력 |
|---|---|---|---|---|---|
| Claude Fable 5.1 | $10 | $0.25 | $12.50 | $20 | $50 |
| Claude Fable 5 | $10 | $1 | $12.50 | $20 | $50 |
| Claude Opus 5 | $5 | $0.50 | $6.25 | $10 | $25 |
| Claude Sonnet 5 | $2 | $0.20 | $2.50 | $4 | $10 |
기본 입력은 Opus 5의 2배인데 캐시 읽기는 Opus 5의 절반이다. Sonnet 5 대비로는 기본 입력이 5배 비싼데 캐시 읽기는 25%만 비싸다. 즉 프롬프트 접두부를 얼마나 재사용하느냐가 모델 선택 기준을 뒤집는다.
손익분기도 달라진다. 5분 쓰기가 1.25배이므로, 배수 0.1 환경에서는 읽기 1회면 캐싱이 이득이었다. 배수 0.025인 Fable 5.1에서는 같은 쓰기 비용을 회수하는 데 필요한 읽기 횟수가 더 늘어나는 대신, 회수 이후의 절감 속도가 4배 빨라진다. 장시간 도는 에이전트 루프처럼 같은 접두부를 수십~수백 번 읽는 구조에서 차이가 벌어지는 이유다.
앤트로픽은 2026년 8월 4주간 실사용 데이터를 기본 effort(추론 강도)로 측정해, Fable 5를 100으로 지수화하면 전형 워크로드가 75, 고도 에이전틱 워크로드가 55로 내려간다고 밝혔다. 이 지수는 자사 측정값이다.
코드: 캐싱은 그대로, 모델 ID만 바꾼다
프롬프트 캐싱 API 자체는 변경되지 않았다. 공식 문서의 자동 캐싱(automatic caching) 예제에서 model만 claude-fable-5-1로 두면 그대로 동작한다. 아래는 Prompt caching 문서의 자동 캐싱 예제 형태에 모델 식별자만 교체한 것이다.
import anthropic

client = anthropic.Anthropic()

response = client.messages.create(
    model="claude-fable-5-1",
    max_tokens=1024,
    cache_control={"type": "ephemeral"},
    system="You are an AI assistant tasked with analyzing literary works. Your goal is to provide insightful commentary on themes, characters, and writing style.",
    messages=[
        {
            "role": "user",
            "content": "Analyze the major themes in 'Pride and Prejudice'.",
        }
    ],
)
print(response.usage.model_dump_json())
요청 최상위에 cache_control 한 줄을 얹는 방식이며, 대화가 길어질 때 캐시 분기점을 시스템이 알아서 관리한다. 기본 TTL은 5분이고, 1시간을 쓰려면 값을 명시한다.
{ "cache_control": { "type": "ephemeral", "ttl": "1h" } }블록 단위로 세밀하게 잡고 싶다면 개별 콘텐츠 블록에 cache_control을 붙이는 명시적 분기점 방식을 쓴다. 문서의 캐시 예열(pre-warming) 예제가 이 형태다.
prewarm = client.messages.create(
    model="claude-fable-5-1",
    max_tokens=0,
    system=[
        {
            "type": "text",
            "text": "You are an expert software engineer with deep knowledge of distributed systems...",
            "cache_control": {"type": "ephemeral"},
        }
    ],
    messages=[{"role": "user", "content": "warmup"}],
)
주의할 제약이 하나 있다. TTL이 다른 캐시 항목을 섞을 때는 긴 TTL이 짧은 TTL보다 앞에 와야 하고, 마지막 블록의 명시적 cache_control TTL이 최상위 값과 다르면 API가 400을 반환한다. Fable 5.1의 최소 캐시 가능 길이는 512토큰이다.
절감액은 usage 필드로 검증한다
모델을 바꿔놓고 청구서를 기다릴 필요는 없다. 응답의 usage에 캐시 읽기·쓰기 토큰이 분리돼 나온다.
{
  "usage": {
    "input_tokens": 2048,
    "cache_read_input_tokens": 1800,
    "cache_creation_input_tokens": 248,
    "output_tokens": 503,
    "cache_creation": {
      "ephemeral_5m_input_tokens": 148,
      "ephemeral_1h_input_tokens": 100
    }
  }
}input_tokens는 마지막 캐시 분기점 이후의 토큰만 센다. 따라서 전체 입력은 cache_read_input_tokens + cache_creation_input_tokens + input_tokens로 계산한다. 여기서 cache_read_input_tokens가 전체 입력에서 차지하는 비율이 이번 인하로 절감되는 폭을 그대로 결정한다. 이 비율이 낮다면 Fable 5.1로 옮겨도 청구서는 거의 그대로다.
벤치마크: 에이전트 축에 몰려 있다
아래 점수는 전부 앤트로픽 자사 발표값이며, 프로덕션 세이프가드를 켠 상태에서 측정됐다. 독립 검증 결과가 아니다.
| 벤치마크 | Fable 5.1 | Fable 5 | Opus 5 | GPT-5.6 Sol |
|---|---|---|---|---|
| Terminal-Bench-Science 0.1 | 52.6% | 24.7% | 29.0% | 22.4% |
| Terminal-Bench 4.0 | 55.8% | 42.0% | 52.3% | 37.3% |
| GDPval-AA v2 (Elo) | 1853 | 1723 | 1824 | 1711 |
| OSWorld 2.0 (strict) | 41.7% | 36.1% | 39.6% | — |
| AutomationBench | 31.4% | 17.1% | 26.9% | 19.6% |
| CursorBench 3.2.0 | 73.4% | 70.5% | 70.0% | 67.2% |
| Humanity's Last Exam (도구 사용) | 65.0% | 63.8% | 63.6% | — |
읽을 때 세 가지 단서를 같이 봐야 한다. 첫째, Terminal-Bench-Science 0.1의 표준오차가 모델당 ±3.5~4.5포인트다. 52.6%는 점이 아니라 구간이다. 둘째, OSWorld 2.0은 벤치마크 저자의 2026년 8월 과제 릴리스 기준이라 이전 공개 점수와 직접 비교할 수 없다. 셋째, 세이프가드가 개입한 과제에서 Fable 5.1과 Fable 5는 0점 처리됐다고 앤트로픽이 명시했다. Terminal-Bench 4.0에서 Mythos 5.1이 60.9%로 더 높은 것도 같은 이유다.
HLE는 63.8%에서 65.0%로 거의 제자리다. 지식 정답률이 아니라 장시간 에이전트 실행 쪽에 개선이 몰려 있다는 뜻으로 읽는 편이 정확하다.
전환 전에 확인할 것
1. 신규 API 계정 대상 파괴적 변경. 앤트로픽은 증류(distillation) 방지를 위해, 2026년 9월 1일 이후 생성된 API 계정에서 다중 턴 대화 중 Claude의 이전 사고 기록(thinking transcript)을 보존한 채 이전 컨텍스트를 수동 편집하는 것을 막았다. 기존 계정은 현재 영향이 없지만 향후 모델 릴리스부터 전체 적용된다고 밝혔다. 대화 히스토리를 직접 재조립하는 커스텀 연동이 있다면 여기서 깨진다.
2. 세이프가드 폴백은 Opus 요금으로 청구된다. Fable 5.1은 이제 방어 목적의 소프트웨어 취약점 탐지에 쓸 수 있고 Claude Code 세션당 사이버 세이프가드 개입이 Fable 5 대비 평균 약 60% 줄었다. 다만 익스플로잇 생성, 침투 테스트, 바이너리 기반 취약점 스캔은 여전히 Opus 모델로 우회된다. 생물학 쪽 폴백 구조는 이전에 정리한 Fable 5 생물학 세이프가드 글과 이어진다.
3. 데이터 보관. 엔터프라이즈 프론티어 세이프가드(EFS)는 모니터링 데이터를 고객사 자체 클라우드에 저장하는 구조로, 올가을부터 단계적으로 제공된다. 그전까지 적격 고객은 Fable 5.1을 무데이터보관(zero data retention) 조건으로 쓸 수 있다.
4. 다른 가격 배수와 겹칠 때. 배치 API는 입력·출력을 절반으로 낮춰 $5 / $25가 되고, inference_geo: "us"를 지정하면 캐시 읽기·쓰기를 포함한 모든 토큰 항목에 1.1배가 곱해진다. 두 배수는 캐싱 배수 위에 중첩된다. 구독 기반 사용량 한도와는 별개 축이므로, Claude Code 쪽 소비를 관리한다면 주간 한도 정리 글을 함께 참고할 만하다.
자주 묻는 질문
Q. Fable 5를 계속 쓸 이유가 있나?
표시 가격이 같고 캐시 읽기만 4배 비싸므로 캐시를 쓰는 워크로드라면 남을 이유가 없다. 표시 가격 자체를 낮추고 싶다면 Fable 계열이 아니라 Opus 5($5 / $25)가 선택지다.
Q. 캐시 배수 0.025는 다른 Claude 모델에도 적용되나?
현재는 Fable 5.1과 Mythos 5.1에만 적용된다. 공식 가격 문서 각주에 다른 모든 모델은 표준 0.1배를 사용한다고 명시돼 있다. 앤트로픽은 Fable 5.1의 개선을 나머지 모델군으로 가져오는 작업을 계속하고 있다고만 밝혔고, 확대 시점은 확인 필요하다.
Q. Mythos 5.1은 API로 바로 쓸 수 있나?
쓸 수 없다. 사이버 검증 프로그램(CVP)과 생명과학 검증 프로그램(LSVP)이라는 신뢰 접근 프로그램을 통해서만 제공되며, 현재는 미국 소재 조직 일부로 한정돼 있다.
마무리
이번 릴리스에서 실무적으로 확인할 값은 벤치마크 표가 아니라 usage.cache_read_input_tokens의 비율이다. 그 비율이 곧 절감률의 상한이고, 낮다면 모델을 바꿔도 청구서는 움직이지 않는다.
출처
- Anthropic, Introducing Claude Fable 5.1 and Claude Mythos 5.1 (2026-09)
- Claude Platform Docs, Pricing (2026-09-02 확인)
- Claude Platform Docs, Prompt caching (2026-09-02 확인)
- VentureBeat, Anthropic's Claude Fable 5.1 and Mythos 5.1 arrive with a 75% cost reduction for Fable cache reads (2026-09-01)
본 글은 공개 자료를 바탕으로 정리했으며, 세부 내용·수치는 원 출처·공식 문서와 대조 확인을 권장합니다. 성능 및 비용 절감 수치는 모두 앤트로픽 자사 발표·측정값입니다.