안녕하세요, 미니지식공간입니다.
Claude 텍스트 워터마크는 별도의 문자를 심는 방식이 아니라 SynthID-Text 계열의 샘플링 개입이다. 무엇이 언제부터 적용되고, 탐지기가 실제로 무엇을 계산하는지를 공식 자료와 공개 구현 코드로 확인한다.
TL;DR
- Anthropic이 2026-08-14 공식 블로그에서 Claude 텍스트 워터마크의 작동 방식을 공개했다. 근거는 EU AI법 투명성 실천규약(2026년 7월 서명, 약 190개 서명자)이고 EU 요구는 2026-08-02부터다.
- 방식은 Google DeepMind의 SynthID-Text(Nature, 2024) 변형이다. 토큰을 추가하지 않고 샘플링 난수의 출처만 바꾼다 → 토큰 수·요금·속도 불변.
- 2026-08-02 이후 출시 모델은 출시 시점부터 적용, 이전 모델은 경과기간에 따라 순차 적용. 지역 구분 없이 전 세계 일괄 적용.
- 탐지 API는 "곧 제공" 상태로 스펙 미공개 — 확인 필요.
적용 범위부터 확정하고 시작하자
공식 블로그와 고객센터 문서를 합쳐 보면 적용 경계가 이렇게 정리된다.
| 항목 | 내용 |
|---|---|
| 대상 모델 | 2026-08-02 이후 출시된 Claude 모델은 출시 시점부터 지원 |
| 기존 모델 | EU법 경과기간 적용, 향후 수개월간 순차 적용 (모델별 일정 미공개 — 확인 필요) |
| 대상 제품 | Claude Platform(API), Claude, Claude Code, Claude Cowork, Claude Tag |
| 클라우드 경유 | AWS, Google Cloud, Microsoft Foundry 경유 시에도 텍스트 워터마크 적용. 서명 메타데이터는 플랫폼에 따라 미지원 가능 |
| 지역 | 전 세계. "지역별로 범위를 나눌 안정적인 방법이 아직 없다"는 것이 회사 설명 |
| 텍스트 | 임베디드 워터마크 |
| 파일(.png/.jpg/.svg) | C2PA 서명 프로버넌스 메타데이터 (워터마크와 별개 기법) |
| 비용 | 추가 토큰 없음 → 과금 변화 없음 |
여기서 개발자가 먼저 확인할 것은 두 가지다. API 응답 텍스트에도 동일하게 적용된다는 것, 그리고 Bedrock·Vertex 같은 우회 경로로 빠져나가지 않는다는 것이다.
난수원 교체가 전부다
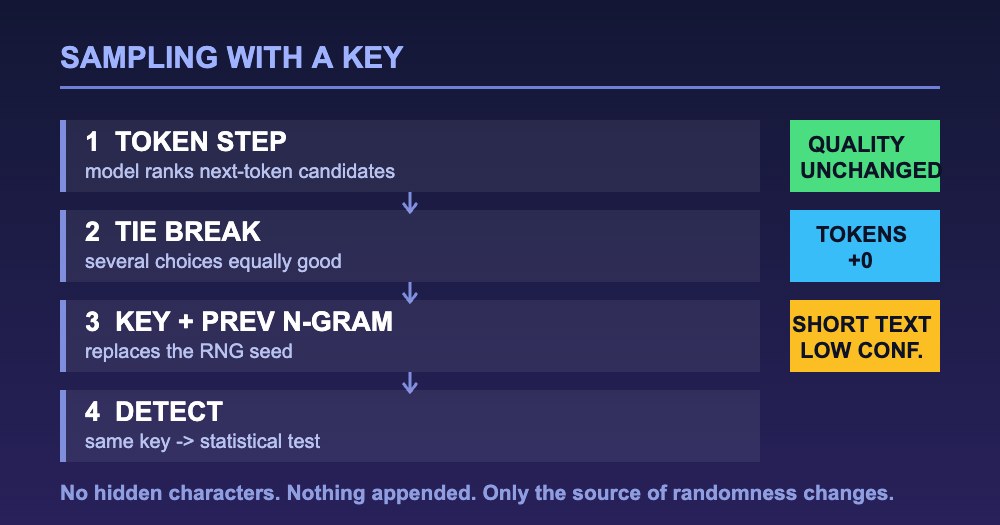
SynthID-Text의 핵심은 단순하다. 디코딩 단계에서 모델은 매 스텝 후보 토큰 분포에서 하나를 뽑는다. 이때 쓰이는 난수를 임의 RNG 대신 (비공개 키, 직전 n개 토큰)의 함수로 대체한다. 분포 자체를 왜곡하지 않으므로 출력 품질이 유지되고, 키를 아는 쪽은 실제 생성된 토큰 열이 그 함수와 정합적인지 통계 검정을 돌려 확률을 산출한다.
Anthropic은 이 계보가 2022년 Scott Aaronson의 제안까지 거슬러 올라가며, 공통 설계 원칙은 "워터마크가 바꾸는 것은 단어 선택에 쓰이는 무작위성의 출처뿐"이라고 명시했다. 품질 영향에 대해서는 SynthID-Text 논문에서 DeepMind가 Gemini 트래픽 일부에 워터마크 모델을 서빙해 좋아요·싫어요 비율을 비교했고 유의미한 차이가 없었다는 결과를 인용했다(자사 발표가 아니라 논문 인용임을 그대로 밝힌다).
코드로 확인하기
Anthropic의 키와 구현은 비공개다. 다만 기법 자체는 Hugging Face Transformers에 공식 구현이 들어가 있어, 파라미터 구조를 그대로 확인할 수 있다. 아래는 Hugging Face 공식 블로그 예제다.
from transformers import (
    AutoModelForCausalLM,
    AutoTokenizer,
    SynthIDTextWatermarkingConfig,
)

# Standard model and tokenizer initialization
tokenizer = AutoTokenizer.from_pretrained('repo/id')
model = AutoModelForCausalLM.from_pretrained('repo/id')

# SynthID Text configuration
watermarking_config = SynthIDTextWatermarkingConfig(
    keys=[654, 400, 836, 123, 340, 443, 597, 160, 57, ...],
    ngram_len=5,
)

# Generation with watermarking
tokenized_prompts = tokenizer(["your prompts here"])
output_sequences = model.generate(
    **tokenized_prompts,
    watermarking_config=watermarking_config,
    do_sample=True,
)
watermarked_text = tokenizer.batch_decode(output_sequences)
출처: https://huggingface.co/blog/synthid-text
keys가 비공개 키에 해당하고 ngram_len이 "직전 몇 개 토큰까지 보고 난수를 정할지"에 해당한다. SynthIDTextWatermarkingConfig의 전체 생성자 시그니처는 다음과 같다.
def __init__(
    self,
    ngram_len: int,
    keys: list[int],
    context_history_size: int = 1024,
    sampling_table_seed: int = 0,
    sampling_table_size: int = 2**16,
    skip_first_ngram_calls: bool = False,
    debug_mode: bool = False,
):주목할 점은 do_sample=True가 전제라는 것이다. greedy 디코딩에는 개입할 난수 자체가 없다. 온도를 극단적으로 낮추거나 결정론적 디코딩을 쓰는 파이프라인에서 워터마크 신호가 약해지는 이유가 여기 있다.
탐지 쪽도 같은 라이브러리에 들어 있다. 학습된 베이지안 탐지기를 불러와 토큰 열에 대해 판정을 내리는 구조다.
from transformers import (
    AutoTokenizer, BayesianDetectorModel, SynthIDTextWatermarkLogitsProcessor, SynthIDTextWatermarkDetector
)

detector_model = BayesianDetectorModel.from_pretrained("joaogante/dummy_synthid_detector")
logits_processor = SynthIDTextWatermarkLogitsProcessor(
    **detector_model.config.watermarking_config, device="cpu"
)
tokenizer = AutoTokenizer.from_pretrained(detector_model.config.model_name)
detector = SynthIDTextWatermarkDetector(detector_model, logits_processor, tokenizer)

test_input = tokenizer(["This is a test input"], return_tensors="pt")
is_watermarked = detector(test_input.input_ids)
출처: https://github.com/huggingface/transformers/blob/v4.46.0/src/transformers/generation/watermarking.py
탐지기가 생성 때와 동일한 watermarking_config를 그대로 받아 온다는 점이 핵심이다. 키가 다르면 판정이 성립하지 않는다. Anthropic이 "다른 회사가 워터마크를 넣어도 키가 다르고 방식도 다를 수 있어 판별 불가"라고 못 박은 이유가 이 구조에서 나온다.
신호가 죽는 구간
워터마크는 "동등하게 좋은 선택지가 여럿인 자리"에서만 살아 있다. 실무에서 신호가 약해지거나 사라지는 조건은 다음과 같다.
- 짧은 출력: 선택 지점 수가 적어 통계 검정의 신뢰도가 떨어진다. 길수록 확신이 커진다.
- 사실 밀도가 높은 텍스트: "Isaac Newton의 대표작은 Principia…" 다음 토큰처럼 정답이 하나뿐인 자리에는 개입하지 않는다.
- 코드: 정확성이 요구되는 토큰이 대부분이라 워터마크가 붙을 여지가 거의 없다. 다만 주석처럼 표현을 고를 수 있는 부분에는 붙을 수 있고, 회사 설명으로는 실제 코드에 미치는 영향은 무시할 수준이다.
- 교정·첨삭: 사람 원문을 가볍게 다듬은 결과물은 대부분의 토큰이 사람 것이라 붙을 자리가 없다.
- 전면 재작성: 모든 단어를 바꾸면 제거된다. 가벼운 편집으로는 완전히 제거되지 않는다.
반대로 번역문은 모든 토큰을 Claude가 고르므로 워터마크가 붙는다. 번역 파이프라인을 돌리는 팀은 이 부분을 알고 있어야 한다.
반발이 나온 지점
TechCrunch는 2026-08-11 첫 보도 이후 Reddit과 X에서 논쟁이 이어졌다고 전했다. 한쪽은 "무고한 사용자를 겨냥한 조치"라고 주장했고, 다른 쪽은 "이걸 원치 않을 이유는 속이려는 것뿐"이라고 반박했다. Business Insider는 X에서 수십 명이 구독 취소를 밝혔다고 보도했는데, 실제 규모는 확인 필요다.
기술적으로 보면 반발의 상당 부분은 오해에 기대고 있다. 워터마크와 키에는 사용자·조직·대화를 식별할 정보가 없고, 탐지로 얻는 결론은 "Claude가 관여했을 가능성"까지다. Anthropic은 이것이 저작권이나 법적 책임을 바꾸지 않으며, Pangram 같은 AI 탐지 서비스가 문체의 흔적을 보는 방식과는 근본적으로 다르다고 선을 그었다.
참고로 이 규약에 준수를 약속한 곳은 Anthropic만이 아니다. TechCrunch는 Black Forest Labs, Google, Meta, Microsoft, OpenAI, Synthesia도 서명했다고 전했다.
도입 전 체크리스트
- 사내 문서·공지·마케팅 카피를 Claude로 초안 잡는다면, 그 결과물에 표식이 남는다는 전제로 검수 프로세스를 정한다.
- 번역 파이프라인은 워터마크가 강하게 남는 구간이다. 고객사 납품물이 있다면 계약상 표기 의무와 대조해 둔다.
- 코드 생성물은 실질적으로 영향이 없다. 다만 생성된 주석을 그대로 커밋하는 관행은 한 번 짚어볼 만하다.
- Claude가 만든 이미지·SVG는 C2PA 메타데이터가 붙는다. CI에서 이미지 최적화나 포맷 변환을 거치면 대개 날아간다는 점을 인지한다.
- EU 시장에 제품을 낸다면, 제50조 의무는 모델 제공자와 별개로 자사 제품에도 적용될 수 있다. Anthropic도 "직접 평가하라"고 안내한다.
자주 묻는 질문
Q. 기존 API 코드를 고쳐야 하나?
아니다. 요청·응답 스키마 변화나 파라미터 추가는 공개된 자료에 없다. 워터마킹은 모델 레벨에서 적용되며 추가 토큰도 생기지 않는다.
Q. Claude 워터마크를 탐지하려면 어떻게 하나?
Anthropic이 워터마크 탐지 API를 제공할 예정이라고 밝혔지만 구현 세부는 정리 중이다. 공개 시점·이용 조건·최소 텍스트 길이 모두 미공개 — 확인 필요. 위 Transformers 코드는 SynthID-Text 기법을 재현한 공개 구현이지 Anthropic 키로 판정하는 도구가 아니다.
Q. 출력 품질이 실제로 떨어지지 않나?
Anthropic 내부 테스트에서는 내용·창의성·가독성 변화가 없었고, SynthID-Text 논문의 대조 실험에서도 유의미한 차이가 확인되지 않았다. 다만 두 결과 모두 해당 기법을 만든 쪽과 도입한 쪽의 발표라는 점은 감안할 필요가 있다.
마무리
Claude 텍스트 워터마크는 인터페이스를 바꾸지 않는 변화다. 코드도 요금도 그대로고, 바뀌는 것은 "이 텍스트에 Claude가 관여했을 가능성"이라는 신호가 항상 함께 나간다는 사실 하나다. 규약에 서명한 다른 개발사들도 각자 구현을 붙일 예정이라, 이 전제는 앞으로 특정 모델의 특성이 아니라 기본값이 될 가능성이 크다.
규제 쪽 배경은 EU AI법 디지털 옴니버스 확정 정리에서, Anthropic의 최근 정책 변화는 Claude Sonnet 5 가격 정리에서 이어서 보실 수 있습니다.
출처
- Anthropic, How Claude's text watermark works (2026-08-14): https://www.anthropic.com/news/claude-text-watermark
- Anthropic Help Center, How Claude marks AI-generated content: https://support.claude.com/en/articles/16266773-how-claude-marks-ai-generated-content
- TechCrunch (2026-08-15): https://techcrunch.com/2026/08/15/anthropic-shares-more-details-about-how-claudes-new-watermarks-will-work/
- TechCrunch (2026-08-11): https://techcrunch.com/2026/08/11/anthropic-says-it-will-watermark-text-generated-by-its-ai-models/
- Hugging Face, SynthID Text: https://huggingface.co/blog/synthid-text
본 글은 공개 자료를 바탕으로 정리했으며, 세부 내용·수치는 원 출처·공식 문서와 대조 확인을 권장합니다.