안녕하세요, 미니지식공간입니다. Zero Data Retention(ZDR, 제로 데이터 보존)을 프론티어 모델에도 유지하겠다는 OpenAI의 발표가 2026년 8월 19일 나왔다. 같은 기간 Anthropic은 커버드 모델에 30일 보존을 요구하고 있어서, API 데이터 정책이 벤더별로 갈라지는 국면에 들어섰다.
세 줄 요약
1. OpenAI가 2026-08-19 Private Safety Processing을 프리뷰 공개했다. 여러 상호작용에 걸친 패턴을 찾되 OpenAI 직원은 원본 콘텐츠에 접근하지 않는 구조라는 설명이다.
2. Anthropic은 커버드 모델(Mythos급 및 유사 역량 향후 모델)에 대해 프롬프트·출력을 30일 보존한다. 공식 고객센터 문서 기준이다.
3. 코드 레벨에서 바뀌는 건 거의 없다. ZDR이 켜지면store파라미터가 강제로false가 되고, 응답 재조회에 의존하던 코드만 영향을 받는다.
1. 타임라인
| 날짜 | 주체 | 내용 | 출처 |
|---|---|---|---|
| 2026-07-09(문서 갱신일) | Anthropic | 커버드 모델 30일 보존 정책 문서 공개 | 고객센터 |
| 2026-08-19 | OpenAI | Private Safety Processing 프리뷰, ZDR 유지 재확인 | 공식 블로그 |
| 2026-08-19 | OpenAI | Aleah Houze 제품 정책 총괄 기자 브리핑 | Axios |
| 2026년 9월(예정) | OpenAI | 롤아웃 시작 + 기술 백서 공개 | 공식 블로그 |
Anthropic 문서에는 한 가지 어긋나는 표기가 있다. 문서 갱신일은 2026년 7월 9일인데 본문의 시행일은 2026년 6월 9일로 적혀 있다. 갱신일보다 시행일이 앞서는 형태라 원문·콘솔 공지로 재확인이 필요하다.
2. ZDR이 API 동작을 어떻게 바꾸나
먼저 기본값부터 짚고 가자. OpenAI 개발자 문서에 따르면 남용 모니터링 로그는 기본적으로 모든 API 기능 사용에 대해 생성되고 최대 30일 보존된다. 법이 더 긴 보존을 요구하거나 서비스·제3자를 피해로부터 보호하는 데 합리적으로 필요한 경우는 예외다. 이 로그에서 고객 콘텐츠를 빼려면 ZDR이나 Modified Abuse Monitoring 승인을 받아야 하고, 두 제어 모두 OpenAI의 사전 승인과 추가 요건 수용이 전제다.
ZDR이 켜지면 엔드포인트 동작이 딱 한 군데 바뀐다. 문서 원문 표기를 그대로 옮기면 이렇다.
# 출처: https://developers.openai.com/api/docs/guides/your-data
# "Zero Data Retention changes some endpoint behavior:"

POST /v1/responses
POST /v1/chat/completions
  store  ->  ZDR 활성화 시 항상 false 로 처리됨
             (요청에서 true 로 설정해도 무시)

# Responses API 기본 동작 (ZDR 미적용 시)
#   - 애플리케이션 상태 보존 기간: 30일
#   - store=true 인 경우에도 동일하게 최소 30일 저장
#   - background 모드는 폴링을 위해 약 10분간 디스크에 저장
#   - 오디오 출력은 멀티턴을 위해 1시간 저장
즉 요청 본문에서 저장을 끄고 싶다면 문서상 파라미터는 다음과 같다. ZDR 조직이라면 아래 값을 명시하든 안 하든 결과는 같다.
{
  "model": "...",
  "input": "...",
  "store": false
}
store: false일 때의 부가 동작도 문서에 명시돼 있다. 서버 사이드 컴팩션(server-side compaction)에서는 store="false"이면 데이터가 보존되지 않는다. 반대로 ZDR이 조직에 활성화되지 않은 경우에는 지원 모델 전체에 대해 모든 쿼리가 확장 프롬프트 캐싱을 사용한다.
3. Private Safety Processing의 구조
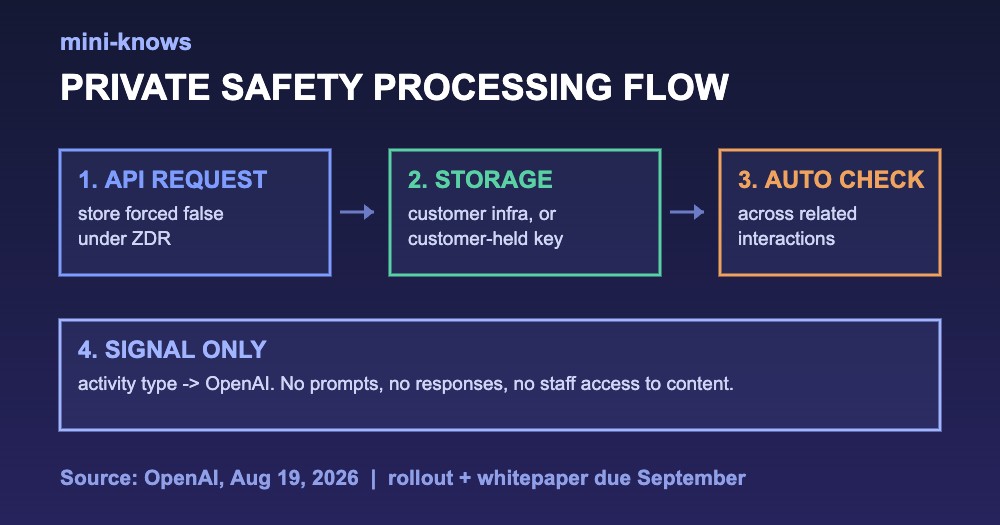
OpenAI 공식 글의 설명을 정리하면 이렇다. 기존 ZDR 호환 안전 시스템은 상호작용을 개별적으로 평가했다. Private Safety Processing은 그 보호를 관련된 여러 상호작용으로 확장한다. 자동화 시스템이 패턴을 식별하되, OpenAI 직원은 보존된 고객 콘텐츠에 접근하지 않는다.
저장 위치는 두 가지다. ZDR 배포에서는 고객 콘텐츠가 고객이 통제하는 인프라에 남는다. 또는 OpenAI가 제공하는 스토리지에 두되 고객이 통제하는 키로 암호화한다. OpenAI 직원은 그 키의 사본을 갖지 않으므로 원본 콘텐츠에 접근할 수 없다는 것이 회사 설명이다. 후자는 아직 개발 중(developing)이라고 원문에 적혀 있다.
위험이 식별되면 OpenAI가 받는 것은 관련 활동의 유형을 나타내는 좁게 정의된 신호(narrowly defined signal)다. 이 신호로 집행 필요 여부를 판단하고, 플래그가 걸린 경우에도 직원은 고객 콘텐츠에 접근하지 않는다. 고객은 자기 시스템의 정보로 알림과 집행 결정을 조사할 수 있고, 이의 제기나 조사 지원을 원하면 관련 정보를 스스로 선택해 공유한다.
왜 이런 게 필요한가에 대한 OpenAI 측 설명은 Axios 브리핑에 구체적으로 나온다. 제품 정책 총괄 Aleah Houze는 어떤 사람이 한 대화에서는 특정 회사 소프트웨어의 약점을 묻고, 다른 대화에서는 원격 접속이나 보안 도구의 탐지 범위를 묻는 식으로 요청을 나눌 수 있다고 예시를 들었다. 단일 프롬프트-응답 쌍만 봐서는 잡히지 않는 패턴이라는 취지다.
4. Anthropic 쪽 설정
Anthropic 고객센터 문서는 커버드 모델에 제출된 프롬프트와 생성된 출력을 30일간 보존한다고 명시한다. 대상은 Mythos급 모델과 유사한 역량을 지닌 향후 모델이며, 다른 모델은 기존 약관 그대로다. 소비자 플랜(Free·Pro·Max)은 이미 입출력을 보존하고 있어 영향이 없다.
적용 대상은 좁다. Claude Console에서 ZDR 워크스페이스를 설정한 조직, Claude Enterprise에서 ZDR로 Claude Code를 쓰는 조직, 그리고 AWS Bedrock·Google Cloud Agent Platform·Microsoft Foundry를 ZDR로 경유하는 조직이다. 그 외 조직은 설정할 것이 없다.
# 출처: https://support.claude.com/en/articles/15425996-data-retention-practices-for-covered-models

[Claude Platform 직접 사용]
  Workspace > Manage > Privacy Controls  에서 보존 활성화
  -> 다른 ZDR 워크스페이스는 ZDR 유지

[Amazon Bedrock 경유]
  보존 활성화 필요. 보존 데이터는 AWS 안에 남음

[Google Cloud Agent Platform 경유]
  보존 활성화 필요. 보존 데이터는 GCP 안에 남음

[Azure Foundry 경유]
  Azure 구독 단위로 설정
  -> ZDR 구독을 쓰고 있다면 별도 구독 생성 필요

[Claude Code]
  동작하는 워크스페이스의 설정을 따름
  Bedrock / GCP 경유 시에는 클라우드 환경 설정을 따름
보호 장치도 문서에 적혀 있다. 기본적으로 Anthropic 직원은 보존된 대화를 읽을 수 없고, 사람의 검토는 자동 신뢰·안전 시스템이 잠재적 위해로 플래그한 경우처럼 통제된 접근 경로로만 가능하다. 검토는 소수의 승인된 검토자만 수행하며, 모든 접근은 검토자가 억제하거나 수정할 수 없는 변조 방지 로그에 기록된다. 30일이 지나면 데이터는 자동 삭제되고, 플래그된 경우나 법적 보관 의무가 있는 드문 경우만 예외다.
5. 두 접근의 비교
| 축 | OpenAI | Anthropic |
|---|---|---|
| 프론티어 모델 정책 | ZDR 유지 | 커버드 모델 30일 보존 |
| 다중 요청 탐지 방식 | 콘텐츠 접근 없이 패턴 분석 후 신호만 수신 | 프롬프트·출력을 함께 보존해 분석 |
| 키 통제 | 고객이 키 통제, OpenAI는 사본 미보유 | 적격 조직은 고객 관리 암호화 키 옵션 |
| 사람 검토 | 플래그 시에도 직원 콘텐츠 미접근 | 통제된 경로, 소수 승인 검토자, 변조 방지 로그 |
| 상태 | 얼리 커스터머 테스트 중, 9월 롤아웃·백서 예정 | 문서화된 시행 정책 |
Anthropic이 이 결정의 부담을 스스로 인정한 대목도 있다. Axios가 인용한 지난주 리스크 리포트에서 Anthropic은 30일 보존이 제로 보존에 익숙한 고객에게 인기가 없을 것이고 특히 경쟁사가 따라오지 않으면 사업 성공에 실질적 위험을 초래한다고 적었다. 다만 여러 요청에 걸친 정교한 공격을 탐지·차단하는 데 필수적이라고 판단했다는 것이다.
6. 도입 전 체크리스트
- OpenAI 콘솔의
Settings → Organization → Data controls → Data Retention탭에서 조직 레벨 설정을 확인한다. ZDR인지 Modified Abuse Monitoring인지. - 프로젝트 레벨 설정을 하나씩 본다. 각 프로젝트는
default로 조직 설정을 상속하거나, ZDR·Modified Abuse Monitoring을 명시하거나,None으로 끌 수 있다. 개발·프로덕션 프로젝트가 다르게 걸려 있는 경우가 흔하다. - 쓰고 있는 엔드포인트가 ZDR 적격인지 문서 표를 확인한다.
/v1/assistants,/v1/threads,/v1/vector_stores등은 ZDR 부적격으로 표기돼 있고, 부적격 엔드포인트는 ZDR을 켜도 애플리케이션 상태를 저장할 수 있다. - 이미지·파일 입력 경로를 점검한다. 제출 시 CSAM 분류기 검사를 거치고, 잠재적 CSAM으로 탐지되면 ZDR·Modified Abuse Monitoring·Eyes Off가 켜져 있어도 수동 검토를 위해 이미지가 보존된다. OpenAI는 이를 법적 신고 의무에 따른 것으로 각주에 명시했다.
- Claude 쪽은 커버드 모델을 쓸 워크스페이스만 보존을 켠다. 클라우드 경유라면 보존 데이터가 어느 클라우드에 남는지 확인한다.
- Eyes Off·Safety Retention 조항을 읽어둔다. OpenAI는 ZDR·Modified Abuse Monitoring 승인 고객이라도 특정 고객에 대해 모델을 해당 제어 대상에서 제외할 권리를 유보하며, 이 경우 사전 서면 통지를 한다고 문서에 적었다.
자주 묻는 질문
Q. ZDR을 켜면 store: true를 보내도 저장이 안 되나?
그렇다. OpenAI 문서 기준으로 ZDR이 조직에 활성화되면 /v1/responses와 /v1/chat/completions의 store 파라미터는 요청이 true로 설정하려 해도 항상 false로 처리된다. 응답 ID로 나중에 다시 불러오는 패턴을 쓰고 있었다면 그 코드는 동작이 달라진다.
Q. Private Safety Processing을 지금 쓸 수 있나?
아직 아니다. OpenAI는 현재 얼리 커스터머와 테스트 중이라고 밝혔고, 넓은 롤아웃 시작과 기술 백서 공개를 2026년 9월로 예고했다. 프리뷰 단계이므로 계약이나 조달 문서에 반영하기 전에 정식 문서를 기다리는 편이 안전하다.
Q. ChatGPT Plus나 Pro를 쓰면 ZDR이 적용되나?
아니다. Axios 보도에 따르면 이 안전 시스템은 자격 요건을 갖춘 엔터프라이즈·API 고객용으로 설계됐고, OpenAI의 ZDR 제어는 Free·Plus·Go·Pro 사용자에게 적용되지 않는다. 소비자 데이터 설정은 그대로 유지된다.
마무리
정리하면, 코드가 바뀌는 폭은 작고 계약과 설정이 바뀌는 폭은 크다. store 파라미터 하나로 요약되는 API 레벨 변화 뒤에, 어느 벤더의 프론티어 모델을 쓸 수 있느냐가 조직의 데이터 보존 정책에 달리는 구도가 만들어졌다. 판단은 9월 기술 백서를 보고 해도 늦지 않다.
관련해서 이전에 정리한 글도 함께 보면 맥락이 이어진다. 추론 블록이 API 경계에서 어떻게 새는지는 thinking signature 재생 취약점 글에서, 벤더가 출력 자체에 표식을 남기는 방향은 Claude 텍스트 워터마크 글에서 다뤘다.
출처
- OpenAI, "Offering Zero Data Retention for frontier models", 2026-08-19 — https://openai.com/index/offering-zero-data-retention-for-frontier-models/
- OpenAI 개발자 문서, "Data controls in the OpenAI platform" — https://developers.openai.com/api/docs/guides/your-data
- Anthropic 고객센터, "Data retention practices for Covered Models" — https://support.claude.com/en/articles/15425996-data-retention-practices-for-covered-models
- Axios, "OpenAI previews zero-retention safety system as Anthropic requires data logs", 2026-08-19 — https://www.axios.com/2026/08/19/openai-previews-zero-retention-safety-system-as-anthropic-requires-data-logs
- TechCrunch, "OpenAI seeks to one-up Anthropic with new customer privacy protections", 2026-08-19 — https://techcrunch.com/2026/08/19/openai-seeks-to-one-up-anthropic-with-new-customer-privacy-protections/
본 글은 공개 자료를 바탕으로 정리했으며, 세부 내용·수치는 원 출처·공식 문서와 대조 확인을 권장합니다. 설계·보호 장치에 관한 서술은 각 회사의 자사 발표 및 주장이며 외부 감사 결과가 아닙니다.