안녕하세요, 미니지식공간입니다.
Decision 3.0 — vLLM Semantic Router 팀의 멀티모달 결정 모델(decision model) 계열이 허깅페이스에 Apache-2.0으로 올라왔다. 토큰을 생성하지 않고 선택지별 확률만 돌려주는 구조라서, LLM 라우팅이나 분류 판단을 별도 레이어로 떼어 내려는 쪽에서는 지금 바로 재 볼 수 있는 오픈 웨이트다.
- 허깅페이스
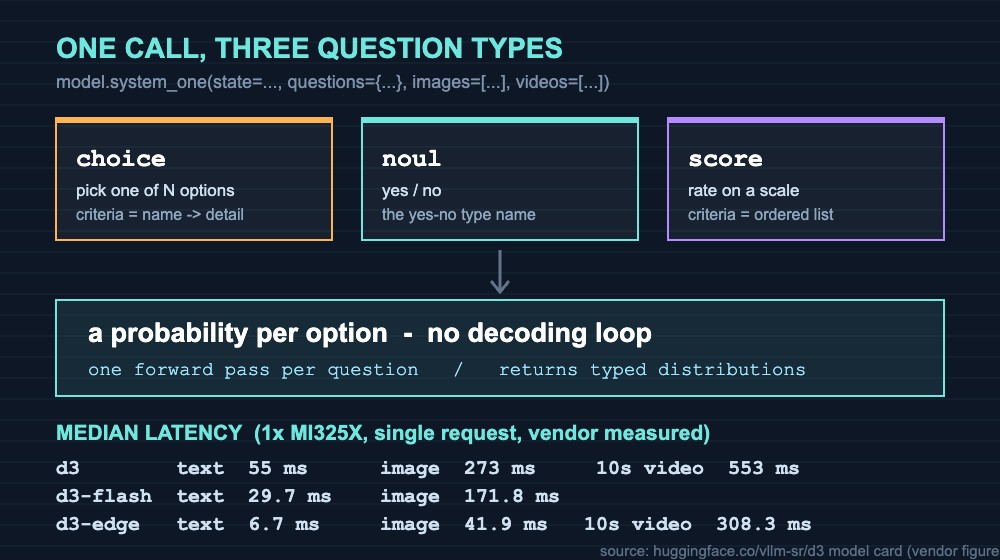
vllm-sr조직에d3계열 저장소 6개. 표시 크기 26B / 8B / 5B / 2B / 0.9B / 0.6B, 전부 Apache-2.0.- 호출 한 번에 choice · yes-no · score 질문을 섞어 넣으면 질문마다 확률 분포가 돌아온다. 디코딩 루프가 없다.
- 공식 발표 글·릴리스 노트·컨텍스트 한도가 없다. 성능 수치는 전부 자사 측정이다.
1. 문서에 적힌 것만 먼저
- 주체: vLLM Semantic Router 팀. 모델 카드는 자신을 "vLLM Semantic Router의 결정 모델"로 소개한다.
- 라이선스: 여섯 모델 모두 Apache-2.0. 기반 Qwen 모델도 Apache-2.0.
- 기반 모델:
d3→Qwen/Qwen3.8-27B,d3-flash→Qwen/Qwen3.5-9B. (d3-flash는 Model tree 박스가Qwen/Qwen3.5-9B-Base로 적혀 라이선스 절과 어긋난다.) - 파라미터:
d326.09B(비전 인코더 0.46B 포함),d3-flash8.39B(동일 인코더 포함). 텐서 타입 BF16. - 학습 하드웨어: AMD Instinct MI325X.
- 파이프라인 태그: zero-shot classification. API 메서드는
model.system_one(...),pipeline("decision", ...)별칭도 있다. - 배포 상태: 두 카드 모두 "이 모델은 어떤 추론 제공자에도 배포되지 않았습니다". 즉 엔드포인트가 아니라 로컬 로드 경로만 있다.
- 출시일: 모델 카드에 없다. 인용 BibTeX는
year = {2026}뿐이고, 허깅페이스 상대 시각이 2026-10-11 전후를 가리킨다. 2차 보도(OrcaRouter, 2026-10-11)는 업로드가 2026-10-10 09:38 UTC부터 23:49 UTC 사이에 이뤄졌다고 적는다. 공식 블로그 글·깃허브 릴리스 노트는 2026-10-12 기준 존재하지 않는다(확인 필요).
2. 라인업과 개수 불일치
| 모델 ID | 표시 크기 | 영상 입력 | 비고 |
|---|---|---|---|
vllm-sr/d3 | 26B (26.09B) | 카드에 기재 | video 태그 있음 |
vllm-sr/d3-flash | 8B (8.39B) | 카드에 없음 | video 태그 없음 |
vllm-sr/d3-mini | 5B | 카드 미확인 | — |
vllm-sr/d3-nano | 2B | 카드 미확인 | — |
vllm-sr/d3-lite | 0.9B | 카드 미확인 | — |
vllm-sr/d3-edge | 0.6B | 카드 미확인 | 컬렉션 누락 사례 있음 |
계열 개수가 출처마다 다르다. 허깅페이스 Decision 3.0 컬렉션은 5개를 담은 시점이 있었고, 조직 페이지의 컬렉션 위젯은 4개만 보여준 적이 있다. d3 카드 푸터는 "6 items", d3-flash 카드 푸터는 "5 items"를 같은 시간대에 표시했다. 2차 보도 중 Tech AI Magazine(2026-10-12)은 "0.8B에서 27B까지 5개"로 적어 0.59B급 d3-edge를 빼놓았다. d3-* 저장소는 6개가 실재하지만 공식 계열 정의는 미확정이다(확인 필요).
3. 호출 — system_one 하나로 끝난다
의존성과 최소 호출은 모델 카드 퀵스타트에 그대로 적혀 있다. 아래는 d3 카드의 블록을 그대로 옮긴 것이다.
출처: https://huggingface.co/vllm-sr/d3
pip install "transformers==5.17.0" torch torchvision pillow opencv-python-headless safetensors accelerate
pip install flash-linear-attention  # optional: fast GPU kernels for the linear-attention layers
transformers 버전이 ==5.17.0으로 고정돼 있다는 점을 먼저 보는 편이 좋다. trust_remote_code=True로 저장소 안의 modeling_d3.py를 그대로 실행하는 구조이기 때문에 버전이 밀리면 바로 깨진다.
출처: https://huggingface.co/vllm-sr/d3
import json

from transformers import AutoModel

model = AutoModel.from_pretrained("vllm-sr/d3", trust_remote_code=True)

result = model.system_one(
    state="The order arrived damaged yesterday. The customer has a receipt and asks for a replacement today.",
    questions={
        "route": {
            "type": "choice",
            "instructions": "Which team should handle this request?",
            "criteria": {
                "returns": "Refunds, replacements and damaged deliveries",
                "billing": "Payments, invoices and charges",
                "technical": "Product setup and faults"
            }
        },
        "receipt": {
            "type": "noul",
            "instructions": "Does the customer have a receipt?"
        },
        "urgency": {
            "type": "score",
            "instructions": "How urgent is this request?",
            "criteria": [
                "Routine",
                "Soon",
                "Today"
            ]
        }
    },
)
print(json.dumps(result["answers"], indent=2))
읽을 지점이 세 군데다. 첫째, state는 판단 대상 하나이고 questions는 이름 붙은 질문들의 딕셔너리다. 둘째, 예/아니오 타입의 이름이 noul이다(카드 코드 그대로이며 오타가 아니다). 셋째, criteria는 choice에서는 보기 이름 → 설명의 딕셔너리, score에서는 단계 리스트다. 설명 없이 보기만 두려면 값에 None을 넣는 예시도 카드에 함께 있다.
이미지·영상은 같은 호출에 images=[...], videos=[...]로 붙인다. 카드 주석은 로컬 경로, http(s) URL, PIL 이미지, base64 데이터 URL을 모두 받는다고 적어 둔다.
허깅페이스 "Use this model" 위젯이 내놓는 스니펫은 태스크 이름이 다르다. 위젯은 pipeline("zero-shot-classification", ...)을 쓰고, 카드 퀵스타트 주석은 pipeline("decision", ...)을 쓴다. 같은 모델에 두 표기가 공존하므로 복사해 쓸 때 주의한다.
4. 입력 제약 — 토큰이 아니라 픽셀로 적혀 있다
| 항목 | 값 | 출처 |
|---|---|---|
| 이미지 포맷 | PNG, JPEG, WebP | d3 카드 |
| 이미지 해상도 | 한 장당 최대 1.6 메가픽셀 | d3 카드 |
| 이미지 개수 | 요청당 여러 장, 모든 질문이 모든 이미지를 본다 | d3 카드 |
| 이미지 배치 | 텍스트보다 앞 | d3 카드 |
| 영상 포맷 | MP4, WebM, MOV, MKV, 프레임 배열 | d3 카드 |
| 영상 샘플링 | 초당 2프레임 | d3 카드 |
| 영상 프레임 수 | 영상 전체에서 최대 32프레임 | d3 카드 |
| 영상 프레임 해상도 | 프레임당 최대 0.2 메가픽셀 | d3 카드 |
| 컨텍스트 윈도 / 토큰 한도 | 미기재 (가장 큰 모델의 decision_config.json은 max_length가 null) | 확인 필요 |
영상 쪽은 계산이 바로 나온다. 2fps · 최대 32프레임이면 실질 커버 구간은 16초 내외이고, 더 긴 영상은 전체에 걸쳐 32프레임으로 희석된다. 긴 영상에서 짧은 사건을 잡아야 하면 모델 밖에서 구간을 잘라 넣는 설계가 맞다.
d3-flash 카드에는 영상 항목이 아예 없고 video 태그도 없는데, 조직 페이지의 데모 스페이스 설명은 d3-flash도 "text, images and video"를 다룬다고 적는다. 두 기술이 어긋나므로 영상이 필요하면 d3를 기준으로 잡는 편이 안전하다(확인 필요).
5. 자사 벤치마크 — 비교군은 자사 리더보드 데이터
카드가 직접 밝힌 조건부터 옮긴다. d3·d3-flash 행은 팀의 내부 평가이고, 비교 행은 "live board data, text 2026-10-10, vision 2026-10-09"다. 독립 재현은 어디에도 없다.
| 모델 | Jev Decision Index 0.3.1 | 공개 | 동일 스킬 | 새 도메인 |
|---|---|---|---|---|
d3 | 64.7 | 65.5 | 62.8 | 56.6 |
| Perplexity Decider v1.1 (27B) | 62.8 | 62.3 | 61.1 | 55.6 |
| Fastino GLiDE no-thinking (28B) | 60.2 | 59.1 | 59.5 | 52.9 |
| Jev | 60.1 | 58.0 | 58.0 | 55.0 |
| Torchcast Decision 27B | 59.9 | 65.1 | 58.1 | 50.8 |
| Decision 2.0 (27B) | 55.9 | 57.0 | 55.7 | 47.9 |
| 모델 | 비전 보드 | 공개 | 비공개 |
|---|---|---|---|
d3 | 71.6 | 74.2 | 68.9 |
| Perplexity Decider v1.1 (27B) | 70.6 | 73.2 | 67.9 |
| JEV-27B-VL | 69.6 | 72.8 | 66.4 |
| Solomon v1.1 (27B) | 66.8 | 69.9 | 63.8 |
d3공개 수트 65.45, Decision 2.0 27B(56.97) 대비 +8.5 주장.d3-flash공개 수트 57.78, Decision 2.0 9B(46.76) 대비 +11.0 주장. 텍스트 보드에서는 59.0으로 Decision 2.0 9B(48.2)보다 위.- Perception Test 검증 세트 전체 19,140문항에서
d377.4(내부 평가). 3지선다라 우연 정답률 33.3이라고 카드가 함께 적는다. 세부는 Memory 80.3 / Abstraction 71.2 / Physics 72.5 / Semantics 88.8. - 2차 보도가 정리한 크기별 공개 수트와 Decision 2.0 동급 대비 상승폭:
d3-flash57.79(+11.0),d3-mini54.90(+10.7),d3-nano42.22(+12.2),d3-lite36.93(+16.4),d3-edge28.82(+12.1).
세대 간 실제 차이는 지수 변동보다 모달리티다. Decision 2.0 계열은 텍스트만 읽었고 Decision 3.0은 이미지·영상을 읽는다. 지수 상승폭을 두고 "더 나은 사전학습 레시피"와 "작은 모델에 더 센 튜닝"을 외부에서 구분할 방법은 없다는 점도 2차 보도가 짚는다.
6. 지연 — 이 계열을 쓰는 실질적 이유
MI325X 한 장, 요청 하나씩, 중간값 기준이다(자사 측정).
| 모델 | 텍스트 | 이미지 1장 포함 | 10초 영상 포함 |
|---|---|---|---|
d3 | 55 ms | 273 ms | 553 ms |
d3-flash | 29.7 ms | 171.8 ms | — |
d3-edge | 6.7 ms | 41.9 ms | 308.3 ms |
d3-edge 행은 2차 보도 수치다. 생성 모델로 같은 분류를 하면 들어가지 않는 구간이고, 판단 레이어를 요청 경로 앞단에 두는 설계가 가능해지는 지점이 여기다.
7. 도입 전 점검할 것
- 토큰 한도를 직접 재라. 문서에 없다. 긴 입력을 넣을 계획이면 길이를 늘려 가며 끊기는 지점을 찾아 두는 작업이 선행이다.
- 확률을 임계값으로 쓰려면 보정부터 하라. 여섯 카드 어디에도 Brier 점수·기대 보정 오차·온도 값이 없다. 자기 라벨 데이터로 신뢰도-정확도 곡선을 먼저 그려야 0.8 같은 컷이 의미를 갖는다.
transformers==5.17.0고정과trust_remote_code=True를 운영 정책과 맞춰 보라. 저장소 코드를 실행하는 방식이라, 리비전 핀과MODEL_MANIFEST.json의 파일별 SHA-256 검증을 파이프라인에 넣는 쪽이 맞다.- 엔드포인트를 전제하지 마라. 추론 제공자 배포가 없다. 직접 서빙 또는 로컬 프로세스 경로를 계산에 넣어야 한다.
- 라우터 본체 연결은 아직 확인하라. 프로젝트 문서 소개 페이지와 모델 허브 목록에
d3가 없다. 2차 보도는 저장소에d3·d3-edge를 런타임에 연결하는 커밋이 2026-10-11에 들어갔다고 전하지만, 공식 설정 스키마 문서에서는 확인되지 않는다(확인 필요).
자주 묻는 질문
Decision 3.0을 상업 서비스에 넣어도 되나?
모델 카드 기준 여섯 모델 전부 Apache-2.0이고 기반 Qwen 모델도 Apache-2.0이다. 다만 사용 형태에 따라 해석이 달라질 수 있으니 저장소 LICENSE 파일을 직접 확인하는 편이 안전하다.
기존 분류 코드를 고쳐야 하나?
생성 모델 호출을 쓰고 있었다면 인터페이스가 다르다. 프롬프트와 파싱 대신 state + questions 딕셔너리를 만들고 반환된 확률을 읽는 구조로 바꿔야 한다. 응답이 자유 텍스트가 아니라 타입이 정해진 확률 분포이므로 파싱 코드는 오히려 줄어든다.
vLLM로 serve할 수 있나?
확인 필요하다. 조회한 모델 카드·조직 페이지·프로젝트 문서 소개·모델 허브 어디에도 d3용 vllm serve 명령이나 라우터 설정 YAML 예시가 없다. 현재 문서화된 경로는 트랜스포머 AutoModel 로드뿐이다.
마무리
정리하면 Decision 3.0은 모델 자체보다 "판단을 생성과 분리한다"는 설계를 오픈 웨이트로 확인해 볼 기회에 가깝다. 공식 문서가 얇고 수치가 전부 자사 측정이라 그대로 믿을 단계는 아니지만, 라이선스가 열려 있고 0.6B급까지 있어서 직접 재 보는 비용은 낮다. 요청 단위로 모델을 갈라 보내는 접근 자체가 어떤 그림인지는 Cursor Router 분석 글에서 다룬 적이 있어 함께 보면 맥락이 잡힌다.
출처
vllm-sr/d3모델 카드 — https://huggingface.co/vllm-sr/d3vllm-sr/d3-flash모델 카드 — https://huggingface.co/vllm-sr/d3-flashvllm-sr조직 페이지 — https://huggingface.co/vllm-sr- Decision 3.0 컬렉션 — https://huggingface.co/collections/vllm-sr/decision-30
- vLLM Semantic Router 문서 소개 — https://vllm-sr.ai/docs/intro/
- vLLM Semantic Router 깃허브 — https://github.com/vllm-project/semantic-router
- OrcaRouter, 2026-10-11 — https://www.orcarouter.ai/blog/decision-3-0-open-multimodal-decision-models
- Tech AI Magazine, 2026-10-12 — https://www.techaimag.com/ai-news/vllm-semantic-router-unveils-decision-3-0-models
본 글은 공개 자료를 바탕으로 정리했으며, 세부 내용·수치는 원 출처·공식 문서와 대조 확인을 권장합니다. 본문의 벤치마크·지연 수치는 전부 vLLM Semantic Router 팀의 자사 발표·자사 측정값이고 비교군 행은 같은 팀이 운영하는 리더보드 데이터로, 독립 검증된 바 없습니다. 출시일, 컨텍스트 한도, 계열 모델 개수, d3-flash 영상 지원, vllm serve 경로는 공식 문서에서 확인되지 않아 "확인 필요"로 표기했습니다.