안녕하세요, 미니지식공간입니다.
Muse Wonder는 메타가 2026년 10월 12일 공개한 첫 프런티어급(한 세대의 최고 성능 구간) 모델 계열이고, Model API로 호출할 수 있는 쪽은 muse-wonder-1.0 한 종류뿐이다. Muse Wonder 가격은 100만 토큰당 입력 $4.00 / 출력 $20.00이며, 상위 변종인 Muse Wonder Full은 API 목록에 아예 올라오지 않았다.
- 2026-10-12 공개. 변종 2종 — Muse Wonder(Model API 가능), Muse Wonder Full(Muse Code 구독 전용).
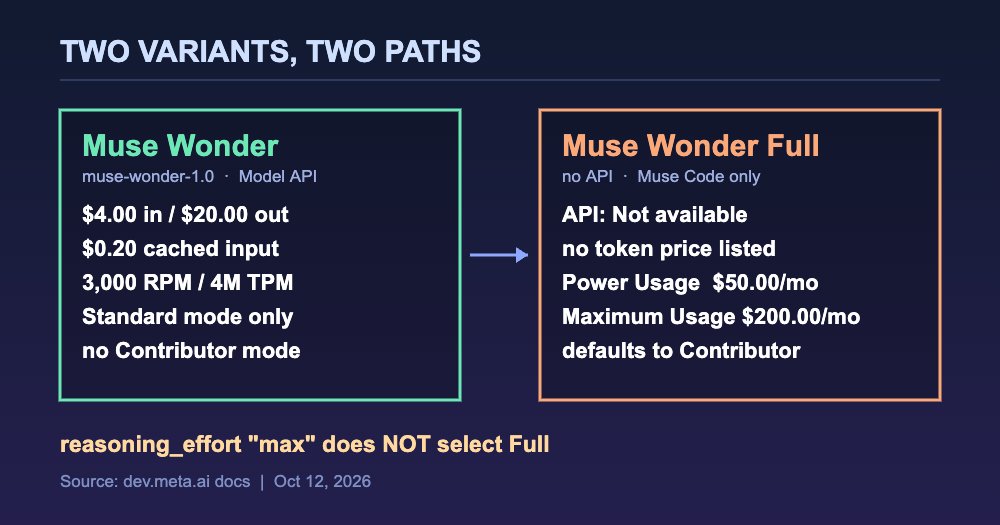
muse-wonder-1.0Standard 단가(100만 토큰당): 캐시 입력 $0.20 / 입력 $4.00 / 출력 $20.00.- Full은 Model API에서 "Not available". Muse Code Power Usage $50.00/월, Maximum Usage $200.00/월 플랜에서만 쓸 수 있다.
1. 공식 문서에 적힌 것만 모으면
- 공개일: 2026-10-12 (모델 카드 "Date of Release October 12, 2026", 뉴스룸·리서치 블로그 동일)
- 주체: Meta Platforms, Inc. / Meta Platforms Ireland Limited (모델 카드 Model Provider 표기)
- 모델 ID:
muse-wonder-1.0. 상태는 문서상 preview - 컨텍스트: 1,048,576 토큰. 모델 카드는 "Context Length 1M tokens at inference"
- 입력: 텍스트·이미지·영상·음성, 문서 기준 PDF 포함 / 출력: 텍스트
- 추론 강도:
reasoning effort를"minimal"부터"max"까지 - 학습: 메타의 기가와트급 Prometheus 데이터센터. TechCrunch(2026-10-12)는 위치를 오하이오 중부로 적었다
- 파라미터 수, 최대 출력 토큰, 지식 컷오프는 뉴스룸·리서치 블로그·모델 카드·개발자 문서 어디에도 없다 → 확인 필요
메타가 이름을 붙인 기능 축은 두 가지다. Active Memory는 대화를 넘겨가며 중요한 맥락을 들고 다니면서 필요한 시점에 꺼내 쓰는 쪽이고, Active Focus는 막히거나 요구사항이 바뀌어도 목표를 계속 밀고 나가면서 대안을 시도하고 중요한 행동 전에는 확인을 받는 쪽이다. 각각 FocusBench와 MemoryBench로 평가했다고 적혀 있다.
2. 호출 — 엔드포인트와 SDK
Model API 베이스 URL은 https://api.meta.ai/v1이고 OpenAI SDK와 호환된다. 아래는 개발자 문서 모델 페이지에 그대로 실린 예제다.
import os

from openai import OpenAI

client = OpenAI(
    base_url="https://api.meta.ai/v1",
    api_key=os.environ["MODEL_API_KEY"],
)

response = client.models.list()

print(response.model_dump_json(indent=2))
출처: https://dev.meta.ai/docs/models
모델 목록을 curl로 받는 쪽도 문서에 있다.
curl -X GET "https://api.meta.ai/v1/models" \
  -H "Authorization: Bearer $MODEL_API_KEY"
출처: https://dev.meta.ai/docs/models
주의할 점이 하나 있다. 문서의 퀵스타트 채팅 예제는 모델 ID가 muse-spark-1.3으로 적혀 있고, Muse Wonder 전용 채팅 예제는 공식 문서에 없다. 다만 같은 문서가 "Muse Wonder와 Muse Spark는 같은 엔드포인트에서 같은 요청을 받으므로 둘 사이의 이동은 모델 ID 교체"라고 적어 두었다. 그래서 아래는 문서의 퀵스타트 형태에 문서가 명시한 모델 ID만 끼운 스니펫이고, 문서에 없는 파라미터는 넣지 않았다.
# dev.meta.ai/docs 퀵스타트 형태 + 문서에 명시된 모델 ID
# 문서 원문 예제의 모델 ID는 muse-spark-1.3이다
response = client.chat.completions.create(
    model="muse-wonder-1.0",
    messages=[{"role": "user", "content": "..."}],
)
print(response.choices[0].message.content)
출처: https://dev.meta.ai/docs/models , https://dev.meta.ai/docs/cookbook/quickstart-chat-completions
프로토콜은 Responses / Chat Completions / Messages 세 가지가 열려 있다. 문서가 적어 둔 동작 규칙 중 실무에서 걸리는 쪽은, 추론 토큰이 usage의 reasoning_tokens로 잡히면서 출력 토큰으로 과금된다는 점이다.
3. 단가 — 같은 표에 Muse Spark를 올려 보면
100만 토큰당 USD, 개발자 문서 Pricing and rate limits 페이지 기준이다.
| 항목 | Muse Wonder (Standard) | Muse Wonder (Contributor) | Muse Spark (Standard) | Muse Spark (Contributor) |
|---|---|---|---|---|
| 캐시 입력 | $0.20 | 불가 | $0.15 | $0.002 |
| 입력 | $4.00 | 불가 | $1.25 | $0.10 |
| 출력 | $20.00 | 불가 | $4.25 | $0.20 |
Standard 기준으로 Muse Spark 대비 입력 3.2배($4.00/$1.25), 출력 약 4.71배($20.00/$4.25)다. 재검산해도 같다.
여기서 설계에 바로 영향을 주는 항목이 Contributor mode 불가다. Muse Spark에는 콘텐츠를 학습에 쓰도록 허용하는 대신 단가를 크게 내리는 muse-spark-1.3-contributor 같은 변종이 있지만, 문서는 "Contributor mode isn't available for Muse Wonder on Model API"라고 적었다. Model API의 Muse Wonder는 Standard mode 전용이고, 그쪽은 보낸 프롬프트·코드·파일·맥락과 받은 응답을 메타가 학습에 쓰지 않는다고 명시돼 있다.
반대로 Muse Code 구독은 기본값이 Contributor mode이고 설정에서 끌 수 있다. 같은 모델을 어느 경로로 부르는지에 따라 데이터 처리 기본값이 갈리므로, 사내 코드가 섞이는 작업이라면 경로를 먼저 정하는 쪽이 맞다.
레이트 리밋은 muse-wonder-1.0이 3,000 RPM / 4,000,000 TPM이고, 문서는 이 한도가 API 키 단위가 아니라 팀 단위로 걸린다고 못 박았다. 한 팀의 모든 키가 같은 한도를 나눠 쓴다. 긴 컨텍스트를 채워도 단가가 올라가지 않는 no long-context premium 조항도 같은 페이지에 있다.
4. Full이 API에 없다는 사실의 무게
| 변종 | Model API (종량제) | Muse Code |
|---|---|---|
Muse Wonder (muse-wonder-1.0) | 가능 (Standard mode 전용) | 종량제 + 전체 플랜 |
| Muse Wonder Full | 불가 | Power Usage / Maximum Usage |
문서가 따로 경고하는 지점이 있다. reasoning effort를 "max"로 올려도 Muse Wonder Full이 선택되지 않는다. 둘은 추론 강도 차이가 아니라 별개 변종이다. Full의 토큰 단가는 어디에도 공시되지 않았고(종량제 자체가 없다), 접근 경로는 구독뿐이다.
Muse Code 구독은 네 플랜이다. Everyday Usage는 5시간당 10~50 프롬프트, High Usage는 Everyday의 5배, Power Usage는 20배에 가장 강한 모델 접근 포함, Maximum Usage는 80배다. 공시된 월 가격은 모델 페이지에 적힌 Power Usage $50.00/월, Maximum Usage $200.00/월 두 개뿐이고, Everyday·High Usage의 월 가격은 구독 문서에 없다 → 확인 필요.
5. 벤치마크 — 숫자의 출처를 먼저 보고
전부 max 추론 강도 기준이고, 메타 모델 페이지의 비교표다. 모델 카드는 이 비교가 자사 내부 평가 + 벤더 제공 점수 + 제3자 결과가 섞인 것이라고 스스로 밝혔다. 따라서 아래는 독립 검증된 순위표가 아니라 메타 발표 수치로 읽어야 한다.
| 벤치마크 | Wonder Full | Wonder | Fable 5.1 | GPT-6 Astra | Opus 5.5 |
|---|---|---|---|---|---|
| Personal Superintelligence Index | 59.1 | 54.3 | 49.9 | 54.5 | 55.2 |
| Harvey LAB-AA (법률) | 13.1 | 10.0 | 6.4 | 8.6 | 4.2 |
| Vals Finance Agent V2 | 59.1 | 56.6 | 58.9 | 53.5 | 58.6 |
| HealthBench Pro | 62.3 | 60.5 | 62.1 | 65.3 | 65.6 |
| AutomationBench-AA | 45.4 | 39.1 | 32.1 | 41.6 | 41.2 |
| GDP.pdf | 33.2 | 30.8 | 27.6 | 34.2 | 30.6 |
| JobBench | 75.3 | 70.5 | 73.1 | 66.1 | 75.4 |
| MemoryBench | 85.5 | 85.6 | 79.0 | 81.4 | 81.5 |
| Terminal-Bench 4.0-AA | 57.1 | 52.0 | 52.0 | 59.1 | 59.6 |
| DeepSWE 1.1 | 79.0 | 78.8 | 67.4 | 74.1 | 74.2 |
| SWE-Marathon | 57.5 (xhigh) | 53.1 | 45.6 | 42.5 | 46.3 |
| ProgramBench | 59.0 | 50.0 | 55.5 | 52.5 | 70.5 |
| Artificial Analysis Index | 56 | 52 | 53 | 53 | 58 |
읽을 때 걸러야 할 지점을 네 가지만 적는다.
- Personal Superintelligence Index는 메타 내부 합성 지수다. 모델 카드는 Agents' Last Exam, AutomationBench-AA, FocusBench, JobBench, GDP.pdf, VBT, DRACO 7종을 묶은 것이라고 밝혔다. 자사가 구성한 지수에서 자사 모델이 1위인 것은 정보량이 적다.
- SWE-Marathon 비교는 동일 하네스(모델을 감싸는 실행 틀) 비교가 아니다. 모델 카드가 직접, 비교 대상의 리더보드 기록이 Codex와 Claude Code를 쓴 것이어서 "controlled common-harness comparison"이 아니라고 적었다.
- Wonder Full의 57.5만 xhigh로 측정됐다. 표의 다른 칸과 측정 조건이 다르다.
- MemoryBench는 메타 내부 벤치마크이고 대화 길이 64K~100K 토큰 구간이다. 여기서 Wonder(85.6)가 Wonder Full(85.5)보다 미세하게 높다 — 상위 변종이 모든 축에서 낫다는 가정이 성립하지 않는다는 뜻이다.
실제로 Wonder Full도 Terminal-Bench 4.0-AA(57.1 vs Astra 59.1 / Opus 59.6), HealthBench Pro(62.3 vs 65.3 / 65.6), ProgramBench(59.0 vs Opus 70.5), Artificial Analysis Index(56 vs Opus 58)에서는 밀린다. 매체 해석도 갈렸다. TechCrunch(2026-10-12)는 두 모델이 Fable 5.1·GPT-6 Astra와 "비슷한 수준"이라고 적었고, VentureBeat(같은 날)는 Wonder Full이 그 둘을 앞선다고 적었다. 같은 표를 놓고 나온 서로 다른 요약이다.
6. 가중치와 라이선스
가중치는 공개되지 않았고, 모델 라이선스도 공시되지 않았다. 사용은 Meta Model API Terms of Service, Meta Model Acceptable Use Policy 등 호스팅 약관이 규율한다. 메타의 오픈 웨이트 라인은 별개로 남아 있다 — 8월에 아파치 2.0으로 풀린 Muse Glimmer 30B 쪽이 자가 호스팅 경로이고, Muse Wonder는 그 경로가 없다. 모델 카드의 의도된 용도는 "commercial and research use", 18세 미만 사용은 비의도로 적혀 있다.
안전 쪽에서 메타가 스스로 밝힌 것도 기록해 둘 만하다. 모델 카드는 완화 조치가 없는 상태의 모델이 화학·생물 영역에서 고위험 기준선에 닿을 가능성을 배제하지 않는다고 적고, 그래서 안전 후속학습과 시스템 레벨 분류기를 적용했다고 설명한다. 사이버보안과 통제 상실은 완화 전에도 "moderate or lower"로 평가했다. 결과가 되돌릴 수 없는 에이전트 행동에는 사람 확인을 권고한다.
자주 묻는 질문
Muse Wonder Full을 API로 쓸 수 있나?
2026-10-12 공개 시점 기준으로 불가능하다. 개발자 문서의 변종 표가 Model API 칸을 "Not available"로 적었고, 종량제 토큰 단가도 공시되지 않았다. Muse Code의 Power Usage($50.00/월) 또는 Maximum Usage($200.00/월) 구독이 유일한 경로다.
기존 Muse Spark 코드를 수정해야 하나?
엔드포인트와 요청 형태는 그대로다. 문서가 두 모델이 같은 엔드포인트에서 같은 요청을 받는다고 적었으므로 모델 ID 교체가 기본이다. 다만 muse-spark-1.3-contributor처럼 Contributor 변종을 쓰고 있었다면 Muse Wonder에는 대응 변종이 없어서 Standard 단가로 올라간다.
Muse Wonder는 Claude Opus 5.5와 단가가 같은데 성능도 같나?
단가는 같은 구간이지만 표의 방향은 벤치마크마다 갈린다. 메타 발표 기준으로 Muse Wonder Full은 DeepSWE 1.1·SWE-Marathon·Harvey LAB-AA에서 앞서고, ProgramBench·Terminal-Bench·Artificial Analysis Index에서는 Opus 5.5가 앞선다. 게다가 API로 쓸 수 있는 쪽은 Full이 아닌 Muse Wonder(52)다. 본인 워크로드로 재는 쪽이 맞다.
마무리
정리하면 이번 발표의 실무 쟁점은 성능 순위보다 접근 경로다. 숫자가 가장 좋은 변종은 API에 없고, API에 있는 변종은 Contributor mode가 없어 단가를 내릴 여지가 없다. 반대로 단가를 내려 주는 Muse Code 구독은 기본값이 Contributor mode라서 데이터 처리 조건이 달라진다. 가격표만 보고 결정할 수 있는 발표가 아니다. 파라미터 수·최대 출력 토큰·지식 컷오프가 모두 미공개라는 점도 도입 판단에서 빈칸으로 남는다.
같은 메타 계열에서 Contributor 단가와 하네스 공동학습을 다룬 Muse Spark 1.2 정리도 이번 경로 비교에 참고가 된다.
출처
- https://about.fb.com/news/2026/10/introducing-muse-wonder-models/ (공식 1차, 2026-10-12)
- https://research.meta.ai/blog/muse-wonder (공식 1차, 기술 블로그)
- https://research.meta.ai/static/muse-wonder-model-card (공식 1차, 모델 카드 PDF — 평가 방법론·안전)
- https://dev.meta.ai/models/muse-wonder/ (공식 1차, 벤치마크표·구독 가격)
- https://dev.meta.ai/docs/models (공식 1차, 사양·변종·코드)
- https://dev.meta.ai/docs/pricing-rate-limits (공식 1차, 단가·레이트 리밋)
- https://dev.meta.ai/docs/muse-code/subscriptions (공식 1차, 구독 플랜)
- https://venturebeat.com/technology/metas-new-muse-wonder-and-muse-wonder-full-models-achieve-frontier-performance-but-only-the-weaker-one-is-available-via-api (2026-10-12)
- https://techcrunch.com/2026/10/12/meta-releases-its-first-frontier-model-muse-wonder/ (2026-10-12)
본 글은 공개 자료를 바탕으로 정리했으며, 세부 내용·수치는 원 출처·공식 문서와 대조 확인을 권장합니다. 본문의 성능·벤치마크 수치는 메타가 발표한 값이며, 모델 카드가 밝힌 대로 자사 내부 평가와 벤더 제공 점수, 제3자 결과가 섞여 있습니다. 독립 검증 결과가 아닙니다.