안녕하세요, 미니지식공간입니다. DeepInfer는 DeepSeek이 자사 프로덕션 서비스를 돌려온 추론 프레임워크이고, 2026년 10월 20일 Apache 2.0으로 공개됐다. 저장소를 열어보면 "범용 서빙 엔진"이 아니라 "DeepSeek-V4.1-Flash를 특정 하드웨어에서 최대로 뽑아내는 엔진"에 가깝다. 어디까지 들어 있고 무엇이 빠졌는지, 설치 경로와 환경변수까지 코드 기준으로 정리한다.
TL;DR
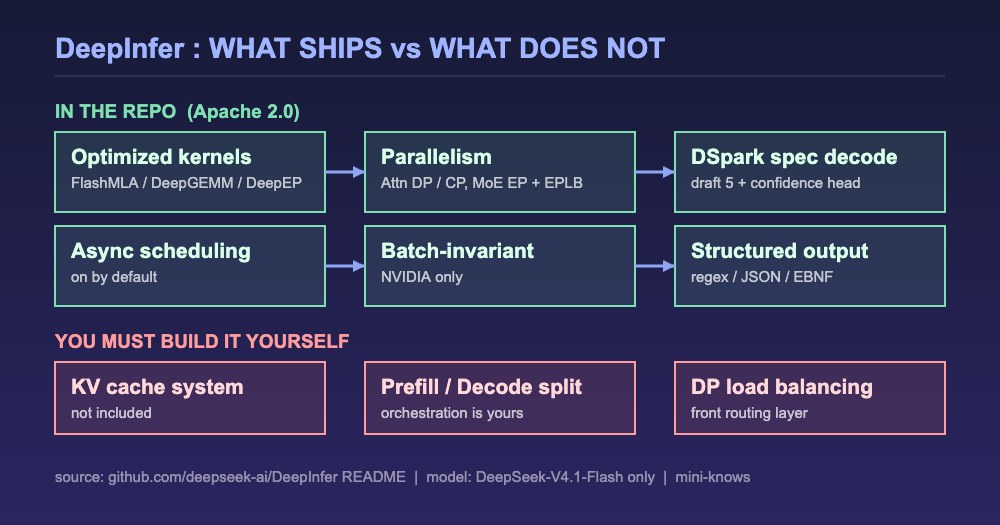
1. 공개 범위는 오프라인 추론(offline inference)이다. KV 캐시 시스템, VE/Prefill/Decode 분리, 데이터 병렬 복제본 간 로드밸런싱은 저장소에 없다.
2. 지원 축이 좁다. NVIDIA SM100 GPU와 Huawei Ascend 950 NPU, 그리고 모델은 DeepSeek-V4.1-Flash 하나다.
3. README는 DeepInfer가 "주로 vLLM 위에 구축됐고 SGLang·TensorRT-LLM에서 영감을 받았다"고 명시한다. 성능 수치는 전부 자사 발표다.
1. 설치는 pip가 아니라 빌드다
README의 Prerequisites는 Linux, GCC 13.0 이상, Python 3.12, 그리고 NVIDIA면 CUDA 13 / Ascend면 CANN 9.2(Huawei의 Ascend 소프트웨어 스택)다. pip 설치나 공식 도커 이미지 안내는 README에 없고, 빈 Python 3.12 환경을 만든 뒤 소스를 빌드하는 경로만 제시된다.
# Use `ascend` instead for the Ascend platform
# Keep it exported in the environment where you run DeepInfer
export DEEPINFER_ACCELERATOR=nvidia
./build.sh
출처: https://github.com/deepseek-ai/DeepInfer (README, Installation)
주석에 적힌 "실행하는 환경에서도 export를 유지하라"는 단서를 놓치기 쉽다. 빌드 때만 지정하고 실행 셸에서 빠뜨리면 가속기 선택이 흔들린다. 동작 확인은 예제 스크립트 한 줄이다.
python examples/offline_inference.py기본 체크포인트는 Hugging Face의 deepseek-ai/DeepSeek-V4.1-Flash-1017이고 첫 실행 시 HF 캐시로 내려온다. 로컬 사본을 쓰려면 경로를 지정한다.
export DEEPINFER_HF_MODEL_DIR=/path/to/DeepSeek-V4.1-Flash-1017저장소에는 pyproject.toml, setup.py와 함께 requirements-nvidia.txt, requirements-ascend.txt가 따로 들어 있다. 가속기별 의존성이 갈린다는 뜻이고, 한 환경에서 두 백엔드를 동시에 쓰는 구성은 전제되지 않는다.
2. 엔진 안쪽: 커널·병렬화·스케줄링
README의 기능 목록은 네 묶음으로 읽힌다. 커널, 병렬화, 추측 디코딩, 그리고 재현성이다.
커널 쪽은 DeepSeek이 그동안 따로 공개해온 것들이 한자리에 모였다. FlashMLA, DeepGEMM, DeepEP, TileKernels, DeepSelect에 더해 자체 TileLang 커널이 deepinfer/model_executor/layers/tilelang_ops에 들어 있다.
병렬화는 Attention DP(어텐션 데이터 병렬)와 balanced CP(컨텍스트 병렬), MoE 쪽은 EP(전문가 병렬) + EPLB(전문가 배치 균형)다. MoE 모델 서빙에서 전문가 간 부하 쏠림이 처리량을 깎는 문제를 저장소 안에서 다루고 있다는 점이 눈에 띈다.
스케줄링은 비동기 방식이고 기본 활성이다. README는 CPU의 배치 스케줄링을 디바이스 실행과 겹치게 돌리는 zero-overhead batch scheduler라고 설명한다. 별도 플래그가 필요 없다.
3. 환경변수로 조절되는 기능들
눈에 띄는 건 상당수 기능이 플래그가 아니라 환경변수로 켜진다는 점이다. README에 적힌 값을 그대로 정리하면 다음과 같다.
# DSpark 추측 디코딩 (초안 최대 길이 기본값 5)
export DEEPINFER_ENABLE_MTP_VARLEN=1
export DEEPINFER_USE_NEXTN_DECODE=5

# 디코더 SWA bounded replay — V4.1 기본 설정
export DEEPINFER_YOCO_PREFILL_TRUNCATION_MODE=compact
export DEEPINFER_YOCO_PREFILL_KEEP_TOKENS=140

# batch-invariant 추론 (NVIDIA 전용)
export DEEPINFER_BATCH_INVARIANT=1
출처: https://github.com/deepseek-ai/DeepInfer (README, Features) — 변수명·기본값은 README 기재 그대로
DEEPINFER_YOCO_PREFILL_KEEP_TOKENS에는 README가 직접 단서를 달아뒀다. 남기는 접미 구간이 SWA(sliding window attention) 윈도우와 최대 백트래킹 길이를 모두 덮어야 한다는 조건이다. 값을 임의로 줄이면 품질이 아니라 정확성이 깨질 수 있는 설정이라는 의미로 읽힌다.
결정적 샘플링은 환경변수 두 개와 호출 측 시드가 함께 필요하다. README는 DEEPINFER_BATCH_INVARIANT=1 DEEPINFER_ENABLE_MTP_VARLEN=0을 설정하고 SamplingParams에 고정 seq_seed를 넘기라고 적었다. 추측 디코딩을 끄는 쪽이 조건에 포함돼 있다는 점이 중요하다. 재현성과 DSpark는 동시에 가져갈 수 없다. 그리고 batch-invariant와 결정적 샘플링은 둘 다 NVIDIA 전용이다. Ascend에서는 재현성 보장을 기대할 수 없다.
구조화 출력은 정규식, JSON 스키마, EBNF 문법 세 가지를 지원한다. README가 제시하는 호출 형태는 샘플링 파라미터에 인자를 얹는 방식이다.
# README 기재 형태 — 상세 예제는 examples/_structured_output.py 참조
SamplingParams(
    so_args={"schema_type": ..., "schema": ...},
)
출처: https://github.com/deepseek-ai/DeepInfer (README, Structured outputs). 위 생략 부호는 README 표기 그대로이며 실제 값은 저장소 예제 파일 참조.
4. 빠진 조각이 설계 의도를 말해준다
README의 "Required for a complete inference service (not included in this release)" 항목이 이번 공개의 경계선이다.
| 빠진 구성 | 무엇인가 | 운영 관점 영향 |
|---|---|---|
| KV 캐시 시스템 | 생성 중 재사용하는 키·값 캐시의 클러스터 단위 관리 계층 | 멀티턴·장문 컨텍스트 재사용 최적화를 직접 설계해야 함 |
| VE/Prefill/Decode 분리 | 프롬프트 처리와 토큰 생성을 다른 장비에 나누는 구조 | README는 "엔진 쪽 필요 기능은 대부분 이미 구현됨"이라 밝힘 — 오케스트레이션은 운영자 몫 |
| DP 복제본 간 로드밸런싱 | prefill·decode 양쪽 데이터 병렬 복제본 사이 요청 분배 | 앞단 라우팅 계층을 별도로 붙여야 함 |
SiliconANGLE은 DeepSeek이 KV 캐시 관리와 로드밸런싱 코드를 내부 인프라와 강하게 결합돼 있다는 이유로 공개하지 않았다고 전했다. 공개된 건 엔진이고, 서비스가 되려면 그 앞뒤가 필요하다. 함께 공개된 deepseek-recipe는 요청을 DeepSeek 공식 API와 동일한 방식으로 토큰 시퀀스로 바꿔주는 라이브러리인데, 이것도 서빙 계층이 아니라 입력 정규화 도구다.
5. 성능 숫자: README에는 그래프만 있다
README 본문에는 수치가 없다. Pareto 그래프 두 장(prefill은 비캐시 입력 처리량 대 지연, decode는 출력 처리량 대 사용자당 속도)과 측정 환경 한 줄이 전부다. "prefill은 SM100 4장, decode는 64장에서 측정, 각각 하나의 scale-up 도메인 내"다. 재현 스크립트로 examples/sweep/run_sweep.sh를 안내하고, 비교 기준선은 본문에 명시되지 않았다.
수치는 기사 쪽에서 나온다. 전부 DeepSeek 측 설명·추정이고, 독립 벤치마크는 아직 없다(TNW 명시).
| 수치 | 내용 | 성격 |
|---|---|---|
| 약 30% | confidence head가 매 스텝 검증 대상 초안 토큰 수를 줄이는 폭 | DeepSeek 설명 (SiliconANGLE) |
| 4~7% | 자사 프로덕션 부하 기준 처리량 향상 추정 | DeepSeek 추정 (SiliconANGLE) |
| "거의 절반" | 프롬프트 뒤쪽 일부 토큰만 디코더 레이어에 통과시켜 줄인 prefill 연산량 | DeepSeek 주장 (SiliconANGLE) |
| 155조 토큰/일 · GPU시간당 $38 | 클러스터 처리량과 오프피크 단가 기준 환산 | 확인 필요 — 환산 주체가 기사에 불명확 |
상충도 두 건 짚어둔다. 첫째, SiliconANGLE은 DeepSeek이 효율적이라 보는 최소 배포를 prefill 64장 + decode 64장으로 전했는데 README 벤치마크 환경은 prefill 4장이다. 서로 다른 구성이다. 둘째, prefill 축약 토큰 수가 README는 140(V4.1 기본 설정), SiliconANGLE 기사는 "마지막 128 토큰"으로 엇갈린다. 설정값을 쓸 거라면 README를 따르는 쪽이 안전하다.
6. vLLM과의 관계
README의 Acknowledgments가 가장 솔직한 대목이다. DeepInfer는 "주로 vLLM 위에 구축됐고, SGLang과 TensorRT-LLM에서도 영감을 받았다"고 적혀 있다. SiliconANGLE은 2025년 4월 DeepSeek이 자사 엔진을 "vLLM의 초기 포크"라고 설명한 적이 있다고 전했다. 포크가 3년 가까이 사내에서 따로 자라 다시 열린 형태다.
vLLM 프로젝트는 X에서 DeepSeek에 감사를 표하고, DeepInfer의 아이디어를 참고해 자사 V4.1-Flash 지원을 개선하겠다고 밝혔다(TNW). 직접 DeepInfer를 운영하지 않는 쪽에도 이 공개가 닿는 경로는 여기다. 저장소 반응 자체는 빨랐다. TNW는 10월 20일 오후 스타 8,000개 이상이라고 보도했고, 2026년 10월 21일 확인 시점에는 12.4k, 포크 1.1k, 열린 PR 93건이다. 반면 main 브랜치 커밋은 3개뿐이고 릴리스·태그는 비어 있다. 히스토리를 정리해 한 번에 올린 공개라는 뜻이다.
인용이 필요하면 README가 BibTeX를 제공한다.
@misc{deepinfer2026,
  title = {DeepInfer: High-performance, large-scale inference framework for DeepSeek models},
  author = {DeepSeek-AI},
  year = {2026},
  publisher = {GitHub},
  howpublished = {\url{https://github.com/deepseek-ai/DeepInfer}},
}
함께 보면 좋은 글
DeepInfer가 유일하게 지원하는 모델이 DeepSeek-V4.1-Flash다. 그 1017 체크포인트와 피크·오프피크 단가 구조는 앞선 글에서 정리했다. → deepseek-flash 1017 체크포인트와 Search·Fetch API — 11월 1일부터 요청당 과금이 시작된다
자주 묻는 질문
DeepInfer vs vLLM, 뭘 써야 하나?
현재 공개 범위로는 비교 대상이 아니다. DeepInfer는 모델이 DeepSeek-V4.1-Flash 하나, 하드웨어가 SM100·Ascend 950 두 종류이며 KV 캐시 시스템과 로드밸런싱이 빠져 있다. README도 DeepInfer가 vLLM 위에 구축됐다고 밝히고 있고, vLLM 쪽은 DeepInfer의 아이디어를 자사 지원 개선에 반영하겠다고 했다.
H100에서 DeepInfer를 돌릴 수 있나?
README가 명시한 지원 하드웨어는 NVIDIA SM100 GPU와 Huawei Ascend 950 NPU뿐이다. SiliconANGLE은 Hopper 등 이전 아키텍처가 목록에 없다고 짚었다. 그 외 가속기 동작 여부는 공식 문서에 언급이 없어 확인 필요하다.
출력이 매번 같아야 하는 서비스에 쓸 수 있나?
batch-invariant 추론과 결정적 샘플링을 제공하지만 조건이 있다. 둘 다 NVIDIA 전용이고, 결정적 샘플링은 DEEPINFER_ENABLE_MTP_VARLEN=0으로 추측 디코딩을 끈 상태에서 SamplingParams에 고정 seq_seed를 넘겨야 한다. 재현성과 DSpark는 동시에 켤 수 없다.
마무리
이번 공개는 "바로 띄울 수 있는 서빙 스택"이 아니라 "프로덕션에서 돌던 엔진의 내부 구현"이다. 하드웨어와 모델 축이 좁아 직접 운영 대상이 될 조직은 제한적이지만, 추측 디코딩의 confidence head 설계, SWA bounded replay의 유지 토큰 조건, EPLB 같은 선택을 코드와 환경변수 수준에서 읽을 수 있게 됐다. 성능 수치는 전부 자사 발표라는 전제를 붙이고, 환경변수 기본값은 README를 1차 기준으로 두는 게 안전하다.
출처
- GitHub, DeepInfer 저장소 README (1차 출처): https://github.com/deepseek-ai/DeepInfer
- SiliconANGLE, 2026-10-20: https://siliconangle.com/2026/10/20/deepseek-open-sources-deepinfer-the-inference-framework-behind-its-production-services/
- The Next Web, 2026-10-20: https://thenextweb.com/news/deepseek-deepinfer-open-source-inference-engine
본 글은 공개 자료를 바탕으로 정리했으며, 세부 내용·수치는 원 출처·공식 문서와 대조 확인을 권장합니다. 본문의 성능·처리량 수치는 모두 DeepSeek의 자사 발표 또는 추정이며 독립 검증 결과가 아닙니다.