안녕하세요, 미니지식공간입니다.
gemini-3.5-transcribe는 파라미터 하나를 켜는 순간 다른 파라미터가 막히는 모델이다. Gemini 3.5 Transcribe API를 공식 문서 기준으로 뜯어보면, 성능 수치보다 transcription_config의 조합 제약이 설계에 훨씬 큰 영향을 준다. 2026년 8월 26일 공개 프리뷰로 나온 이 모델을 개발자 관점에서 정리한다.
먼저 결론
- 모델 ID는 두 개다.
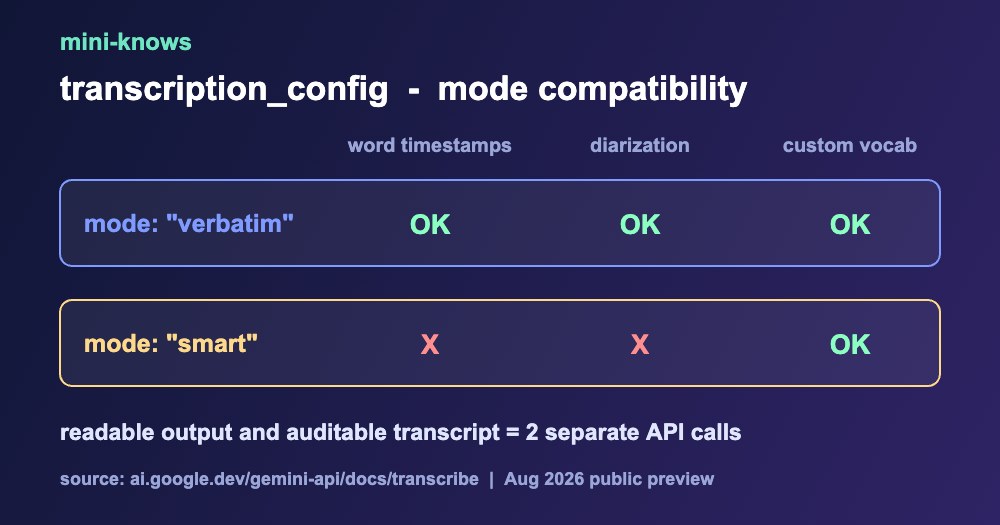
gemini-3.5-transcribe(Interactions API, 파일)와gemini-3.5-transcribe-live(Live API, 스트리밍). SDK 호출 경로부터 다르다. mode: "smart"는timestamp_granularities,diarization_mode와 동시 사용이 불가능하다. 읽기용 결과와 감사용 원문은 호출 2회로 분리된다.- 과금은 오디오 초당 25토큰, 텍스트 분당 175토큰이 환산 기준이다. 이 값을 알면 청구서를 직접 계산할 수 있다.
두 엔드포인트가 왜 갈렸나
구글 공식 블로그(2026-08-26)는 이 모델을 "두 개의 별도 API로 제공(available across two separate APIs)"이라고 명시했다. 실시간 스트리밍은 Live API의 gemini-3.5-transcribe-live, 사전 녹음 처리는 Interactions API의 gemini-3.5-transcribe다. 이름이 이어져 있지만 기능 집합·한도·단가가 전부 다르므로, 통합 추상화 레이어를 먼저 만들고 나중에 모델만 바꾸는 접근은 여기서 깨진다.
| 제약 | live | unary |
|---|---|---|
| 최대 길이 | 세션당 10분 | 파일 1시간 |
| diarization·timestamps 활성 시 | 미지원 | 30분으로 축소 |
| 화자 분리 | 미지원 | 지원 |
| 단어 타임스탬프 | 미지원 | 지원 |
| custom vocabulary | 최대 1,000개 | 최대 1,000개 |
| 오디오 입력 형식 | 16kHz mono 16-bit PCM, 100ms 청크 | Files API 업로드 URI |
Live API 쪽은 발화 중 추정치를 interim_input_transcription으로, 턴이 끝나면 input_transcription으로 내보낸다. VAD(Voice Activity Detection, 음성 구간 검출)는 자동·하이브리드·수동을 지원하고, 모바일·웹 클라이언트가 API 키를 들고 있지 않아도 되도록 임시 토큰(ephemeral token) 경로를 제공한다.
기본 호출
아래 코드는 모두 공식 문서 Audio transcription의 예제를 그대로 가져온 것이다. 문서에 없는 코드는 쓰지 않았다.
from google import genai

client = genai.Client()

audio_file = client.files.upload(file="path/to/sample.mp3")

interaction = client.interactions.create(
    model="gemini-3.5-transcribe",
    input=[
        {
            "type": "audio",
            "uri": audio_file.uri,
            "mime_type": audio_file.mime_type,
        }
    ],
)

print(interaction.output_text)generate_content가 아니라 interactions.create다. 기존 Gemini 코드베이스에서 그대로 옮겨 붙이면 여기서 먼저 막힌다. 결과 전문은 interaction.output_text에 들어온다.
transcription_config 파라미터
전사 옵션은 generation_config.transcription_config 아래에 모인다. 공식 문서의 파라미터 레퍼런스는 다음과 같다.
| 필드 | 타입 | 설명 |
|---|---|---|
language_codes | string 배열 | BCP-47 코드. 생략하거나 []이면 자동 감지 + 코드 스위칭 처리 |
custom_vocabulary | string 배열 | 최대 1,000개. 인식 편향용 |
mode | object 또는 string | "smart" 또는 {"type": "verbatim", ...}. 기본은 verbatim |
mode.timestamp_granularities | string 배열 | verbatim 전용. ["word"] |
mode.diarization_mode | string | verbatim 전용. "speaker" |
화자 분리와 단어 타임스탬프를 함께 켜는 경우는 이렇게 된다.
generation_config = {
    "transcription_config": {
        "custom_vocabulary": ["Gemini"],
        "mode": {
            "type": "verbatim",
            "diarization_mode": "speaker",
            "timestamp_granularities": ["word"],
        },
    }
}
smart 모드는 왜 따로 가야 하나
mode가 문자열 "smart"일 때와 객체 {"type": "verbatim", ...}일 때 사용할 수 있는 옵션이 갈린다. 공식 문서는 Smart transcription이 timestamp_granularities 또는 diarization_mode와 결합할 수 없다고 못 박았다.
interaction = client.interactions.create(
    model="gemini-3.5-transcribe",
    input=[
        {
            "type": "audio",
            "uri": audio_file.uri,
            "mime_type": audio_file.mime_type,
        }
    ],
    generation_config={
        "transcription_config": {
            "mode": "smart",
        }
    },
)
print(interaction.output_text)
문서에 실린 동작 예시를 보면 차이가 분명하다. "Um, so for the meeting, I think we should, uh, invite Alice and, wait no, Bob and Carol."이라는 발화에 대해 verbatim은 군더더기를 포함한 원문을 그대로 돌려주고, smart는 자기 정정을 반영해 "For the meeting, I think we should invite Bob and Carol."을 반환한다. 항목 나열을 번호 목록으로 자동 정리하는 서식 처리도 smart 쪽에서만 일어난다.
설계상 의미는 명확하다. 사용자에게 보여줄 깔끔한 텍스트와, 분쟁 시 근거가 될 원문 타임스탬프 기록은 같은 응답에서 나올 수 없다. 둘 다 필요하면 같은 오디오에 대해 두 번 호출하고, 그만큼 과금도 두 배다.
워드 애노테이션 파싱
타임스탬프나 화자 분리를 켜면 결과가 output_text 외에 애노테이션으로 붙는다. 문서가 제시한 추출 코드는 다음과 같다.
def extract_word_annotations(interaction):
    words = []
    for step in getattr(interaction, "steps", []) or []:
        for content in getattr(step, "content", []) or []:
            for annotation in getattr(content, "annotations", []) or []:
                if getattr(annotation, "type", None) == "word_info":
                    words.append(annotation)
    return words

words = extract_word_annotations(interaction)

for w in words:
    speaker = f"[{w.speaker}] " if getattr(w, "speaker", None) else ""
    start = getattr(w, "start_offset", "")
    end = getattr(w, "end_offset", "")
    timing = f"({start} -> {end}) " if start and end else ""
    print(f"{speaker}{timing}{w.text}")
응답 구조는 steps[].content[].annotations[] 3단 중첩이고, 각 항목은 type: "word_info"에 text, speaker(spk_1 형태), start_offset, end_offset("0.100s" 같은 문자열)을 담는다. 오프셋이 숫자가 아니라 단위가 붙은 문자열이라는 점은 파싱할 때 걸리기 쉬운 부분이다.
단가를 직접 계산해 보기
공식 가격 페이지 기준이다.
| 모델 | 오디오 입력 / 1M | 텍스트 출력 / 1M | 혼합 환산 |
|---|---|---|---|
gemini-3.5-transcribe | $2.00 | $12.00 | 약 $0.005/분 |
gemini-3.5-transcribe-live | $3.50 | $21.00 | 약 $0.009/분 |
환산 기준은 오디오 입력 초당 25토큰, 텍스트 출력 분당 175토큰이다. 1시간짜리 오디오를 unary로 넣으면 이렇게 된다.
- 입력: 3,600초 × 25 = 90,000 토큰 → 0.09M × $2.00 = $0.180
- 출력: 60분 × 175 = 10,500 토큰 → 0.0105M × $12.00 = $0.126
- 합계 약 $0.306, 분당 약 $0.0051 → 문서의 "약 $0.005/분"과 일치한다.
같은 계산을 live에 적용하면 $0.315 + $0.2205 = 약 $0.536(분당 약 $0.0089)이다. 실시간이 대략 1.75배 비싸다. 주의할 점은 출력 토큰 단가가 입력의 6배라는 것이다. 발화 밀도가 높은 오디오는 분당 175토큰 가정을 넘길 수 있으므로, 콜센터처럼 말이 촘촘한 도메인에서는 실측 없이 이 환산값을 예산에 그대로 넣지 않는 편이 좋다.
성능 수치 (전부 구글 자사 발표)
아래는 구글이 발표한 값이며 제3자 독립 검증 결과가 아니다.
| 지표 | 스트리밍 | 비스트리밍 |
|---|---|---|
| 평균 WER (Artificial Analysis 측정, 구글 발표) | 4.0% | 2.6% |
| FLEURS 상위 언어·로케일 WER | 5.50% | 5.04% |
이전 모델 Chirp 3 대비 최종 전사까지의 시간이 70% 개선됐다는 것이 구글의 설명이다. 언어는 85개 이상 자동 감지하며 한국어는 ko-KR로 지원 목록에 있다. 다만 한국어 단독 WER은 공개되지 않았다.
상충되는 서술 한 가지
화자 수 한도가 자료마다 다르다. 구글 공식 블로그는 "최대 3명(3명 이상은 실험적)"으로 적었고, API 문서는 "최대 8명 지원(3명 이상 귀속은 실험적)"으로 적었다. 같은 날 나온 1차 자료끼리의 불일치이므로 확인 필요로 남겨 둔다. 4명 이상 화자를 전제로 파이프라인을 짜고 있다면 실측이 필요하다.
도입 전 체크리스트
- 호출 경로가
interactions.create인지 확인. 기존generate_content래퍼는 그대로 못 쓴다. - 화자 분리·타임스탬프를 켤 계획이면 입력 길이 상한이 1시간이 아니라 30분임을 전제로 분할 로직을 넣는다.
- live 세션 10분 상한에 대한 재연결·이어붙이기 전략을 먼저 설계한다.
- smart와 verbatim 중 무엇이 제품 요구사항인지 정하고, 둘 다면 2회 호출 비용을 예산에 반영한다.
custom_vocabulary는 1,000개까지 들어가지만 문서 권장은 100개 이하다. 일상어를 넣지 말고 고유명사·약어만 넣는다.- 무료 등급은 입력이 제품 개선에 사용된다고 약관에 명시돼 있다. 민감 오디오는 유료 등급 경로를 쓴다.
Live API 계열의 다른 오디오 모델을 함께 보면 구글의 오디오 스택이 어떻게 나뉘는지 파악하기 쉽다. → Gemini 3.5 Live Translate 개발자 관점 정리
자주 묻는 질문
Q. 기존 Gemini API 코드를 그대로 쓸 수 있나?
아니다. 전사는 client.interactions.create에 type: "audio" 입력을 넣는 Interactions API 경로를 쓴다. 전사 옵션도 generation_config.transcription_config 아래에 별도로 들어가므로 요청 조립부를 수정해야 한다.
Q. 실시간 스트리밍에서 화자를 나눌 수 있나?
없다. gemini-3.5-transcribe-live는 화자 분리와 단어 타임스탬프를 지원하지 않는다. 세션이 끝난 녹음을 gemini-3.5-transcribe로 다시 처리하는 2단 파이프라인이 필요하다.
Q. 자체 서버에 올려서 쓸 수 있나?
불가능하다. 오픈 웨이트가 공개되지 않았고 자체 호스팅 경로도 제공되지 않는다. Gemini API 또는 Gemini Enterprise Agent Platform을 통한 관리형 서비스 형태로만 쓸 수 있으며, 두 트랙 모두 아직 공개 프리뷰다.
마무리
Gemini 3.5 Transcribe에서 실제로 설계를 좌우하는 것은 WER 2.6%가 아니라 조합 제약이다. 실시간이면 화자 라벨을 포기해야 하고, 정리된 텍스트를 원하면 타임스탬프를 포기해야 하며, 둘 다 원하면 호출을 나눠야 한다. 도입 판단은 이 세 가지를 자기 요구사항에 대입해 본 다음에 하는 것이 순서다.
출처
- Google 공식 블로그, Intelligent transcription with Gemini 3.5 Transcribe (2026-08-26): https://blog.google/innovation-and-ai/models-and-research/gemini-models/gemini-3-5-transcribe/
- Gemini API 문서, Gemini 3.5 Transcribe 모델: https://ai.google.dev/gemini-api/docs/models/gemini-3.5-transcribe
- Gemini API 문서, Audio transcription (코드 스니펫 출처): https://ai.google.dev/gemini-api/docs/transcribe
- Gemini API 가격 페이지: https://ai.google.dev/gemini-api/docs/pricing
- MarkTechPost (2026-08-27): https://www.marktechpost.com/2026/08/27/google-ai-releases-gemini-3-5-transcribe-a-speech-to-text-model-reporting-2-6-average-wer-across-85-languages/
본 글은 공개 자료를 바탕으로 정리했으며, 세부 내용·수치는 원 출처·공식 문서와 대조 확인을 권장합니다. 성능 수치는 구글 자사 발표 기준으로 제3자 독립 검증 결과가 아닙니다. 코드 스니펫은 공식 문서 예제를 인용한 것이며, 가격·기능은 공개 프리뷰 단계에서 변경될 수 있습니다.