안녕하세요, 미니지식공간입니다.
Gemini 3.7 Flash 마이그레이션에서 가장 먼저 걸리는 지점은 벤치마크가 아니라 thinking_level이다. Gemini 3.7 Flash는 2026년 8월 13일 공개됐고, 3.6 Flash에서 쓰던 minimal 값을 더 이상 받지 않는다. 이 글은 API 문서와 모델 카드를 기준으로 스펙·파라미터 변경·토큰 단가를 정리한다.
결론부터
- 모델 ID
gemini-3.7-flash, stable. 3.6 Flash 기반의 알고리즘 개선판이며 새 사전학습이 아니다(모델 카드). thinking_level에서minimal이 빠졌다. 3.7 Flash는low/medium/high만 지원하고 기본값은medium이다.- 도입 단가 $0.75 / $3.75(1M 토큰, 입력/출력). 2026년 12월 31일 종료, 2027년 1월 1일부터 $1.50 / $7.50.
스펙 정리
| 항목 | 값 |
|---|---|
| 모델 ID | gemini-3.7-flash (stable) |
| 기반 모델 | Gemini 3.6 Flash (알고리즘 개선) |
| 입력 토큰 한도 | 1,048,576 |
| 출력 토큰 한도 | 65,536 |
| 입력 타입 | 텍스트, 이미지, 비디오, 오디오, PDF |
| 출력 타입 | 텍스트 |
| 지식 컷오프 | 2026년 3월 |
| thinking_level | low / medium / high (기본 medium, minimal 미지원) |
| 지원 기능 | 캐싱, 코드 실행, 함수 호출, 구조화 출력, 검색 그라운딩, URL 컨텍스트, 파일 검색 |
| 미지원 | 이미지 생성, Live API, 오디오 생성 |
| 소비 옵션 | Batch API, Flex inference, Priority inference |
컴퓨터 유즈(모델이 화면을 보고 UI를 조작하는 기능)는 프리뷰 단계로 표시돼 있다. 오픈 웨이트 배포는 없어 자체 호스팅 경로는 존재하지 않는다.
thinking_level: 마이그레이션 시 실제로 깨지는 부분
공식 thinking 문서의 모델별 지원 표를 보면 차이가 명확하다. gemini-3.6-flash는 minimal을 포함한 네 단계를 받았지만, gemini-3.7-flash는 세 단계만 받는다. 모델 문서는 3.7 Flash에서 minimal을 지정하면 오류를 반환한다고 명시한다.
| 모델 | 기본값 | 지원 레벨 |
|---|---|---|
gemini-3.7-flash | medium | low, medium, high |
gemini-3.6-flash | medium | minimal, low, medium, high |
gemini-3.5-flash-lite | minimal | minimal, low, medium, high |
즉 분류·단순 조회처럼 사고량을 최소로 눌러 두던 호출 경로가 있다면, 그대로 모델 ID만 바꾸면 실패한다. minimal → low로 올려야 하고, 그만큼 thought 토큰이 늘어난다.
아래는 공식 문서(ai.google.dev/gemini-api/docs/thinking)의 thinking_level 예제에서 model 값만 gemini-3.7-flash로 교체한 것이다.
from google import genai

client = genai.Client()

interaction = client.interactions.create(
    model="gemini-3.7-flash",
    input="Provide a list of 3 famous physicists and their key contributions",
    generation_config={
        "thinking_level": "low"
    }
)
print(interaction.output_text)
REST 형태도 동일한 문서에 있다.
curl -X POST "https://generativelanguage.googleapis.com/v1beta/interactions" \
  -H "x-goog-api-key: $GEMINI_API_KEY" \
  -H 'Content-Type: application/json' \
  -d '{
    "model": "gemini-3.7-flash",
    "input": "Provide a list of 3 famous physicists and their key contributions",
    "generation_config": {
      "thinking_level": "low"
    }
  }'
과금에서 놓치기 쉬운 부분: thought 토큰
thinking 문서는 "thinking이 켜져 있을 때 응답 과금은 출력 토큰과 사고 토큰의 합"이라고 못 박는다. 요약(summary)만 반환되더라도 과금은 모델이 실제로 생성한 전체 사고 토큰 기준이다. 따라서 단가표의 출력 $3.75만 보고 예산을 잡으면 실제 청구액과 벌어진다.
문서가 제공하는 사용량 필드를 그대로 찍어 보는 편이 빠르다.
print("Thoughts tokens:", interaction.usage.total_thought_tokens)
print("Output tokens:", interaction.usage.total_output_tokens)
스트리밍 응답의 interaction.completed 이벤트에도 동일한 값이 실린다. 문서 예시 기준으로 usage 객체는 total_tokens, total_input_tokens, total_output_tokens, total_thought_tokens 네 필드를 갖는다. 기본값이 medium이므로, 별도 설정 없이 붙이면 사고 토큰이 기본으로 계상된다는 점을 전제해야 한다.
단가 계산
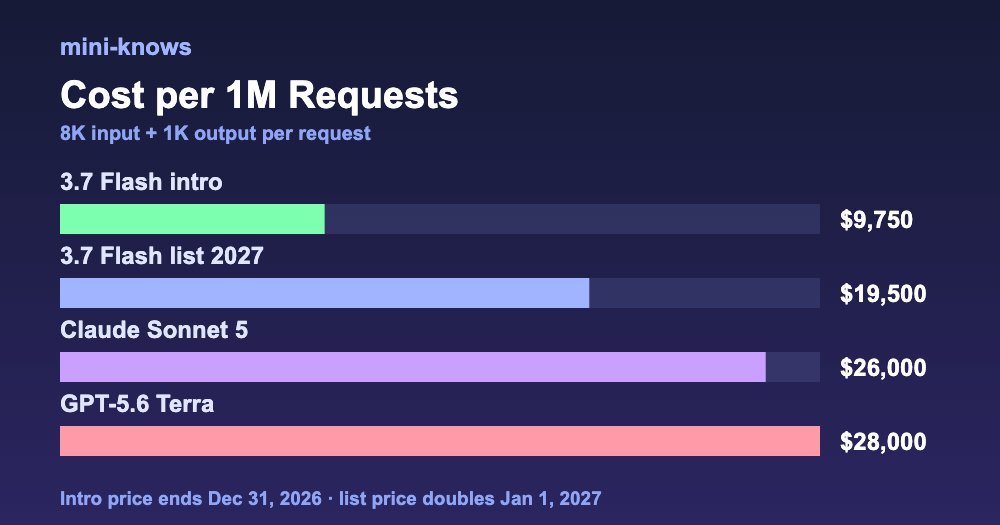
100만 요청 기준으로 환산하면 감이 잡힌다. 요청당 입력 8,000토큰 / 출력 1,000토큰(사고 토큰 포함 가정)이라고 두면 총 입력 80억 토큰, 총 출력 10억 토큰이다.
| 구성 | 입력 단가 | 출력 단가 | 100만 요청 비용 |
|---|---|---|---|
| 3.7 Flash 도입가 (~2026-12-31) | $0.75 | $3.75 | $9,750 |
| 3.7 Flash 정가 (2027-01-01~) | $1.50 | $7.50 | $19,500 |
| Claude Sonnet 5 | $2.00 | $10.00 | $26,000 |
| GPT-5.6 Terra | $2.00 | $12.00 | $28,000 |
경쟁 모델 단가는 구글이 자사 모델 카드 비교표에 기재한 값이므로, 실제 도입 전에는 각 사 공식 가격표와 대조하는 편이 안전하다. 도입가와 정가의 차이가 정확히 2배라는 점이 중요하다. 연말을 넘겨 운영할 서비스라면 $19,500 쪽 숫자로 손익을 검증해야 한다.
벤치마크: 어디가 오르고 어디가 내렸나
전부 구글 자사 발표 수치이며 제3자 독립 검증이 아니다.
| 벤치마크 | 3.7 Flash | 3.6 Flash | GPT-5.6 Terra |
|---|---|---|---|
| FrontierCode 1.1 Main | 43.6% | 34.4% | 41.3% |
| DeepSWE v1.1 | 65.3% | 48.6% | 69.6% |
| Code Arena (Elo) | 1588 | 1538 | 1523 |
| Terminal-bench 2.1 | 85.8% | 78.0% | 87.4% |
| Terminal-bench 3.0 | 14.9% | 5.4% | 20.8% |
| AutomationBench | 30.4% | 17.0% | 23.6% |
| GDP.pdf | 34.0% | 22.0% | 24.7% |
| GDM-MRCR v2 (128k) | 97.0% | 91.8% | 93.5% |
| OSWorld-2.0 | 47.9% | 33.8% | 50.2% |
| CharXiv Reasoning (도구 없음) | 84.5% | 85.2% | 85.9% |
읽는 방식은 두 갈래다. 코드 품질(FrontierCode)·웹 개발(Code Arena)·엔터프라이즈 자동화(AutomationBench)·문서 이해(GDP.pdf)에서는 3.7 Flash가 GPT-5.6 Terra까지 앞선다. 반대로 터미널 에이전트와 컴퓨터 유즈 계열(Terminal-bench, OSWorld-2.0)은 여전히 GPT-5.6 Terra가 우위다. CharXiv Reasoning은 3.6 Flash 대비 소폭 하락한 회귀 항목이다.
한 가지 상충이 있다. DeepSWE v1.1의 3.6 Flash 점수가 모델 카드에는 48.6%, 공식 블로그 본문에는 49.0%로 다르게 적혀 있다. 같은 날 공개된 두 자료 사이의 불일치라 어느 쪽이 최종 수치인지는 확인이 필요하다.
종합 지표인 Artificial Analysis Intelligence Index에서는 3.7 Flash가 56점, GPT-5.6 Terra와 Muse Spark 1.2가 각각 57점이다. 절대 성능 1위를 다투는 위치는 아니다.
마이그레이션 체크리스트
thinking_level="minimal"을 쓰는 호출 경로를 전수 조사한다. 3.7 Flash에서는 오류다.minimal→low전환 후total_thought_tokens증가폭을 측정한다. 단가는 내려가도 사고 토큰이 늘면 상쇄될 수 있다.- 이미지 생성·Live API에 3.6 Flash를 쓰던 경로가 있는지 확인한다. 3.7 Flash는 두 기능을 지원하지 않는다.
- 지식 컷오프가 2026년 3월이므로, 최신 정보가 필요한 경로는 검색 그라운딩이나 URL 컨텍스트로 보완한다.
- 2027년 1월 정가 전환 시점을 예산 캘린더에 표시한다.
스테이트리스 모드로 대화 상태를 직접 관리한다면 thought 블록과 서명(signature)을 그대로 재전송해야 한다는 규칙도 그대로 적용된다. 문서는 모델을 바꿔도 이전 모델의 thought 블록을 재전송하라고 안내한다. 3.6 → 3.7 전환 중 세션이 걸쳐 있는 경우 특히 유의할 부분이다.
관전 포인트
3.5 → 3.6 → 3.7 Flash로 이어지는 릴리스 간격이 3주 수준으로 좁혀졌다. 모델 ID를 코드에 고정해 두는 팀에게는 마이그레이션 비용이 반복 발생한다는 뜻이다. 3.6 Flash의 토큰 효율 개선을 다뤘던 이전 글과 비교해 보면, 이번에는 효율보다 단가와 코딩 성능 쪽으로 강조점이 옮겨 갔다.
자주 묻는 질문
Q. Gemini 3.7 Flash에서 thinking_level="minimal"을 쓰면 어떻게 되나?
공식 모델 문서는 minimal이 지원되지 않으며 오류를 반환한다고 명시한다. low가 가장 낮은 단계다. 3.6 Flash는 minimal을 지원했으므로 모델 ID만 교체하는 방식은 안전하지 않다.
Q. 기존 API 코드 수정이 필요한가?
thinking_level 값과 이미지 생성·Live API 사용 여부만 확인하면 나머지 호출 구조는 동일하다. 캐싱, 함수 호출, 구조화 출력, 배치·Flex·Priority 추론 모두 지원된다.
Q. Gemini 3.7 Flash 가격이 정가로 바뀌면 얼마인가?
2027년 1월 1일부터 입력 $1.50 / 출력 $7.50(1M 토큰)이다. 도입가의 정확히 2배이며, 구글 공식 블로그 각주와 모델 카드 각주 양쪽에 동일하게 기재돼 있다.
마무리
Gemini 3.7 Flash는 성능 도약보다 단가 대비 성능을 노린 릴리스에 가깝다. 코딩과 문서 처리 개선 폭은 실제로 크지만, 터미널·컴퓨터 유즈 계열은 상위 모델이 여전히 앞선다. 도입 검토 시 확인할 값은 두 개다. thinking_level의 minimal 삭제, 그리고 2026년 12월 31일이라는 도입가 만료일이다.
출처
- Introducing Gemini 3.7 Flash — Google 공식 블로그 (2026-08-13)
- Gemini 3.7 Flash 모델 카드 — Google DeepMind (2026-08-13)
- Gemini 3.7 Flash 모델 문서 — Google AI for Developers
- Gemini thinking 문서 — 코드 스니펫 출처
본 글은 공개 자료를 바탕으로 정리했으며, 세부 내용·수치는 원 출처·공식 문서와 대조 확인을 권장합니다. 성능 수치는 모두 구글 자사 발표 기준이며 제3자 독립 검증 결과가 아닙니다.