안녕하세요, 미니지식공간입니다.
GPT-5.6 Luna 가격이 80% 내려가면서 OpenAI API 요금 계산이 완전히 달라졌습니다. 이 글은 2026년 7월 30일 인하된 GPT-5.6 단가를 모델 문서 스펙과 함께 놓고, 실제 요청 단위 비용과 호출 코드가 어떻게 바뀌는지 개발자 관점에서 뜯어봅니다.
먼저 결론
- 2026년 7월 30일부터
gpt-5.6-luna는 100만 토큰당 입력 $0.20·출력 $1.20,gpt-5.6-terra는 $2.00·$12.00이다. - 모델 ID·요청 스키마는 그대로다. 마이그레이션 작업 없이 단가만 바뀐다.
- 우선 처리(Priority Processing)는 Fast 모드로 대체됐고,
service_tier="priority"로 보내던 요청은 하위 호환으로 계속 동작한다.
단가 변화
| 모델 | 인하 전 입력/출력 (1M) | 인하 후 입력/출력 (1M) | 변화 |
|---|---|---|---|
gpt-5.6-luna | $1.00 / $6.00 | $0.20 / $1.20 | -80% |
gpt-5.6-terra | $2.50 / $15.00 | $2.00 / $12.00 | -20% |
gpt-5.6-sol | $5.00 / $30.00 | 변동 없음 | - |
인하 전 단가는 OpenAI 모델 문서 기재값, 2026년 6월 26일 GPT-5.6 공개 당시 발표값, MLQ.ai 보도가 모두 일치한다. Sol은 이번 공식 글에 "변동 없음"으로만 적혀 있고 금액은 명시되지 않았다.
한 가지 주의점이 있다. 이 글을 쓰는 2026년 8월 1일(KST) 기준 Luna 모델 문서 페이지에는 아직 종전 단가 $1.00/$6.00이 표시돼 있다. 문서 반영에 시차가 있는 것으로 보이며, 실제 청구 단가는 요금 페이지와 사용량 대시보드로 확인하는 편이 안전하다.
요청 단위로 환산하면
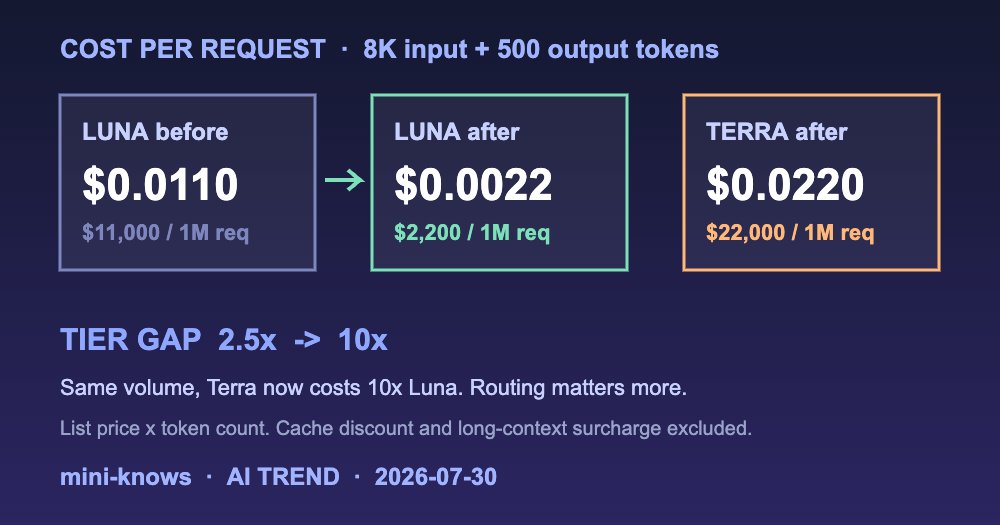
단가표보다 요청 단위 계산이 체감이 빠르다. 프롬프트 8,000 토큰, 출력 500 토큰인 전형적인 에이전트 스텝을 가정한다.
| 구성 | 요청당 비용 | 100만 요청 기준 |
|---|---|---|
| Luna (인하 전) | $0.011 | $11,000 |
| Luna (인하 후) | $0.0022 | $2,200 |
| Terra (인하 후) | $0.022 | $22,000 |
숫자에서 읽어야 할 건 80%라는 인하폭이 아니라 마지막 두 줄의 격차다. 인하 후 Terra는 Luna의 정확히 10배다. 인하 전에는 2.5배였다. 티어를 한 칸 내렸을 때 아끼는 금액이 네 배로 커졌다는 뜻이고, 라우팅 설계를 다시 볼 이유는 여기서 나온다.
(위 계산은 공개 단가에 토큰 수를 곱한 값이며 캐시 할인·할증은 제외했다.)
모델 문서에서 같이 봐야 할 스펙
단가만 보고 예산을 짜면 어긋난다. Luna 모델 문서에 명시된 과금 관련 조건은 다음과 같다.
- 컨텍스트 윈도우 1,050,000 토큰, 최대 출력 128,000 토큰, 지식 컷오프 2026년 2월 16일
- 입력 토큰이 272K를 넘는 요청은 요청 전체에 입력 2배·출력 1.5배 단가가 적용된다
- 캐시 쓰기는 비캐시 입력 단가의 1.25배로 과금된다
- 엔드포인트는
v1/responses,v1/chat/completions등을 지원하며 추론 토큰(reasoning token)을 지원한다 - 파인튜닝은 미지원
롱컨텍스트 할증은 특히 신경 쓸 부분이다. 272K를 넘기는 순간 입력이 두 배가 되므로, 문서 전체를 매번 밀어 넣는 RAG 구성이라면 인하 효과가 상쇄될 수 있다. 캐시 입력 단가는 문서상 $0.10로 적혀 있으나 이는 종전 단가 기준 값이라, 인하 후 캐시 단가가 같은 비율로 조정됐는지는 확인 필요하다.
호출 코드
모델 ID만 바꾸면 된다. 아래는 공식 텍스트 생성 가이드의 Responses API 예제에서 model 값을 문서에 기재된 gpt-5.6-luna로 교체한 것이다(문서에 없는 코드는 만들지 않았다).
from openai import OpenAI

client = OpenAI()

response = client.responses.create(
    model="gpt-5.6-luna",
    reasoning={"effort": "low"},
    instructions="Talk like a pirate.",
    input="Are semicolons optional in JavaScript?",
)

print(response.output_text)
curl "https://api.openai.com/v1/responses" \
-H "Content-Type: application/json" \
-H "Authorization: Bearer $OPENAI_API_KEY" \
-d '{
"model": "gpt-5.6-luna",
"reasoning": {"effort": "low"},
"input": "Are semicolons optional in JavaScript?"
}'instructions는 input보다 우선순위가 높은 지시로 처리되며, previous_response_id로 대화 상태를 이어갈 때 이전 턴의 instructions는 컨텍스트에 남지 않는다. 이 점은 인하와 무관하지만 저비용 모델로 내릴 때 프롬프트를 재구성하며 자주 밟는 함정이다.
Fast 모드와 service_tier
OpenAI 발표에 따르면 API의 우선 처리는 Fast 모드로 대체됐다. GPT-5.6 Sol 기준 표준 처리 대비 최대 2.5배 속도를 두 배 가격에 제공하고, 지능에는 변화가 없다. 하위 호환이 명시돼 있어 priority로 태깅된 기존 요청은 자동으로 Fast 모드를 탄다.
파라미터 자체는 우선 처리 가이드에 기재된 형태를 그대로 쓰면 된다.
from openai import OpenAI

client = OpenAI()

response = client.responses.create(
    model="gpt-5.5",
    input="What does 'fit check for my napalm era' mean?",
    service_tier="priority"
)
print(response)
가이드 문서에는 아직 "Fast 모드"라는 명칭이 반영돼 있지 않고 Priority processing으로 서술돼 있다. 문서에 기재된 운영상 주의점 두 가지는 그대로 유효하다. 첫째, 응답 객체의 service_tier 필드로 실제 어떤 티어로 처리됐는지 확인할 수 있다. 둘째, 트래픽이 급증하면 램프 레이트 제한에 걸려 일부 요청이 표준으로 강등되고 표준 요금으로 청구되며, 이때 service_tier는 "default"로 내려온다.
라우팅을 다시 짤 근거
OpenAI는 공식 글에서 코딩 워크플로우 예시를 든다. 불확실성 해소와 계획 수립은 Sol에 맡기고, 명세가 확정된 변경 구현·테스트 작성 및 실행·결과 평가는 Luna에 맡기는 구성이다. 인하 전에도 가능했던 설계지만, Terra 대비 10배 격차가 생긴 지금은 절감 폭이 달라진다.
실무에서 이 분할이 성립하는지는 결국 평가로 확인해야 한다. 프로덕션 트래픽 샘플로 Luna와 Terra의 출력을 같은 기준에 놓고 채점한 뒤, 품질 손실이 허용 범위 안이면 내리는 식이다. 인용된 도입 사례들도 같은 방향이다. OpenAI 공식 글에 실린 Blitzy CTO는 Luna 전환 뒤 프롬프트 캐시 재사용률이 24%에서 90%로 올랐고 GPT-5.4 mini 대비 비용이 87% 낮아졌다고 밝혔다. Dust는 이전 기본 모델 대비 40% 빠르고 40% 저렴하다고 했다. 모두 각 기업이 밝힌 자체 측정값이다.
인하 배경에 대한 두 가지 설명
OpenAI는 효율 개선을 이유로 든다. 사람이 주도하는 절차 안에서 Sol이 프로덕션 커널을 자율적으로 재작성·최적화하고 토큰 생성 개선 실험을 수백 건 수행했으며, 그 결과 서빙 종단 간 비용이 20% 감소하고 토큰 생성 효율이 15% 이상 개선됐다는 것이다. 전부 OpenAI 자사 발표이고 제3자 검증은 공개되지 않았다.
시장 요인도 보도된다. MLQ.ai는 CNBC 조사를 인용해 오픈라우터(OpenRouter)에서 중국계 모델이 미국 기업 토큰 사용량의 46%를 차지했다고 전했고, 인하 당일 딥시크가 V4를 공개했다는 점도 함께 짚었다. 공식 발표문에 경쟁 언급이 없다는 사실과 이 보도는 서로 모순되지 않으며, 어느 쪽이 결정적이었는지는 확인할 방법이 없다.
자주 묻는 질문
Q. 기존 API 코드 수정이 필요한가?
필요 없다. 모델 ID와 요청 스키마는 그대로이고 단가만 바뀐다. service_tier="priority"로 보내던 요청도 하위 호환이 명시돼 있어 그대로 동작하며 Fast 모드로 처리된다.
Q. gpt-5.6-luna는 컨텍스트를 얼마나 받나?
모델 문서 기준 컨텍스트 윈도우 1,050,000 토큰, 최대 출력 128,000 토큰이다. 다만 입력이 272K를 넘으면 해당 요청 전체에 입력 2배·출력 1.5배 단가가 적용되므로, 롱컨텍스트를 상시로 쓰는 구성이라면 실효 단가를 따로 계산해야 한다.
Q. Sol도 싸졌나?
아니다. 공식 발표에서 인하 대상은 Luna와 Terra뿐이고 Sol은 변동 없음으로 명시됐다. Sol 쪽 변화는 가격이 아니라 Fast 모드 도입이다.
마무리
이번 조정에서 실제로 바뀐 건 단가 한 줄이 아니라 티어 간 거리다. Terra와 Luna의 격차가 2.5배에서 10배로 벌어졌고, 그만큼 "이 단계는 더 싼 모델로 내려도 되는가"라는 질문의 값어치가 커졌다. 답은 벤더 발표가 아니라 각자의 평가 세트에 있다.
같은 시기 구글 쪽 저비용 티어의 가격·토큰 효율 변화는 Gemini 3.6 Flash 토큰 효율과 API 비용 정리에 정리해 두었으니 비교해 보시면 도움이 됩니다. 오늘도 미니지식공간을 찾아 주셔서 감사합니다.
출처
- OpenAI, "Advancing the price-performance frontier with GPT-5.6" (2026-07-30) — https://openai.com/index/advancing-the-price-performance-frontier-with-gpt-5-6/
- MLQ.ai (2026-07-31) — https://mlq.ai/news/openai-slashes-gpt-56-luna-prices-80-undercutting-deepseek-as-ai-price-war-intensifies/
- Quartz (2026-07-30) — https://qz.com/openai-price-cuts-gpt-luna-terra-073026
- OpenAI API 문서, GPT-5.6 Luna — https://developers.openai.com/api/docs/models/gpt-5.6-luna
- OpenAI API 문서, Text generation / Priority processing — https://developers.openai.com/api/docs/guides/text
본 글은 공개 자료를 바탕으로 정리했으며, 세부 내용·수치는 원 출처·공식 문서와 대조 확인을 권장합니다. 성능·효율 관련 수치는 별도 표기가 없는 한 발표 주체의 자사 측정값입니다.