안녕하세요, 미니지식공간입니다. Voxtral 3는 Mistral AI가 2026년 10월 20일 공개한 음성 모델군이고, 모델 ID 기준으로 voxtral-mini-transcribe-3-0부터 voxtral-mini-tts-realtime-3-0까지 다섯 개가 한 번에 올라왔다. 이 글은 Voxtral 3 가격표와 공식 문서의 요청 한도, 그리고 LiveKit 기반 음성 에이전트 SDK 구조를 API를 붙이는 쪽 관점에서 정리한 것이다.
TL;DR
- 2026-10-20 발표. 공식 문서 기준 5종(STT 3 + TTS 2). 배치 전사
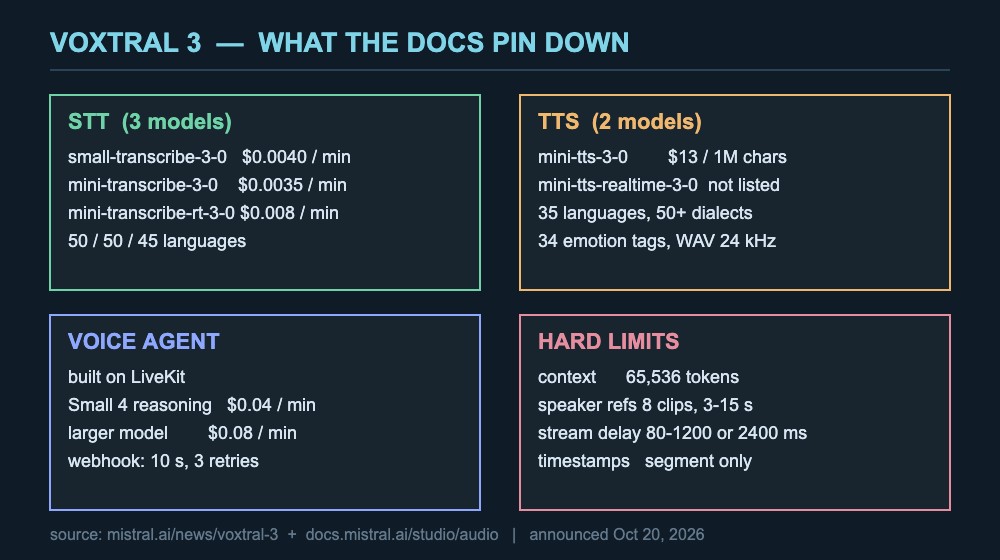
$0.0035/min, 실시간 전사$0.008/min, TTS$13/1M chars.- 요청 한도가 꽤 촘촘하다. 컨텍스트 65,536 토큰(오디오와
context_bias공용), 화자 참조 클립 8개·각 3~15초,target_streaming_delay_ms80~1200 또는 2400.- 가중치·라이선스는 공식 공지에 없다. 확인되는 경로는 EU 호스팅 API와 자체 인프라 배포뿐이다.
1. 발표 사실부터 고정
Mistral 블로그 본문에는 날짜 표기가 없다. 발표일은 공식 뉴스 목록에서 확인된다 — "Voxtral 3 ... October 20, 2026 By Mistral". 2차 확인으로 Cryptobriefing 기사의 published_time이 2026-10-20T16:04:41+00:00이고, AGI Pulse도 10월 20일 공개 건으로 다뤘다. 블로그 벤치마크 각주의 generated 2026-10-20은 평가 실행 날짜이므로 발표일 근거로 쓰지 않았다.
주체는 Mistral AI다. 배포 문구는 "Available today through Mistral's EU-hosted API or for self-deployment on your own infrastructure"이고, 호스팅은 "European, US, and global endpoints"로 적혀 있다. 가중치 배포나 라이선스 이름에 대한 문장은 공식 공지에 없다. 일부 매체가 "open-weight"로 표기했지만 공식 근거가 확인되지 않아 이 글에서는 확인 필요로 둔다.
2. 모델 표면 — ID와 단가
| 모델 ID | 역할 | 단가(공식 가격표) | 문서상 특징 |
|---|---|---|---|
voxtral-small-transcribe-3-0 | 파일 전사 | $0.0040/min | "Highest accuracy speech transcription model", 출시 시점 녹음 파일만 |
voxtral-mini-transcribe-3-0 | 파일 전사 | $0.0035/min | 4B 파라미터, 화자 라벨·구간 타임스탬프·사용자 어휘 |
voxtral-mini-transcribe-realtime-3-0 | 실시간 전사 | $0.008/min | 지연 500ms 미만 주장, 세션별 지연 설정 |
voxtral-mini-tts-3-0 | 음성 합성(배치) | $13/1M chars | 프리셋 음성 + 제로샷 클로닝, 출력 5종·WAV 24kHz |
voxtral-mini-tts-realtime-3-0 | 음성 합성(스트리밍) | 가격표 미기재 — 확인 필요 | "Streaming speech generation for live conversations" |
| 음성 에이전트 API (Mistral Small 4) | 통합 | 0.04$/min | 가격표 표기 그대로 |
| 음성 에이전트 API (상위 모델) | 통합 | 0.08$/min | 가격표 표기 그대로 |
문서는 "Voxtral 3 has five models: three turn speech into text, and two turn text into speech"로 5종을 명시한다. 그런데 블로그 가격표는 네 줄이라 TTS 실시간 모델의 단가가 비어 있다. 모델 수와 가격표 행 수가 어긋나는 상태이므로, 스트리밍 TTS 비용은 콘솔에서 확인해야 한다.
언어 지원은 모델별로 다르게 적혀 있다. 문서의 언어 페이지 기준으로 voxtral-mini-transcribe-3-0과 voxtral-small-transcribe-3-0이 50개 언어, voxtral-mini-transcribe-realtime-3-0이 45개 언어·방언, voxtral-mini-tts-3-0이 35개 언어·50개 이상 방언이다. TTS 프리셋 음성이 있는 언어는 22개이고 한국어(ko)는 프리셋 2종이다. 프리셋이 없는 언어는 해당 언어 녹음으로 클로닝하라고 안내된다.
3. 공식 문서 기준 최소 호출
아래는 docs.mistral.ai/studio/audio/overview에 실린 예제를 그대로 옮긴 것이다. 문서에 없는 코드는 쓰지 않았다.
출처: https://docs.mistral.ai/studio/audio/overview
export MISTRAL_API_KEY="your-api-key"
pip install "mistralai[realtime]"
curl -O https://docs.mistral.ai/audio/obama.mp3
문서는 realtime extra에 대해 "The realtime extra adds the WebSocket client for realtime transcription"이라고 설명한다. 즉 실시간 전사를 쓰지 않는다면 기본 설치로 충분하다는 뜻이다.
import os

from mistralai.client import Mistral

client = Mistral(api_key=os.environ["MISTRAL_API_KEY"])

with open("obama.mp3", "rb") as audio:
    transcription = client.audio.transcriptions.complete(
        model="voxtral-mini-transcribe-3",
        file={"file_name": "obama.mp3", "content": audio},
    )

print(transcription.text)
주의할 점이 하나 있다. 이 예제의 모델 문자열은 voxtral-mini-transcribe-3인데, 같은 문서의 모델 표는 ID를 voxtral-mini-transcribe-3-0으로 적는다. 끝의 -0이 붙은 쪽이 버전 고정 ID로 보이지만 문서가 둘을 모두 쓰고 있으므로, 실제 사용 전에 모델 목록 API로 유효한 식별자를 확인하는 편이 안전하다. 별칭을 쓰면 모델 동작이 조용히 바뀌는 위험이 따라온다는 점도 Mistral 문서가 다른 곳에서 경고한 바 있다.
4. 요청 한도와 에러 코드
도입 설계에 바로 쓰이는 숫자들이다. 전부 specs-and-limits/limits 문서 기준이다.
| 항목 | 값 | 초과 시 |
|---|---|---|
컨텍스트(오디오 + context_bias 공용) | 65,536 토큰 | 400, 잘라내지 않음 |
file_url 길이 | 2,083자 | 검증 오류 |
timestamp_granularities | segment만 | word 지정 시 400 |
화자 참조 클립 (diarize=true) | 최대 8개, 각 3~15초 | 400 — "At most 8 speaker references are supported, got {n}" |
target_streaming_delay_ms | 80~1200 정수, 또는 2400 | error 이벤트 |
phoneme_hints | 음소 50종 고정 목록 | 422 |
| 감정 태그 | 34종 | 오류 없음, 태그가 발화되지 않음 |
| 속도 태그 | slow / fast | — |
language | ISO 639-1 두 글자(예: fr) | 그 외 값은 422 |
| 클로닝 참조 클립 | "A few seconds to a few minutes" | MP3·WAV 아니면 400 |
input_audio(chat completions) | 수치 미기재 | 429 "Rate limit exceeded" |
| 음성 에이전트 웹훅 | 10초 내 응답, 총 3회 재시도(5xx·429·네트워크 오류) | — |
| 최대 파일 크기·최대 오디오 길이·요청 레이트 수치 | 문서 미기재 — 확인 필요 | 워크스페이스 단위 설정으로만 안내 |
여기서 설계에 영향이 큰 것은 65,536 토큰 컨텍스트가 오디오와 어휘 목록을 함께 쓴다는 점이다. 핵심어 주입을 늘리면 처리 가능한 오디오 길이가 줄어드는 트레이드오프가 생기고, 초과하면 자동으로 잘리지 않고 400이 떨어진다. 긴 녹취를 다룬다면 분할 전사와 어휘 목록 크기를 함께 설계해야 한다.
타임스탬프가 구간 단위만 지원되는 것도 미리 알아야 한다. 단어 단위 싱크가 필요한 자막 파이프라인이라면 word를 넣는 순간 400이 나므로 후처리로 정렬하는 단계가 필요하다.
5. 실시간 전사 — 지연이 곧 정확도 다이얼
실시간 모델은 target_streaming_delay_ms를 세션마다 설정한다. Mistral이 공개한 FLEURS 35 언어 WER(낮을수록 좋음) 수치는 지연과 정확도의 교환비를 숫자로 보여 준다.
| 설정·시스템 | WER |
|---|---|
voxtral-mini-transcribe-3(오프라인 기준선) | 4.0% |
| Gemini 3.5 Realtime Transcribe | 4.2% |
| Voxtral Mini Realtime 3 @ 2400ms | 5.7% |
| Microsoft AI Transcribe 2 Streaming | 5.8% |
| Voxtral Mini Realtime 3 @ 960ms | 6.0% |
| Voxtral Mini Realtime 3 @ 480ms | 6.4% |
| Voxtral Mini Realtime 3 @ 240ms | 7.4% |
| GPT Live Transcribe | 8.4% |
| Scribe v2 Realtime | 8.7% |
전부 Mistral 자사 발표이고 독립 검증이 아니다. 그래도 같은 모델 안에서 240ms와 2400ms 사이에 1.7%p 차이가 난다는 구조 자체는 설계에 쓸 수 있다. 음성 봇의 체감 응답성을 포기할 수 없다면 480ms 전후에서 도메인 어휘 주입으로 정확도를 보완하는 쪽이 현실적인 조합이다.
6. 음성 에이전트 SDK 구조
SDK는 세 단계를 연결한다 — 실시간 전사 모델이 듣고, Mistral Small 4가 추론과 도구 호출을 하고, Voxtral TTS가 답한다. 문서는 각 단계의 모델을 "per agent or per session"으로 고를 수 있다고 적는다. 전송 계층은 LiveKit이고, Mistral은 그 위에 Python·TypeScript 바인딩과 모델 연결부를 얹었다고 설명한다. 한 턴이 1초 안에 끝난다는 것은 Mistral 주장이다.
문서에 적힌 실무 제약은 다음과 같다. 네이티브 오디오 의존성이 필요하다 — Python은 PortAudio, Node.js는 SoX와 FFmpeg다. 브라우저 세션은 TypeScript를 쓴다. 텔레포니는 출시 시점에 엔터프라이즈 고객에게만 계정 담당자를 통해 제공된다. 패키지 이름·설치 명령·저장소 URL은 개요 페이지에 없고 별도 퀵스타트 페이지로 링크돼 있다(이번 확인 시도에서 해당 퀵스타트 페이지는 열리지 않았다) — 따라서 설치 명령은 확인 필요로 남겨 둔다.
7. 벤치마크에서 인용할 만한 두 지점
라벨이 명확한 것만 옮긴다. 화자 분리 cpWER(AMI-IHM·AMI-SDM·Switchboard·Switchboard CallHome·AISHELL-4 평균, 낮을수록 좋음)이다.
| 시스템 | cpWER |
|---|---|
| Voxtral Small Transcribe 3 | 18.4% |
| Voxtral Mini Transcribe 3 | 18.6% |
| Pyannote Orchestrator (Precision 3) | 19.0% |
| Microsoft AI Transcribe 2 | 20.3% |
| Scribe v2 | 23.0% |
| Voxtral Mini Transcribe 2 | 30.9% |
| Gemini 3.5 Transcribe | 38.4% |
두 번째는 맥락 주입 효과다. Earnings 22 핵심어 재현율에서 Voxtral Small Transcribe 3은 맥락 제공 시 94.6%, 미제공 시 81.4%였다. Scribe v2는 94.3% 대 84.0%, Gemini 3.5 Transcribe는 87.3% 대 80.9%다. 13.2%p 차이는 모델 등급 변경보다 큰 폭이고, context_bias에 사내 용어를 넣는 작업의 우선순위를 뒷받침한다.
다국어 FLEURS 45 평균 WER은 상위 값이 4.1%, 비교군 중 Whisper large-v3가 16.0%로 가장 높게 제시된다. 다만 차트의 수치와 모델 라벨 대응이 본문 텍스트만으로 1:1 확정되지 않아 중간 구간은 확인 필요로 둔다. TTS 품질 차트는 전부 "Internal eval" 표기(Voice Code Bench 300문항·판정 모델 gemini-3.8-flash, 다국어 377문항, 표현력 237문항)여서 수치 인용을 피했다. TTS 비용 우위 주장("OpenAI TTS-1, Deepgram, ElevenLabs Flash, Gemini Flash보다 저렴")도 Mistral 자사 주장이다.
8. 문서끼리 어긋나는 세 군데
- 실시간 전사 언어 수 — 블로그 본문 "over 35", 제품 카드 "40+", 문서 언어 페이지 "45 languages and dialects". 세 값이 다르다. 문서 페이지 값을 기준으로 두고 실측하는 쪽을 권한다.
- 클로닝 기준 음성 길이 — 블로그는 "30+ minutes of sampled audio", 문서는 "A few seconds to a few minutes". Pro Voice 적응은 "just 30 minutes of audio"로 적혀 있어, 클로닝과 Pro Voice가 다른 기능인지 같은 기능의 다른 표현인지 공식 문구만으로는 갈리지 않는다.
- 모델 ID — 코드 예제
voxtral-mini-transcribe-3vs 모델 표voxtral-mini-transcribe-3-0.
여기에 더해 2차 출처 한 곳이 분당 약 $0.001을 제시했으나 공식 가격표의 어떤 행과도 맞지 않는다. 단일 출처 수치여서 채택하지 않았다.
9. 지금 할 수 있는 것 / 미뤄야 할 것
지금 할 수 있는 것은 네 가지다. 첫째, 녹음 파일 전사 비용 산정이다. $0.0040/min이면 1,000시간이 약 $240이다. 둘째, context_bias에 사내 용어를 넣은 상태와 넣지 않은 상태로 동일 샘플 비교다. 셋째, 실시간 지연을 240/480/960/2400ms로 바꿔 가며 자체 데이터 WER을 재는 것이다. 넷째, 화자 분리가 필요한 파이프라인에서 참조 클립 8개 제한에 맞춘 화자 사전 설계다.
미뤄야 할 것도 분명하다. 가중치를 받아 자체 서빙하는 계획은 라이선스가 공개되기 전까지 확정할 수 없다. 스트리밍 TTS 비용 모델은 가격표에 행이 없다. 파일 크기·오디오 길이 상한은 문서에 값이 비어 있어 대용량 배치 설계의 근거가 아직 없다. 음성 에이전트 SDK의 설치 경로도 퀵스타트 페이지 확인이 필요하다.
자주 묻는 질문
기존 Whisper 기반 코드를 수정해야 하나?
호출 방식이 다르므로 클라이언트 코드는 바꿔야 한다. 공식 Python 예제는 client.audio.transcriptions.complete(model=..., file={"file_name":..., "content":...}) 형태이고, OpenAI 호환 엔드포인트 제공 여부는 공식 문서에서 확인되지 않았다. 다만 음성 에이전트 쪽은 LiveKit 기반이라 LiveKit을 이미 쓰고 있다면 전송 계층은 재사용 가능하다.
Voxtral 3는 한국어를 지원하나?
전사 모델은 50개 언어를 지원한다고 적혀 있고, TTS는 한국어(ko) 프리셋 음성 2종이 제공된다. 다만 한국어 개별 WER 수치는 공식 자료에 없고 FLEURS 다국어 평균만 제시된다. 한국어 품질은 자체 샘플로 측정해야 한다.
단어 단위 타임스탬프를 받을 수 있나?
받을 수 없다. 문서는 timestamp_granularities=segment만 허용하고 word를 넣으면 400을 반환한다고 명시한다. 단어 싱크가 필요하면 구간 결과를 받아 후처리로 정렬해야 한다.
마무리
Voxtral 3를 평가할 때 쓸 만한 재료는 벤치마크 차트보다 가격표와 한도표다. 분당 단가 세 종, 100만 자당 $13, 그리고 65,536 토큰·8개 클립·80~2400ms 같은 숫자들이 도입 계산을 바로 가능하게 한다. 반대로 가중치·라이선스·파일 상한처럼 공식 문서가 비워 둔 칸은 문의와 실측으로 채워야 한다. 같은 회사가 직전에 API를 먼저 열고 가중치를 뒤에 붙인 사례는 Mistral Large 4 단가와 가중치 공개 일정 정리에 따로 정리해 두었다. 읽어 주셔서 감사합니다.
출처
- Mistral AI — Voxtral 3 (2026-10-20)
- Mistral AI — News 목록 (발표일 확인)
- Mistral Docs — Audio overview (코드 예제 출처)
- Mistral Docs — Limits
- Mistral Docs — Languages
- Mistral Docs — Voice agents overview
- Mistral Docs — Speech to text overview
- Cryptobriefing — Mistral unveils Voxtral 3 (2026-10-20)
본 글은 공개 자료를 바탕으로 정리했으며, 세부 내용·수치는 원 출처·공식 문서와 대조 확인을 권장합니다. 성능 비교 수치는 모두 Mistral 자사 발표이며 독립 검증 결과가 아닙니다.