1. 서론
토폴로지 딥러닝(Topological Deep Learning) 은 전통적인 유클리드 공간에서의 데이터 학습을 넘어, 비유클리드 데이터 구조를 학습하는 새로운 접근 방식이다. 기존 딥러닝 모델은 그리드 기반(예: CNN) 또는 시퀀스 기반(예: RNN) 데이터에 최적화되어 있었으나, 실제 데이터는 복잡한 위상적(topological) 구조 를 가질 수 있다. 이에 따라, 토폴로지 정보를 효과적으로 활용하는 딥러닝 기법이 연구되고 있다.
2. 토폴로지 딥러닝의 개념
토폴로지 딥러닝은 데이터가 가진 기하학적 및 위상적 특성 을 반영하여 학습하는 딥러닝 모델의 한 유형이다. 특히, 데이터가 단순한 행렬 형태가 아닌, 복잡한 관계성과 구조를 가질 때 이를 효과적으로 학습할 수 있도록 설계된다. 기존 딥러닝 모델 이 다루는 데이터는 일반적으로 일정한 차원을 가지는 텐서 형태이지만, 토폴로지 딥러닝 에서는 비유클리드 공간의 데이터를 다룰 수 있도록 확장된 구조를 사용한다.
2.1 Non-Euclidean Data(비유클리드 데이터)의 특성
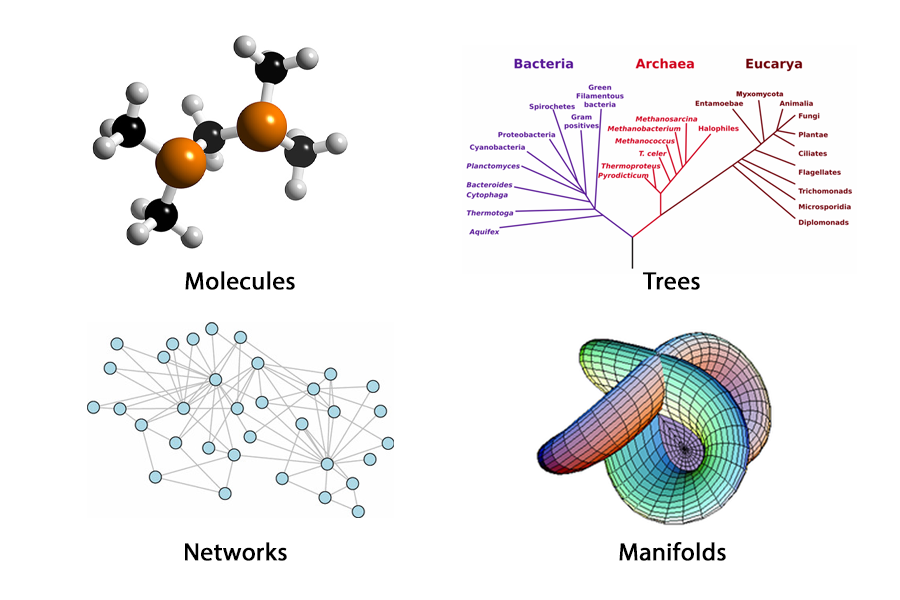
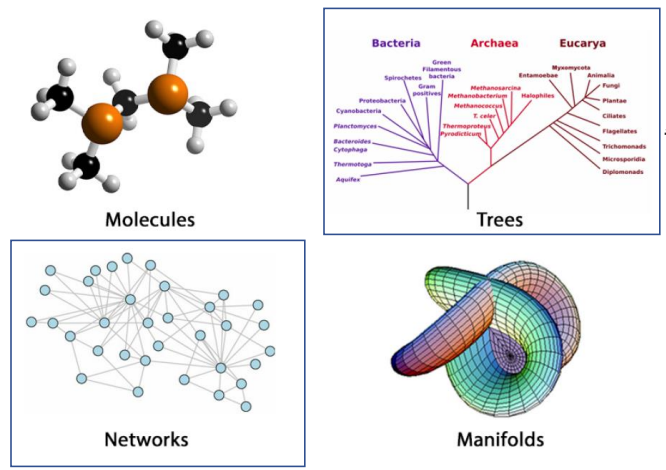
Non-Euclidean Data 란 일반적인 좌표 공간에서 표현하기 어려운 데이터로, 예를 들어 그래프, 네트워크, 트리 구조, 위상 공간 등이 이에 해당한다. 이러한 데이터는 노드와 엣지의 관계, 다차원적인 연결성, 연속적인 변형 불변성 등의 특성을 가진다. 토폴로지 딥러닝은 이러한 데이터의 특징을 유지하면서도 학습할 수 있도록 설계된 모델이다.
2.2 토폴로지 기반 데이터 표현
토폴로지 딥러닝에서는 다음과 같은 구조를 활용하여 데이터를 표현한다:
그래프(Graphs) : 노드(Node)와 엣지(Edge)로 구성된 데이터 구조로, 네트워크 분석, 소셜 미디어, 추천 시스템에서 자주 사용된다.
단순 복합체(Simplicial Complexes) : 단순한 그래프 구조를 넘어 다차원적으로 연결된 데이터 구조를 표현하는 방법으로, 위상 공간을 보다 세밀하게 모델링할 수 있다.
퍼시스턴스 호모로지(Persistent Homology) : 데이터의 위상적 변화를 분석하여 특징을 추출하는 기법으로, 위상 데이터 분석(Topological Data Analysis, TDA)에서 활용된다.
하이퍼그래프(Hypergraphs) : 일반적인 그래프보다 확장된 개념으로, 한 개의 엣지가 다수의 노드를 연결할 수 있는 구조를 가진다.
2.3 토폴로지 딥러닝의 장점
토폴로지 딥러닝의 가장 큰 장점은 기존의 전통적인 딥러닝 기법이 학습하기 어려운 복잡한 구조를 보다 효과적으로 학습할 수 있다는 점이다. 주요 이점은 다음과 같다:
전역적 및 국소적 패턴 학습 : 데이터 내의 전체적인 구조뿐만 아니라 미세한 패턴까지 학습 가능하다.
변형 불변성(Invariance) : 데이터의 회전, 이동, 스케일 변화 등에 영향을 덜 받으며, 보다 일반화된 학습이 가능하다.
데이터의 관계성 유지 : 그래프나 위상적 구조를 사용함으로써 데이터 간의 관계를 보존할 수 있다.
토폴로지 딥러닝은 그래프 신경망(Graph Neural Networks, GNN), 퍼시스턴스 호모로지(Persistent Homology), 하이퍼그래프 신경망(Hypergraph Neural Networks) 등의 방법을 활용하여 데이터의 전역적 구조와 관계성을 보다 정교하게 학습할 수 있도록 돕는다.
3. 주요 기법
3.1 그래프 신경망(Graph Neural Networks, GNN)
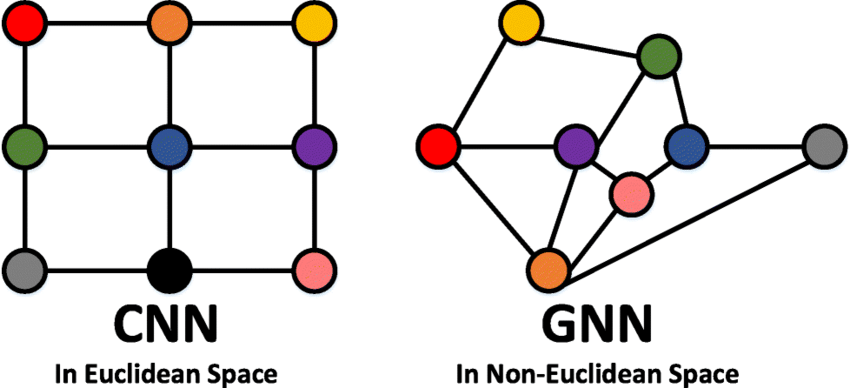
GNN은 그래프 구조의 데이터에서 노드 간 관계를 학습하는 신경망 모델이다. 이는 특히 소셜 네트워크 분석, 분자 구조 예측, 추천 시스템 등의 응용 분야에서 효과적으로 사용된다. GNN은 전통적인 딥러닝 모델과 달리 데이터의 비유클리드적 특성을 반영할 수 있으며, 대표적인 아키텍처로는 Graph Convolutional Network (GCN), Graph Attention Network (GAT), GraphSAGE 등이 있다.
Graph Convolutional Network (GCN): CNN에서의 합성곱 연산을 그래프 구조로 확장한 모델로, 인접 노드의 정보를 종합하여 학습한다.
Graph Attention Network (GAT): 특정 노드의 중요도를 반영하기 위해 어텐션 메커니즘을 적용한 GNN 변형 모델이다.
GraphSAGE: 데이터가 점진적으로 확장될 때 노드 샘플링을 통해 효율적인 학습이 가능하도록 하는 기법이다.
3.2 퍼시스턴스 호모로지(Persistent Homology)
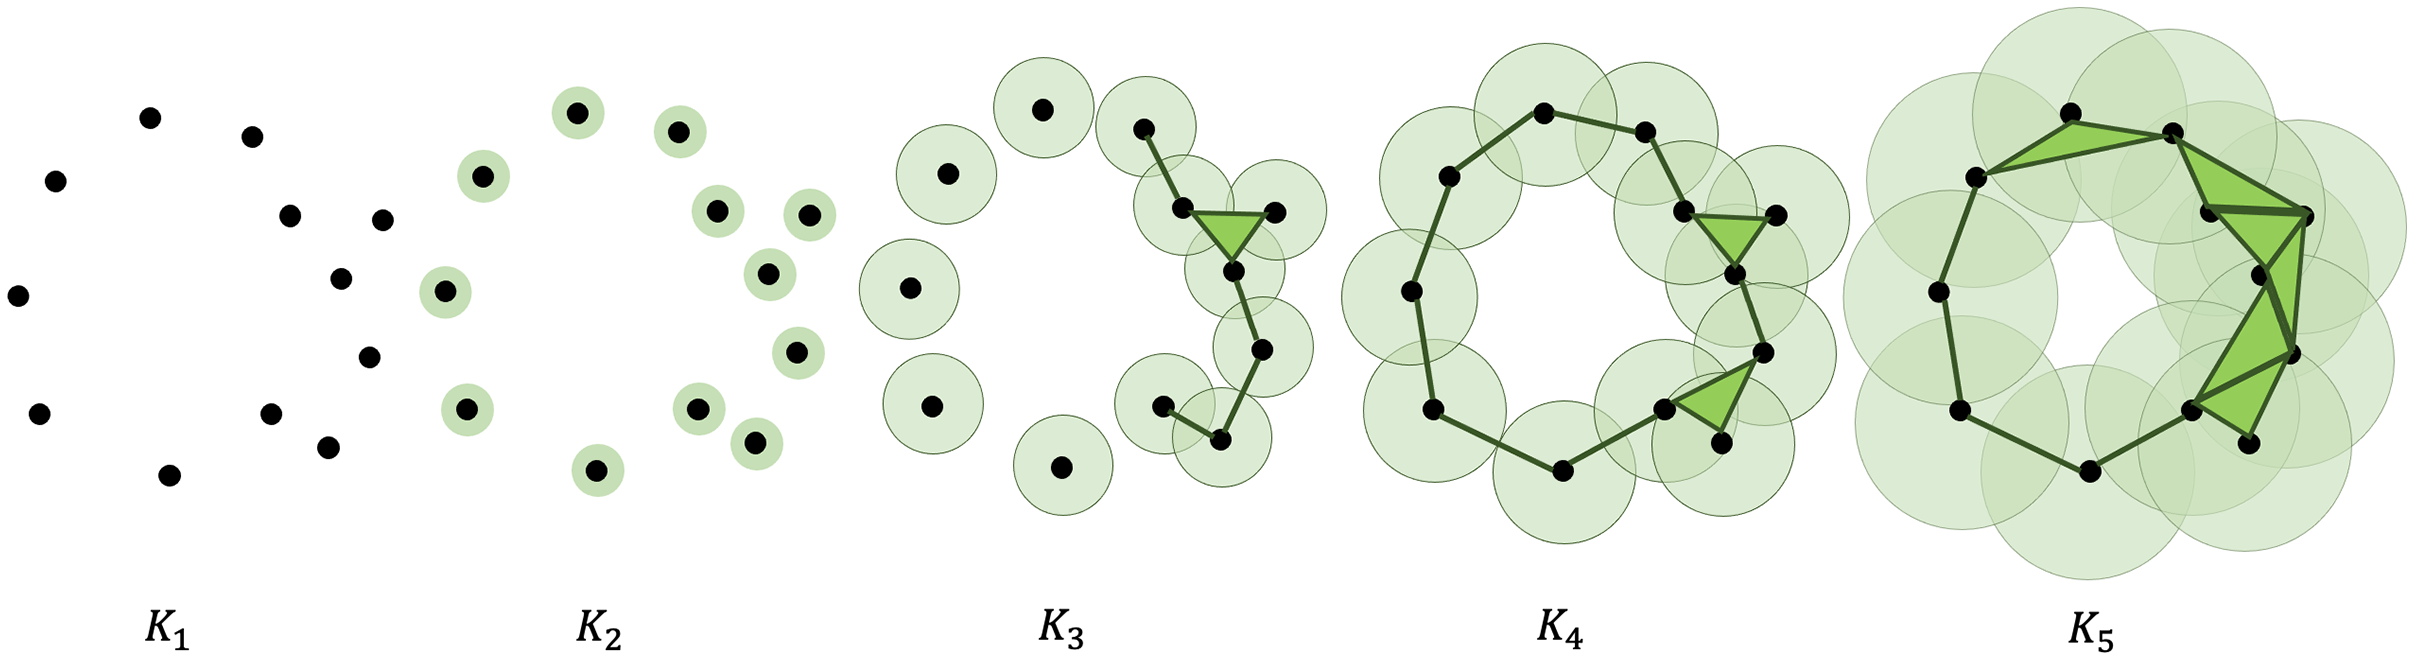
Persistent Homology 는 위상 데이터 분석(Topological Data Analysis, TDA)의 핵심 기법 중 하나로, 데이터의 위상적 특징을 유지하며 특성을 추출하는 방법이다. 일반적으로 시뮬레이션 데이터, 이미지 데이터, 생물학적 데이터(예: 단백질 구조 분석)에서 사용된다.
필트레이션(Filtration) : 주어진 데이터에서 점진적으로 연결 관계를 확장하며 위상적 특성을 분석하는 과정이다.
퍼시스턴스 다이어그램(Persistence Diagram) : 데이터의 위상적 특징을 시각적으로 표현하며, 각 구조적 요소의 지속성을 나타낸다.
퍼시스턴스 베팅 넘버(Persistent Betti Numbers) : 데이터의 차원별 위상 특징을 수치화하여 학습에 활용하는 지표이다.
3.3 하이퍼그래프 신경망(Hypergraph Neural Networks)
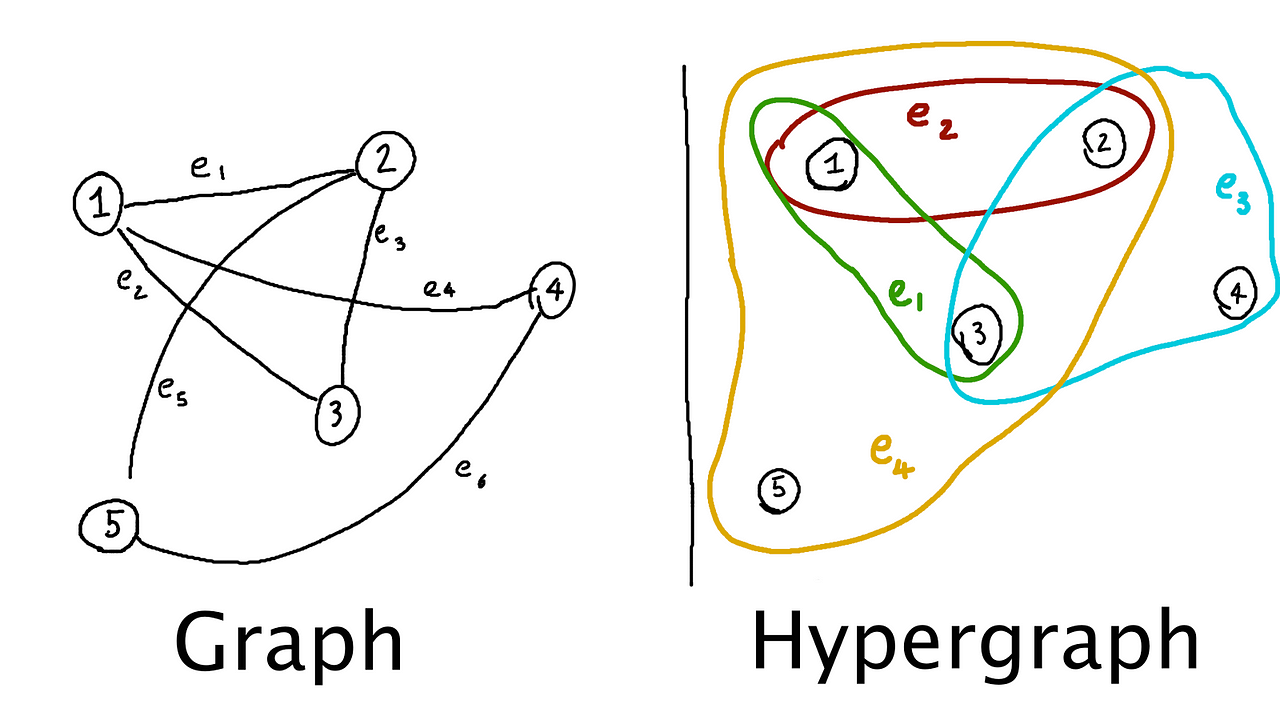
Hypergraph Neural Networks 은 일반적인 그래프보다 더 복잡한 관계를 모델링할 수 있는 구조 를 제공한다. 전통적인 그래프에서는 노드 간 1:1 관계를 정의하는 반면, 하이퍼그래프에서는 하나의 관계(하이퍼엣지)가 여러 개의 노드를 연결할 수 있다. 이러한 특징은 소셜 네트워크 분석, 유전자 상호작용 분석, 추천 시스템 등에 적용할 수 있다.
하이퍼그래프 합성곱(Hypergraph Convolution): 그래프 합성곱을 확장하여 하이퍼엣지를 통해 여러 노드 간 정보를 통합하는 방법이다.
하이퍼그래프 임베딩(Hypergraph Embedding): 하이퍼그래프 구조를 벡터 공간에 효율적으로 표현하여 머신러닝 모델에서 활용할 수 있도록 변환하는 기법이다.
4. 응용 분야
Topological Deep Learning 은 생물정보학, 신경과학, 소셜 네트워크 분석, 추천 시스템, 물리학 등 다양한 분야에서 활용된다.
예를 들어, 단백질 구조 예측에서는 단순한 시퀀스 정보보다 단백질의 위상 구조를 고려한 학습이 더 정확한 결과를 제공할 수 있다.
생물정보학: 단백질-단백질 상호작용, 유전자 네트워크 분석
신경과학: 뇌 연결망 분석을 통한 신경 질환 진단
소셜 네트워크 분석: 커뮤니티 감지, 영향력 있는 사용자 식별
추천 시스템: 다중 사용자-아이템 관계를 반영하여 추천 정확도를 향상
5. 결론
토폴로지 딥러닝 (Topological Deep Learning) 은 기존 딥러닝 기법이 다루기 어려운 복잡한 데이터 구조를 학습하는 데 강력한 도구가 될 수 있다. 향후 연구가 더욱 발전함에 따라, 다양한 산업 분야에서 실용적인 활용이 가능할 것으로 기대된다. 특히, 비정형 데이터와 고차원 데이터에서 유용한 결과를 제공할 수 있으며, 다양한 도메인에서 데이터의 본질적인 구조를 보다 깊이 있게 이해하는 데 기여할 것으로 예상된다
📌 이미지 출처
https://www.marktechpost.com/wp-content/uploads/2022/11/Blog-Banner-2.png
https://velog.velcdn.com/images/sangyun/post/89608785-26c0-45db-81f0-0a2f7ff955b6/image.png
https://user-images.githubusercontent.com/79881119/209148483-6c47c2cc-9be8-4f34-9173-fa5f33c6aa22.png
https://dfzljdn9uc3pi.cloudfront.net/2023/cs-1195/1/fig-1-full.png
https://towardsdatascience.com/wp-content/uploads/2021/01/0nVvvxd7M2JbHP6TO.png