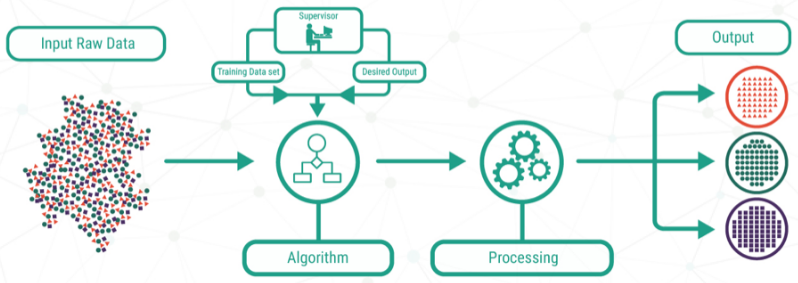
1. 지도학습 개요
지도학습(Supervised Learning)은 입력 데이터(Features)와 정답(Label)을 기반으로 모델을 학습하는 방식입니다.
대표적인 지도학습 문제
- 이미지 분류(Image Classification): CIFAR-10과 같은 데이터셋을 활용해 이미지에 레이블을 예측.
- 텍스트 분류(Text Classification): 감성 분석(Positive/Negative), 스팸 메일 필터링 등.
- 다음 단어 예측(Next Word Prediction): 문장에서 다음 단어를 예측하는 모델.
- 번역(Translation): 문장을 다른 언어로 변환하는 작업.
- 가격 예측(Price Prediction): 부동산, 주식 등 가격을 예측하는 문제.
2. 지도학습의 두 가지 유형
2.1 분류(Classification)
- 목표: 주어진 데이터를 정해진 카테고리(클래스) 중 하나로 분류.
- 예제: 개/고양이 분류, 스팸 필터링, 감성 분석.
- 이진 분류(Binary Classification): 두 개의 클래스로 구분 (예: 스팸/비스팸).
- 다중 클래스 분류(Multi-Class Classification): 세 개 이상의 클래스로 구분 (예: 손글씨 숫자 분류).
2.2 회귀(Regression)
- 목표: 연속적인 값을 예측하는 문제.
- 예제: 부동산 가격 예측, 온도 예측, 주가 예측.
3. 선형 회귀 (Linear Regression)
3.1 개념
선형 회귀는 입력 변수(독립 변수)와 출력 변수(종속 변수) 간의 선형 관계를 찾아 예측하는 모델입니다.
- 모델 수식: 여기서 ( w )는 가중치(Weight), ( b )는 편향(Bias)입니다.
3.2 손실 함수 (Loss Function)
선형 회귀에서는 일반적으로 평균제곱오차(MSE, Mean Squared Error)를 사용합니다.
3.3 경사 하강법 (Gradient Descent)
MSE를 최소화하기 위해 경사 하강법(Gradient Descent)을 사용하여 가중치를 최적화합니다.
- 초기 가중치 설정 (( w ), ( b ) 랜덤 초기화)
- 손실 함수의 기울기(Gradient) 계산
- 가중치 업데이트:여기서 ( \alpha )는 학습률(Learning Rate).
4. 로지스틱 회귀 (Logistic Regression)
4.1 개념
로지스틱 회귀는 이진 분류 문제를 해결하는 데 사용됩니다.
-
시그모이드 함수(Sigmoid Function) 사용:
여기서
-
결과값이 0~1 사이의 확률값을 출력.
4.2 손실 함수 (Loss Function)
크로스 엔트로피 손실 함수 (Cross-Entropy Loss) 사용:
5. 서포트 벡터 머신 (SVM)
5.1 개념
SVM(Support Vector Machine)은 데이터 포인트 간 마진(Margin)을 최대화하여 분류하는 알고리즘입니다.
- 결정 경계(Decision Boundary): 클래스 간 가장 큰 마진을 가지는 선.
- 힌지 손실(Hinge Loss) 사용.
5.2 소프트 마진 SVM (Soft-Margin SVM)
- 선형적으로 분리할 수 없는 데이터를 처리하기 위해 슬랙 변수(Slack Variable)를 도입하여 일부 오류를 허용.
5.3 커널 트릭 (Kernel Trick)
- 고차원 특징 공간으로 변환하여 비선형 데이터를 분리할 수 있도록 도와줌.
- 대표적인 커널 함수:
- 다항식 커널 (Polynomial Kernel)
- 가우시안 RBF 커널 (Gaussian Radial Basis Function)
6. 의사결정 트리 (Decision Tree)
6.1 개념
- 데이터의 특징을 기반으로 트리 구조를 만들어 분류/회귀를 수행.
- 엔트로피(Entropy)와 지니 계수(Gini Index)를 활용하여 노드 분할.
6.2 랜덤 포레스트 (Random Forest)
- 여러 개의 의사결정 트리를 조합하여 예측 성능을 향상시키는 배깅(Bagging) 기반 앙상블 학습 방법.
6.3 부스팅 (Boosting)
- 이전 모델이 틀린 데이터에 가중치를 더 주면서 모델을 학습하는 방식.
- 대표적인 알고리즘:
- AdaBoost
- XGBoost
- LightGBM
7. 지도학습의 일반화 (Overfitting vs. Underfitting)
7.1 과적합 (Overfitting)
- 모델이 훈련 데이터에 너무 과하게 적응하여 새로운 데이터에 대한 일반화 능력이 부족한 상태.
- 해결 방법:
- 더 많은 데이터 수집
- 정규화 (L1, L2 Regularization)
- 데이터 증강 (Augmentation)
7.2 과소적합 (Underfitting)
- 모델이 훈련 데이터의 패턴을 제대로 학습하지 못한 상태.
- 해결 방법:
- 더 복잡한 모델 사용
- 더 많은 특성(Feature) 추가
8. 결론
지도학습은 머신러닝에서 가장 널리 사용되는 학습 방법으로, 회귀와 분류 문제를 해결하는 데 사용됩니다. 선형 회귀, 로지스틱 회귀, SVM, 의사결정 트리 등의 다양한 알고리즘이 존재하며, 문제 유형에 따라 적절한 알고리즘을 선택하는 것이 중요합니다.
📌 요약
- 지도학습은 입력 데이터와 정답을 이용해 학습하는 방식.
- 주요 알고리즘: 선형 회귀, 로지스틱 회귀, SVM, 의사결정 트리.
- 과적합을 방지하는 정규화 기법과 데이터 증강 활용.
- 문제에 맞는 모델을 선택하고 하이퍼파라미터 튜닝이 중요.
다음에 또 올게요~~ 안녕~

민기임니다