이 시리즈는 Databricks 환경에서 구축했던 항공/운송/물류 분야의 RAG Agent 구축 프로젝트 관련 내용을 정리하는 시리즈입니다. 요구사항과 관련하여 Databricks의 어떤 기술을 사용해 이를 충족하였으며, 수행 중 발생한 문제 상황을 어떻게 해결했는지 정리합니다.
실제 고객사에서 수행한 프로젝트와는 별도의 내용으로, 기술적인 내용만을 정리합니다.
1. 데이터 인덱싱 파이프라인 개요(Data Indexing)
데이터 인덱싱(Data Indexing) 작업은 수집이 완료된 문서 파일들을 읽어 파싱, 청킹, 형태소 분석 및 임베딩 단계를 거쳐 Databricks Vector Search Index로 최종 동기화하는 파이프라인입니다.
이 파이프라인은 Databricks Workflow 상에서 각각 독립적인 Task 노트북으로 구성되어 순차적으로 동작하며, 분산 데이터 처리와 모델 연동을 위해 src/indexing 내의 모듈을 참조합니다.
[참고] 6월 13일자로 DBRX의
Vector Search가AI Search로 명칭이 변경되었습니다. 다만 본 프로젝트에서는 시기상 프로젝트의 후반임을 고려하여 기존 버전을 고정시켜 작업하였으므로 Vector Search를 그대로 사용하였습니다.
1.1. 전체 데이터 인덱싱 흐름도
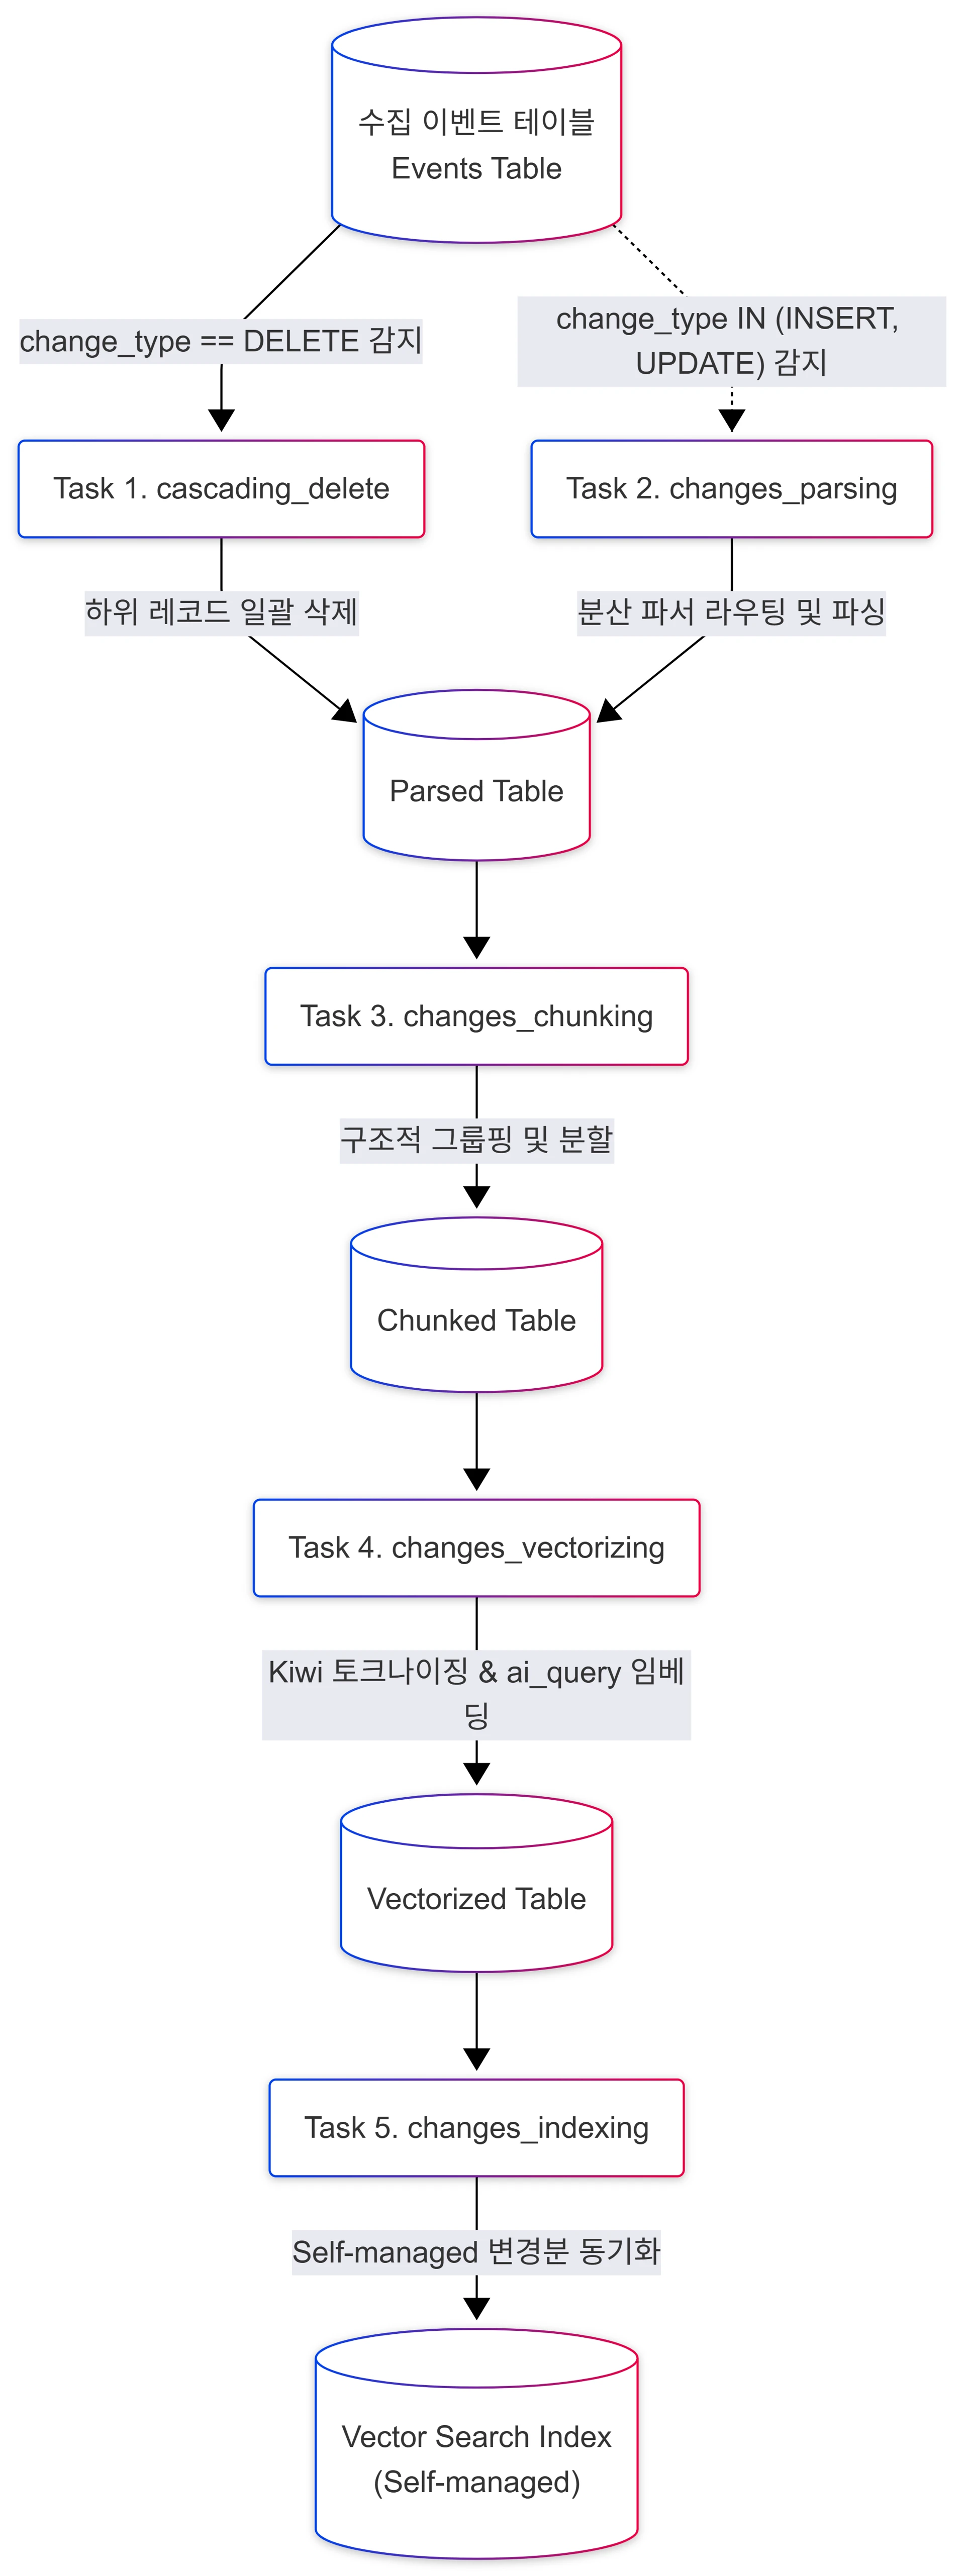
1.2. 주요 태스크(Task) 정의
| 태스크명 | 역할 및 핵심 기능 |
|---|---|
| Task 1. Cascading Delete | 원천 데이터 수집 단계에서 삭제 처리된 문서의 ID를 기반으로 하위 테이블(Parsed, Chunked, Vectorized)의 파편 데이터를 일괄 제거합니다. |
| Task 2. Changes Parsing | 수집 완료된 JSON 형식의 본문 데이터를 문서별 구조적 특징을 반영하여 단락, 테이블, 이미지 등의 최소 요소(Element) 단위로 파싱합니다. |
| Task 3. Changes Chunking | 파싱된 개별 요소를 구조적 앵커(제목, 시트 탭, 슬라이드 번호) 기준으로 결합하고 글자 수 임곗값 초과 시 오버랩 분할하여 청크 데이터로 가공합니다. |
| Task 4. Changes Vectorizing | 생성된 청크 데이터에서 Kiwi 형태소 분석기를 이용해 검색 전용 키워드를 추출하고, Databricks ai_query를 활용해 시맨틱 벡터 컬럼을 생성합니다. |
| Task 5. Changes Indexing | 벡터화가 완료된 최종 Delta Table의 데이터를 Databricks Vector Search와 연동하여 인덱스를 최종 동기화합니다. |
2. [Task #1] 변경분 연쇄 삭제(Cascading Delete)
데이터 변경 감지 이력(Change Data Feed)에서 문서 삭제 이벤트가 감지되었을 때, RAG 시스템 내부 테이블들에 잔존하는 해당 문서의 하위 레코드를 일괄적으로 정리하여 데이터 정합성을 유지합니다.
연쇄 삭제 (Cascading Delete)의 필요성
데이터베이스 간의 강한 참조 제약 조건이 없는 분산 파일/테이블 환경에서는 원본 문서가 삭제되었을 때 파생된 단락(Parsed), 청크(Chunked), 벡터(Vectorized) 데이터가 그대로 남는 현상이 발생할 수 있습니다. RAG 검색 시 삭제된 문서의 단락이 노출되는 문제를 방지하기 위해 파이프라인 시작부에서 연쇄 삭제 작업을 우선 실행합니다.
2.1. 노트북 동작 로직 및 연쇄 삭제 구현
-
삭제 대상 식별:
names.events테이블을 조회하여 당일(KST 기준) 기준change_type이"DELETE"로 기록된 문서들의 고유 식별자(file_id) 목록을 추출합니다. 만약 대상이 존재하지 않을 경우 작업을 조기에 종료합니다(dbutils.notebook.exit). -
하위 테이블 병합 삭제: 식별된
file_id목록(delete_df)을 기준으로 파싱 테이블(names.parsed), 청킹 테이블(names.chunked), 벡터 테이블(names.vectorized)에DeltaTable.merge()조작을 수행하여document_id가 일치하는 레코드들을 일괄 삭제(whenMatchedDelete)합니다.[참고] 본 프로젝트에서는 카탈로그 및 스키마 명칭 등 관련 변수들을
naming.py에서 일괄 관리합니다. -
병합 최적화: 대량의 데이터프레임과 거대 Delta 테이블 간의 조인 성능 저하를 방지하기 위해, 삭제 대상 데이터프레임(
delete_df)을 메모리상에 브로드캐스트하여 스파크 셔플(Shuffle) 연산 병목을 예방합니다.# cascading_delete - 변경분 삭제 이벤트 발생 시 하위 테이블 데이터 일괄 삭제 parsed_dt = DeltaTable.forName(spark, names.parsed) parsed_builder = (parsed_dt.alias("a") .merge(source=delete_df, condition=F.col("a.document_id") == F.col("file_id")) .whenMatchedDelete()) parsed_builder.execute()브로드캐스트 해시 조인(Broadcast Hash Join)을 통한 셔플 병목 예방
- 셔플(Shuffle) 병목: 분산 환경에서 두 테이블을 조인할 때, 조인 키(예:
document_id) 기준 정렬 및 재배치를 위해 워커 노드 간 대량의 데이터를 네트워크로 주고받는 과정을 '셔플'이라고 하며, 이는 무거운 작업으로서 일반적으로 쉽게 병목이 발생할 수 있습니다. - 브로드캐스트(Broadcast): 하루 동안 발생한 삭제 문서 ID 목록(
delete_df)처럼 작은 데이터프레임을 조인할 때, 드라이버 노드가 해당 데이터를 모든 워커 노드의 메모리에 복사본으로 복제 전송(Broadcast)합니다. - 동작 방식: 각 워커 노드는 로컬 메모리에 상주한 삭제 대상 목록을 참고하여, 자신이 맡고 있는 수백만 건의 Delta 테이블 조각(Parsed, Chunked 등)과 로컬에서 즉시 연계하여 연쇄 삭제 작업을 완수합니다. 워커 노드 사이의 네트워크 데이터 이동(Shuffle)을 유발하지 않는 효율적 구조입니다.
# data_processor.py 중 일부 target_in_scope = target_dt.toDF().join( broadcast(source_doc_ids), # <--- 수동으로 브로드캐스트 해시 조인을 유도 on=doc_key, how='inner', ) - 셔플(Shuffle) 병목: 분산 환경에서 두 테이블을 조인할 때, 조인 키(예:
3. [Task #2] 데이터 파싱(Data Parsing)
수집 완료된 JSON 형식의 파일 본문을 의미 구조를 파악할 수 있는 단락, 테이블, 이미지 등 최소 단위(Element) 형태로 분산 가공하는 단계입니다.
분산 파싱(Distributed Parsing)
대량의 문서 파일 본문 데이터를 단일 프로세스(Single Process)에서 가공하면 병목이 발생할 수 있습니다. 따라서data_processor.py모듈은 Spark의mapInPandasAPI를 활용하여 여러 워커 노드(Worker Node)에 파싱 대상을 분산 분배하고, 각 워커 노드가 메모리 상에서 문서를 병렬로 가공할 수 있도록 구성하였습니다.
3.1. data_processor.py 및 전처리 프로세스
3.1.1. IngestionProcessor.process_ingestion(process_df, resolver)
- 역할: 수집 로그 데이터프레임(
process_df)을 전처리하고 볼륨에 적재된 물리 JSON 본문 파일을 분산 워커에 적재합니다. - 동작 로직
- 구글 드라이브 수집 사양(
payload_layout)에 맞춤화된resolver객체를 식별하여, 물리 스토리지 Volume에 저장되어 있는 파일 본문 및 메타데이터 경로 정보를 Pandas 데이터프레임으로 변환합니다.
- 구글 드라이브 수집 사양(
3.1.2. write_table(df, target_table, pk, mode, doc_key)
-
역할: 파싱 완료 데이터프레임을 Delta Table에 기입할 때, 원본 내용 수정으로 발생한 고아 행을 제거하고 머지합니다.
-
동작 로직
- 1단계(고아 제거): 새로 들어온 소스 데이터프레임(
df) 내 문서 ID 목록과 대상 테이블 데이터를 왼쪽 안티 조인(Left-Anti Join)하여 기존 데이터 중 유효하지 않게 된 레코드(Orphan)를 식별하고 삭제(whenMatchedDelete)합니다. - 2단계(병합 적재): 식별 키 조건(
t.element_id = s.element_id)에 맞춰 Upsert(whenMatchedUpdateAll,whenNotMatchedInsertAll)를 수행합니다.
# data_processor.py - write_table 내 orphan 제거 및 데이터 병합(Merge) 로직 # 1단계: orphan DELETE if orphans.head(1) != []: (target_dt.alias("t") .merge(source=orphans.alias("o"), condition=f"t.{pk} = o.{pk} AND t.{doc_key} = o.{doc_key}") .whenMatchedDelete() .execute()) # 2단계: upsert MERGE (target_dt.alias("t") .merge(source=df.alias("s"), condition=f"t.{pk} = s.{pk} AND t.{doc_key} = s.{doc_key}") .whenMatchedUpdateAll() .whenNotMatchedInsertAll() .execute()) - 1단계(고아 제거): 새로 들어온 소스 데이터프레임(
3.2. distributed_parser.py 및 포맷별 분산 파서
3.2.1. DistributedParser.parsing(records_df, target_table)
- 역할: Spark의 분산 연산 엔진을 사용하여 대량의 문서를 병렬 파싱 처리합니다.
- 동작 로직
- 메타데이터 규격을 동기화하기 위해 Timestamp 타입을 임시 문자열로 정규화한 뒤
mapInPandas를 구동하여 각 워커 노드에서_parse_payload함수를 작동시킵니다.
- 메타데이터 규격을 동기화하기 위해 Timestamp 타입을 임시 문자열로 정규화한 뒤
3.2.2. _parse_payload(payload) 및 포맷별 파서
- 역할: 단일 문서의 본문을 파일 유형에 따라 전용 파서 클래스로 분기(Routing)시켜 텍스트를 구조화합니다.
- 식별자 생성: 추출된 개별 요소마다
{category}_{document_id}_{order}형태로 고유한element_id를 생성합니다.
4. [Task #3] 데이터 청킹(Data Chunking)
파싱된 문서 요소들을 RAG 시스템의 시맨틱 검색 정확도를 고려하여 의미적 문맥 손실이 없는 크기의 덩어리(Chunk)로 결합하고 분할하는 단계입니다.
4.1. chunk_builder.py 및 청크 빌더 메커니즘
4.1.1. ChunkBuilder.build_chunks(element_df, grouping_rules)
-
역할: 파싱 테이블의 요소들을 받아서 중복 제거 및 구조적 병합 처리를 진행한 청크 데이터프레임을 생성합니다.
-
동작 로직
- 노이즈 필터링:
columns_to_drop_null규칙에 따라 본문 내용이 없거나 빈 껍데기 요소를 드롭합니다. - 구조적 그룹핑: 정의된 포맷별 그룹 규칙(
grouping_rules)에 의거해 요소 데이터에 동일한group_key를 계산하여 부여합니다. - 데이터 병합 (Aggregation): 동일
group_key를 지닌 요소들의 본문을 순서대로 결합하고, 메타데이터 배열(링크 목록 등)을 중복 없이 모아 하나의 구조화된 JSON 데이터로 축약합니다. - 글자 수 임곗값 분할: 집계된 결과가 한계 설정값(
chunk_threshold_chars= 15,000자)을 상회할 경우 LangChain의RecursiveCharacterTextSplitter를 적용하여chunk_overlap_chars(= 500자) 크기의 중첩 구간을 두고 분할합니다. - 딥링크 연동: 사용자가 답변 출처 클릭 시 정확한 앵커 위치로 가도록 앵커 속성을 사용한
chunk_url을 동적으로 구성하고 고유한 PK(chunk_id)를 부착합니다.
# chunk_builder.py - RecursiveCharacterTextSplitter 기반 텍스트 분할 splitter = RecursiveCharacterTextSplitter( chunk_size=chunk_size, chunk_overlap=chunk_overlap, separators=["\n\n", "\n", ". ", "?", "!", " ", ""] ) chunks = splitter.split_text(text) - 노이즈 필터링:
4.1.2. 청킹 튜닝 파라미터 사양
| 설정 파라미터명 | 기본 설정값 | 조절 시 시스템 영향도 |
|---|---|---|
chunk_threshold_chars | 15,000자(약 6,000 토큰) | 상향 시: 청크당 문맥 정보가 확장되어 LLM 의미 해독력은 증가하나, 검색 시 컴퓨팅 자원 소비 및 지연 시간(Latency)이 증가할 수 있음. 하향 시: 핀포인트 정보 매칭 정확도 향상 및 비용이 감축되나, 문맥 소실 위험이 있음. |
chunk_overlap_chars | 500자(약 200 토큰) | 텍스트 한계 분할 지점에서 키워드가 찢어지는 단절 현상을 완화하기 위해 인접 청크 간 물리적 텍스트 중첩 분량을 제어함. |
columns_to_drop_null | [["content", "links", "image_path"]] | 본문, 하이퍼링크, 이미지 경로 정보가 모두 부재하는 노이즈 데이터를 원천 배제하여 데이터 정합성을 관리함. |
grouping_rules | {"document": ["heading3", "heading2", "heading1"]} | 파싱 계층 중 그룹화 결합의 기준이 되는 앵커 우선순위를 동적으로 할당함. |
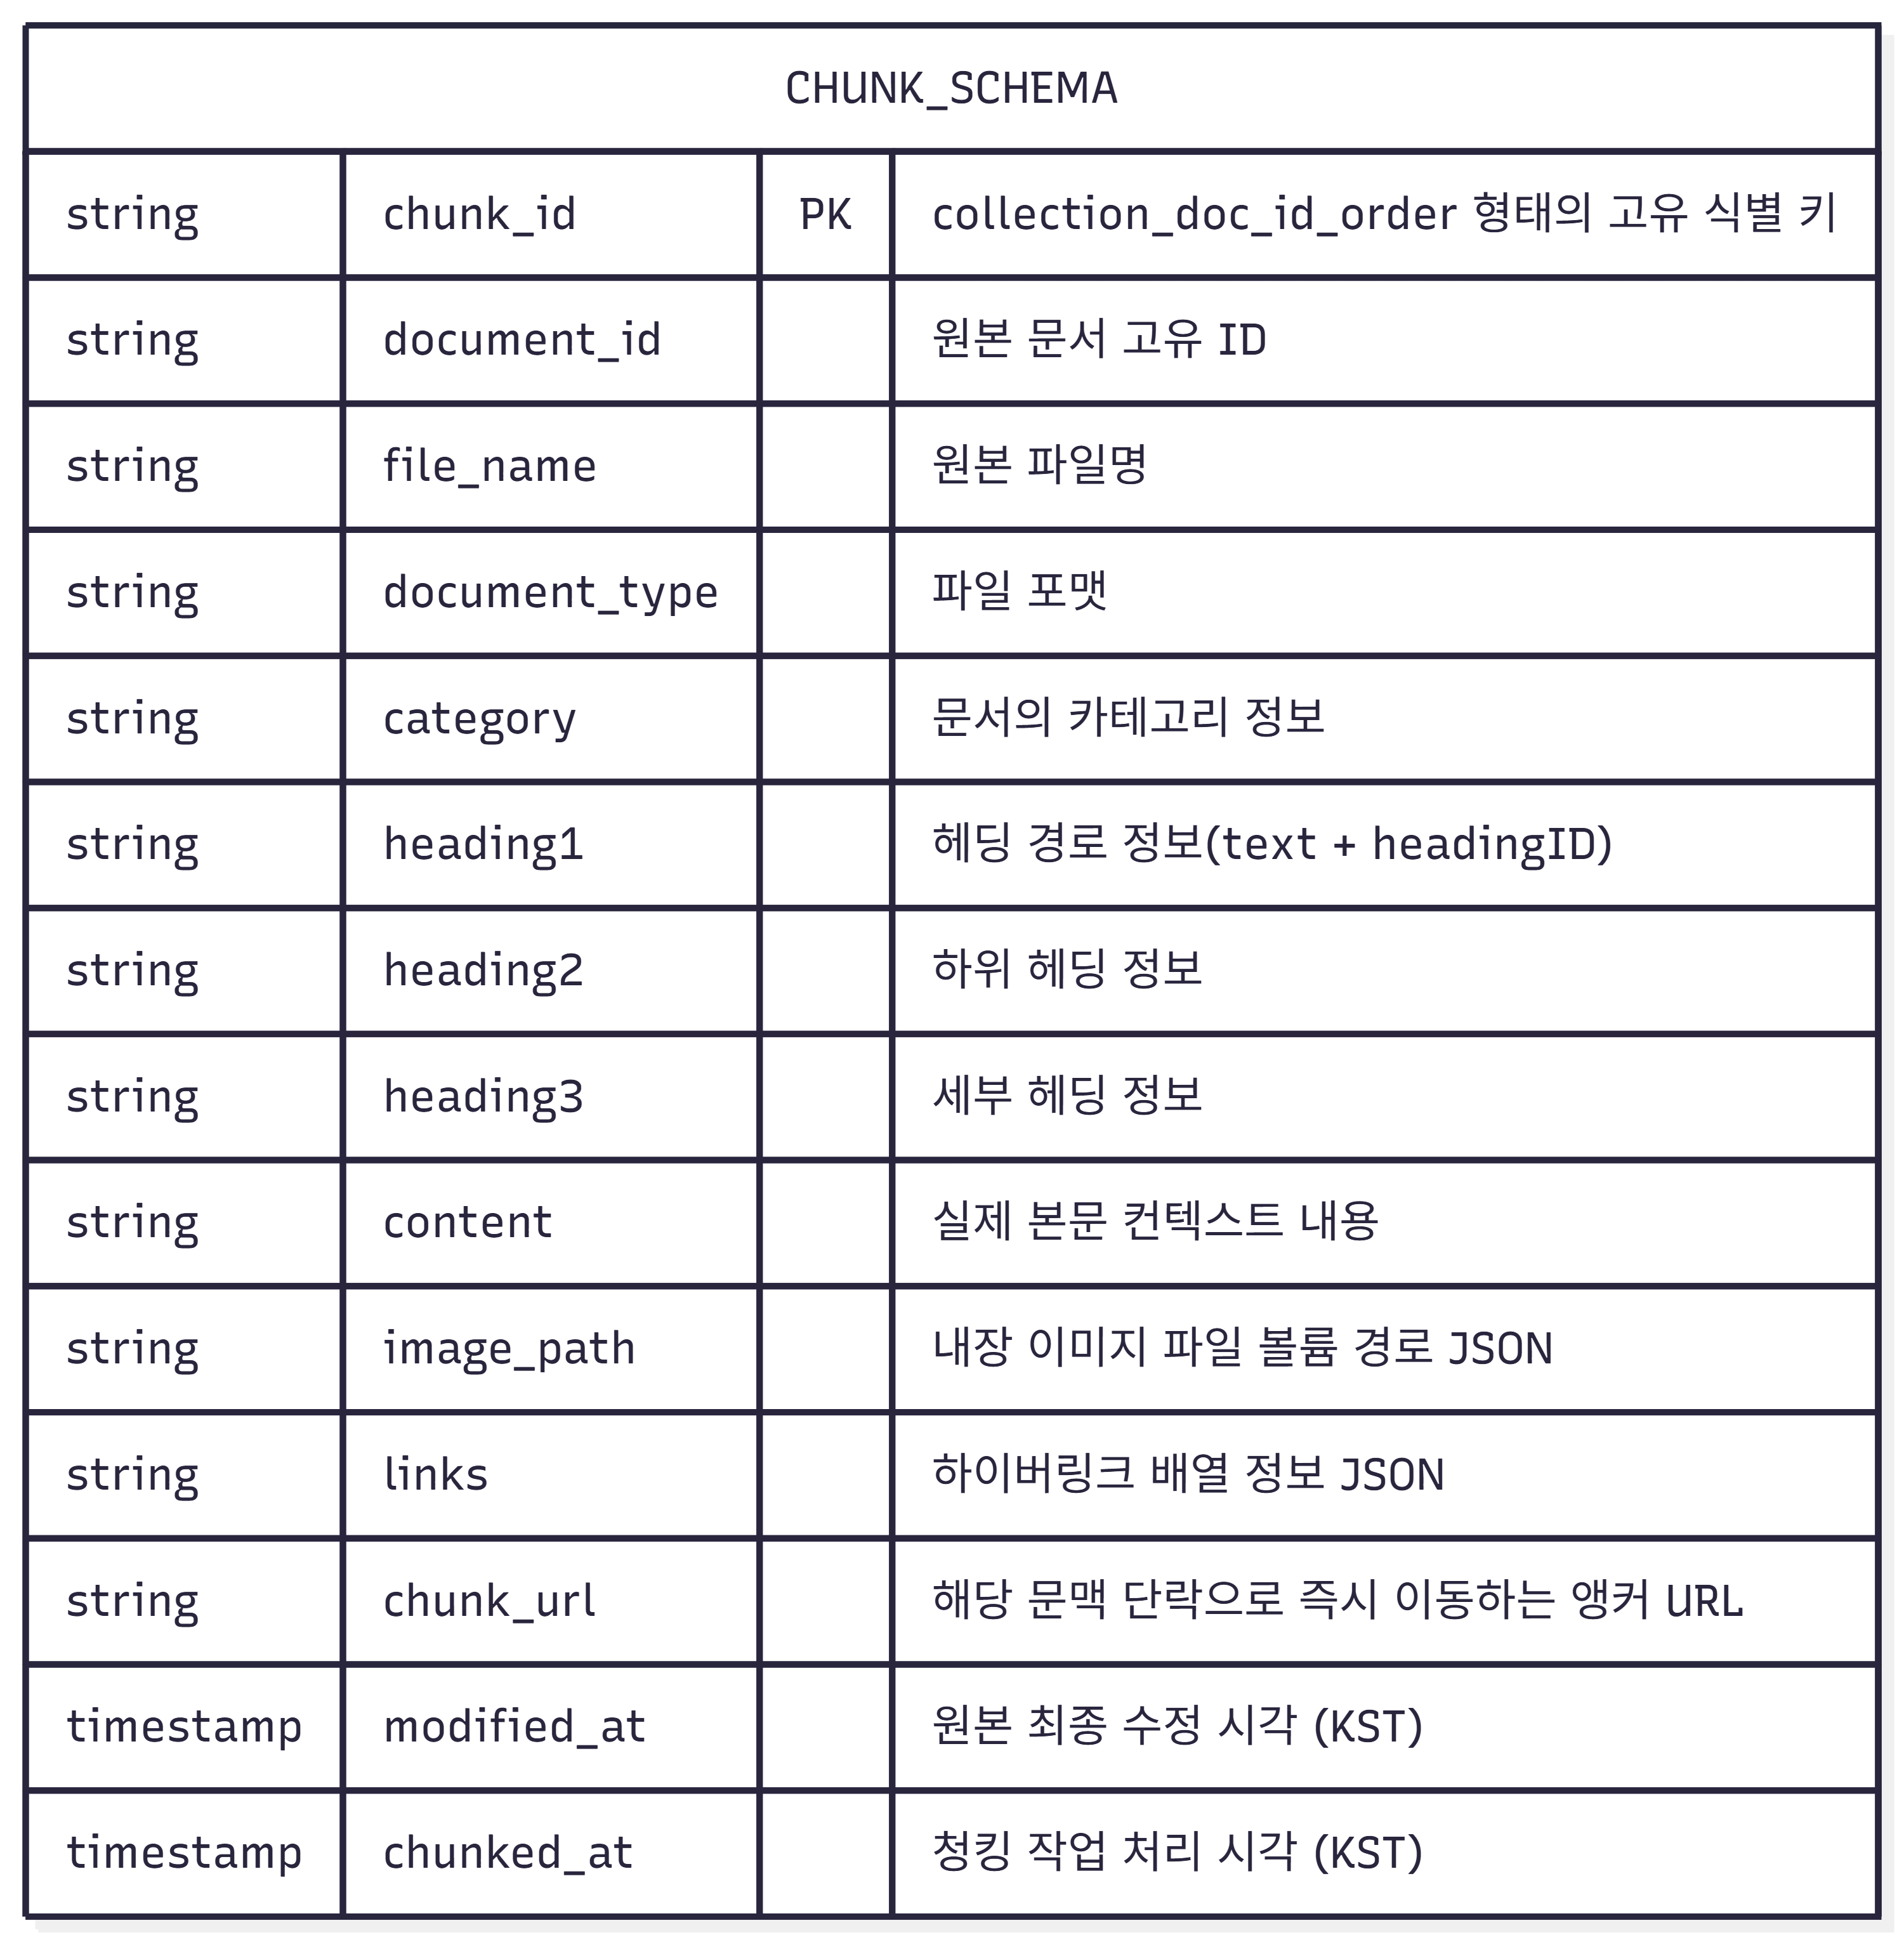
4.2. 청크 메타데이터 보존 구조
RAG의 사후 검색 및 소스 인용 신뢰도를 강화하기 위해, 최종 Delta Table에는 본문 외에도 확장 메타데이터 스키마를 유실 없이 보존합니다.
5. [Task #4] 데이터 벡터화(Data Vectorizing)
청킹 처리된 데이터를 검색 시스템이 계산할 수 있는 형태인 형태소 키워드(BM25 인덱싱용) 및 고차원 시맨틱 벡터(ANN 검색용)로 추출하고 계산하는 단계입니다.
Databricks
ai_query를 통한 분산 임베딩
임베딩 연산을 위해 외부 API를 사용하거나 복잡한 클라이언트 코드 및 호출 한도를 관리할 필요 없이, 데이터브릭스가 자체 호스팅하는 임베딩 모델 엔드포인트를 Spark 분산 처리 런타임 내에서 함수 형태로 직접 호출하는 방식입니다. 병목을 제어하고 연산을 병렬 처리합니다.
5.1. Kiwi 토크나이저 UDF 바인딩(kiwi_tokenizer.get_tokenize_udf)
- 역할: 사용자 사전(User Dictionary)과 불용어 사전(Stopwords)을 동적으로 로드하여 Spark 데이터프레임 내에서 동작하는 분산 형태소 분석용 토크나이징 UDF를 반환합니다.
- 동작 로직
- 구동 시점에 Unity Catalog Volume의 사용자 사전 경로(
USER_DICT_DIR)와 불용어 사전 경로(STOPWORDS_DIR) 내 파일을 스캔 및 병합하여 Kiwi 라이브러리에 주입합니다. 본 정보는 키워드 검색(BM25)의 색인 성능에 직접 기여합니다(세부 형태소 매칭 방식과 사전 문서는 별도로 다룹니다). - 핵심 분석기 설정: 형태소 판별 정확도가 우수한
model_type='cong'모델을 기본형으로 채택하고, 복합명사 분해 옵션(split_complex=True) 및 표준 어미 통합 옵션(integrate_allomorph=True)을 활성화하여 항공 전문 용어의 토큰화 성능을 보조합니다.
- 구동 시점에 Unity Catalog Volume의 사용자 사전 경로(
5.2. 키워드 컬럼 구성 및 임베딩 연산(changes_vectorizing)
-
역할: 데이터프레임에 검색용
keywords컬럼과 시맨틱 임베딩vector_column컬럼을 생성하고 대상 테이블에 기입합니다. -
동작 로직
ChunkBuilder.build_keyword_column메서드를 사용해 검색어가 포함될 대상 메타데이터(파일명, 카테고리 등)와 본문을 하나의 임시 필드로 묶습니다.- 설정된 토크나이저 UDF를 활용해 형태소 단어로 토큰화하여
keywords컬럼에 적재합니다. ai_query연산:Qwen 3 Embedding호스팅 모델 엔드포인트를 지정하여content컬럼의 본문 텍스트에 대해 1024차원 임베딩 연산을 분산 수행하고vector_column에 할당합니다.
# changes_vectorizing - ai_query를 통한 분산 임베딩 및 UDF 토큰화
morph_df = analysis_df.withColumn("keywords", tokenizer(F.col(temp_col_name))).drop(temp_col_name)
vectorized_df = morph_df.withColumn("vector_column", F.expr(f"ai_query('{EMBEDDING_MODEL}', content)"))
6. [Task #5] 인덱스 동기화(Indexing Sync)
임베딩과 형태소 분석이 종결된 최종 Delta Table 데이터를 원천 테이블로 하여 Databricks Vector Search의 벡터 검색 인덱스를 생성하거나 혹은 동기화하여 서비스에 반영하는 단계입니다.
Self-managed Index 방식
프로젝트 수행 당시 Databricks가 벡터화를 전담하는 Managed Index 방식은 동기화 필드 중 메타데이터 성격의 텍스트 컬럼까지 키워드 검색 엔진(BM25)의 색인 대상으로 처리하여 검색 노이즈가 발생하는 한계가 있었습니다(현재는 Fix됨). 이를 제어하기 위해 본 프로젝트에서는 본문 임베딩 컬럼(vector_column)과 키워드 전용 컬럼(keywords)을 미리 수동 계산하여 생성해 두고, 인덱스는 지정된 컬럼만 동기화하도록 유도하는 Self-managed 방식을 채택합니다.
6.1. VectorSearchManager.create_or_sync_index
-
역할: 지정된 Vector Search 엔드포인트 내에 인덱스의 존재 여부를 검사하고, 유효한 명세에 따라 신규 생성하거나 기존 인덱스의 델타 동기화 트랜잭션을 트리거합니다.
-
동작 로직
get_embedding_dimension메서드를 통해 모델에 테스트용 텍스트를 인가하여 현재 활성화된 임베딩 차원(1024차원)을 확인합니다.managed=False설정을 사용하여 Self-managed 모드로 인덱스를 지정합니다.- 데이터 파이프라인 지연을 방지하기 위해
sync_index=True옵션을 인가하여 Delta Table에 최종 누적된 변경 내역(CDC)이 인덱스 검색 엔진으로 즉시 전파되도록 비동기 동기화 트리거를 호출합니다.
# changes_indexing - Vector Search Index 동기화 트리거
vs_manager.create_or_sync_index(
    endpoint_name=names.vector_search_endpoint,
    index_full_name=names.vector_index,
    source_table=names.vectorized_raw,
    primary_key="chunk_id",
    managed=False,
    vector_column="vector_column",
    embedding_dimension=embedding_dimension,
    columns_to_sync=["chunk_id", "vector_column", "keywords", "category"],
    sync_index=True,
)
6.2. 인덱스 설정 파라미터 정의
| 파라미터명 | 설정값 | 역할 및 비고 |
|---|---|---|
primary_key | "chunk_id" | 인덱스 유일 식별을 위한 테이블 및 색인 PK로 활용 |
managed | False | 자동 벡터화를 배제하고, 사용자 정의 필드(vector_column)를 벡터 검색 대상으로 선언 |
vector_column | "vector_column" | 벡터 ANN(근사 최근접 이웃) 검색을 수행할 1024차원의 타깃 벡터 컬럼을 지정 |
columns_to_sync | ["chunk_id", "vector_column", "keywords", "category"] | 동기화 과정에서 색인 물리 스토리지에 탑재하여 검색 후 필터 또는 결과 렌더링에 사용할 대상 컬럼 묶음을 한정 |
sync_index | True | 백그라운드 스케줄러를 기다리지 않고 데이터 갱신 시점에 동기화 연산을 즉시 트리거하여 색인 최신성을 관리 |