이 시리즈는 Databricks 환경에서 구축했던 항공/운송/물류 분야의 RAG Agent 구축 프로젝트 관련 내용을 정리하는 시리즈입니다. 요구사항과 관련하여 Databricks의 어떤 기술을 사용해 이를 충족하였으며, 수행 중 발생한 문제 상황을 어떻게 해결했는지 정리합니다.
실제 고객사에서 수행한 프로젝트와는 별도의 내용으로, 기술적인 내용만을 정리합니다.
1. RAG 에이전트 시스템 개요(Agent System)
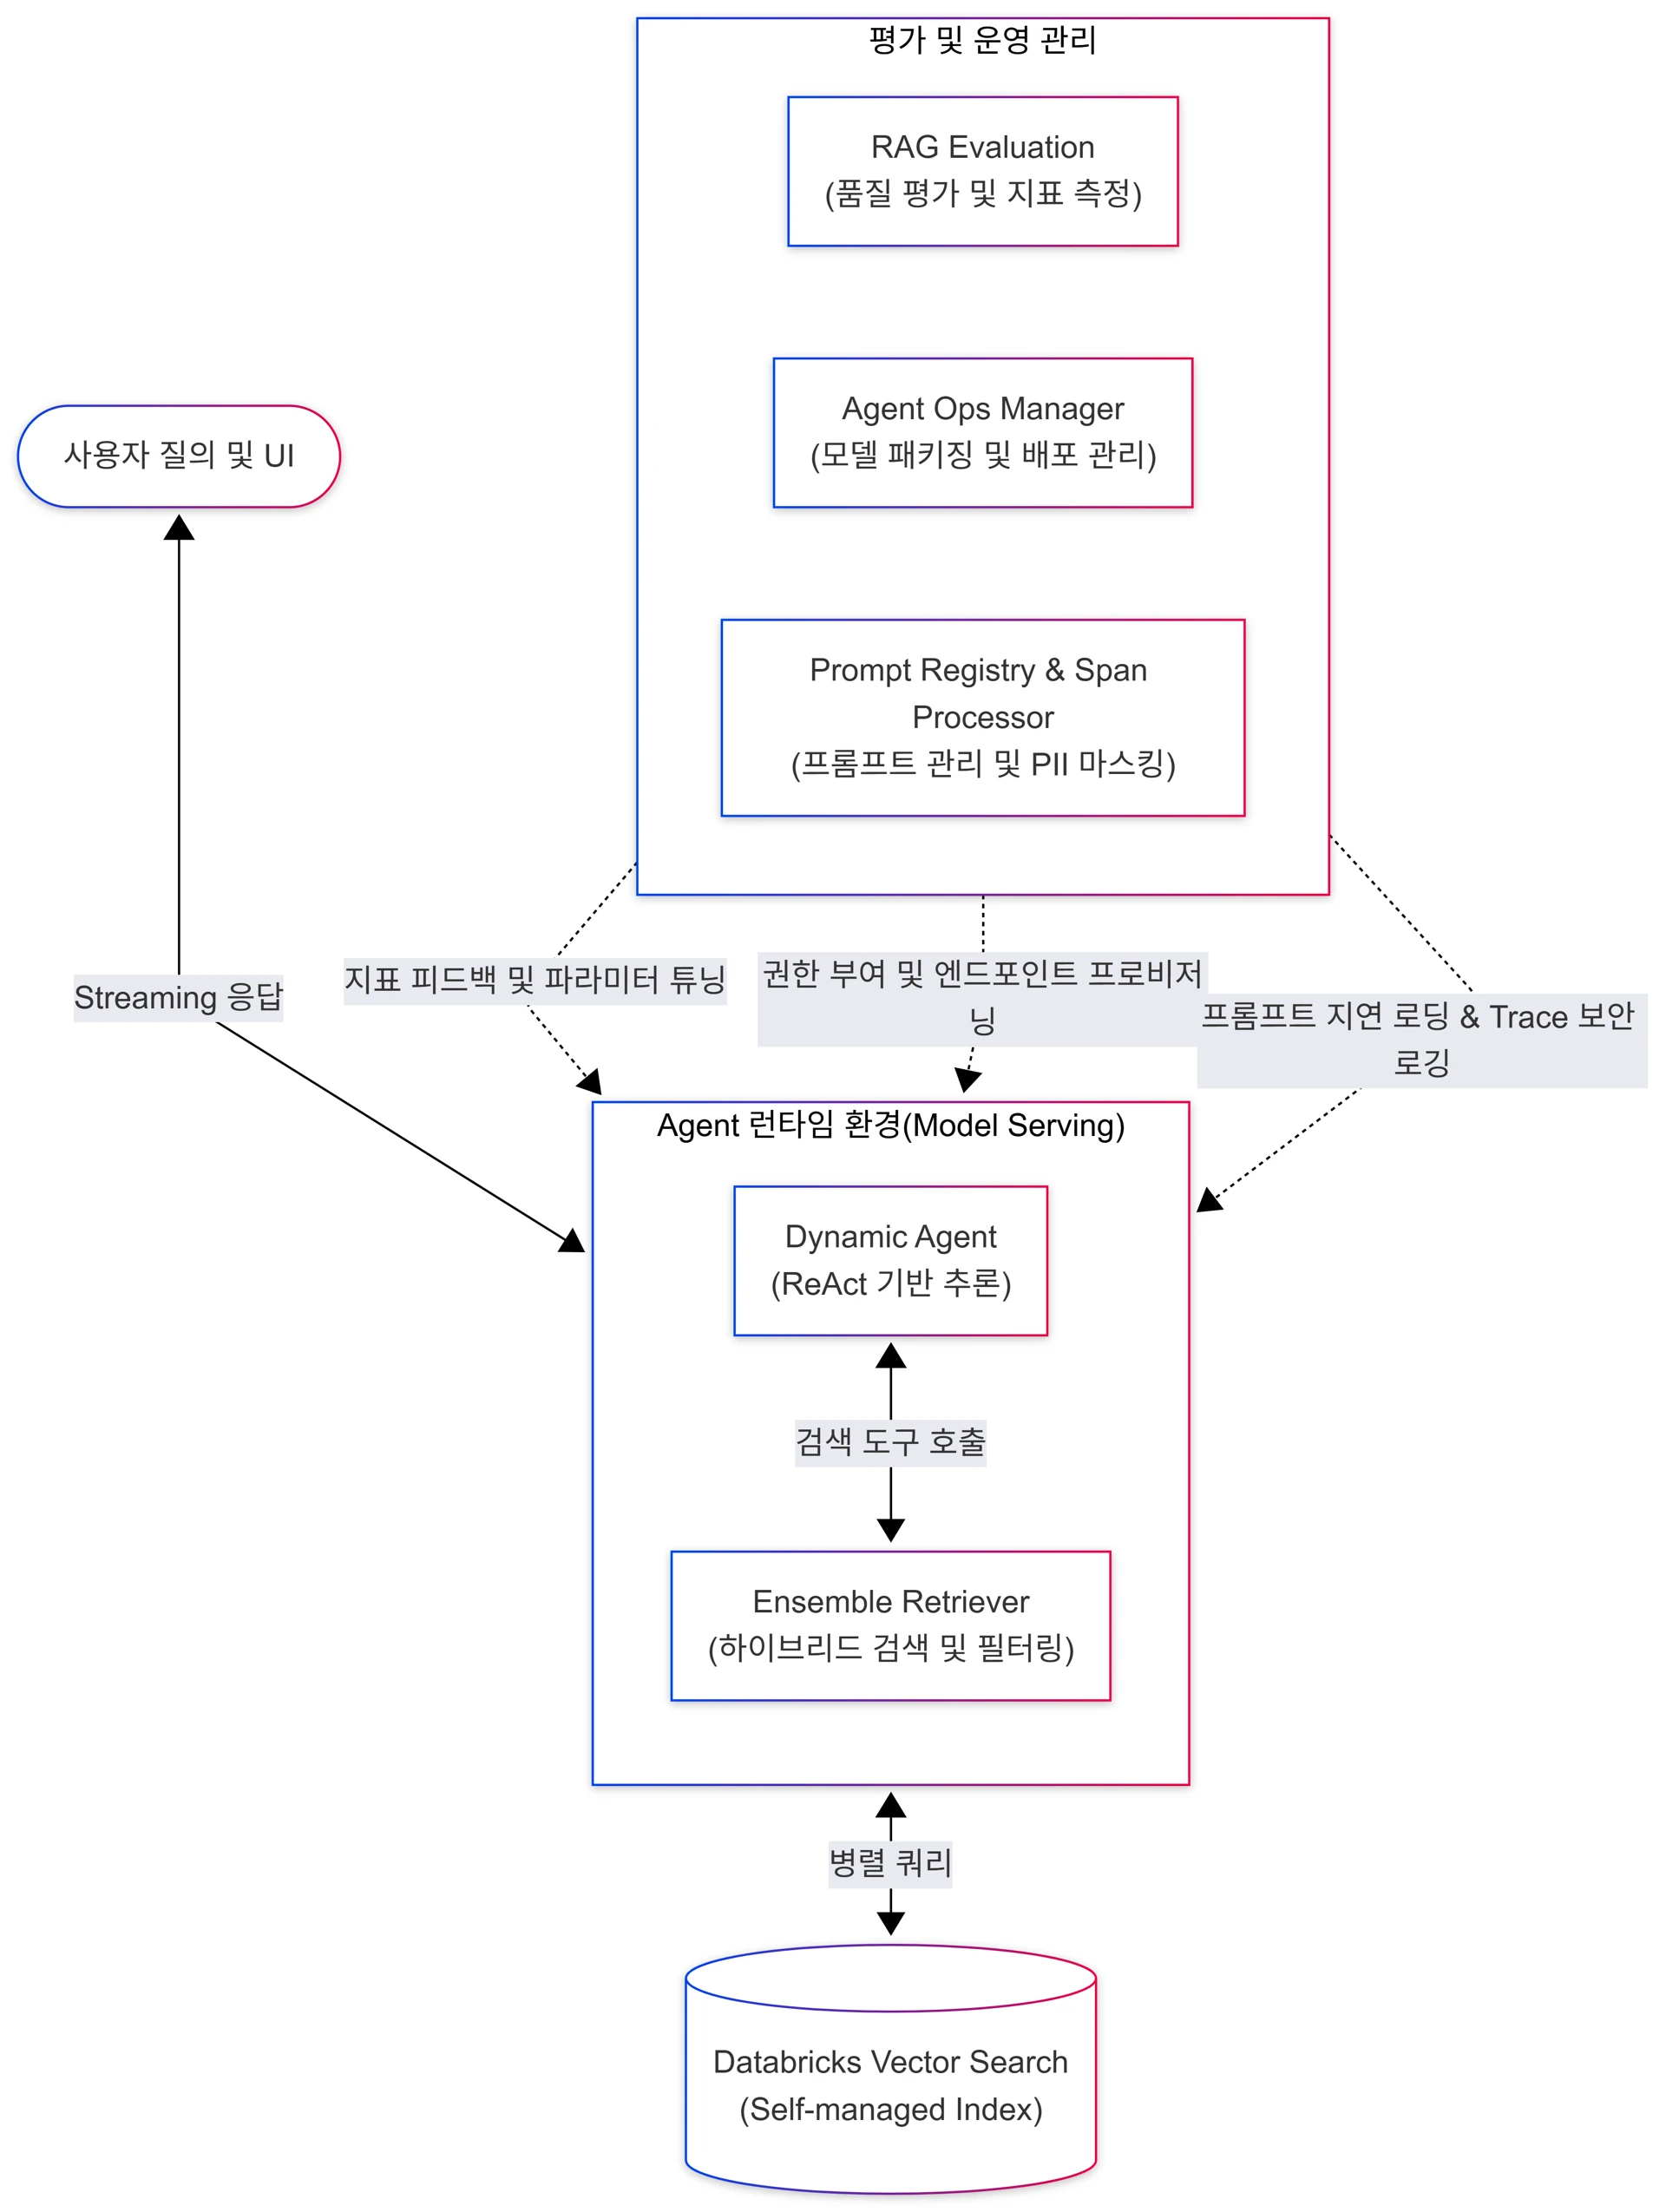
RAG 시스템의 핵심 추론 엔진이자 검색 오케스트레이터인 에이전트 파이프라인의 전체 구조와 구성 모듈을 다룹니다. 에이전트 시스템은 사용자의 질의를 수신하고 실시간 하이브리드 검색을 통해 답변을 생성하는 Runtime 영역과, 모델 패키징, 배포, 권한 관리를 제어하는 Management & Ops 영역으로 이루어집니다.
[참고] 6월 13일자로 DBRX의
Vector Search가AI Search로 명칭이 변경되었습니다. 다만 본 프로젝트에서는 시기상 프로젝트의 후반임을 고려하여 기존 버전을 고정시켜 작업하였으므로 Vector Search를 그대로 사용하였습니다.
1.1. 에이전트 시스템 구성도
1.2. 주요 구성 모듈 정의
| 모듈명 | 참조 소스 파일 | 핵심 역할 |
|---|---|---|
| Dynamic Agent | agent.py | LangGraph 프레임워크와 ReAct 방법론을 기반으로 동작하는 추론 엔진으로, LLM 호출과 검색 도구(Tool) 실행 흐름을 제어합니다. |
| Ensemble Retriever | ensemble_retriever.py | 시맨틱 검색(ANN)과 키워드 검색(BM25)을 병렬 수행하고, 정규화 병합(Fusion), Claim-Check, Self-RAG 적합성 판정을 전담합니다. |
| Agent Ops Manager | agent_ops_manager.py | 환경 설정을 병합하고, 로컬 에이전트 기능 검증(Smoke Test), Unity Catalog 모델 등록, Model Serving 엔드포인트 프로비저닝 및 권한 제어를 수행합니다. |
| Prompt Registry & Span Processor | prompt_manager.pyspan_processor.py | MLflow Prompt Registry 연계 및 캐싱을 처리하고, 백엔드 추적(Trace) 로그 상의 개인 식별 정보(PII)를 비동기로 마스킹합니다. |
2. Dynamic Agent(DynamicToolCallingAgent)
사용자의 대화 맥락을 유지하면서 검색 도구를 호출하고, 생성된 최종 답변을 실시간으로 스트리밍하는 핵심 추론 모듈입니다.
2.1. 진입점 구조 및 요청 라우팅(predict_stream)
에이전트는 MLflow Model Serving 표준 인터페이스 규격을 충족하기 위해 predict_stream 진입점 메서드를 제공합니다. 이 메서드는 외부 클라이언트로부터 전달되는 REST API 페이로드를 역직렬화하여 처리합니다.
- 입력 검증:
mlflow.types.responses.ResponsesAgentRequest스키마를 사용하여 사용자 질의(query), 대화 이력(history), 그리고 세션 파라미터에 대하여 유효성을 검증합니다. - 출력 스트리밍: 연산 결과를
ResponsesAgentStreamEvent규격의 제너레이터(Generator) 객체로 스트리밍 반환하며, 텍스트 토큰과 참조 출처 목록, 내부 추론 상태 메시지를 다중 채널로 다중화하여 출력합니다.
2.2. LangGraph 기반 ReAct 상태 머신 설계
에이전트의 워크플로는 LangGraph를 이용해 상태 저장형(Stateful) 제어 흐름 그래프로 컴파일됩니다.
2.2.1. 상태(State) 정의
AgentState구조: 대화 히스토리인messages(Annotated[List[BaseMessage], operator.add])와 현재 반복 횟수인agent_steps(int)로 이루어진 상태 객체(TypedDict)입니다.operator.add어노테이션은 신규 메시지가 발생할 때마다 기존 리스트에 원소로 자동 추가되도록 제어합니다.
2.2.2. 노드 및 간선 구조
agent노드: 현재AgentState를 기반으로 시스템 프롬프트 및 사용자 질의를 종합하여 LLM에 추론을 요청합니다. 도구 실행 조건이나 최종 응답을 판단합니다.tools노드:agent노드가 반환한 메시지 내부에tool_calls목록이 발견되면 실행되는 영역입니다. 주입된vs_execute(벡터 검색 도구)를 구동하고 검색 결과를 관찰(Observation) 메시지로 변환해 상태에 추가합니다.should_continue조건부 간선(Conditional Edge):agent노드의 출력 메시지를 검사하여,tool_calls가 존재하고agent_steps가max_iterations보다 작으면tools노드로 실행 흐름을 보냅니다. 그렇지 않으면 최종 답변 출력을 위해 그래프 연산을 종료(END)합니다.
2.3. 멀티스레드 서빙 환경에서의 ContextVars 격리 패턴
Model Serving 서비스는 단일 프로세스 내 멀티 스레드로 구동되어 다수의 사용자 트래픽을 처리합니다. 인스턴스 전역 변수를 사용할 경우 요청 간 데이터 혼선이 유발되므로, 파이썬 표준 라이브러리인 contextvars를 적용하여 요청 컨텍스트를 스레드 단위로 완전히 격리합니다.
_collection_filter_var: 사용자가 입력한 카테고리 필터링 명령어 프리픽스(예:/manual)를 기반으로 타깃 인덱스를 전환하기 위한 격리 필터 저장소입니다._seen_chunk_ids_var: 단일 요청 내에서 다회 검색(Iteration)이 수행될 때, 이전 라운드에서 이미 LLM에게 제공된 문서 조각(chunk_id)이 재차 조회되어 프롬프트를 낭비하는 현상을 차단하기 위해 중복 식별용 Set을 컨텍스트별로 유지합니다._retrieved_refs_var: 검색 과정에서 획득한 모든 문서 후보군을 모아두는 독립 리스트입니다._sources_map_var: 최종 렌더링에 필요한 출처 URL과 세부 메타데이터 매핑 딕셔너리를 격리 관리합니다.
2.4. 세부 예외 방어 및 모델 호환성 최적화
2.4.1. 장애 복구 폴백(Fallback) 모델 라우팅
-
메인 추론 API 엔드포인트(
llm_endpoint)가 대량 호출로 인해 HTTP 500, 502, 503, 504 장애를 반환할 때 작동하는 방어선입니다. -
예외 핸들러가 50x 에러를 감지하면, 사전에 지정된
fallback_llm_endpoint가 존재하는 경우ChatDatabricks인스턴스를 실시간으로 재생성하고 도구(Tools) 바인딩 명세를 다시 주입하여 호출을 대행함으로써 추론 실패를 예방합니다.# agent.py - 기본 LLM 장애 시 폴백 LLM 호출 제어 def _invoke_with_fallback(self, llm_with_tools, tools, messages: list[BaseMessage]) -> BaseMessage: try: return llm_with_tools.invoke(messages) except (MlflowException, DeploymentsMlflowException) as e: status_code = getattr(e, 'http_status_code', 500) if status_code in [500, 502, 503, 504] and self.fallback_llm_endpoint: fallback_llm = ChatDatabricks( endpoint=self.fallback_llm_endpoint, temperature=self._temperature, top_p=self._top_p if self._top_p is not None else 1.0, ) return fallback_llm.bind_tools(tools).invoke(messages) raise e
2.4.2. Gemini 모델 thoughtSignature 보존 패치
ChatDatabricks라이브러리는 도구 호출 메시지를 파싱하여BaseMessage객체로 역직렬화할 때, Gemini 모델이 출력한 추론 과정인thoughtSignature키 값을 직렬화 스키마에서 배제하여 누락시키는 현상이 있습니다.- 이를 해결하기 위해
_chat_models._get_tool_calls_from_ai_message함수를 래핑하는 멍키 패치(_patched_get_tool_calls)를 내장하여, 모델 서빙의 추적 span 상에 리즈닝 정보가 남도록 우회 설계했습니다.
2.4.3. 도구 인자 역직렬화 예방(_sanitize_tool_calls)
- 일부 구형 LLM 또는 모델 제공 벤더사의 엣지 케이스로 인해 도구 호출 인자(
args)가 딕셔너리가 아닌 직렬화된 JSON 문자열 형태로 도달하는 경우가 있습니다. - LangGraph의
ToolNode는 내부 연산 시args가 파이썬 딕셔너리 구조일 것을 기대하므로, 인자가 문자열일 경우json.loads및ast.literal_eval을 순차 적용하여 강제 딕셔너리 객체화하는 정제 코드를 실행합니다.
2.4.4. 멀티턴 프롬프트 클리닝(_strip_source_artifacts)
- 대화가 길어지는 멀티턴 대화 상황에서, 프론트엔드가 이전 답변과 함께 전송한 출처 식별자(
<<SOURCES>>...) 및 참조 블록(**출처:**)을 정규 표현식으로 추출해 제거하고 순수 텍스트 본문만 LLM에 재입력합니다. - 이를 통해 LLM 프롬프트에 불필요한 메타 JSON 데이터가 누적되어 토큰 비용이 급증하고, 모델이 자기 복제된 출처를 재참조하여 답변 품질이 저하되는 현상을 예방합니다.
3. 하이브리드 검색 도구(HybridEnsembleRetriever)
시맨틱 근사 검색(ANN)과 키워드 정합 검색(BM25)의 결과를 융합하고, 원본 테이블 조인 및 적합성 평가를 거쳐 가장 연관성이 높은 문서를 반환하는 모듈입니다.
3.1. 4단계 검색 파이프라인 상세 처리 로직
3.1.1. 1단계: 병렬 하이브리드 검색
- 검색 도구(
vs_execute)가 동작하면 질의 키워드 분석과 벡터화가 동시에 개시됩니다. - 시맨틱 검색:
DatabricksEmbeddings를 경유하여 질의를 1024차원의 임베딩 벡터로 전환한 후,WorkspaceClient.vector_search_indexes.query_indexAPI를 호출해 근사 최근접 이웃(ANN) 벡터 매칭을 수행합니다. - 키워드 검색: 동일 시점에 질의 텍스트를 형태소 분석기 UDF(
kiwi_tokenizer)에 인가하여 검색 키워드 목록을 추출하고, 이를 결합하여query_indexAPI의query_text매개변수로 넘겨 풀텍스트(Full-Text) 정합 매칭을 실행합니다. - 병렬 수행: 검색 지연 속도를 단축하기 위해 두 가지 서로 다른 성격의 API 호출 작업을
ThreadPoolExecutor를 사용해 병렬 스레드로 동시 호출합니다.
3.1.2. 2단계: 결과 점수 융합(hybrid_fusion)
- 시맨틱 인덱스와 키워드 인덱스에서 산출된 유사도 점수는 척도(Scale)와 값의 도메인이 다릅니다. 이들을 결합하기 위해 다음 알고리즘을 지원합니다.
- Min-Max 정규화: 수집된 결과들의 점수 분포에 따라 최솟값과 최댓값을 구하고, 공식을 사용하여 각 점수를
[0.0, 1.0]범위로 리스케일링합니다.
- RRF(Reciprocal Rank Fusion): 순위 기반의 강인한 병합 기법으로, 각 검색 채널의 순위 역수를 구하여 결합합니다.
- 최종 점수 산출: 설정된
semantic_weight비중을 적용하여 가중 합산 점수를 산출한 후 전체 후보군을 재정렬합니다.
- Min-Max 정규화: 수집된 결과들의 점수 분포에 따라 최솟값과 최댓값을 구하고, 공식을 사용하여 각 점수를
3.1.3. 3단계: 원본 조인 및 유사 BM25 계산(Claim-Check & Post-hoc BM25)
-
Claim-Check 패턴: 인덱스의 저장 용량을 줄이고 딥링크 URL 등의 메타데이터 오염으로 인한 BM25 스코어 왜곡을 완화하기 위해, Vector Search Index에는
chunk_id와 같은 최소 식별 정보만 보관합니다. 점수 융합 정렬이 끝난 최상위 후보chunk_id들을 추려내어, 서버리스 Spark Connect 세션을 사용해 실시간으로 원천 Delta 테이블과 조인(Join)하여 본문content데이터를 즉석에서 조회해 가져옵니다.[참고] AI Search의 업데이트와 함께 FTS 대상 컬럼의 지정이 가능하게 되었습니다. 따라서 차후에는 이와 같은 Ensemble Retriver 방식으로의 구현, 그리고 Claim-Check 패턴의 적용이 불필요할 것으로 판단됩니다.
3.1.4. 4단계: Self-RAG 문서 적합성 판정(_judge_relevance)
use_judge설정이 활성화된 경우 구동되는 LLM 기반 필터 단계입니다.- Claim-Check를 통해 복원된 전체 문서 본문 내용과 사용자의 원래 쿼리를 시스템 프롬프트(
SELF_RAG_JUDGE_PROMPT)와 함께 소형 판정 LLM(judge_llm)에 주입합니다. - 모델은 문서를 개별 평가하여 문서가 사용자의 답변 작성에 유효한 정보인지 판별한 후
YES또는NO텍스트로 결과를 응답합니다.NO로 판정된 불필요한 노이즈 문서는 컨텍스트에서 제외되며, 만약 수집된 모든 문서가NO판정을 받아 답변 생성이 불가능하다고 여겨지는 경우needs_additional_retrieval=True플래그를 에이전트 핵심 노드에 전달해 추가 검색 시도 또는 적절한 예외 응답을 출력하도록 제어합니다.
3.2. Databricks 서버리스 연동 및 런타임 우회 기법
-
Lazy Initialization: 컨테이너 콜드 스타트 시 인프라 지연 시간을 낮추기 위해, 무거운 외부 커넥션 개체인
spark세션과judge_llm객체는 멤버 변수가 아닌 파이썬@property구조를 도입하여 최초로 호출되는 3단계/4단계 시점에 지연 생성하여 메모리에 올립니다. -
StreamToLogger 결함 Shim 패치: MLflow Model Serving 표준 런타임은 디버깅 출력을 캡처하기 위해
sys.stdout객체를 전용StreamToLogger인스턴스로 동적 변경합니다. 이 특수 클래스는 일반 스트림과 달리isatty()속성이 존재하지 않습니다. 이 때문에 Spark Connect 모듈 임포트 시 내부 IPython 로더가sys.stdout.isatty()호출을 시도하다AttributeError를 발생시키며 컨테이너 기동을 실패시키는 버그가 있습니다. 이를 무력화하기 위해, Spark 세션을 획득하기 직전 stdout/stderr 객체에 강제로 더미isatty호출용 람다 함수를 동적으로 결합해 두어 정상 가동되도록 우회 조치했습니다.# ensemble_retriever.py - isatty 결손 우회 및 Lazy Spark 세션 획득 @property def spark(self): if self._spark is None: import sys for stream in (sys.stdout, sys.stderr): if not hasattr(stream, "isatty"): try: stream.isatty = lambda: False except (AttributeError, TypeError): pass from databricks.connect import DatabricksSession self._spark = DatabricksSession.builder.serverless().getOrCreate() return self._spark
4. 에이전트 운영 및 배포 관리(AgentOpsManager)
이 모듈은 로컬 환경의 에이전트 코드를 검증하고, 필수 에셋 파일 및 리소스 인증 바인딩 규격을 하나의 아티팩트로 압축하여 Unity Catalog 모델 레지스트리에 적재 및 엔드포인트 배포를 자동화하는 모듈입니다.
4.1. 배포 파이프라인 관리 프로세스
4.1.1. 1단계: 환경 설정 병합 및 런타임 오버라이드
config.yaml에 지정된 기본 설정을 읽어온 후, 주입된 위젯 값(project,env,subject)을 해석합니다.- 환경에 대응하는 카탈로그명, 데이터베이스 테이블명, 프롬프트 레지스트리 경로명 등을 동적으로 주입하여 기본 설정을 덮어씁니다.
4.1.2. 2단계: 사전 런타임 스모크 테스트(streaming_test)
Unity Catalog 로깅과 물리 서빙 컨테이너를 프로비저닝하는 과정은 시간과 비용이 많이 소요됩니다. 따라서 패키징 단계에 앞서 streaming_test 메서드를 호출하여 샘플 질의를 메모리 속 에이전트 인스턴스에 통과시켜 스트리밍 데이터를 검증하는 스모크 테스트를 수행합니다. 이를 통해 설정 오류나 데이터베이스 자격 증명 문제를 사전에 파악하여 잘못 구성된 모델 버전이 레지스트리에 적재되는 구조를 예방합니다.
4.1.3. 3단계: Unity Catalog 모델 로깅 및 사전 동봉(log_to_uc)
-
에이전트 구동 과정에서 사용되는 형태소 토크나이저의 사용자 사전(
user_dict), 동의어 사전(synonyms), 불용어 사전(stopwords) 파일들을 Unity Catalog Volume 스토리지로부터 읽어옵니다. -
이 사전 파일들을 배포 패키지 디렉토리 내부의 임시 경로에 복사하여 적재(Pre-bake)함으로써, 서빙 엔진이 구동되었을 때 외부 네트워크 스토리지 연동 없이 컨테이너 로컬 경로 상에서 형태소 사전 파일을 직접 파싱할 수 있게 조율합니다.
-
에이전트가 런타임에 접근하여 쿼리를 인가해야 하는 모델 서비스 엔드포인트(
DatabricksServingEndpoint)와 검색 대상 인덱스(DatabricksVectorSearchIndex)에 대한 리소스 종속성 스키마를 생성하여 모델 아티팩트에 명시적으로 바인딩합니다.# agent_ops_manager.py - 형태소 사전 동봉 및 Unity Catalog 모델 로깅 예시 def log_to_uc(self, model_name: str): # 아티팩트 보관용 임시 경로로 사전 파일들 복사 self._prepare_dictionary_artifacts() # MLflow 모델 패키징 및 리소스 종속성 매핑 resources = [ DatabricksVectorSearchIndex(index_name=self.index_name), DatabricksServingEndpoint(endpoint_name=self.llm_endpoint) ] mlflow.langchain.log_model( lc_model=self.agent_path, artifact_path="agent", registered_model_name=model_name, resources=resources, code_paths=self.code_paths )
4.1.4. 4단계: 엔드포인트 배포 및 RBAC(Role-Based Access Control) 접근 제어(deploy)
- 등록 및 검증이 종결된 모델 버전을 바탕으로
databricks.agents.deployAPI를 가동하여 서버리스 Model Serving Standard 엔드포인트를 프로비저닝합니다. - 기동이 완료되면, 기본 비공개 정책이 걸린 엔드포인트를 대상으로 사전에 등록된 운영자 관리 그룹에 대해서는 관리 권한(
CAN_MANAGE), 실 사용 권한 그룹과 사내 포털 연동용 서비스 프린시펄(Service Principal) 계정에 대해서는 호출 권한(CAN_QUERY)을 API 권한 명세 구조(ServingEndpointAccessControlRequest)를 사용해 원격으로 등록하여 배포 파이프라인을 최종 완료합니다.
5. 프롬프트 캐싱 및 Trace 보안 로깅
이 장에서는 agent.py 소스코드 레벨에서 MLflow 프롬프트 레지스트리와 연계하고 보안 개인정보 마스킹 필터를 활성화하는 연산 메커니즘을 설명합니다.
5.1. 프롬프트 캐싱 및 예외 방어 구현(_get_system_prompt)
- 프롬프트 동적 핫로딩:
agent.py기동 시mlflow.set_tracking_uri("databricks")및mlflow.set_registry_uri("databricks-uc")설정을 적용하여 Unity Catalog 프롬프트 레지스트리를 조인합니다. - TTL 캐시 기법: 런타임 성능 보존을 위해
_get_system_prompt메서드는 메모리 캐시 변수(self._prompt_cache)와 타임스탬프(self._prompt_cache_time)를 비교하여 캐시 수명(self._prompt_ttl= 300초)을 초과한 경우에만mlflow.genai.load_prompt를 실행하여 갱신합니다. - 이중 우회 방어선(Last-Known-Good & Default)
- 프롬프트 갱신 도중 네트워크 단절 등으로 예외가 발생하면 예외 블록이 가로채 콘솔 경고를 출력하고 이전에 성공적으로 조회해 둔 캐시(Last-Known-Good)를 그대로 반환하여 장애를 차단합니다.
- 최초 구동 시점에 로드가 실패하여 캐시조차 존재하지 않는 엣지 케이스가 발생할 때에만 비상 수단으로 소스 코드에 기본 탑재된 로컬
SYSTEM_PROMPT를 할당합니다. - 프롬프트 로딩 성공 시
prompt_load_successspan을 기록하며, 실패 시에는 원격 진입 주소 정보를 attributes에 담아prompt_load_failurespan으로 Trace DB에 남깁니다.
5.2. korean_pii_redactor 마스킹 연계(bootstrap)
- 부트스트랩 시점의 바인딩:
agent.py하단부의bootstrap()진입 함수 내에서mlflow.tracing.configure(span_processors=[korean_pii_redactor])를 명시적으로 기동하여, 컨테이너 전역의 MLflow 로깅 시스템에 개인정보 마스킹 Span Processor를 이식합니다. - 비동기 마스킹 위임: 사용자가 챗봇을 호출할 때는 본문에서 담당자 연락처 등이 무손실로 조회되지만, 백그라운드에서 Trace 수집 및 모델 서빙 플랫폼으로 로그를 전송(OTel 비동기 export)하는 최종 단계에서는
korean_pii_redactor가 Span 내부의 inputs/outputs 텍스트를 재귀 검사(deep_scrub)하여 민감한 이메일, 전화번호, 주민번호 패턴을 마스킹 처리합니다.
6. 엔드포인트 물리 배포 사양 및 OAuth 연동
이 장에서는 agent.py가 데이터브릭스 서빙 엔진 및 외부 인증과 연동될 때 코드 수준에서 작동하는 데이터 파이프라인 흐름을 기술합니다.
6.1. MLflow Trace 정보 업데이트 연산
- 요청/응답 갱신:
predict_stream내에서 현재 활성화된 API 턴의 쿼리를 추출하여mlflow.update_current_trace(request_preview=plain_question)를 호출하고, 본문 조립 완료 시점에mlflow.update_current_trace(response_preview=full_text)를 실행합니다. 이를 통해 MLflow Trace UI 상에서 복잡한 LangGraph 노드 로그를 열지 않고도 원본 질문과 평문 답변을 미리보기 화면에서 즉시 모니터링할 수 있습니다. __meta__호출 시의 Trace UI 노이즈 클리닝- 프론트엔드가 슬래시 명령어 자동완성 필터 목록을 쿼리하기 위해 특수 센티넬 문자열인
__meta__를 담아 에이전트에 요청을 전송하는 특수 케이스가 있습니다. - 에이전트는 이를 감지하면 즉시 JSON 명세를 반환함과 동시에, Trace 모니터링 UI 상에 불필요한 슬래시 자동완성 로그가 누적되는 것을 방지하기 위해 백그라운드 데몬 스레드를 실행하여
mlflow.MlflowClient().delete_traces(experiment_id, trace_ids)API로 해당__meta__쿼리 Trace ID를 실시간 자동 영구 삭제 처리합니다.
- 프론트엔드가 슬래시 명령어 자동완성 필터 목록을 쿼리하기 위해 특수 센티넬 문자열인
6.2. 호출 연계용 Trace ID 역전송 연산(_get_active_trace_id)
- 서빙 엔진 한계 우회
- 에이전트에 Unity Catalog Trace 테이블 바인딩(자동 인증 패스스루 SP)이 가동되면, 데이터브릭스 서빙 하니스가 보안상 응답 JSON 헤더에
databricks_output.trace(Trace ID 정보)를 인라인 결합하여 전달하지 않는 문제가 발생합니다. - 사용자가 답변을 평가하여 피드백(Assessment)을 누적하려면 챗봇 클라이언트가 현재 요청의
trace_id를 취득해야 합니다.
- 에이전트에 Unity Catalog Trace 테이블 바인딩(자동 인증 패스스루 SP)이 가동되면, 데이터브릭스 서빙 하니스가 보안상 응답 JSON 헤더에
- Trace ID 인바운드 스트리밍
- 이를 우회하기 위해
predict_stream연산 완료 시점에mlflow.get_current_active_span()또는mlflow.get_last_active_trace_id()API를 구동하여 현재 요청의trace_id를 직접 탐색해 획득합니다. - 획득된
trace_id를 본문 텍스트가 아닌 특수한 접두사trace-{uuid}를 부착한 스트림 데이터로 클라이언트에게 스트리밍 환류시켜, 화면 단에서 이를 낚아채어 피드백 연계에 재사용할 수 있도록 조율합니다.
- 이를 우회하기 위해
6.3. MLflow Contract 모델 컴파일
mlflow.langchain.autolog()를 구동하여 LangChain 컴포넌트의 내부 스팬 추적을 자동화합니다.- 모듈 import 시점에 MLflow Serving Contract인
mlflow.models.set_model(agent)이 명시 호출되도록 모듈 마지막 라인에서AGENT = bootstrap()을 구동하여 모델 빌드를 종결합니다.