이 시리즈는 Databricks 환경에서 구축했던 항공/운송/물류 분야의 RAG Agent 구축 프로젝트 관련 내용을 정리하는 시리즈입니다. 요구사항과 관련하여 Databricks의 어떤 기술을 사용해 이를 충족하였으며, 수행 중 발생한 문제 상황을 어떻게 해결했는지 정리합니다.
실제 고객사에서 수행한 프로젝트와는 별도의 내용으로, 기술적인 내용만을 정리합니다.
1. Kiwi 토크나이저 개요 및 도입 배경(Overview & Purpose)
한국어는 어근에 조사, 접사, 어미가 결합하는 교착어 특성을 지니며, 따라서 공백 기반의 단순 토큰화만으로는 키워드 검색(BM25)의 검색 일치율이 크게 저하됩니다. 이에 FTS(Full-Text Search) 앞단에 토크나이저를 두어 검색 일치율을 제고하도록 하며, 이 프로젝트에서는 Kiwi 형태소 분석기를 기반으로 설계된 전용 토크나이징 모듈 kiwi_tokenizer.py를 사용합니다.
1.1. 토크나이징 및 검색어 확장 아키텍처
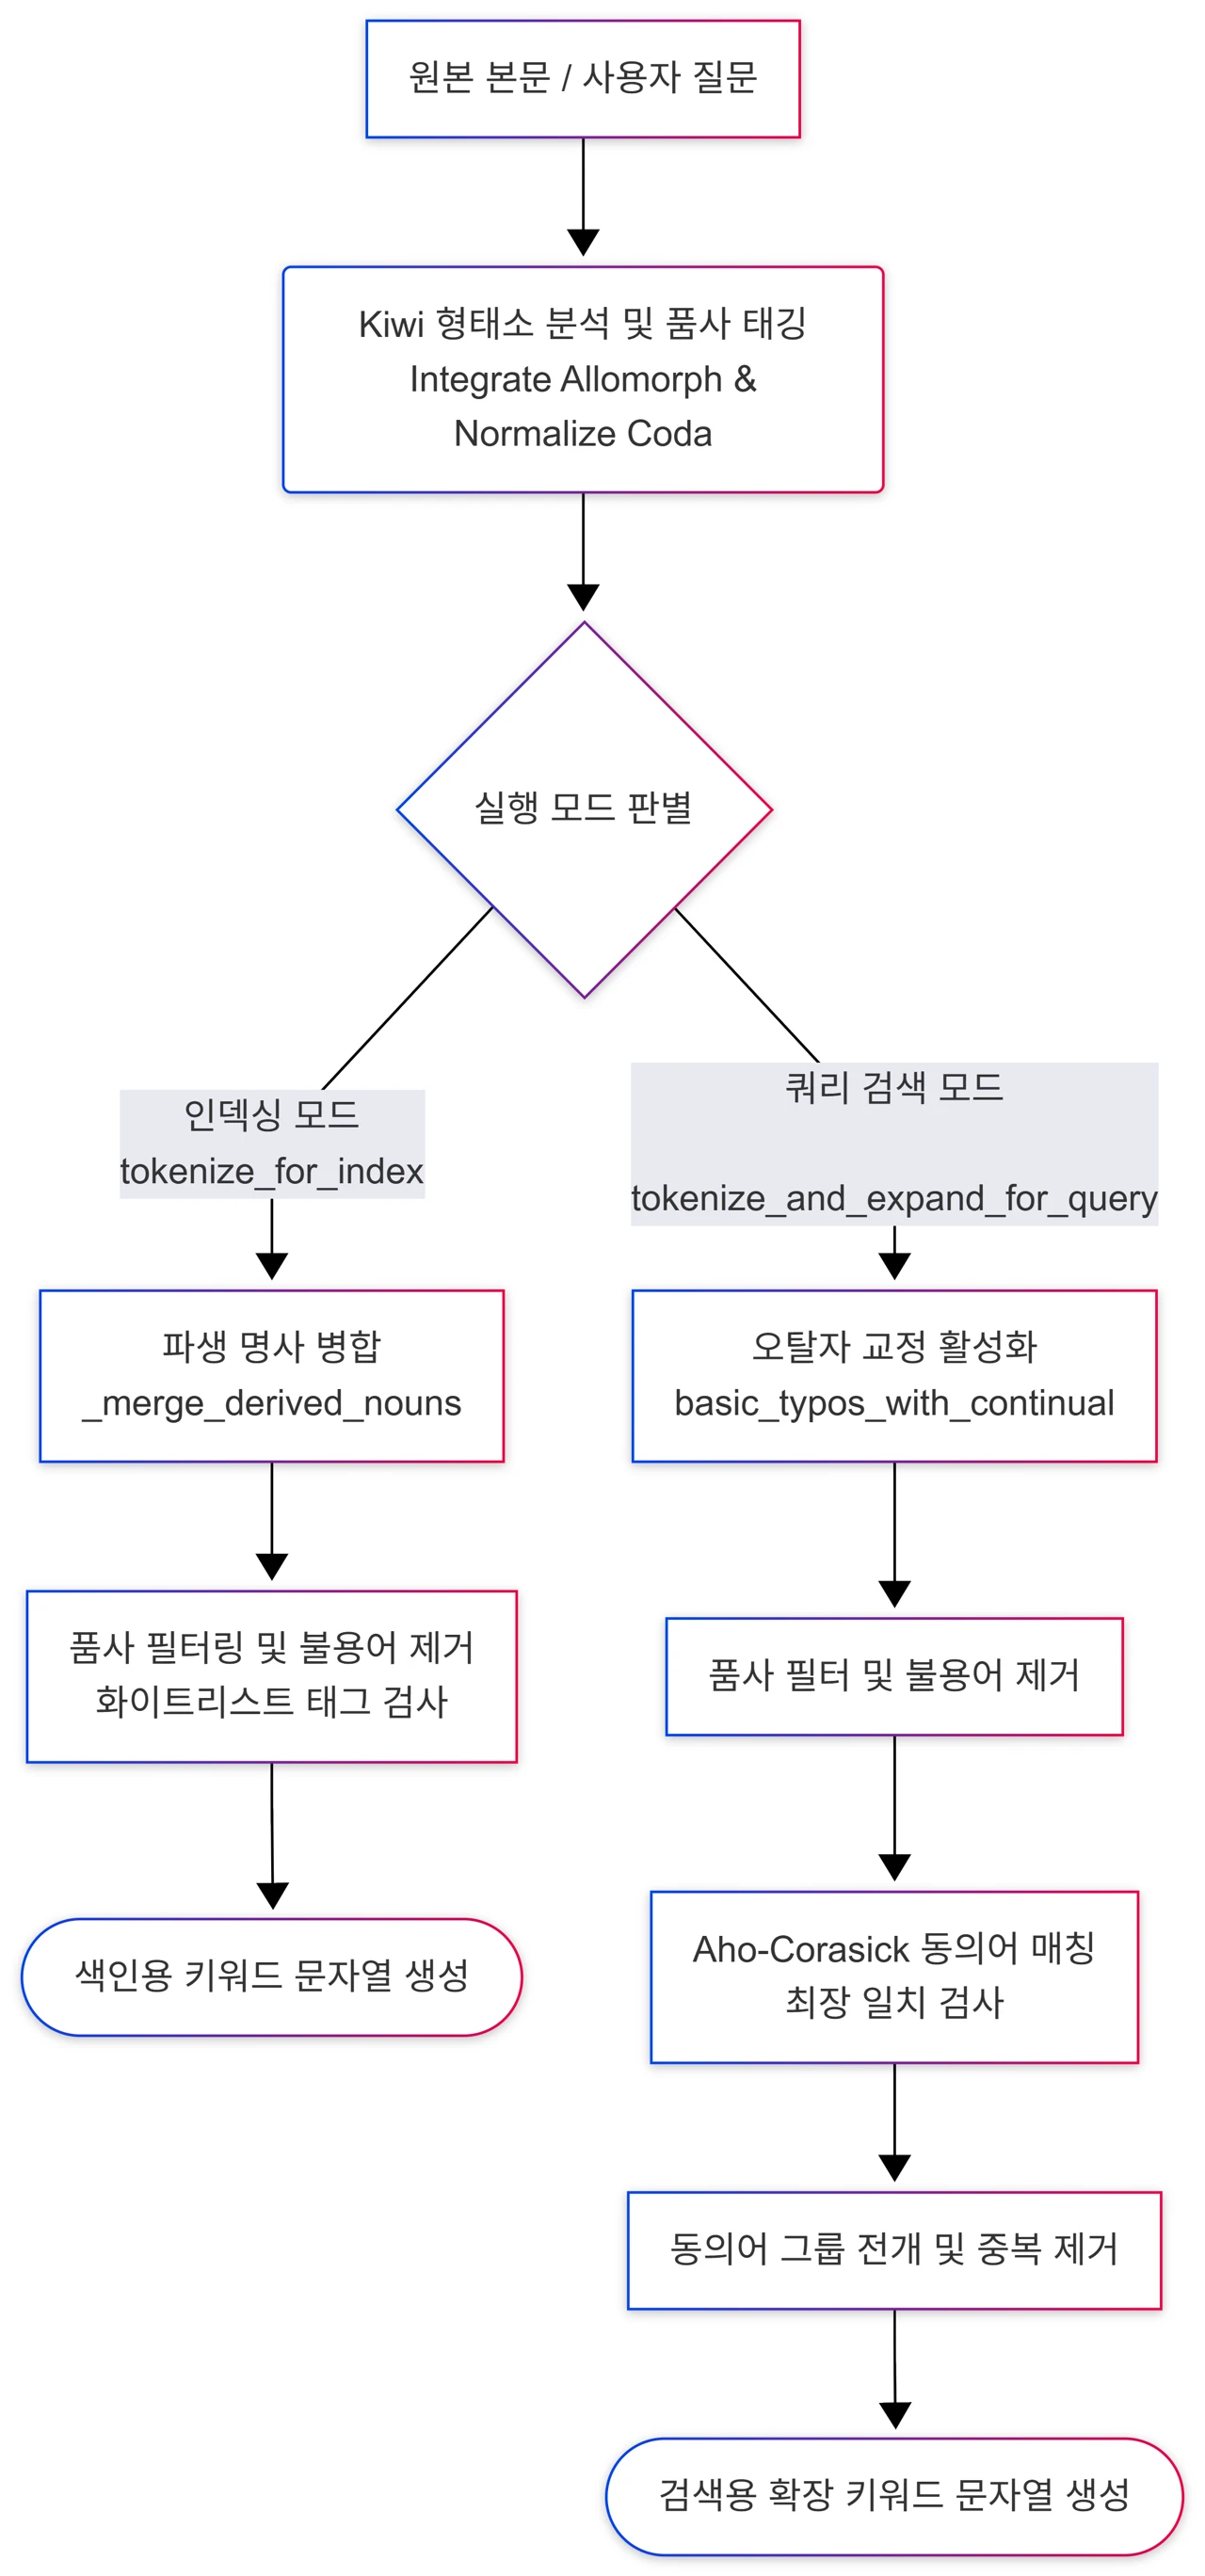
1.2. 인덱싱(색인) 시점과 쿼리(검색) 시점 비교
| 구분 | 인덱싱 시점(tokenize_for_index) | 쿼리 검색 시점(tokenize_and_expand_for_query) |
|---|---|---|
| 목적 | Delta Table 원본 청크의 핵심 명사 색인화 | 사용자 자연어 질문의 의도 분석 및 검색어 확장 |
| 오타 교정 | 비활성화(인덱스 생성 성능 보존) | 활성화(교정 가중치 임계값: 2.5) |
| 동의어 확장 | 비활성화(문서 빈도 왜곡 방지 및 IDF 보존) | 활성화(Aho-Corasick 오토마톤 기반 OR 확장) |
| 사용자 사전 | 활성화(동일 품사 매칭 보장) | 활성화(동일 품사 매칭 보장) |
2. 형태소 분석 및 정규화 알고리즘
형태소 분해 결과의 통일성을 제고하고 검색 누락을 방지하기 위해 정규화 및 형태 복원 알고리즘이 동작합니다.
2.1. 파생/전성명사 원문 표면형 병합(_merge_derived_nouns)
2.1.1. 개요
한국어 구문 분석 중 명사 추출 시 접미사나 어미가 결합되면서 단어가 여러 토큰으로 과도하게 쪼개지는 문제를 방지합니다.
- 전성명사 병합: 용언 어간(STEM:
VV,VA,XSV,XSA,VX태그) 뒤에 명사형 전성어미(ETN:ㅁ,음,기등)가 이어지는 패턴을 감지하여 하나의 일반명사(NNG) 형태로 합성합니다.
(예:알리(VV) + ㅁ(ETN)알림(NNG)) - 파생명사 병합: 명사(NN:
NNG,NNP태그) 뒤에 명사파생 접미사(XSN)가 연속으로 출현할 경우 이를 결합합니다.
(예:할인(NNG) + 권(XSN)할인권(NNG)) - 원본 복원 슬라이싱: 합성 명사 토큰을 생성할 때 분석된 형태소의 형태를 임의로 재구성하면 원문과 표기 차이가 생길 수 있으므로, 매칭된 첫 토큰의 시작 위치(
t.start)부터 마지막 접미사 토큰의 끝 위치(last.start + last.len)까지의 원문 텍스트 범위를 파이썬 슬라이싱으로 직접 잘라내어 표면형을 복원합니다.
2.1.2 파생/전성명사 병합 처리 설계 구조 및 트레이드오프
| 대상 유형 | 원천 형태소 구조 | 병합 후 형태소 | 예시 | 트레이드오프 및 설계 정책 |
|---|---|---|---|---|
| 전성명사 | 용언 어간(STEM) + 명사형 어미(ETN) | 일반명사 (NNG) | 알리(VV) + ㅁ(ETN) = 알림 | 일반 용언의 명사형 변형(예: "그가 옴")까지 병합될 위험이 있으나, BM25 특성상 희소도가 낮아 노이즈 전파가 미미하며 색인/검색 수렴 효과가 더 큽니다. |
| 파생명사 | 명사(NNG/NNP) + 파생접미사(XSN) | 일반명사 (NNG) | 할인(NNG) + 권(XSN) = 할인권 | "할인권"을 단일 1토큰으로 병합 색인하므로 "할인" 단독 질의 시 정확 매칭이 어려워질 수 있으나, 접미사 단독 색인의 무가치함을 제거하고 부분 일치는 하이브리드의 dense 채널이 보완합니다. |
2.2. 품사 화이트리스트 필터링 및 토큰 정제
- 대상 품사 제한: RAG 검색에서 불필요한 조사, 형용사, 어미를 배제하고 키워드 매칭 성능을 발휘하는 5가지 실질 품사(화이트리스트)만을 통과시킵니다.
- 일반명사 (
NNG) / 고유명사 (NNP) / 외국어 (SL) / 숫자 (SN) / 한자 (SH)
- 일반명사 (
- 소문자화 및 불용어 제거: 색인 정합성을 위해 통과된 영문 토큰은 전량 소문자로 통일하며, 운영 상 등록된 불용어 사전에 포함된 어휘는 토큰 목록에서 비동기로 제외 처리합니다.
3. 사용자 사전 및 동의어 사전 연계 메커니즘
이 장에서는 사용자 사전, 동의어 사전, 불용어 사전의 파일 규격과 이들의 형상 관리 계획, 그리고 에이전트 내부에 커스텀 구현된 Aho-Corasick 기반 동의어 확장 알고리즘의 동작 원리를 기술합니다.
3.1. 사전 파일 포맷 규격 및 형상 관리 방안
운영자는 세 가지 유형의 사전을 준비하여 RAG 시스템에 공급할 수 있으며, 각 사전 파일은 다음과 같은 정밀한 확장자 및 컬럼 포맷 요건을 충족해야 합니다.
- 사용자 사전 (User Dictionary)
- 파일 포맷:
user_dict.tsv(UTF-8, Tab 구분자 사용) - 사전 구조: 3개 열의 탭 구조를 준수해야 합니다.
표면형 \t 품사태그 \t 가중치스코어(예:RAG\tNNP\t5.0)변이형 \t 원형/품사태그 \t 가중치스코어(예:수화물\t수하물/NNG\t-3.0)복합명사 \t 어휘1/태그1 + 어휘2/태그2 + ... \t 가중치스코어(예:드림패스\t드림/NNP + 패스/NNG\t-3.0)
- 주의: 파이썬
add_user_wordAPI의 인자 규격과 다르게, TSV 파일 구조상 변이형 매핑을 4번째 열로 추가하여 구성(수화물\tNNG\t-3.0\t수하물)할 경우load_user_dictionary파서가ValueError를 발생시키며 중단되므로 반드시 2번째 열에 슬래시 표기법을 적용해야 합니다.
- 파일 포맷:
- 동의어 사전 (Synonym Dictionary)
- 파일 포맷:
synonym_dict.csv(UTF-8, Comma 구분자 사용) - 사전 구조: OpenSearch Solr Equivalent 표준 규격을 사용하여 동의 관계를 표현합니다.
- 동등 확장: 한 줄에 같은 뜻의 어휘들을 쉼표로 나열합니다. (예:
수하물,짐,가방,캐리어) - 단방향 매핑: 특정 입력에 대해서만 다른 용어로 변환할 경우
=>기호를 사용합니다. (예:RAG => 검색증강생성)
- 동등 확장: 한 줄에 같은 뜻의 어휘들을 쉼표로 나열합니다. (예:
- 규격 제한: 성능 저하와 매칭 왜곡을 예방하기 위해 단일 그룹 내 어휘 수는 15개 이하, 개별 어휘당 토큰 분해 길이는 최대 5개 토큰(
SYN_MAX_TOKENS) 이하로 작성을 제한합니다.
- 파일 포맷:
- 불용어 사전 (Stopwords Dictionary)
- 파일 포맷:
stopwords_dict.csv(UTF-8, 단일 열 구조) - 사전 구조: 한 행당 하나의 불용 단어 리스트 형태로 작성되며,
#기호로 시작하는 행은 파싱 단계에서 주석으로 간주하여 자동 생략됩니다.
- 파일 포맷:
3.2. 사용자 사전 가중치 점수 설정 정책
일반 한국어 코퍼스로 학습된 Kiwi 분석기가 항공/객실 도메인 특화 어휘를 자의적으로 분해하지 않도록 형태소 점수 가산 방식을 정의합니다. 가중치 점수는 형태소 분석 후보군 경쟁 시 해당 후보군에 가산되는 LM 점수값입니다.
| 분류 항목 | 품사 태그 | 가중치 가산값 | 적용 예시 | 목적 및 세부 규칙 |
|---|---|---|---|---|
| 신규 고유명사 및 약어 | 고유명사 (NNP) | +5.0 | ULD, WTO, RAG | 기본 언어 모델 분해 후보보다 무조건 최우선 채택되도록 보장 |
| 의존명사 획득 승격 | 일반명사 (NNG) | +3.0 | 킬로그램, 시간 | 의존명사(NNB) 태그는 색인 화이트리스트 탈락 대상이므로 명사 태깅 강제 |
| 변이형 및 표기 정규화 | 일반명사 (NNG) | -3.0 (원형 바인딩) | 수화물 (원형: 수하물) | 변이형 후보의 선택 순위를 강제로 낮추고 원형 단어 수렴 유도 |
3.3. 내부 구현 Aho-Corasick 동의어 확장 알고리즘의 동작 원리
Databricks Vector Search 및 Kiwi 형태소 분석기 라이브러리는 자체적인 동의어 확장 매커니즘을 내장하고 있지 않습니다. 본 시스템은 이 제약을 해소하기 위해 파이썬 C-Extension 기반의 다중 패턴 매칭 라이브러리인 pyahocorasick 패키지를 채택하여 검색 런타임에 동의어 확장을 직접 구동합니다.
3.3.1. 의존성 패키지(pyahocorasick) 특징
- 고속 탐색 구현: 트라이(Trie) 구조와 Knuth-Morris-Pratt(KMP) 알고리즘의 실패 링크(Failure Link) 개념을 합성한 Aho-Corasick 알고리즘을 사용하므로, 쿼리 길이 에 대해 등록된 동의어 수와 무관하게 의 선형 시간 내에 다중 동의어 구문 일치 구간을 고속 탐색합니다.
KEY_SEQUENCE정수 맵 탐색: 문자열 기반 매칭(KEY_STRING)을 수행하면 단어 일부분만 겹쳐도 트리거되는 경계 오류(예: '수하물'이 '수하물함'을 확장)가 발생합니다. 본 모듈은 토큰 단위 경계 격리를 위해KEY_SEQUENCE정수 시퀀스 매칭 모드를 활용합니다. Kiwi 분석기로 토큰화된 모든 형태소를 고유 정수 ID(tok2id)로 매핑하고, 동의어 구를tuple[int, ...]형태의 ID 시퀀스로 아호코라식 트리에 등록 및 검색합니다.
3.3.2. 3단계 쿼리 확장 연산 메커니즘
동의어 확장은 입력 질의 토큰들에 대해 다음 3단계 연산을 거쳐 BM25 쿼리 문자열로 가공됩니다.
[입력 쿼리 토큰화 결과] -> [위탁, 수하물, 분실, 규정] (각 토큰 정수 ID 변환 완료)
  ↓
[1단계: Aho-Corasick 탐색] -> 모든 매칭 구간 탐색: (0, 1)= "위탁 수하물" (2토큰) / (1,)= "수하물" (1토큰) 중복 매칭
  ↓
[2단계: 최장 비중첩 선택] -> i=0 에서 가장 긴 2토큰 "위탁 수하물" 채택 후 인덱스 +2 점프 (i=2 이동)
                         "수하물" 은 겹치는 구간이므로 무시 및 흡수 (이중 확장 방지)
  ↓
[3단계: 토큰화 및 중복 제거] -> 확장 그룹 ['위탁 수하물', '체크인 수하물'] 전개 -> [위탁, 수하물, 체크인, 수하물]
Set 자료형 적용으로 "수하물" 중복 제거 -> [위탁, 수하물, 체크인, 분실, 규정] 반환- 1단계: Aho-Corasick 탐색 (Scan):
automaton.iter(seq)API를 호출하여 질의 토큰 ID 배열 전체를 1회 스캔하고, 겹치는 모든 동의어 매칭 후보군 목록을 수집합니다. - 2단계: 최장 비중첩 선택 (Leftmost-Longest Match)
- 수집된 매칭 후보들 중 겹침(Overlap)이 발생하면 greedy 알고리즘에 의거하여 시작 위치가 가장 왼쪽에 있고 길이가 가장 긴 패턴(
ln > best[st][1])만을 채택하고, 매칭된 길이만큼 루프 인덱스(i += step)를 건너뛰어 토큰을 소비합니다. - 오작동 차단: 이 비중첩 흡수 연산을 통해
"위탁 수하물 분실"이라는 질의에서"위탁 수하물"그룹이 정상 매칭되었을 때, 그 하부의"수하물"토큰이 단독으로 동작해"짐","가방"등으로 동의어 오확장을 일으키는 문제를 차단합니다.
- 수집된 매칭 후보들 중 겹침(Overlap)이 발생하면 greedy 알고리즘에 의거하여 시작 위치가 가장 왼쪽에 있고 길이가 가장 긴 패턴(
- 3단계: 중복 제거 및 최종 결합 (Deduplication): 매칭 완료된 동의어 그룹 내부 단어들을 쿼리에 나열해 줄 때, 동일 토큰이 중복 나열되면 BM25 가중치가 비정상적으로 누적되어 검색 스코어가 오염되는 현상을 막기 위해 Set 자료형을 활용하여 최종 쿼리 문자열 조립 시 중복을 차단합니다.
3.4. 동의어 키 빌드 시점의 정렬 및 예외 처리
동의어 사전의 키 빌드 경로를 검색/인덱싱과 일치시켜, 키와 질의의 토큰 모양이 일치하지 않아 동의어 매칭이 유실되는 현상을 예방합니다.
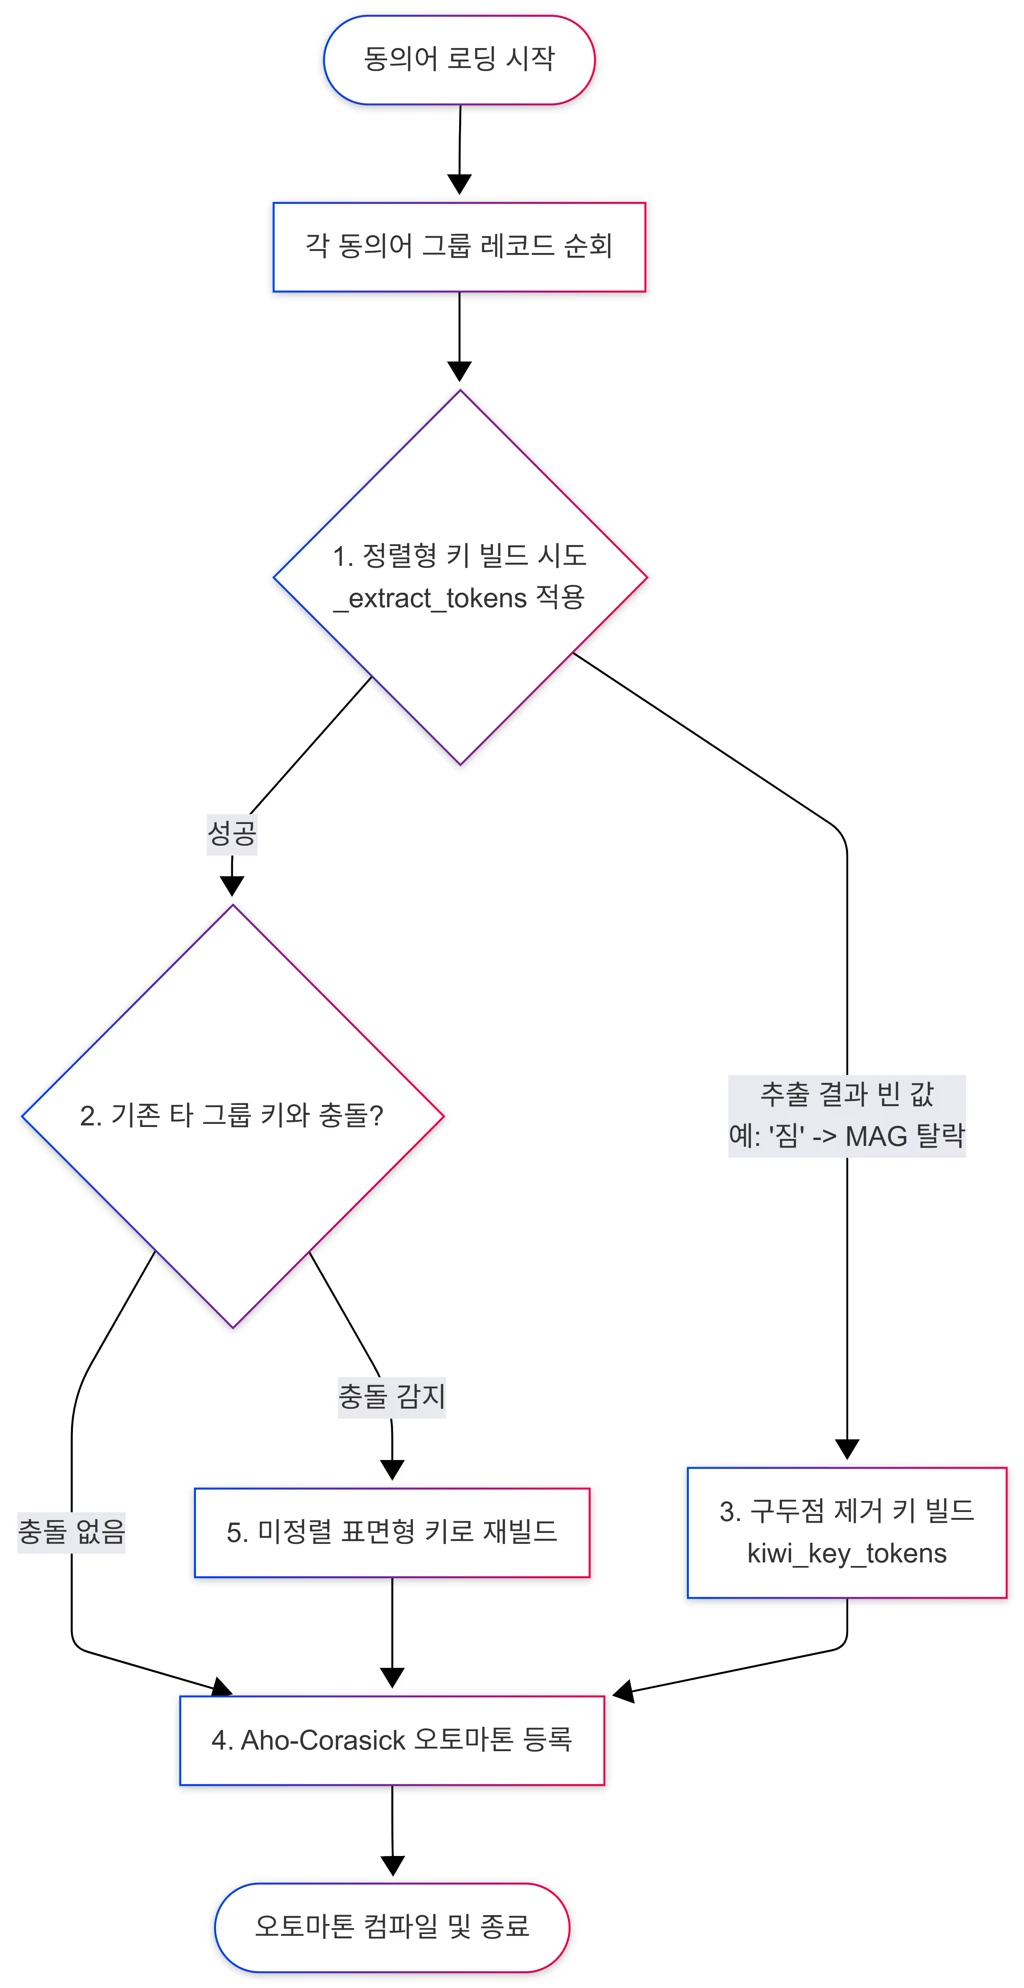
- 정렬형 키 빌드 (Aligned Key Build): 동의어 그룹 내 개별 어휘를 토큰화할 때 단순 구두점 정제 방식을 지양하고, 검색/인덱싱과 동일한 명사 화이트리스트 필터 및 파생명사 병합 규칙(
_extract_tokens기반)을 적용해 키를 빌드합니다. - 단독 오태깅 어휘 폴백: 어휘를 단독으로 형태소 분석할 때 명사가 아닌 다른 품사로 오태깅되어 누락되는 케이스(예: "짐" → 부사(MAG)로 태깅되어 화이트리스트에서 드롭됨)를 보완하기 위해, 1차 정렬형 빌드 결과가 빈 값일 경우 구두점만 제외하고 표면형 토큰을 보존하는 2차 폴백 함수(
kiwi_key_tokens)로 키를 구제합니다. - 그룹 키 충돌 우회: 정렬형으로 축약한 키가 이미 등록된 다른 동의어 그룹의 대표 키와 겹치는 경우, 해당 그룹 전체가 무시되는 현상을 막기 위해 충돌 감지 시 축약하지 않은 원본 표면형 키(미정렬 키)로 교차 재빌드하여 오토마톤에 등록합니다.
- 그룹 부분 수용 (Dropped Members): 그룹 내에 5토큰을 초과하거나 키가 완전히 비어 있는 불량 어휘가 섞여 있더라도 그룹 전체를 무효화하지 않고, 해당 어휘만 제외한 상태에서 정상 어휘들만으로 동의어 관계를 유지하여 메모리에 적재합니다.
4. 런타임 최적화 및 Databricks 연동
대용량 스파크 연산과 서빙 엔드포인트의 Cold-start 지연 시간을 통제하기 위해 적용된 런타임 최적화 기법입니다.
4.1. 배포 환경 경로 자동 해소(resolve_dictionary_dirs)
- Model Serving 컨테이너 구동 시 로컬 볼륨 경로를 하드코딩하면 구동 환경 차이로 인해 사전 파일을 가져오지 못합니다.
- 본 모듈은 호출 위치(
__file__)를 기준으로 상대 경로 역추적을 수행하여, MLflow 모델 패키지 내부 아티팩트 볼륨(artifacts/user_dict등)이 존재하는지 판별하고 존재할 경우 동봉된 사전 경로로 환경을 자동 오버라이드합니다.
4.2. 싱글턴 패턴 기반 인스턴스 공유(get_tokenizer)
- Kiwi 형태소 분석기 및 대용량 동의어 오토마톤 인스턴스는 초기화 시 디스크 I/O와 CPU 연산 리소스를 대량 소모합니다.
- 전역 변수
_tokenizer_instance를 사용해 인스턴스를 캐싱하며, 다수의 파티션을 처리하는 Spark 워크 노드 혹은 Model Serving 컨테이너 인스턴스당 단 1회만 초기화가 보장되도록 싱글턴 생성 제어를 완수합니다.
4.3. Spark 병렬 처리를 위한 Pandas UDF 적용(get_tokenize_udf)
- Spark 분산 환경에서 대량의 데이터를 토큰화할 때 발생하는 JVM-Python 간 직렬화 오버헤드를 막기 위해, Pandas Series 단위로 배치 연산을 일괄 처리하는 Vectorized UDF(
pandas_udf) 구조를 제공합니다. - 인덱싱 시점에는 동의어 확장이 필요하지 않으므로 UDF 내 싱글턴 로더 호출 시
load_synonyms=False옵션을 인가하여 메모리 사용량을 최소화합니다.
5. 핵심 구현 코드 조각
5.1. 파생 명사 병합 구현부
# kiwi_tokenizer.py - stems 및 XSN 접미사 결합 처리
def _merge_derived_nouns(self, text: str, tokens) -> list:
    noun_tags = {"NNG", "NNP"}
    out, i, n = [], 0, len(tokens)
    while i < n:
        t = tokens[i]
        j = None

        # 전성명사: 어간 + ETN (예: 알림)
        if i + 1 < n and t.tag in self.stems and tokens[i + 1].tag == "ETN":
            j = i + 1

        # 파생명사: 명사 + XSN
        elif t.tag in noun_tags:
            j = i

        if j is not None:
            k = j + 1
            while k < n and tokens[k].tag == "XSN":
                k += 1

            if k > j + 1 or j > i:
                last = tokens[k - 1]
                # 원문 text 슬라이싱을 통한 원래 표면형 복원
                out.append((text[t.start : last.start + last.len], "NNG"))
                pointer = k
                i = k
                continue
        out.append((t.form, t.tag))
        i += 1
    return out
5.2. 최장 일치 동의어 탐색 및 쿼리 조립부
# kiwi_tokenizer.py - Aho-Corasick 매칭 및 중복 제거
def tokenize_and_expand_for_query(self, query: str) -> str:
    extracted_keywords = self._extract_tokens(query, self.query_tokenize_opts, lowercase=False)
    if not extracted_keywords:
        return ""

    best = {}
    if len(self.automaton):
        seq = tuple(self.tok2id.get(t.lower(), _UNK_ID) for t in extracted_keywords)
        for end, (grp, ln) in self.automaton.iter(seq):
            st = end - ln + 1
            # 동일 시작 위치(st)에 대해 최장 길이 매칭만 채택
            if st not in best or ln > best[st][1]:
                best[st] = (grp, ln)

    out = []
    seen = set()
    i = 0
    n = len(extracted_keywords)
    while i < n:
        if i in best:
            grp, step = best[i]
        else:
            grp, step = [extracted_keywords[i].lower()], 1
        for phrase in grp:
            for tk in phrase.split():
                if tk not in seen:
                    seen.add(tk)
                    out.append(tk)
        i += step

    return " ".join(out)