donate nest에서 허우적대다가 지난주가 끝나버렸다.
최선을 다했다고 생각하긴 하는데 드는 아쉬움은 어쩔 수가 없다.
이번 과제는 2주 가량이고, 협업도 있으니 그래도 잘 할 수 있을거라 생각한다.
다만 종종 화나게 만드는 요소들이 있다.
출처: https://namu.wiki/w/골든%20리트리버
리트리버들이라고 생각하고 넘어가기로 했다.
<작성중>
<작성중>이라고 적어둔 게시물이 늘어날 때마다 걱정도 늘어난다.
Process
-process.c-
process_init
static void
process_init (void) {
	struct thread *current = thread_current ();
}
좀 독특한 함수같다.
프로세스를 초기화하는 것 같은데
변수도 지역 변수에 반환값도 없다.
코드를 더 추가해야하지 않을까 싶다.
process_create_init
tid_t
process_create_initd (const char *file_name) {
	char *fn_copy;
	tid_t tid;

	/* Make a copy of FILE_NAME.
	 * Otherwise there's a race between the caller and load(). */
	fn_copy = palloc_get_page (0);
	if (fn_copy == NULL)
		return TID_ERROR;
	strlcpy (fn_copy, file_name, PGSIZE);

	/* Create a new thread to execute FILE_NAME. */
	tid = thread_create (file_name, PRI_DEFAULT, initd, fn_copy);
	if (tid == TID_ERROR)
		palloc_free_page (fn_copy);
	return tid;
}
palloc_get_page()는 페이지 풀에서 특정 값으로 초기화된 페이지를 반환하는 함수이다.
fn_copy는 0으로 초기화된 페이지를 받고,그 위에 파일의 경로를 복사한다.
그리고 이 정보를 바탕으로 initd 함수를 가지는 스레드를 생성한다.
만약 에러가 났을 경우 할당받은 페이지를 해제한다.
tid를 반환한다.
왜? 4kb나 되는 페이지를 파일의 이름(혹은 경로)를 복사하는데 쓸까
의문이 들었다.
페이지 단위로 할당하면 비록 공간 낭비는 있을지 모르지만, 구현이 단순하고 페이지 단위로 정렬돼서 그렇다고 한다.
initd
static void
initd (void *f_name) {
#ifdef VM
	supplemental_page_table_init (&thread_current ()->spt);
#endif

	process_init ();

	if (process_exec (f_name) < 0)
		PANIC("Fail to launch initd\n");
	NOT_REACHED ();
}
process_init을 실행시킨뒤 exec를 한다.
만약 exec에 실패할 경우 PANIC이다.
근데 process init은 앞서 언급했듯이 스레드만 달랑있다.
어떻게 작동하는지 잘 모르겠다.
살짝 감이 잡히는 건 있다.
process_exec를 결국 하는데, exec를 했다는 건 fork도 있을 것이라 생각한다.
그래서 initd에 fork 함수도 추가해서 구현해야할 듯 하다.
process_fork
tid_t
process_fork (const char *name, struct intr_frame *if_ UNUSED) {
	/* Clone current thread to new thread.*/
	return thread_create (name,
			PRI_DEFAULT, __do_fork, thread_current ());
}
현재 프로세스를 name으로 복제한다. 새 프로세스의 스레드 id를 반환한다.
duplicate_pte
VM에서 쓴다고 명시되어있긴 하다.
static bool
duplicate_pte (uint64_t *pte, void *va, void *aux) {
	struct thread *current = thread_current ();
	struct thread *parent = (struct thread *) aux;
	void *parent_page;
	void *newpage;
	bool writable;

	/* 1. TODO: If the parent_page is kernel page, then return immediately. */

	/* 2. Resolve VA from the parent's page map level 4. */
	parent_page = pml4_get_page (parent->pml4, va);

	/* 3. TODO: Allocate new PAL_USER page for the child and set result to
	 *    TODO: NEWPAGE. */

	/* 4. TODO: Duplicate parent's page to the new page and
	 *    TODO: check whether parent's page is writable or not (set WRITABLE
	 *    TODO: according to the result). */

	/* 5. Add new page to child's page table at address VA with WRITABLE
	 *    permission. */
	if (!pml4_set_page (current->pml4, va, newpage, writable)) {
		/* 6. TODO: if fail to insert page, do error handling. */
	}
	return true;
}
추후 구현해야될 내용들이 보인다. 페이지 테이블 엔트리를 복사하기 위해선 일련의 과정이 필요하다.
1. 부모의 물리 페이지를 읽어야 한다.
2. 물리 페이지 복사를 위해 자식의 페이지를 할당해야 한다.
3. 자식 페이지에 복사한다.
4. 해당 페이지에 대한 페이지 테이블 엔트리를 생성한다.
__do_fork
static void
__do_fork (void *aux) {
struct intr_frame if_;
struct thread *parent = (struct thread *) aux;
struct thread *current = thread_current ();
/* TODO: somehow pass the parent_if. (i.e. process_fork()'s if_) */
struct intr_frame *parent_if;
bool succ = true;
/* 1. Read the cpu context to local stack. */
memcpy (&if_, parent_if, sizeof (struct intr_frame));
/* 2. Duplicate PT */
current->pml4 = pml4_create();
if (current->pml4 == NULL)
goto error;
process_activate (current);
#ifdef VM
supplemental_page_table_init (¤t->spt);
if (!supplemental_page_table_copy (¤t->spt, &parent->spt))
goto error;
#else
if (!pml4_for_each (parent->pml4, duplicate_pte, parent))
goto error;
#endif부모 실행 context를 복제하는 스레드 함수이다.
parent-tf는 프로세스의 userland context를 가지고 있지 않다고 하는데 무슨 말일까?
aux로는 부모 프로세스만 전달됐다.
아마 aux(부모 프로세스)의 if(intr_frame)에 접근해서 이를 자식으로 넘겨야될 듯하다.
memcpy도 그런 맥락에서 사용된 것 같다.
근데 앞서 process_fork에서 if 매개변수는 이미 전달됐으므로 aux로 전달되는 값을 스레드에서 if로 바꾸거나 혹은 임시방편?으로 do_fork 안에서 parent_if 값 자체를 부모로부터 받아올 수도 있을 것이다.
또한 pml4를 초기화시켜주는데, pml4는 x86-64 아키텍처에서 4단계 페이징 시스템의 최상위 페이지 테이블이다. 64비트 페이징 구조는 다음과 같다.
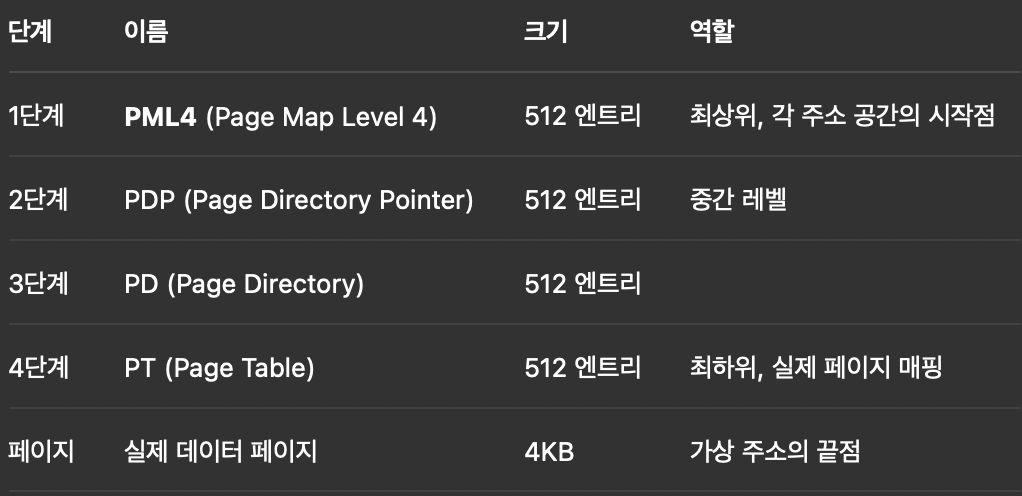
1엔트리당 8바이트이므로 각 단계(테이블)당 4kb의 크기, 즉 1페이지이다.
process_exec
int
process_exec (void *f_name) {
	char *file_name = f_name;
	bool success;

	/* We cannot use the intr_frame in the thread structure.
	 * This is because when current thread rescheduled,
	 * it stores the execution information to the member. */
	struct intr_frame _if;
	_if.ds = _if.es = _if.ss = SEL_UDSEG;
	_if.cs = SEL_UCSEG;
	_if.eflags = FLAG_IF | FLAG_MBS;

	/* We first kill the current context */
	process_cleanup ();

	/* And then load the binary */
	success = load (file_name, &_if);

	/* If load failed, quit. */
	palloc_free_page (file_name);
	if (!success)
		return -1;

	/* Start switched process. */
	do_iret (&_if);
	NOT_REACHED ();
}
if를 새로 설정하고 (스레드 구조의 intr_frame은 문맥 전환 시 값이 변경될 수 있기 때문에 사용하지 않는다.)
현재 실행 중이던 프로그램을 메모리에서 없앤다.
(보통 exec는 부모로부터 복제된 자식 프로세스에서 실행하는 함수이므로, 부모 프로세스의 흔적을 덮어쓴다고 생각하면 된다.)
이후 load를 실행한다.
특별한 코드가 없는 함수들은 설명하지 않을 예정이다.
process_wait, process_exit, process_cleanup, procoess_activate
load
static bool
load (const char *file_name, struct intr_frame *if_) {
	struct thread *t = thread_current ();
	struct ELF ehdr;
	struct file *file = NULL;
	off_t file_ofs;
	bool success = false;
	int i;

	/* Allocate and activate page directory. */
	t->pml4 = pml4_create ();
	if (t->pml4 == NULL)
		goto done;
	process_activate (thread_current ());

	/* Open executable file. */
	file = filesys_open (file_name);
	if (file == NULL) {
		printf ("load: %s: open failed\n", file_name);
		goto done;
	}

	/* Read and verify executable header. */
	if (file_read (file, &ehdr, sizeof ehdr) != sizeof ehdr
			|| memcmp (ehdr.e_ident, "\177ELF\2\1\1", 7)
			|| ehdr.e_type != 2
			|| ehdr.e_machine != 0x3E // amd64
			|| ehdr.e_version != 1
			|| ehdr.e_phentsize != sizeof (struct Phdr)
			|| ehdr.e_phnum > 1024) {
		printf ("load: %s: error loading executable\n", file_name);
		goto done;
	}

	/* Read program headers. */
	file_ofs = ehdr.e_phoff;
	for (i = 0; i < ehdr.e_phnum; i++) {
		struct Phdr phdr;

		if (file_ofs < 0 || file_ofs > file_length (file))
			goto done;
		file_seek (file, file_ofs);

		if (file_read (file, &phdr, sizeof phdr) != sizeof phdr)
			goto done;
		file_ofs += sizeof phdr;
		switch (phdr.p_type) {
			case PT_NULL:
			case PT_NOTE:
			case PT_PHDR:
			case PT_STACK:
			default:
				/* Ignore this segment. */
				break;
			case PT_DYNAMIC:
			case PT_INTERP:
			case PT_SHLIB:
				goto done;
			case PT_LOAD:
				if (validate_segment (&phdr, file)) {
					bool writable = (phdr.p_flags & PF_W) != 0;
					uint64_t file_page = phdr.p_offset & ~PGMASK;
					uint64_t mem_page = phdr.p_vaddr & ~PGMASK;
					uint64_t page_offset = phdr.p_vaddr & PGMASK;
					uint32_t read_bytes, zero_bytes;
					if (phdr.p_filesz > 0) {
						/* Normal segment.
						 * Read initial part from disk and zero the rest. */
						read_bytes = page_offset + phdr.p_filesz;
						zero_bytes = (ROUND_UP (page_offset + phdr.p_memsz, PGSIZE)
								- read_bytes);
					} else {
						/* Entirely zero.
						 * Don't read anything from disk. */
						read_bytes = 0;
						zero_bytes = ROUND_UP (page_offset + phdr.p_memsz, PGSIZE);
					}
					if (!load_segment (file, file_page, (void *) mem_page,
								read_bytes, zero_bytes, writable))
						goto done;
				}
				else
					goto done;
				break;
		}
	}

	/* Set up stack. */
	if (!setup_stack (if_))
		goto done;

	/* Start address. */
	if_->rip = ehdr.e_entry;

	/* TODO: Your code goes here.
	 * TODO: Implement argument passing (see project2/argument_passing.html). */

	success = true;

done:
	/* We arrive here whether the load is successful or not. */
	file_close (file);
	return success;
}
길다..
주석에는
file name(파일 경로)로부터 실행가능한 ELF 파일을 현재 스레드로 로드한다고 한다.
RIP에는 실행 파일의 진입 주소를 저장하고, RSP에는 초기 스택 포인터를 저장한다.
고 되어있다.
goto done이 많아서
done: 부터 살펴보면
파일을 닫고 success를 리턴한다고 한다.
근데 에러 처리도 담당하는 것 같다.
작업을 성공적으로 수행하거나 에러가 등장하면 여기서 파일을 닫아서 마무리하는 것 같다.
그리고 읽다보면 뭐랄까 do_fork랑 비슷하게 생겼다.
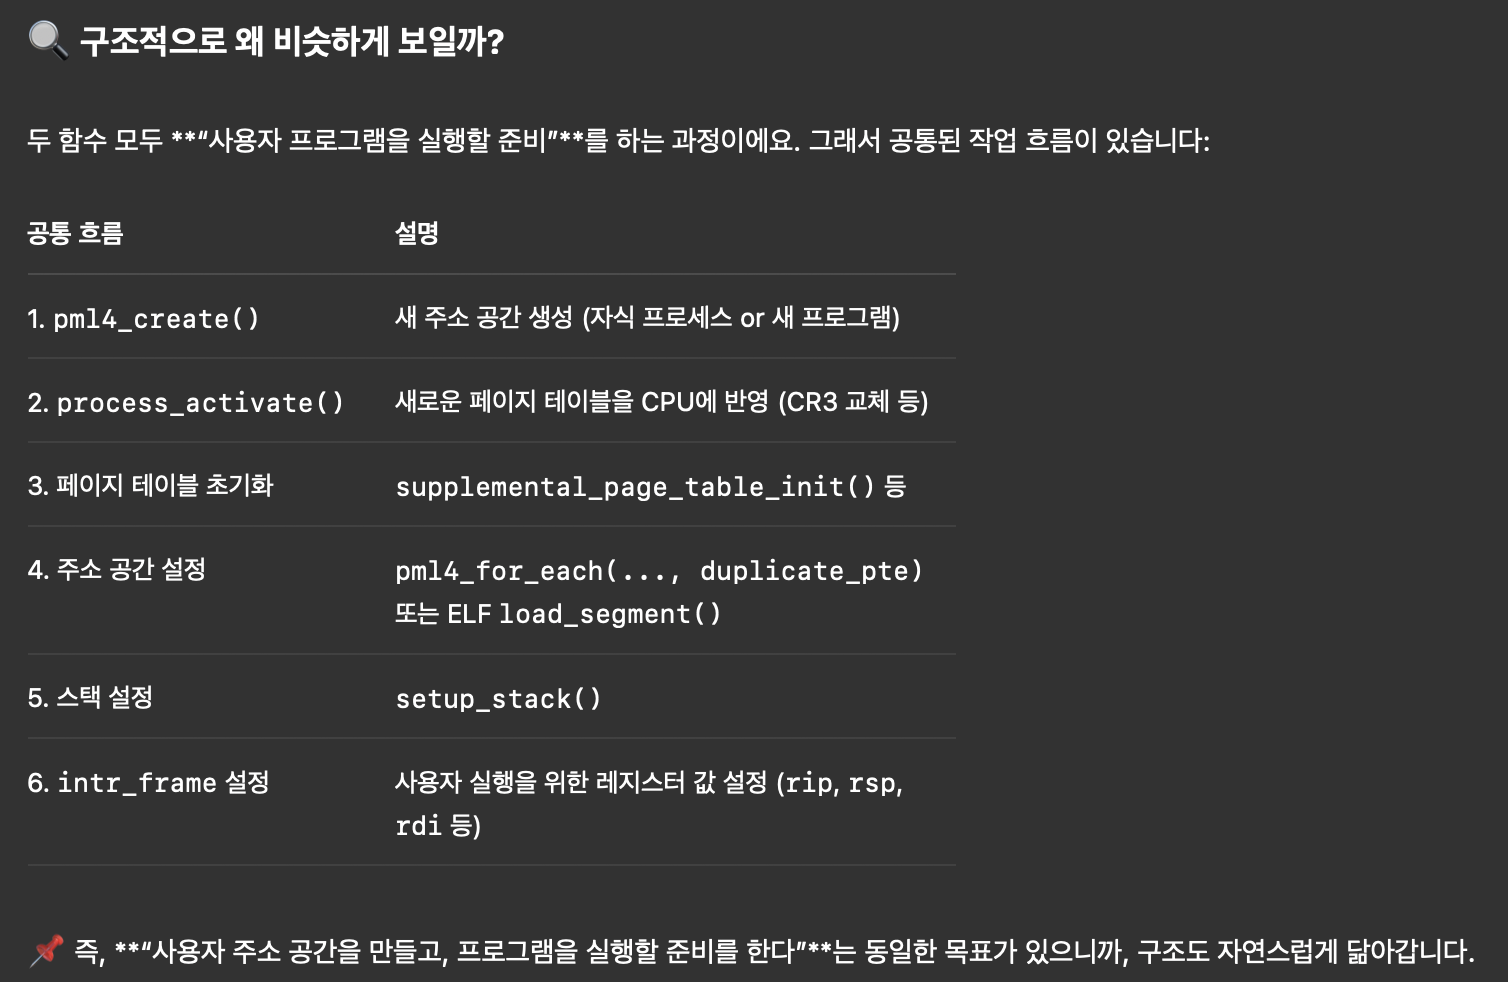
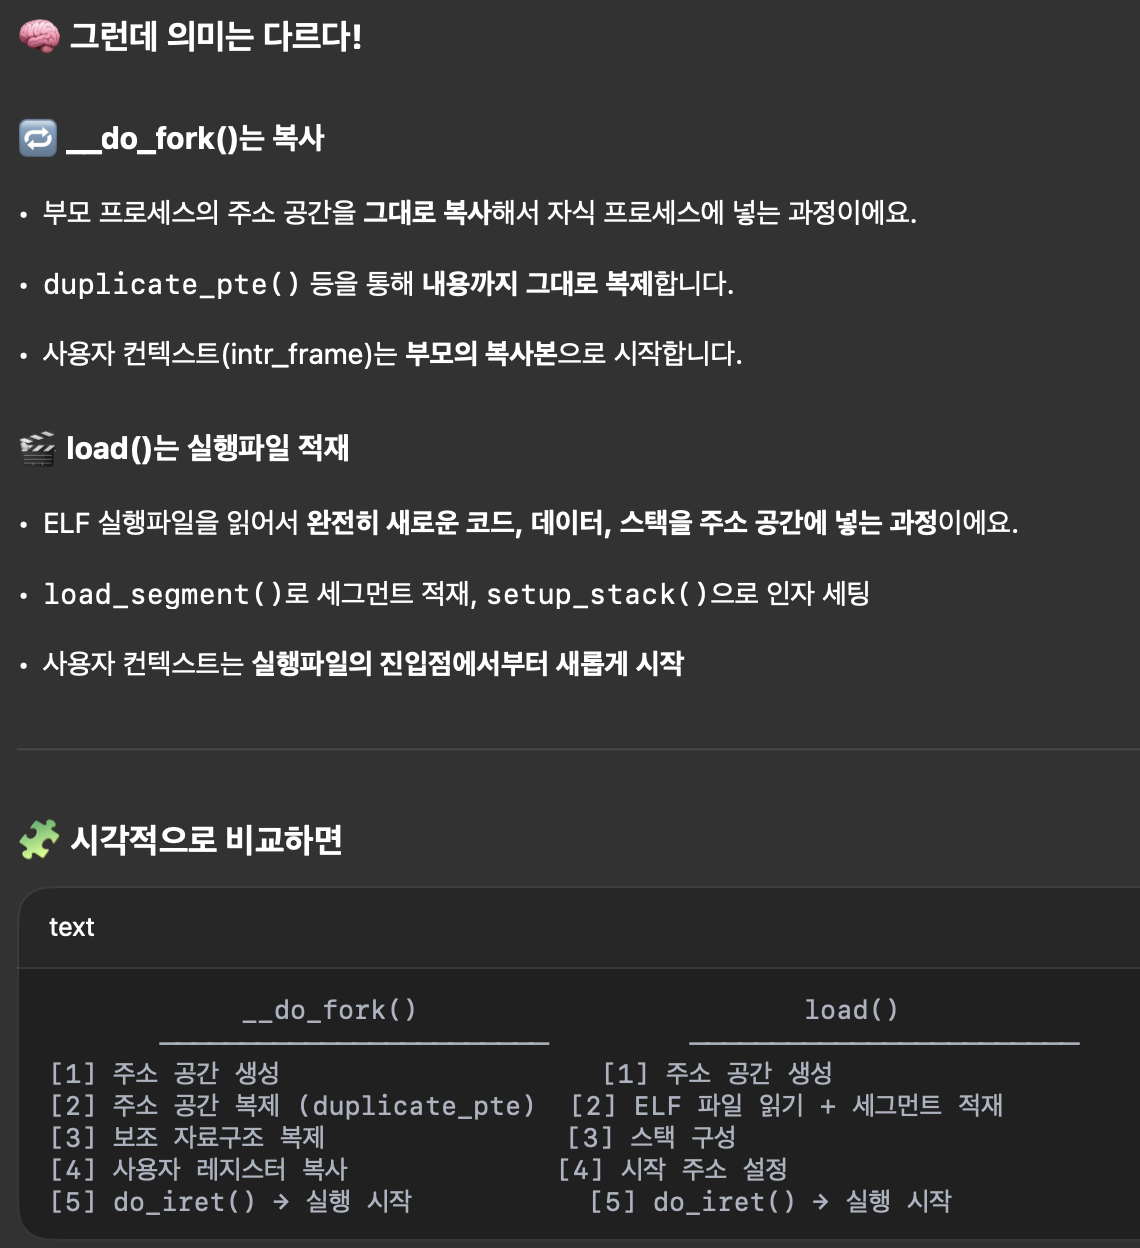
시각적으로 비교하는 걸 못하는 것 같다.
아무튼 흐름은 대략 이런 것 같다.
먼저 부모 프로세스가 자식 프로세스를 생성하고 (fork)
자식 프로세스를 새로운 프로세스로 덮어쓰고 (exec)
새로운 프로세스가 프로그램을 load한다. (load)
그리고 저 for문... 굉장히 폭력적으로 생겼다...
file_ofs = ehdr.e_phoff;
for (i = 0; i < ehdr.e_phnum; i++) {
		struct Phdr phdr;

		if (file_ofs < 0 || file_ofs > file_length (file))
			goto done;
		file_seek (file, file_ofs);

		if (file_read (file, &phdr, sizeof phdr) != sizeof phdr)
			goto done;
		file_ofs += sizeof phdr;

        (중략 ... )

	}
슥 떠봤다.
...
근데 읽어봐도 무슨 말인지 이해도 안돼서
배경 지식을 알려달라고 했다.
ELF(Executable and Linkable Format) 파일이란
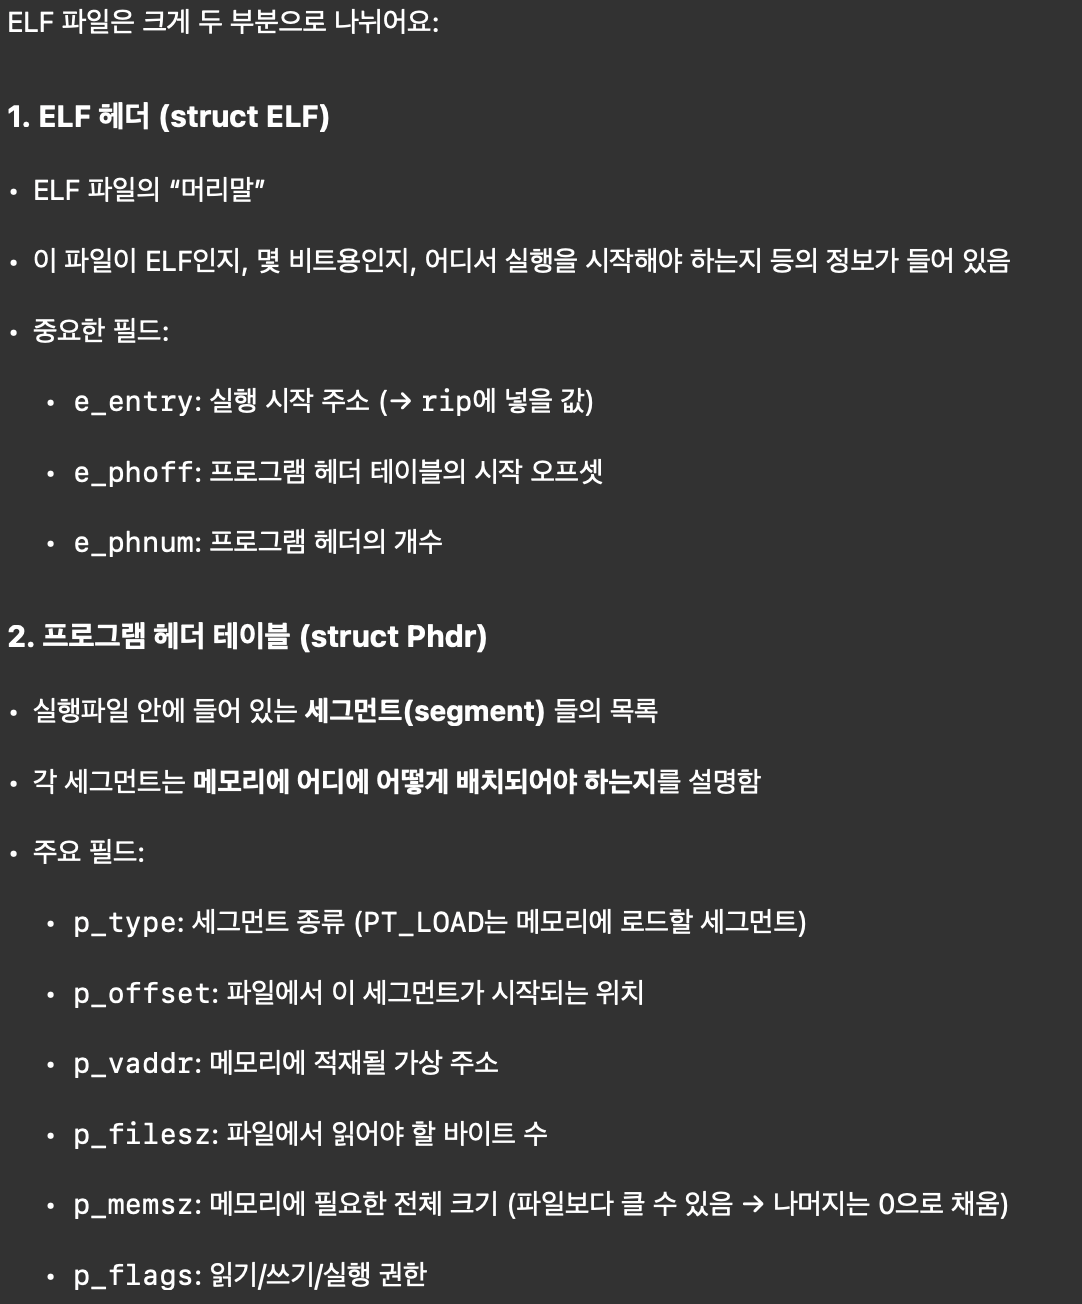
시각적으로 보여달라고 하니
+--------------------+
| ELF Header         |  ← ELF 파일의 시작 부분으로, 파일의 전체 구조를 설명합니다.
+--------------------+
| Program Header     |
| Table              |  ← 실행 시 필요한 세그먼트 정보를 담고 있으며, 로더가 사용합니다.
+--------------------+
| Section Headers    |  ← 링커가 사용하는 섹션 정보를 담고 있으며, 컴파일 및 링크 과정에서 활용됩니다.
+--------------------+
| .text Section      |  ← 실행 코드가 위치하는 섹션입니다.
+--------------------+
| .data Section      |  ← 초기화된 전역 변수 등이 위치하는 섹션입니다.
+--------------------+
| .bss Section       |  ← 초기화되지 않은 전역 변수 등이 위치하는 섹션입니다.
+--------------------+
| 기타 섹션들           |  ← 심볼 테이블(.symtab), 문자열 테이블(.strtab) 등 다양한 섹션이 존재할 수 있습니다.
+--------------------+
csapp에서 본 것 같은 기분이 든다. 근데 또 보니 정리는 안 되어있다.
아무튼 저기 저 for문 앞의 ehdr.e_phoff는 프로그램 헤더 테이블의 시작 오프셋이라고 한다.
그렇다면 프로그램 헤더 테이블은 어디있지? 프로그램 헤더랑 같은 건가?
라고 생각했는데
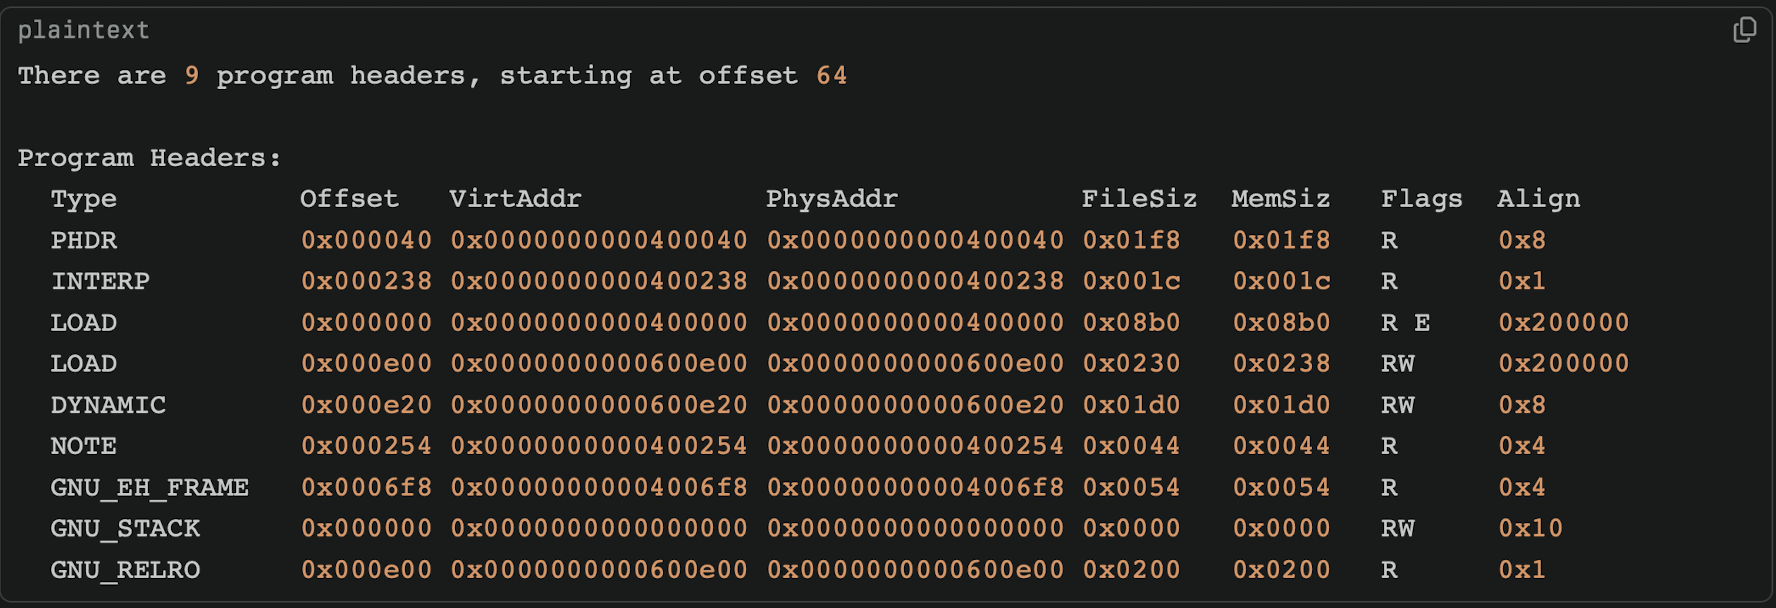
저 모든 정보가 프로그램 헤더 테이블이고 그 아래가 프로그램 헤더라고 한다.
위에 ELF 구조 역시 Program Header라고 돼있길래 Program Header Table이라고 수정했다.
아무튼 for문에서는 프로그램 헤더 테이블로 이동해서 phdr(program header)만큼 읽는다.
PT는 생략하겠다.
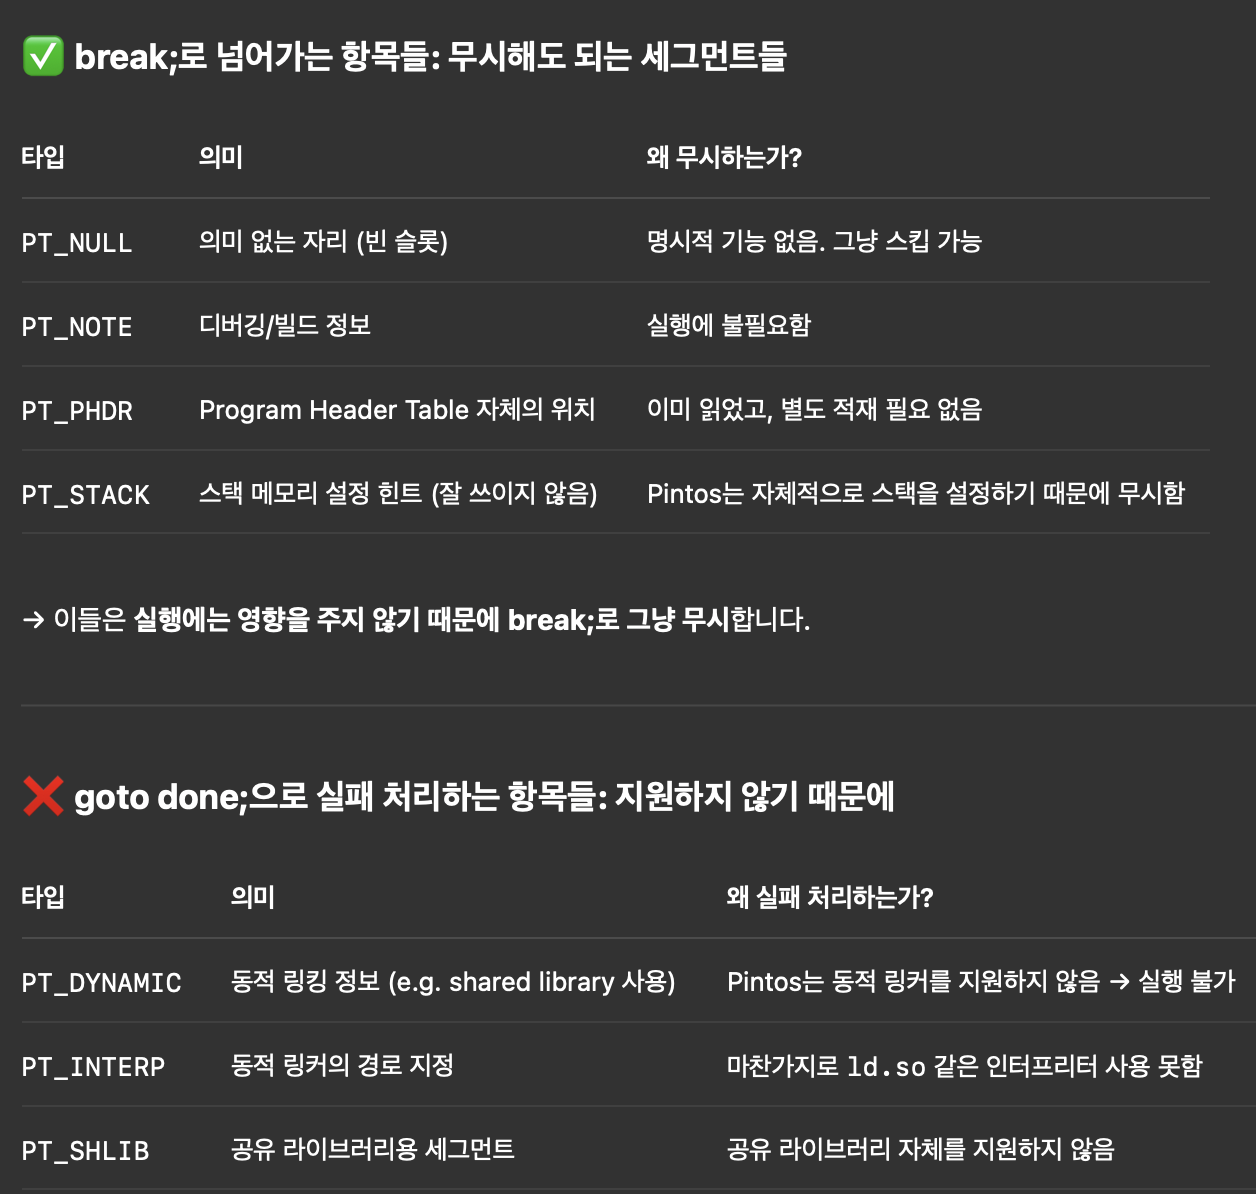
case가 NULL, NOTE, PHDR, STACK일 때는 break하고
DYNAMIC, INTERP, SHLIB일 때는 done으로 이동하며
LOAD일 때 뭔가를 실행한다.
그 이유는 아래 사진을 보고 간단하게 참고하고
그렇다면 PT_LOAD란 무엇인가?
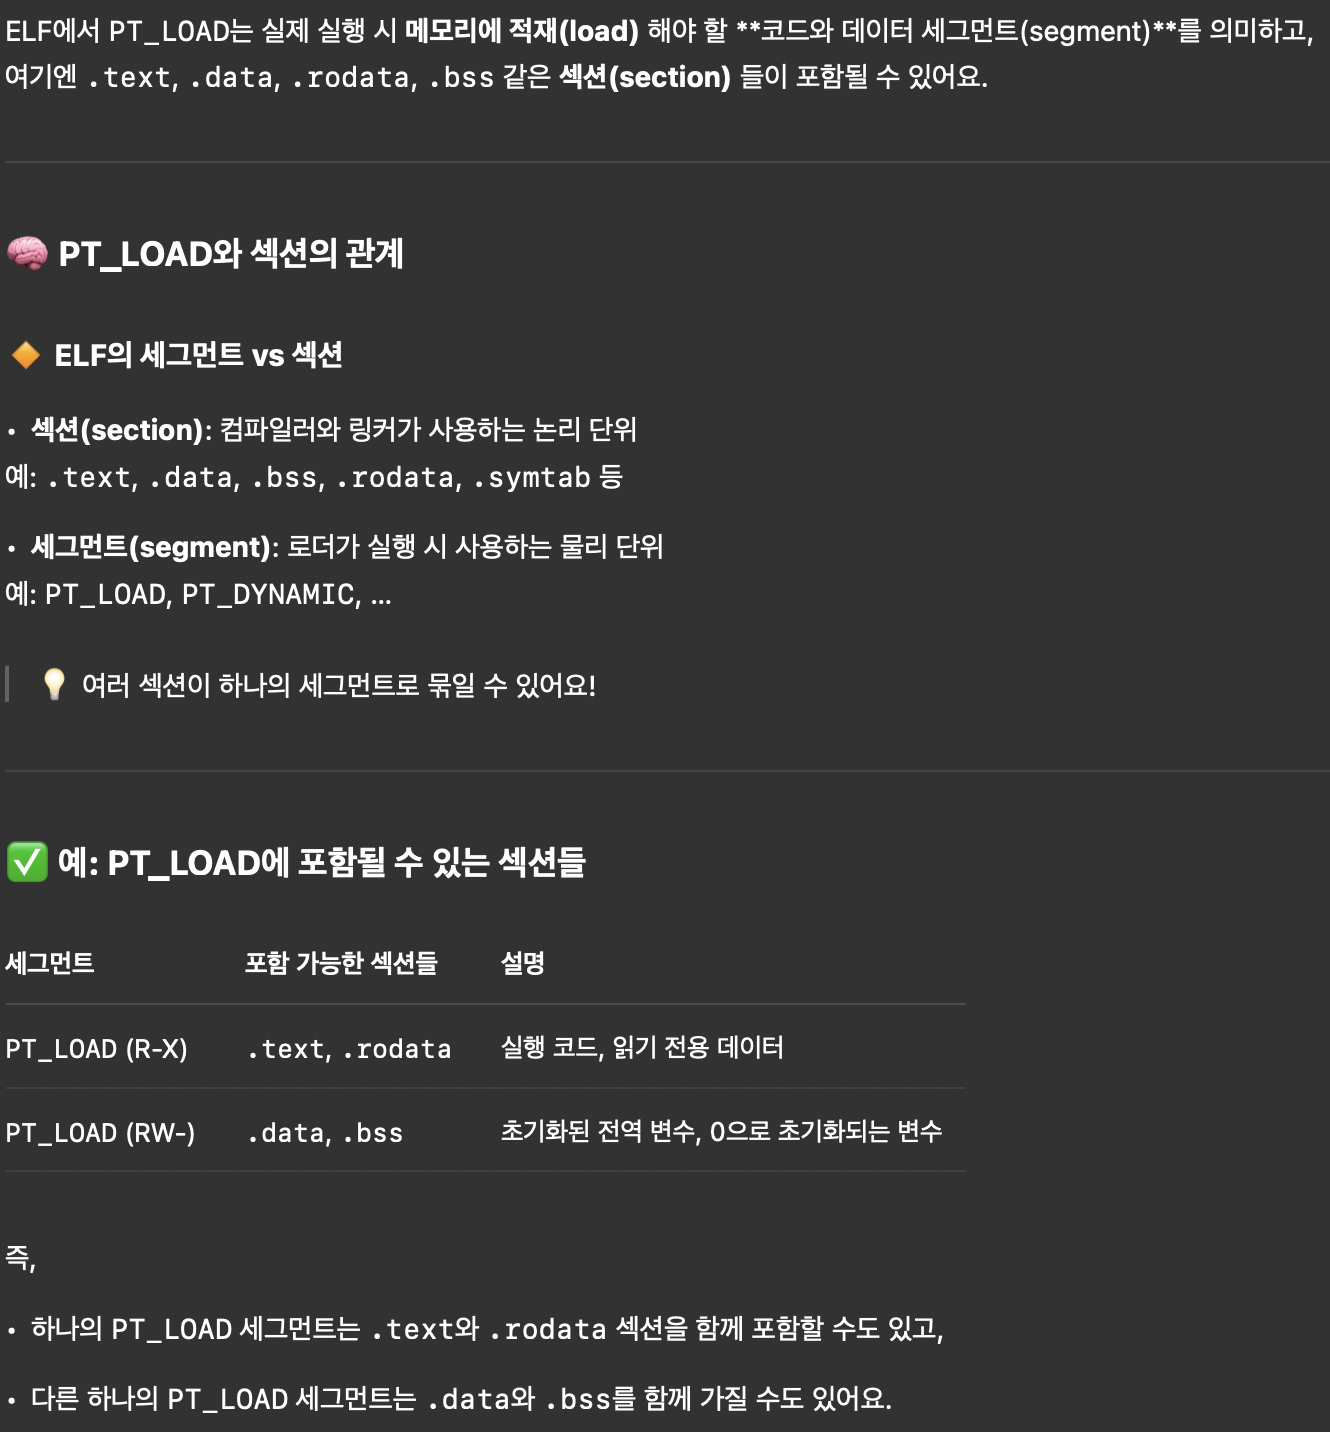
위 사진에서는 여기에 있는 것을 확인할 수 있다.
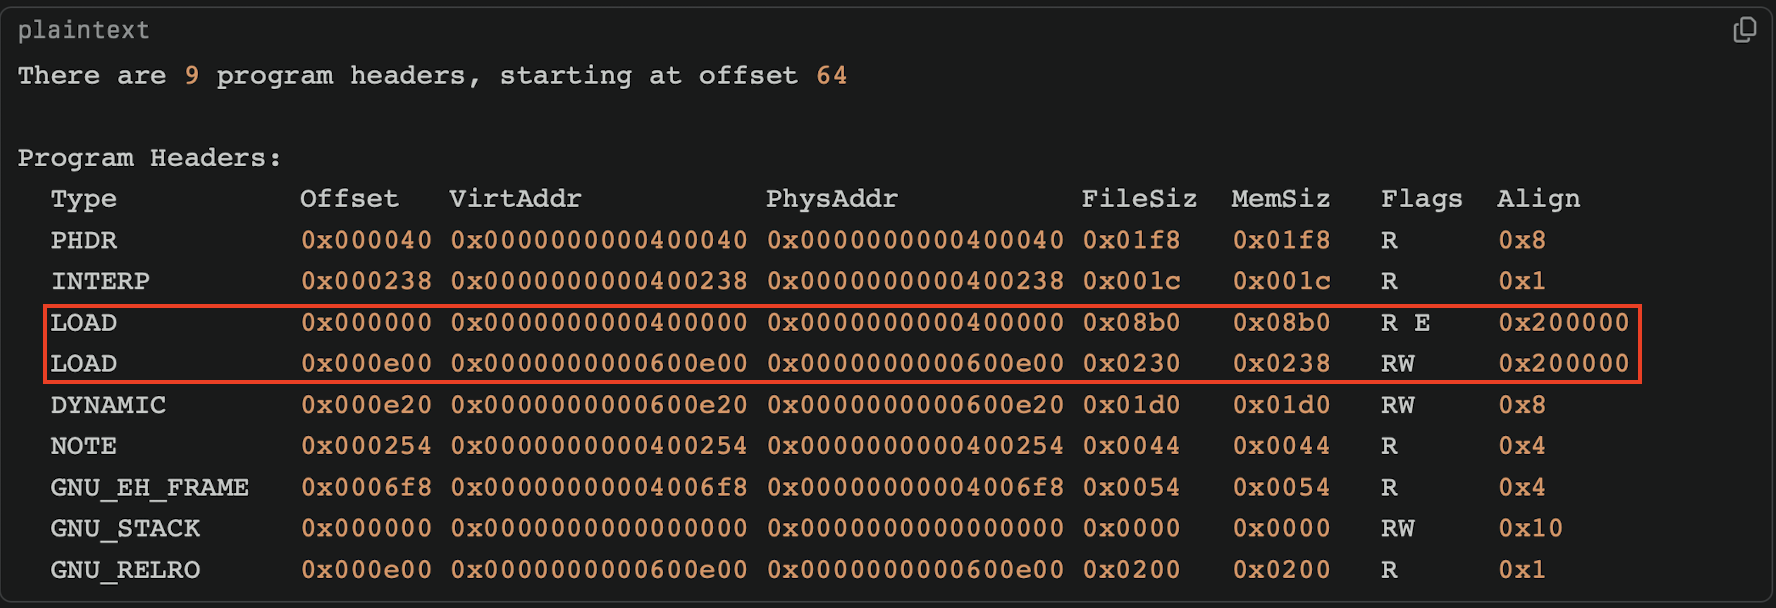
근데 보면 LOAD가 두 개로 나뉘어져있다. 차이가 보이는가?
바로 Flags의 차이이다. 위 LOAD는 R E Flag를 가지고 있고, 아래는 RW만 가지고 있다.
R E는 읽기, 실행가능이라는 의미이고 RW는 읽고 쓰기가 가능하다는 의미이다.
이제야 이해가 된 것은 elf 파일은 단순히 메모.txt 같은 파일이 아니고, 안에 코드와 데이터 등등이 들어있는 파일이라는 것을 이해했다. 실행 가능 목적 파일인 것을 간과했다.
그럼 이제 PT_LOAD의 case에는 어떤 동작이 일어나는지 살펴보자.
if (validate_segment (&phdr, file)) {
	bool writable = (phdr.p_flags & PF_W) != 0;
	uint64_t file_page = phdr.p_offset & ~PGMASK;
	uint64_t mem_page = phdr.p_vaddr & ~PGMASK;
	uint64_t page_offset = phdr.p_vaddr & PGMASK;
	uint32_t read_bytes, zero_bytes;
	if (phdr.p_filesz > 0) {
		/* Normal segment.
		* Read initial part from disk and zero the rest. */
		read_bytes = page_offset + phdr.p_filesz;
		zero_bytes = (ROUND_UP (page_offset + phdr.p_memsz, PGSIZE) - read_bytes);
	} else {
	/* Entirely zero.
	* Don't read anything from disk. */
		read_bytes = 0;
		zero_bytes = ROUND_UP (page_offset + phdr.p_memsz, PGSIZE);
	}
	if (!load_segment (file, file_page, (void *) mem_page, read_bytes, zero_bytes, writable))
		goto done;
	}
우선은 ... GPT한테 물어봐야할 듯 하다.
if (validate_segment (&phdr, file)) 먼저 세그먼트의 유효성을 검사한다. 이는 아래의 함수를 참고하자.
그리고 PGMASK가 등장한다.
PGMASK란 뭘까?
#define BITMASK(SHIFT, CNT) (((1ul << (CNT)) - 1) << (SHIFT))

/* Page offset (bits 0:12). */
#define PGSHIFT 0                          /* Index of first offset bit. */
#define PGBITS  12                         /* Number of offset bits. */
#define PGSIZE  (1 << PGBITS)              /* Bytes in a page. */
#define PGMASK  BITMASK(PGSHIFT, PGBITS)   /* Page offset bits (0:12). */
BITMASK는 왼쪽으로 bit를 몇 번 움직였는지에 관한 매크로이다.
지금 PGMASK는 BITMASK(PGSHIFT, PGBITS)라고 정의되어있고
이는 다시 말해 BITMASK(0, 12)와 같은 의미이며,
실제 비트로 나타내면 1111 1111 1111과 같다.
그렇다면 하위 12비트로 무엇을 할까?
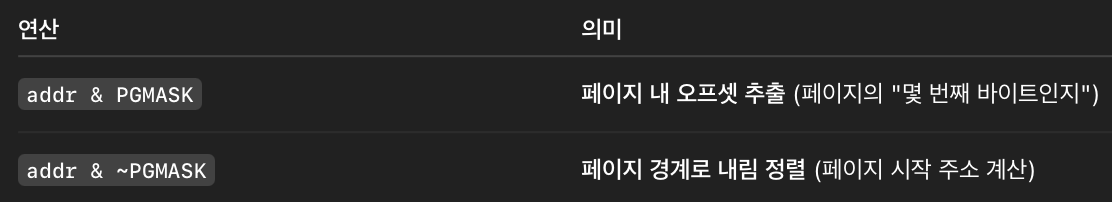
라고 한다. 근데 그래도 여전히 모르겠다.
그래서 힘을 빌렸다.
PGMASK는 다음과 같다.
PGMASK = 0xFFF (1111 1111 1111)
그리고 예를 들기 전 하나만 이해를 해보자.
한 페이지당 4kb이므로 이는 와 같다.
이를 16진수로 바꾸기 위해 씩 묶으면 ==
이는 0x1000이다. 16진수 주소에서 페이지는 0x1000단위로 끊어서 만든다.
즉, 첫 번째 페이지는 0x0000000 ~ 0x0000FFF
두 번째 페이지는 0x0001000 ~ 0x0001FFF 이런 느낌이다.
물론 꼭 첫 번째 페이지가 저 주소가 되리라는 법은 없지만, 저렇게 끊어읽는다고 생각하면 될 듯하다.
그럼 이제 예와 함께보자.
"밥 먹자"를 가리키는 예시 주소는 다음과 같다.
addr = 0x8048123
먼저 addr & ~PGMASK 연산을 할 것이다.
~PGMASK는 0xFFFF000과 같으므로 연산 결과는 0x8048000과 같다.
"밥 먹자"가 있는 페이지의 시작 주소가 0x8048000이고, 해당 페이지의 끝 주소는 0x8048FFF이다.
그리고 addr & PGMASK 연산을 하면 0x0000123이며
해당 페이지에서 0x0000123 오프셋만큼 이동했다고 생각하면 된다.
validate_segment
static bool
validate_segment (const struct Phdr *phdr, struct file *file) {
	/* p_offset and p_vaddr must have the same page offset. */
	if ((phdr->p_offset & PGMASK) != (phdr->p_vaddr & PGMASK))
		return false;

	/* p_offset must point within FILE. */
	if (phdr->p_offset > (uint64_t) file_length (file))
		return false;

	/* p_memsz must be at least as big as p_filesz. */
	if (phdr->p_memsz < phdr->p_filesz)
		return false;

	/* The segment must not be empty. */
	if (phdr->p_memsz == 0)
		return false;

	/* The virtual memory region must both start and end within the
	   user address space range. */
	if (!is_user_vaddr ((void *) phdr->p_vaddr))
		return false;
	if (!is_user_vaddr ((void *) (phdr->p_vaddr + phdr->p_memsz)))
		return false;

	/* The region cannot "wrap around" across the kernel virtual
	   address space. */
	if (phdr->p_vaddr + phdr->p_memsz < phdr->p_vaddr)
		return false;

	/* Disallow mapping page 0.
	   Not only is it a bad idea to map page 0, but if we allowed
	   it then user code that passed a null pointer to system calls
	   could quite likely panic the kernel by way of null pointer
	   assertions in memcpy(), etc. */
	if (phdr->p_vaddr < PGSIZE)
		return false;

	/* It's okay. */
	return true;
}
주석이 아주 친절하게 달려있다.
install_page
물리메모리에 공간을 확보하는 함수이다.
setup_stack
유저 공간의 스택을 설정하는 함수라고 한다. 프로세스를 처음 만들게 되면 실행이 필요하다. fork를 통해 생성된 프로세스에서는 필요없다.
Syscall
-syscall.c-
살펴볼건 딱히 없고 구현이 궁금하다면 아래를 참고하자.
https://velog.io/@mogiyoon/Pintos-프로젝트2-고찰같다#syscallc
-syscall.h-
처음에는 syscall.c만 보고 '뭐야 별거없네'라고 생각했다.
착각이었다. 아래 함수들에 코드를 추가해야 한다.
halt (void)
power_off()을 호출하여 핀토스를 종료한다.
exit (int status)
status를 커널에 반환하고 현재 유저 프로그램을 종료한다.
만약 부모 프로세스가 이를 기다리고 있다면 부모 프로세스에게 status를 반환함. 0은 성공을, nonzero는 에러를 나타낸다.
fork (const char* thread_name)
현재 프로세스의 복제 프로세스를 THREAD_NAME이라는 이름과 함께 생성한다.
%RBX, %RSP, %RBP, %R12-%R15 (피호출자 저장 레지스터) 를 제외한 레지스터 값은 복제할 필요가 없다. 자식 프로세스의 pid를 반드시 반환해야 하며, 그렇지 않으면 올바른 pid가 아니다. 자식 프로세스에서는 반드시 0을 반환해야 한다. 자식은 반드시 가상 메모리 공간이나 파일 디스크립터를 포함한 복제된 자원을 가져야 한다. 부모 프로세스는 자식 프로세스가 성공적으로 복제되었다는 사실을 알기 전까지 절대 return하면 안된다. 만약 자식 프로세스가 자원 복제에 실패하면 부모는 TID_ERROR을 반환해야 한다.
threads/mmu.c의 pm14_for_each()를 사용하면 페이지 테이블 구조에 대응하는 것들을 포함한 전체 유저 메모리 공간을 복제할 수 있다. missing part를 채워야한다.
exec (const char* file)
현재 프로세스를 cmd line에 주어진 이름과 인자들을 포함한 실행가능한 파일 프로세스로 변경한다.
성공하지 않으면 절대 return하지 않는다. 만약 프로그램이 어떤 이유로든 load 혹은 run 될 수 없다면 프로세스는 -1 종료 코드와 함께 종료된다. 이 함수는 exec를 호출한 스레드의 이름은 변경하지 않는다. exec 호출에도 파일 디스크립터는 열린 상태로 남아있다.
wait (pid_t)
child 프로세스의 pid를 기다리거나 child의 종료 상태를 회수한다.
만약 pid가 여전히 살아있다면 종료할 때까지 기다린다. 그리고 pid가 종료하면서 넘긴 상태를 반환한다. 만약 pid가 종료를 호출하지 않았는데 커널에 의해 종료가 됐다면 wait는 반드시 -1을 반환한다.
부모 프로세스가 wait call을 호출했을 때, 이미 종료한 자식 프로세스를 부모 프로세스가 기다리는 것은 문제가 되지 않는다. 하지만 커널은 부모가 자식의 종료 상태를 회수하도록 할 수 있고, 자식이 커널에 의해 종료됐다는 것을 알도록 할 수 있다.
wait 콜이 무조건 실패하고 그 즉시 -1을 반환하는 경우
- pid가 calling process의 direct 자식일 때 가능하다. (A의 자식인 B의 자식인 C를 A가 wait하는 경우)
- 프로세스는 주어진 자식에 대해 최대 한 번까지 wait할 수 있다. (중첩되지 않는다.)
프로세스는 자식 프로세스를 많이 만들 수 있고, 자식을 wait하지 않고 종료할 수 있지만, wait이 일어날 수 있도록 디자인 해야한다. 즉, 부모가 wait를 하든, 하지 않든, 그 부모보다 먼저 혹은 나중에 종료되든 반드시 해제돼야 한다.
핀토스가 초기화 프로세스가 종료되기 전까지는 종료되지 않도록 해야한다. 이를 위해 핀토스는 process_wait()을 메인에서 호출한다.
create (const char* file, unsigned initial_size)
initial_size bytes만큼 file을 호출하여 새로운 파일을 만든다.
성공하면 true를, 실패하면 false를 반환한다. 파일을 만들지만 열지는 않는다.
remove (const char* file)
file을 호출하여 파일을 삭제한다.
성공하면 true를, 실패하면 false를 반환한다. 파일은 열려있든, 닫혀있든 상관없이 제거된다. 그리고 열려있는 파일은 닫지 않고 제거한다.
open (const char* file)
file을 호출하여 파일을 연다.
파일 디스크립터라고 불리는 음이 아닌 정수를 반환하거나 열기에 실패할 경우 -1을 반환한다. open 시스템 콜은 콘솔 입출력을 위한 두 정수(0, 1)는 절대 반환하지 않는다. 각 파일마다 독립적인 파일 디스크립터 테이블을 가지며, 자식 프로세스는 부모의 파일 디스크립터를 상속받는다. open을 호출할 때마다 새로운 파일 디스크립터를 반환한다. 같은 파일에 대한 디스크립터라도 가리키는 파일 위치는 다를 수 있다.
filesize (int fd)
파일의 바이트 크기를 리턴한다.
열린 파일의 파일 디스크립터를 사용하여 크기를 조회한다.
read (int fd, void* buffer, unsigned length)
파일에서 size 크기만큼 버퍼에 읽는다.
실제로 읽은 바이트 크기를 반환하거나 읽지 못한 경우 -1을 반환한다. 0번 디스크립터는 input_getc()를 활용하여 키보드로부터 읽는다.
write (int fd, const void* buffer, unsigned size)
버퍼로부터 size만큼을 파일에 쓴다.
실제로 쓴 바이트를 리턴한다. 즉, 다 못 쓸 경우 size보다 작은 값을 반환한다.
일반적으로 파일의 끝을 넘어서 쓸 경우 파일이 확장되지만, 파일 growth는 기본 파일 시스템에 구현되어 있지 않다. 기대되는 방법은 최대한 많은 바이트를 파일 끝까지 쓰고, 실제 쓴 수를 반환하거나 쓸 수 없으면 0을 반환하는 것이다.
사이즈가 몇 백 바이트보다는 작은 경우에는 putbuf()를 호출하면 버퍼에 있는 모든 내용을 콘솔에 쓸 수 있다. 그렇지 않으면 다른 프로세스에 의해 출력되는 텍스트가 섞이게 된다.
seek (int fd, unsigned position)
열린 파일에서 fd를 사용하여 읽거나 쓸 위치를 변경한다.
파일의 시작을 0이라고 했을 때 바이트로 표현된 위치로 변경한다. seek가 현재 파일의 끝을 지나는 것은 에러가 아니며, read가 0 바이트를 얻거나 write가 파일을 확장하고, 그 사이 공간을 0으로 채운 다음 쓴다. 핀토스 파일은 프로젝트 4 전까지는 고정된 길이이므로 eof를 넘어선 write는 에러를 반환한다.