"데이터의 본질을 찾아서"
- SVD, 고급 군집화 기법
오늘의 키워드를 말씀드리겠습니다.
- SVD
- 특잇값 분해를 이용한 차원 축소 및 압축
- Truncated SVD
- 이미지 압축
- 고급 군집화
- Mean Shift
- DBSCAN
🔍 1. SVD란?
SVD는 Singular Value Decomposition의 약자예요. 한국말로는 특잇값 분해라고 부릅니다.
어떤 행렬이든 3개의 행렬로 분해할 수 있다! 숫자를 소인수분해 하듯이 행렬을 분해하는 겁니다.
식으로 나타내면,
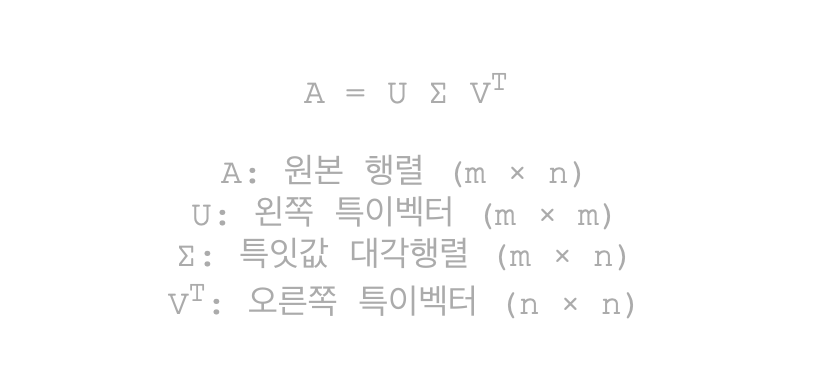
SVD의 직관적인 의미
성적표를 예로 들면,
100명의 학생이 10개 과목 시험을 봤다면 총 1000개의 점수(숫자)가 있겠죠. 하지만 SVD로 분해하면, 이 데이터를 3개의 학습 유형만으로 90% 설명이 가능할 수 있어요.
U : 학생들의 학습 유형
Σ : 각 학습 유형의 중요도
V^T : 과목들의 과목 특성
이렇게 데이터가 많은 성적표를 간단한 패턴으로 설명할 수 있게 됩니다.
2.📉 SVD (특잇값 분해)를 이용한 차원 축소 및 압축
SVD는 행렬 분해 기술 중 하나로, 어떤 행렬이든 세 개의 행렬로 분해하여 데이터의 본질적인 패턴을 찾고 압축하는 데 사용되는 것이라 앞서 설명 드렸습니다.
Truncated SVD
Truncated SVD (절단된 SVD)를 이용한 압축SVD의 핵심은 특잇값이 작은 패턴은 데이터에 미치는 영향이 적다는 것입니다.
원리: 상위 k개의 큰 특잇값만 남기고 나머지 특잇값과 이에 대응하는 벡터를 버려 행렬을 근사적으로 재구성합니다.
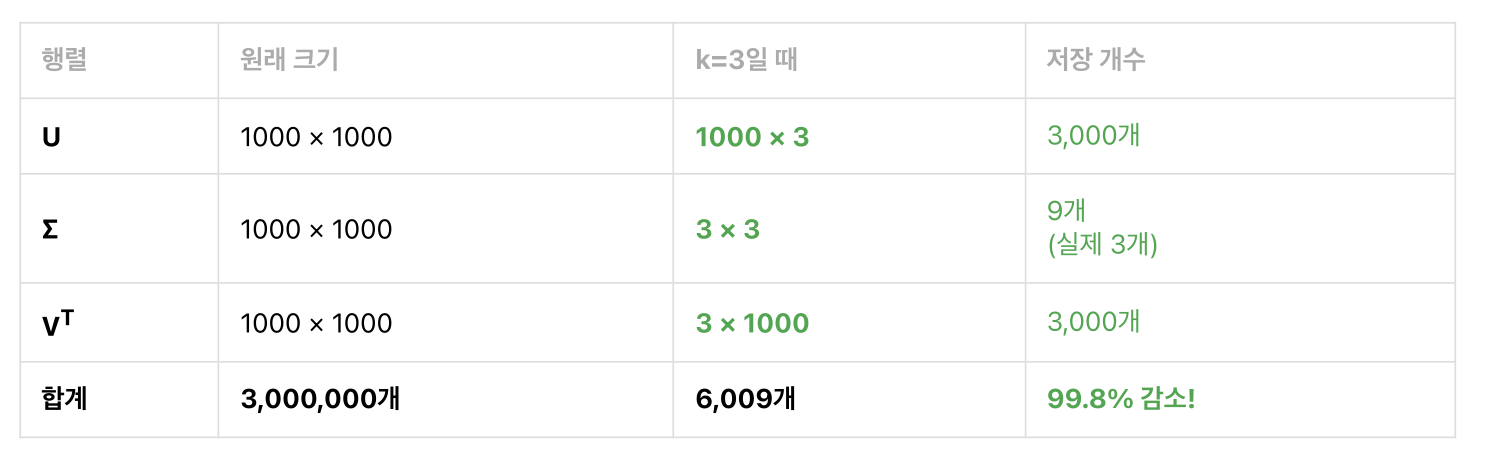
압축 효과: 1000 X 1000 크기의 이미지 행렬을 예로 들 때, k=3만 사용해도 원본 300만 개의 값을 약 6,009개로 줄일 수 있습니다. (약 99.8% 감소)
활용: 상위 몇 개의 특잇값만으로도 이미지나 데이터의 대부분의 정보(에너지)를 유지할 수 있어 이미지 파일 크기를 대폭 줄이는 데 사용됩니다.
크기를 다시 정리해보면,
Full SVD vs Truncated SVD (k=3)
행렬곱 확인
Uk (1000×3) × Σk (3×3) × VkT (3×1000)
= (1000×3) × (3×1000)
= 1000 × 1000
→ 여전히 원본과 같은 크기로 복원됨!
왜 이렇게 줄일 수 있는가?
특잇값 대부분은 매우 작기 때문
예: [850, 320, 95, 12, 3, 1, 0.5, 0.2, ...]
앞의 3개 합: 850 + 320 + 95 = 1265
나머지 997개 합: 약 20
→ 상위 3개가
전체의 98%!
즉, 상위 3개 특잇값만 사용한다 = 행렬을 구성하는'중요한 패턴 3개만 남긴다'
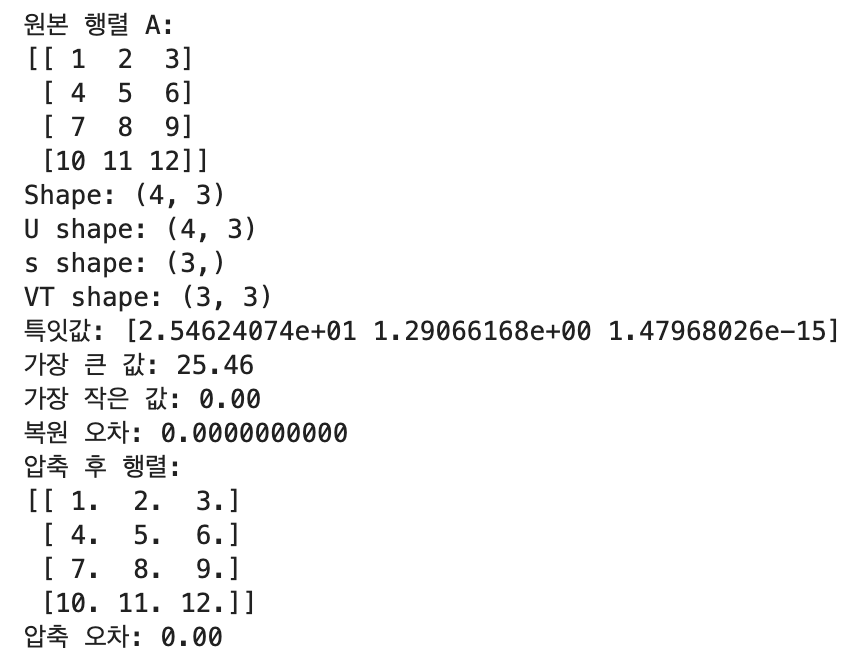
실습 코드
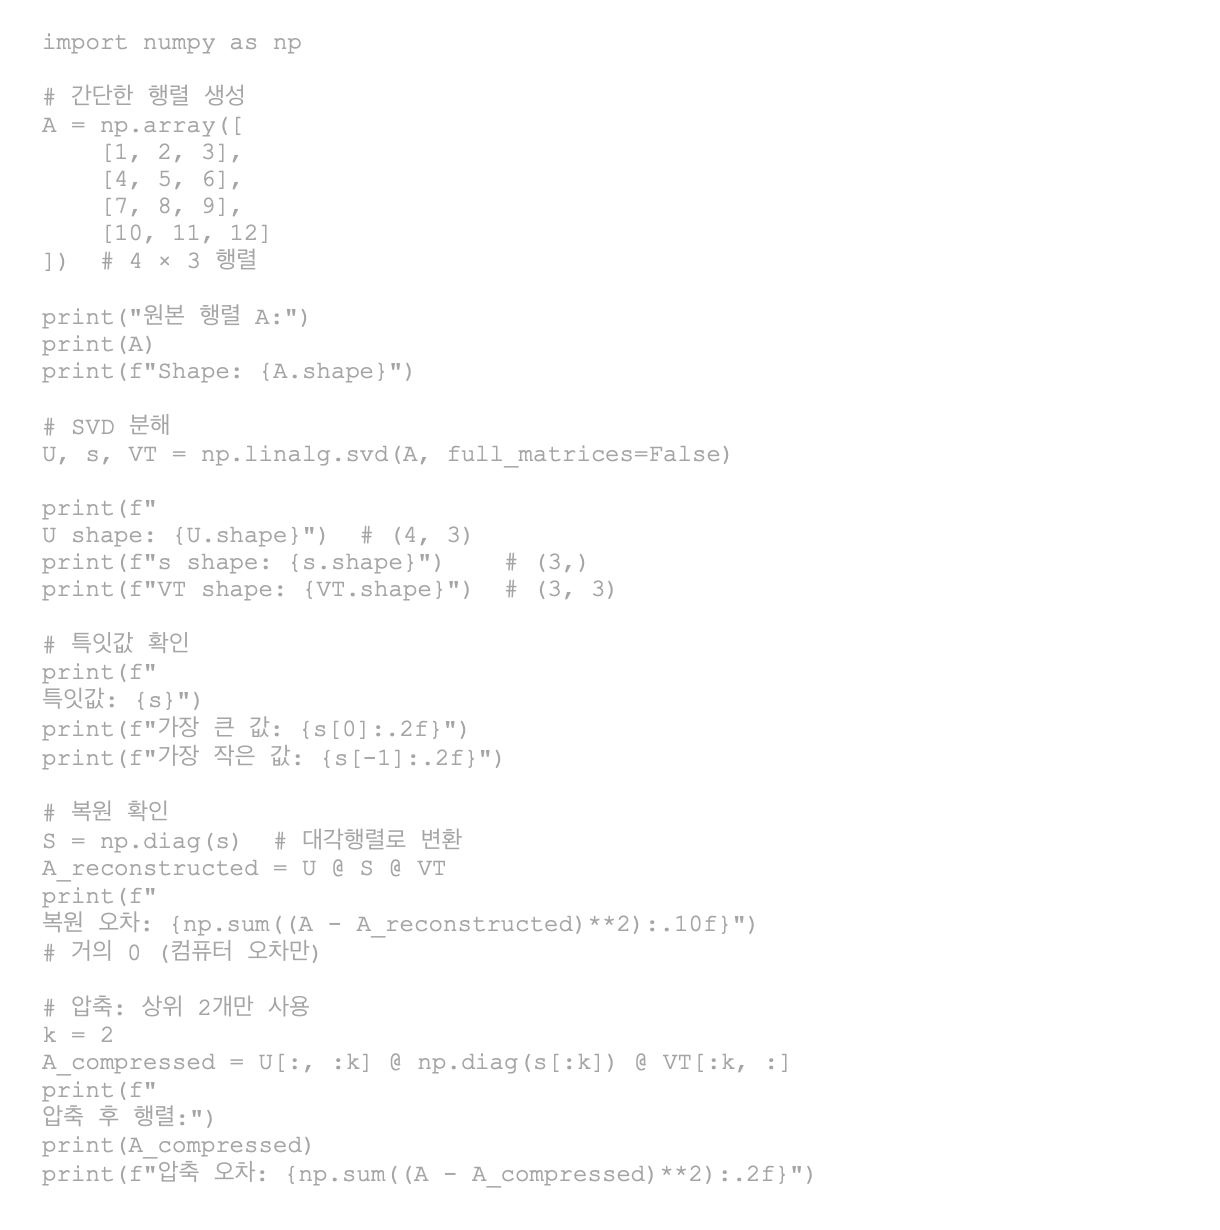
실행하면
이미지 압축
SVD로 이미지 파일 크기 줄이는 것을 말합니다.
SVD를 이용한 이미지 압축은 이미지를 수많은 패턴의 합으로 분해한 뒤, 가장 중요도가 높은 패턴만 남겨 원본과 유사하게 재구성하는 손실 압축 방식입니다.
이에 대한 장점과 단점을 표로 나타내면
| 장점 | 단점 |
|---|---|
| 파일 크기 대폭 감소 | 완벽한 복원은 불가 |
| 중요한 특징 보존 | 손실 압축 방식 |
| k 조절로 압축률 조정 | JPEG보다 효율은 낮음 |
이는 JPEG의 기본 원리와 같습니다. 실제로 JPEG는 SVD와 비슷한 이산 코사인 변환(DCT)을 사용하지만, 근본적인 아이디어는 '데이터의 중요하지 않은 성분을 버린다'는 점에서 유사합니다. SVD 압축은 실전에서 의료 영상, 위성 이미지 등 특정 분야에서 데이터의 핵심적인 정보를 효율적으로 보존하면서 압축률을 세밀하게 조절할 수 있어 유용하게 활용될 수 있습니다.
실습 코드
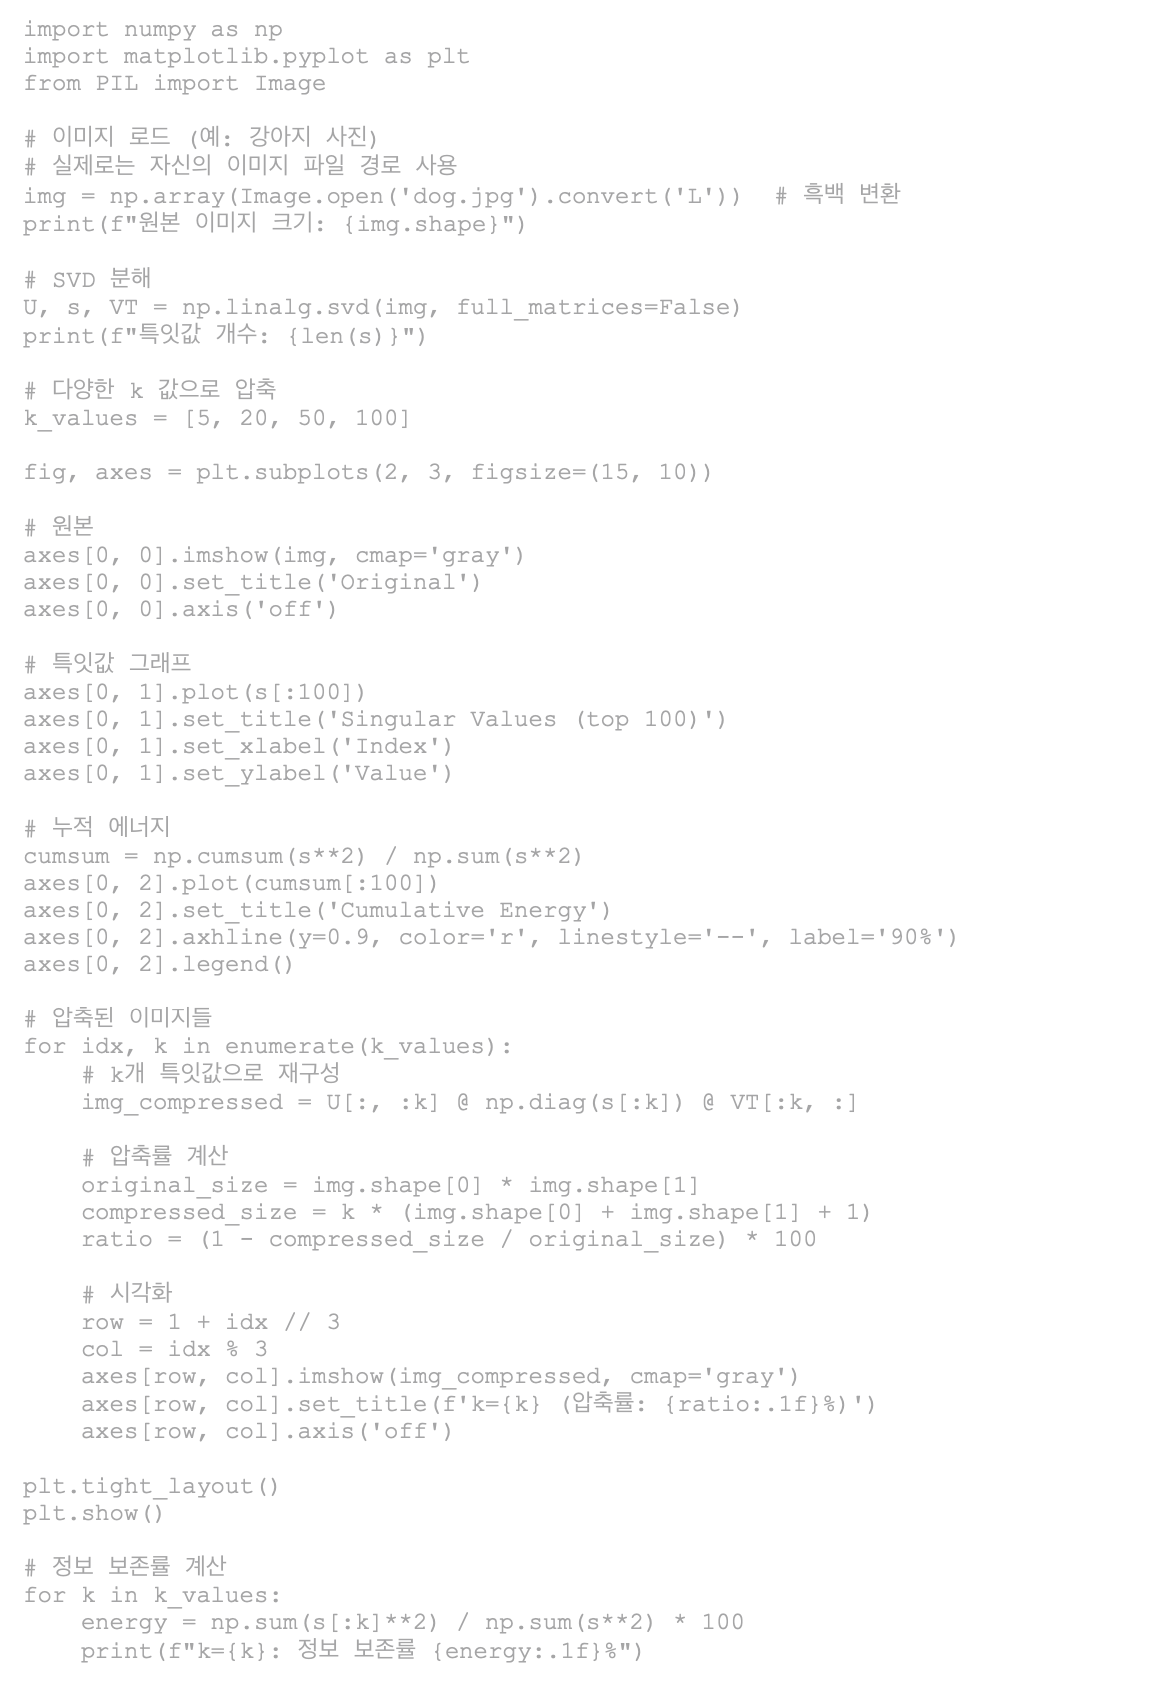
실행할때, 사진을 같은 위치상에 놔주셔야 합니다!
예를 들어서 주피터에서 실행하는거면 주피터에 사진을 올려주세용
저는 쿼카 사진을 압축해보도록 하겠습니다.
코드를 실행하면
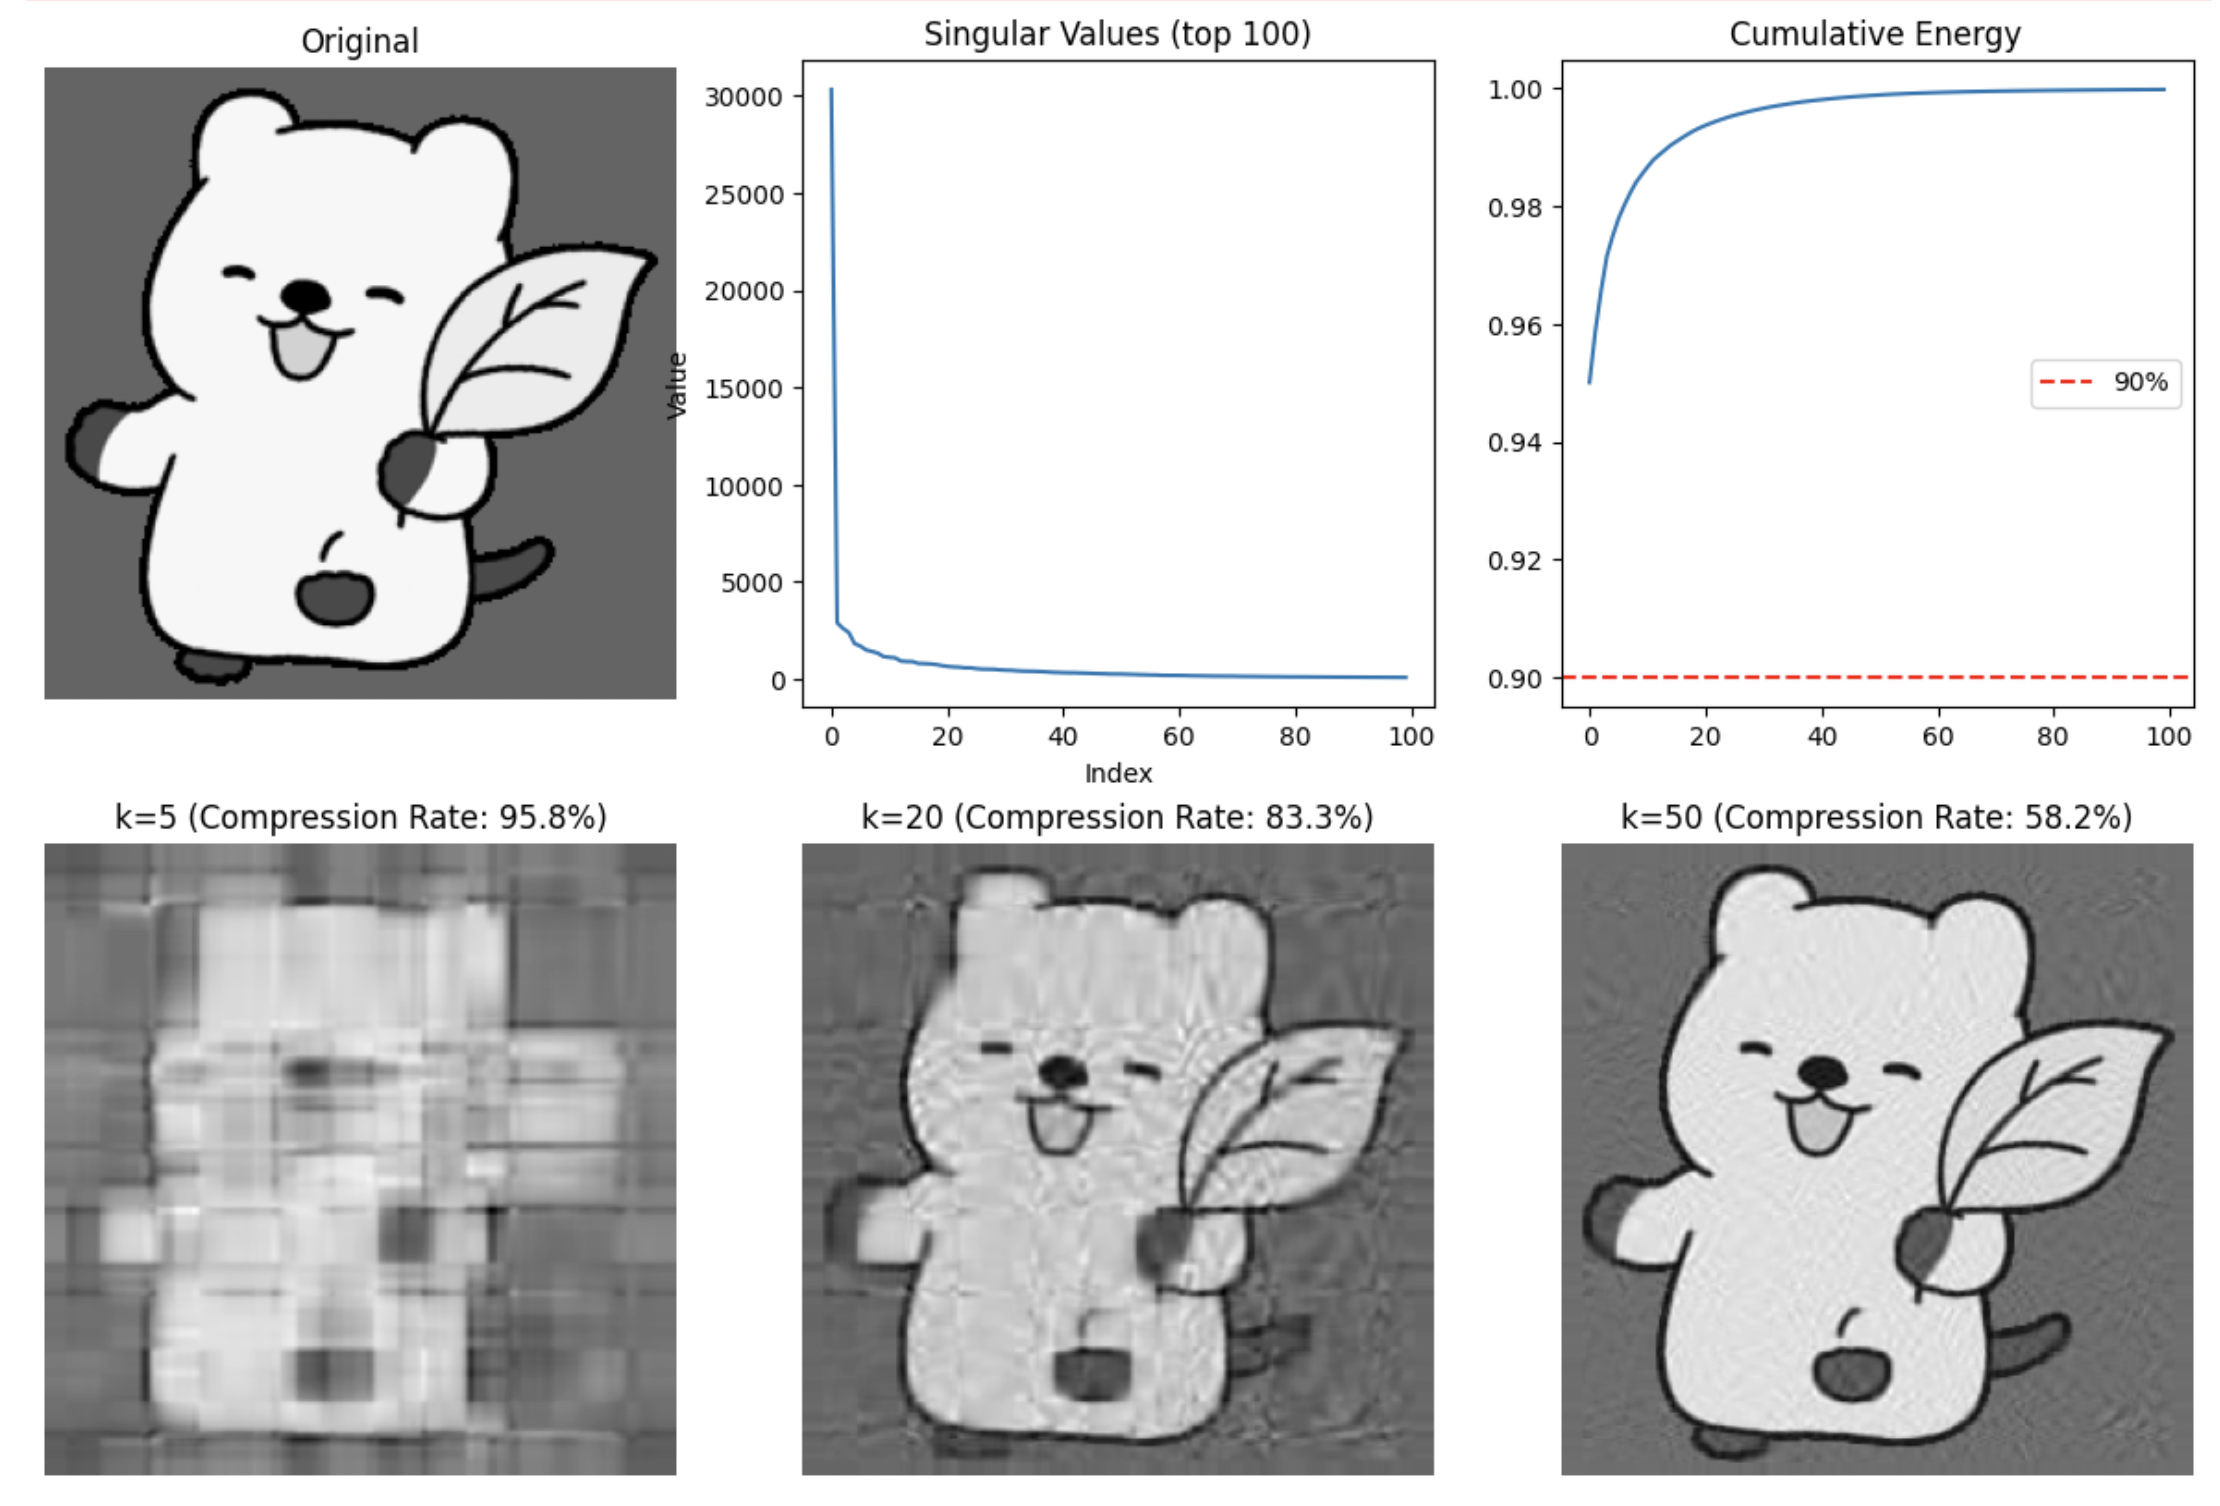
이렇게 사진이 압축되는걸 확인할 수 있습니다.
3. 고급 군집화 (Mean Shift & DBSCAN)
저희 1일차에서 K-means와 Hierarchical를 배워보았습니다.
이 두가지 방법의 한계는 K-means는 K를 미리 알아야하고,
Hierarchical는 큰 데이터에 쓰이면 느리다는 한계점을 가지고 있습니다.
그리고 두가지 다 노이즈/이상치에 약하고,복잡한 모양 군집 어렵다는 문제점이 있죠.
이런 한계를 극복하는 하기 위해 두가지가 출동합니다! Mean Shift, DBSCAN 이 녀석들입니다.
Mean Shift (평균 이동)
데이터의 밀도 경사(Density Gradient)를 따라 각 점을 가장 밀도가 높은 지점(군집 중심)으로 이동시켜 군집을 형성하는 방법입니다.
작동 원리:
1. 초기화 : 각 점 주변에 윈도우(반경 = bandwidth)를 설정합니다.
2. 윈도우 설정 : 윈도우 내 점들의 평균 위치(무게 중심)를 계산합니다.
3. Mean Shift : 현재 위치를 평균 위치로 이동(Shift)합니다.
4. 반복 및 군집 할당 : 수렴할 때까지 반복하며, 같은 곳으로 수렴한 점들을 하나의 군집으로 할당합니다.
장점:
1. K(군집 수)를 미리 지정할 필요가 없다.
2. 복잡한 모양의 군집도 가능하다.
3. 이상치를 자동 분리하는 경향이 있다.
단점:
1. Bandwidth 선택이 매우 중요하다.
2. 계산 비용이 높다.
3. 고차원에서 느리다.
실습해보면
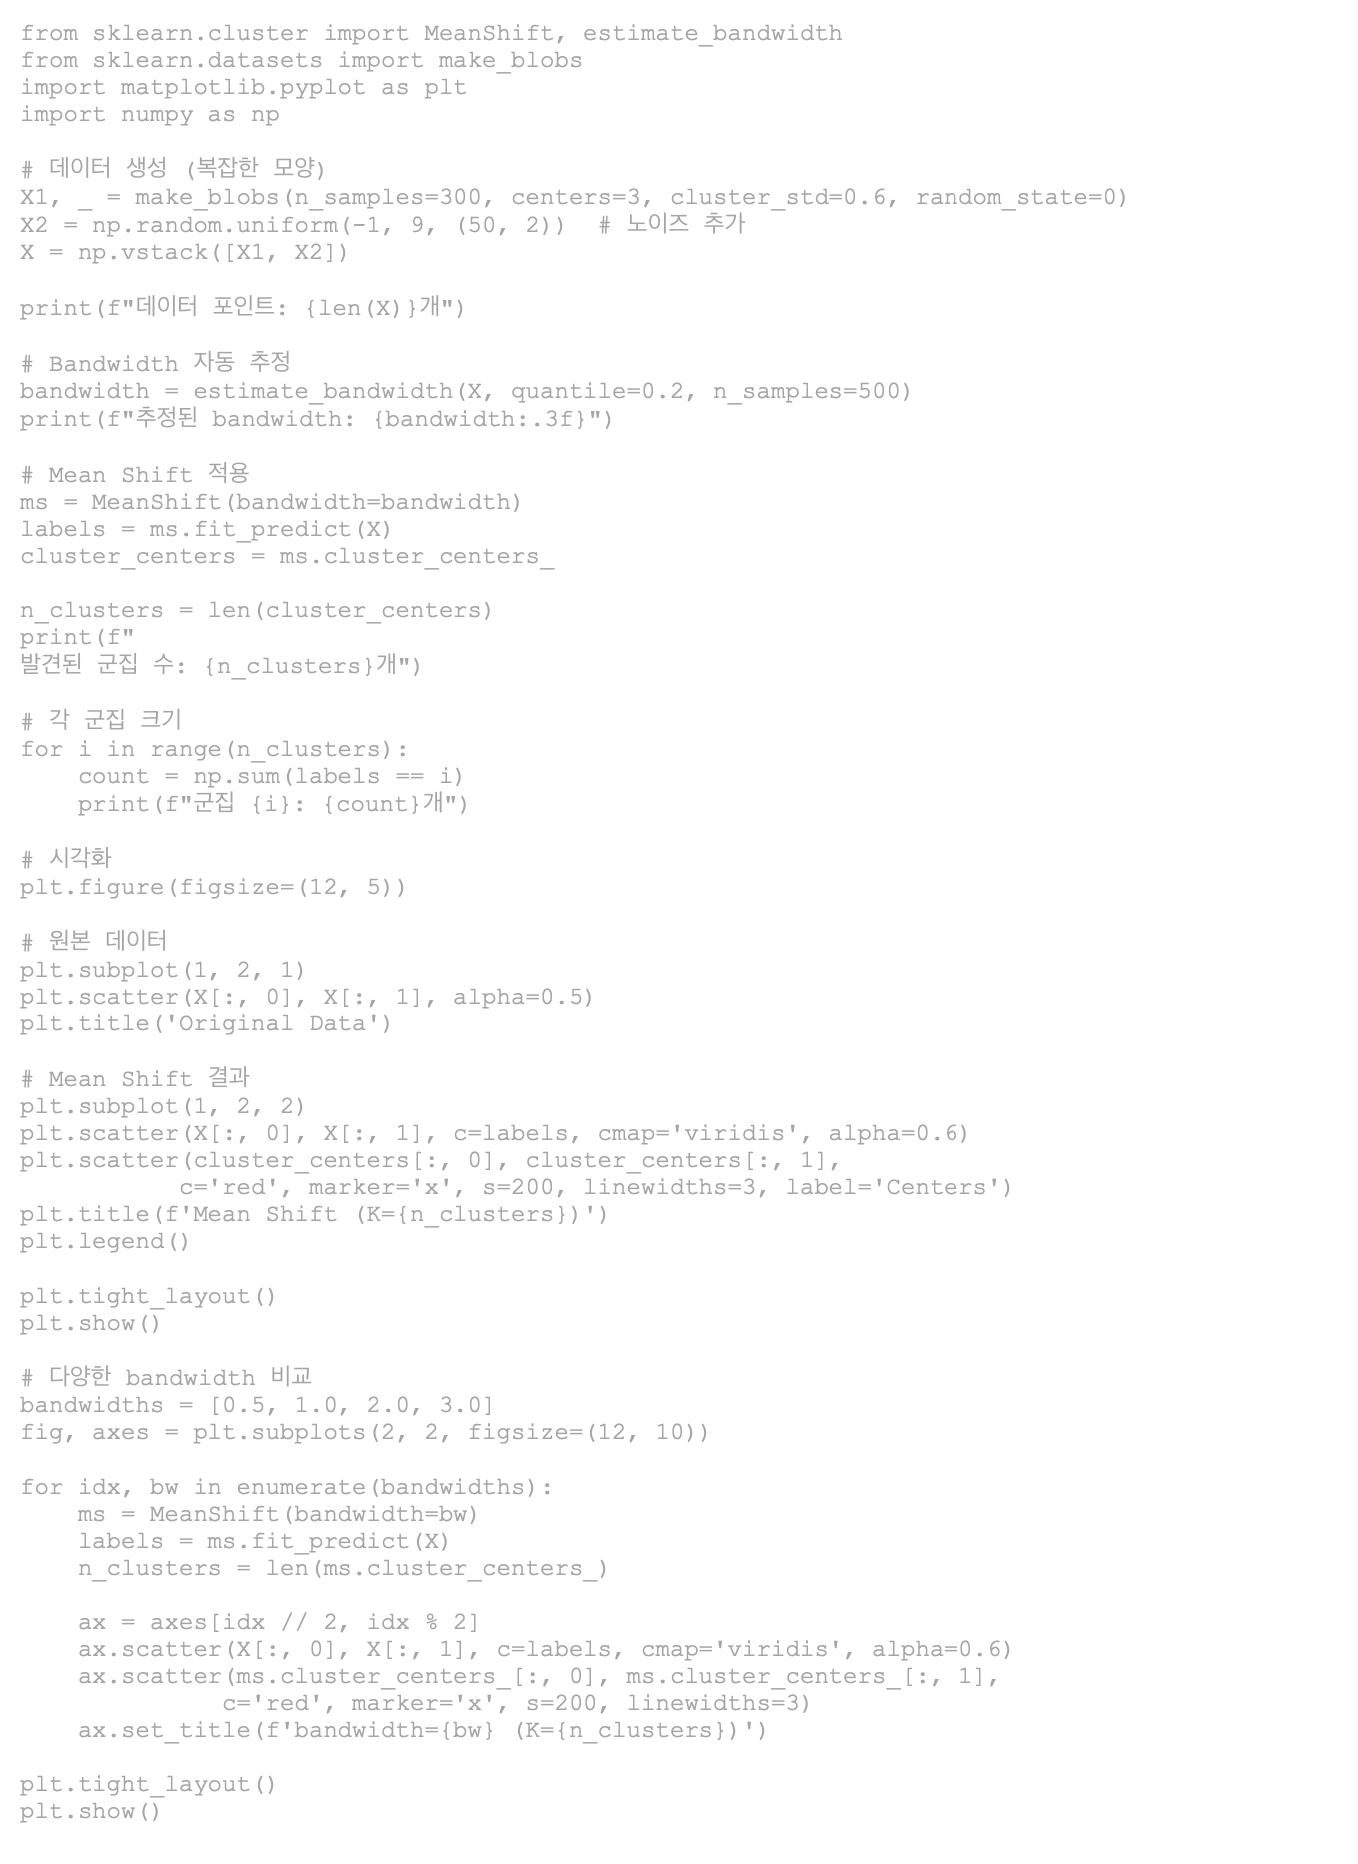
이 코드를 실행하면
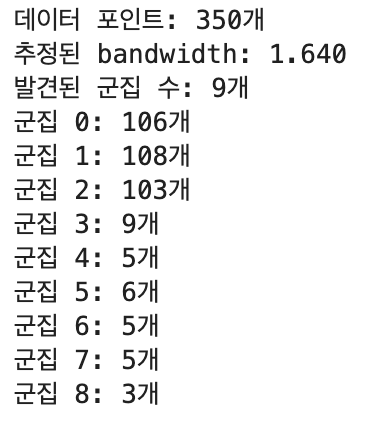
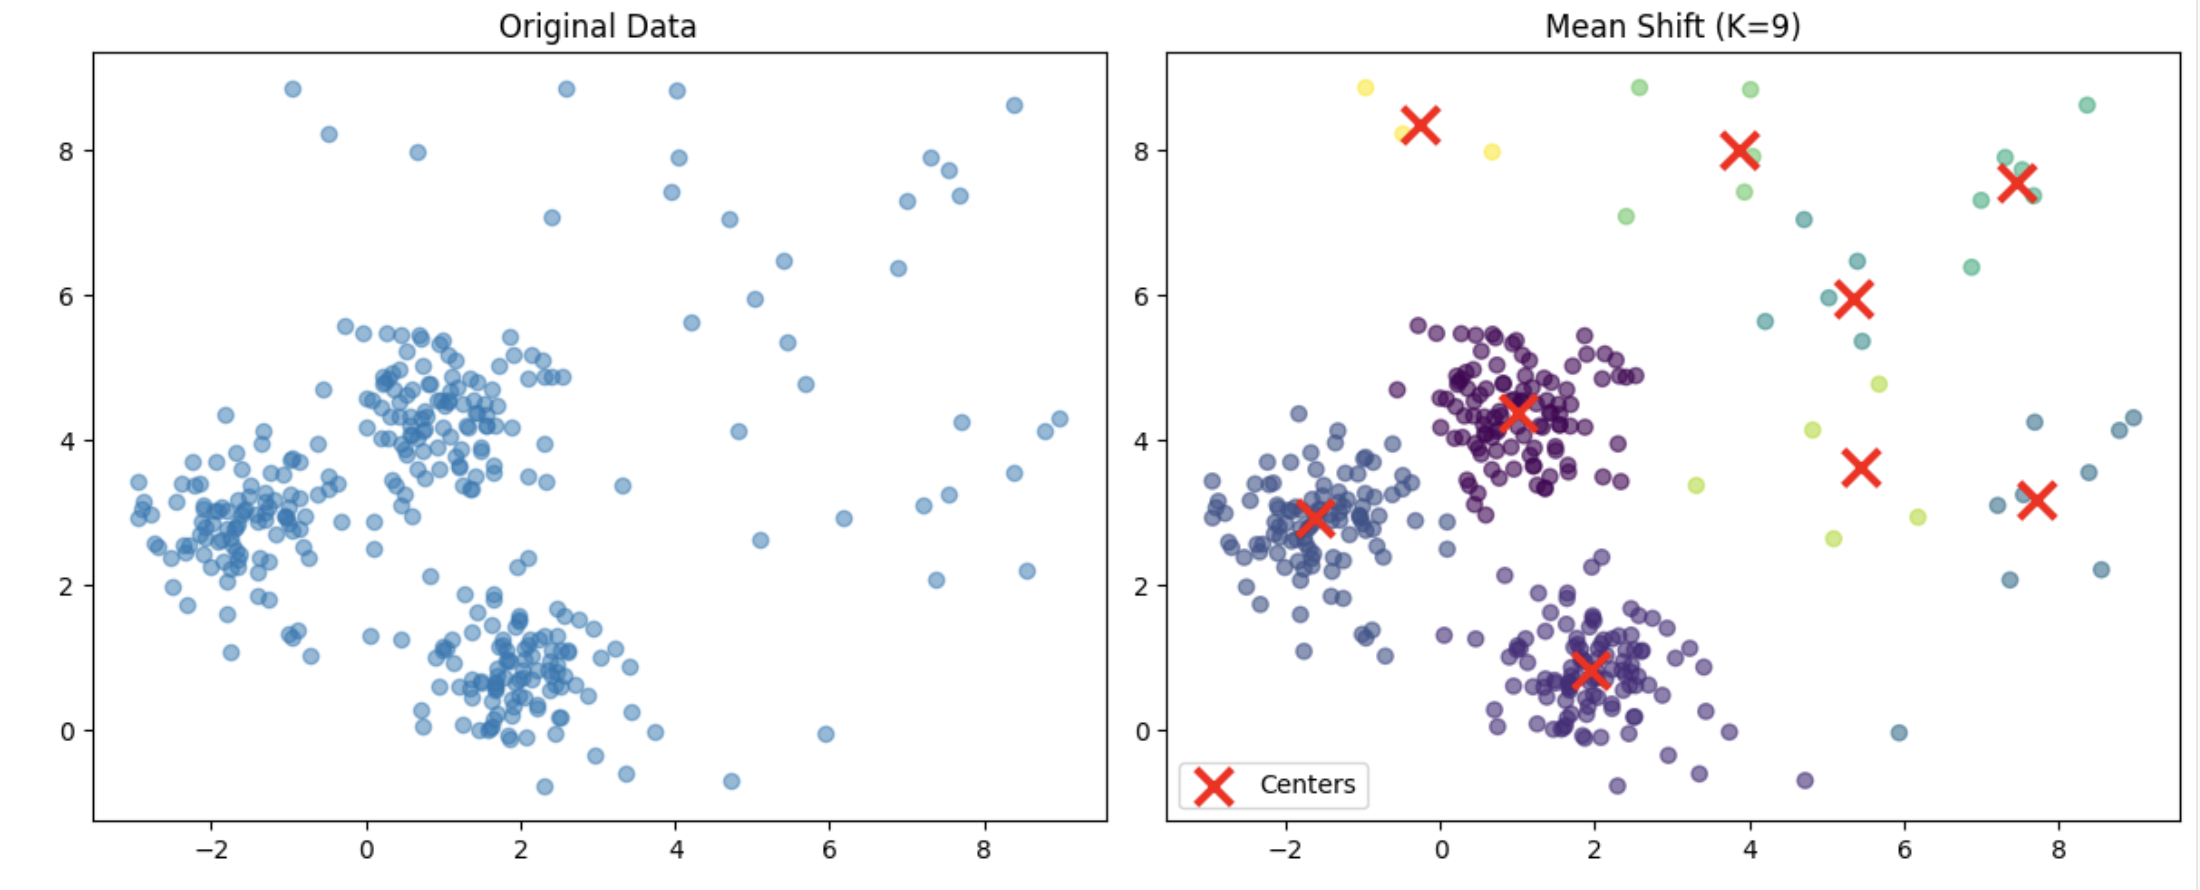
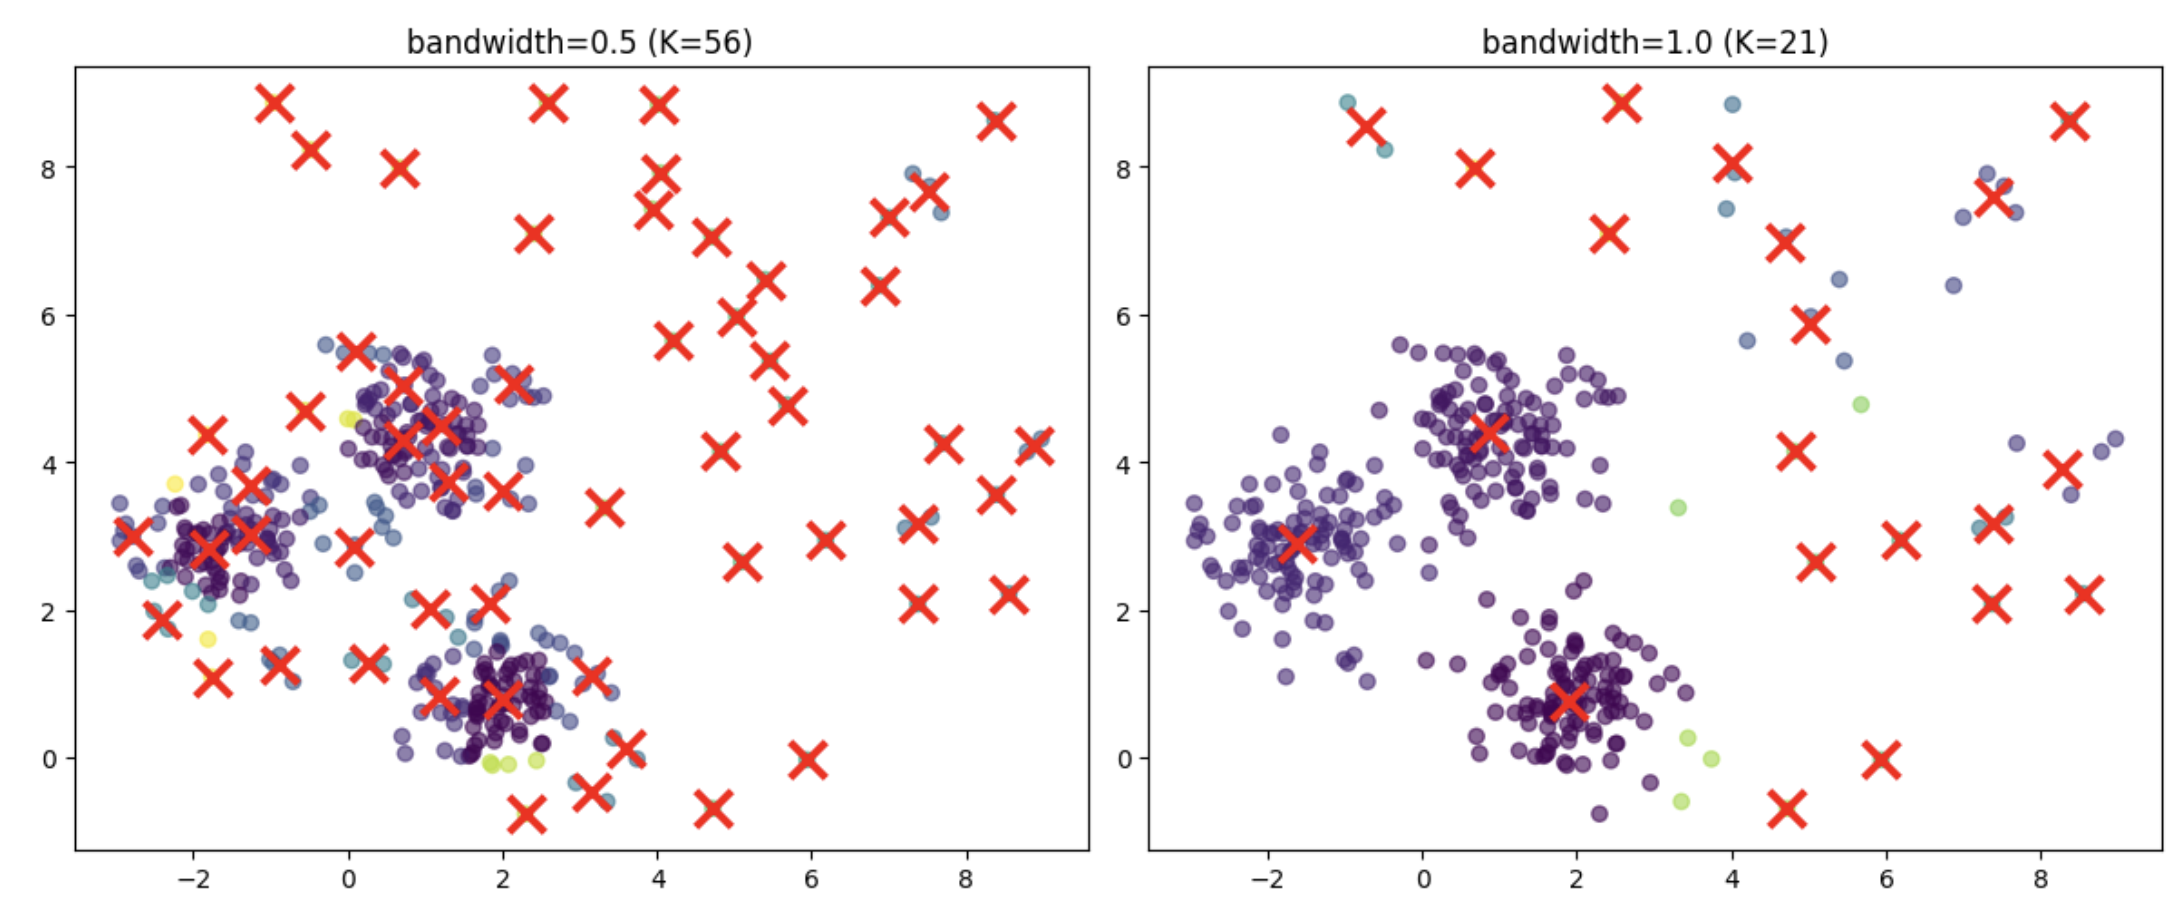
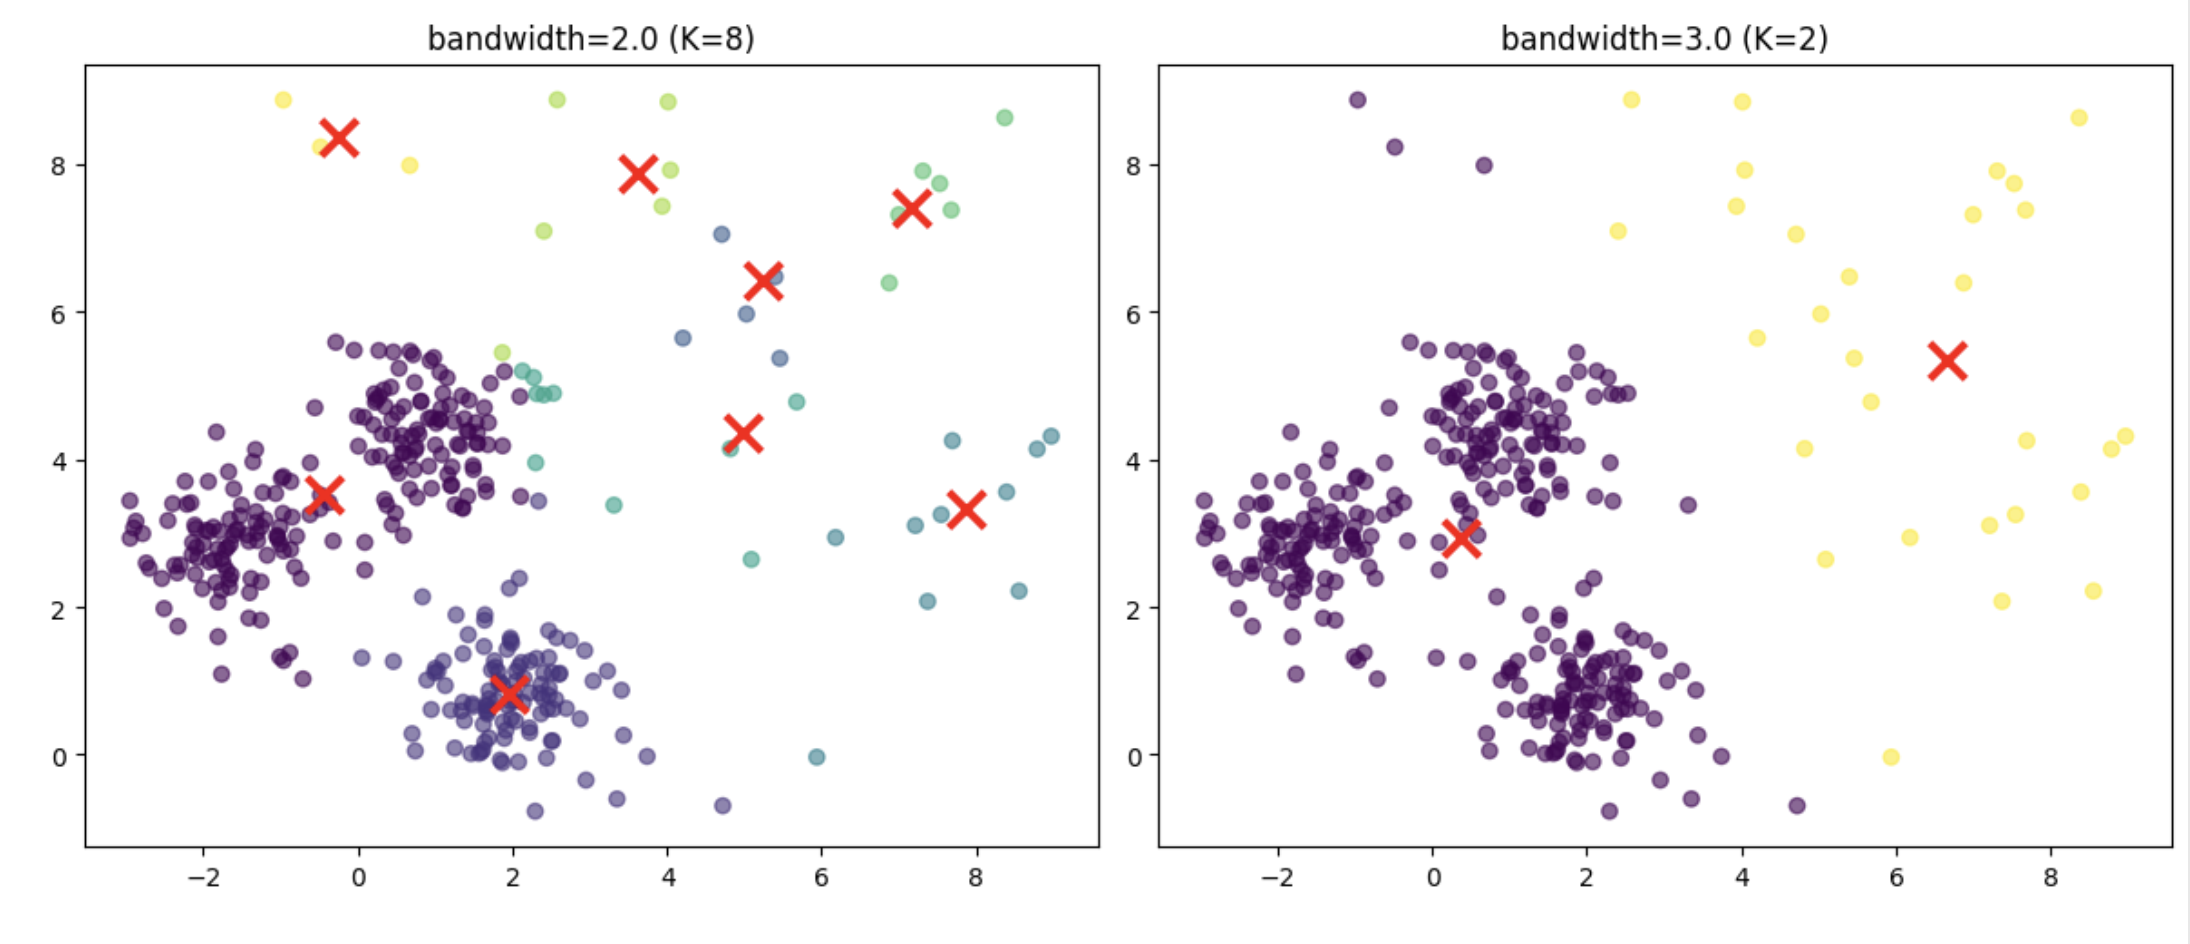
이런 결과를 얻을 수 있습니다.
이는 Mean Shift의 성능이 bandwidth라는 단 하나의 파라미터 선택에 따라서 어떠한 영향을 받는지를 보여줍니다.
DBSCAN 복습 및 심화
밀도 연결성(Density Connectivity)을 기반으로 군집을 찾고, 밀도가 낮은 지역의 점들은 노이즈(-1)**로 명시적으로 분리하는 기법입니다.
핵심 파라미터:
- eps (Epsilon): 이웃으로 간주할 최대 거리(반경).
- min_samples: 군집을 형성하기 위한 최소 점 개수.
점의 3가지 타입:
- Core Point (핵심점): eps 내에 min_samples 이상의 이웃을 가지는 점.(군집의 중심)
- .Border Point (경계점): Core Point의 이웃이지만 자신은 Core가 아닌 점(군집의 가장자리)
- Noise Point (노이즈): 어떤 Core Point의 이웃도 아닌 점.(label = -1)
장점: K 지정 불필요 27, 복잡한 모양의 군집을 정확히 구분하고, 노이즈를 명시적으로 분리합니다29292929. 실전에서 대규모 데이터에 사용하기 더 빠릅니다.
파라미터 선택 팁: eps는 K-distance 그래프를 그려 '팔꿈치' 지점을 찾고, min_samples는 보통 **차원 수 X 2로 선택합니다.
그럼 저희가 군집화에서 배운 K-means, Mean Shift, DBSCAN은 언제 무엇을 사용할까?
| 상황 | K-means | Mean Shift | DBSCAN |
|---|---|---|---|
| 군집 모양 | 구형 군집 | 복잡한 모양 가능 | 복잡한/비선형 모양 (원, 초승달) |
| K 지정 여부 | 필수 | 불필요 (자동 결정) | 불필요 (자동 결정) |
| 노이즈 처리 | 노이즈를 무조건 할당 (취약) | 자동 분리 (단, bandwidth 중요) | 명시적 분리 (label -1) |
| 속도 | 빠름 | 느림 (계산 비용 높음) | 빠름 |
| 실전 추천 | 빠른 탐색, 구형, 대규모 데이터 | 매끄러운 밀도 분포, 소규모 데이터 | 복잡한 모양, 노이즈 많음, 대규모 데이터 |
DBSCAN 실습
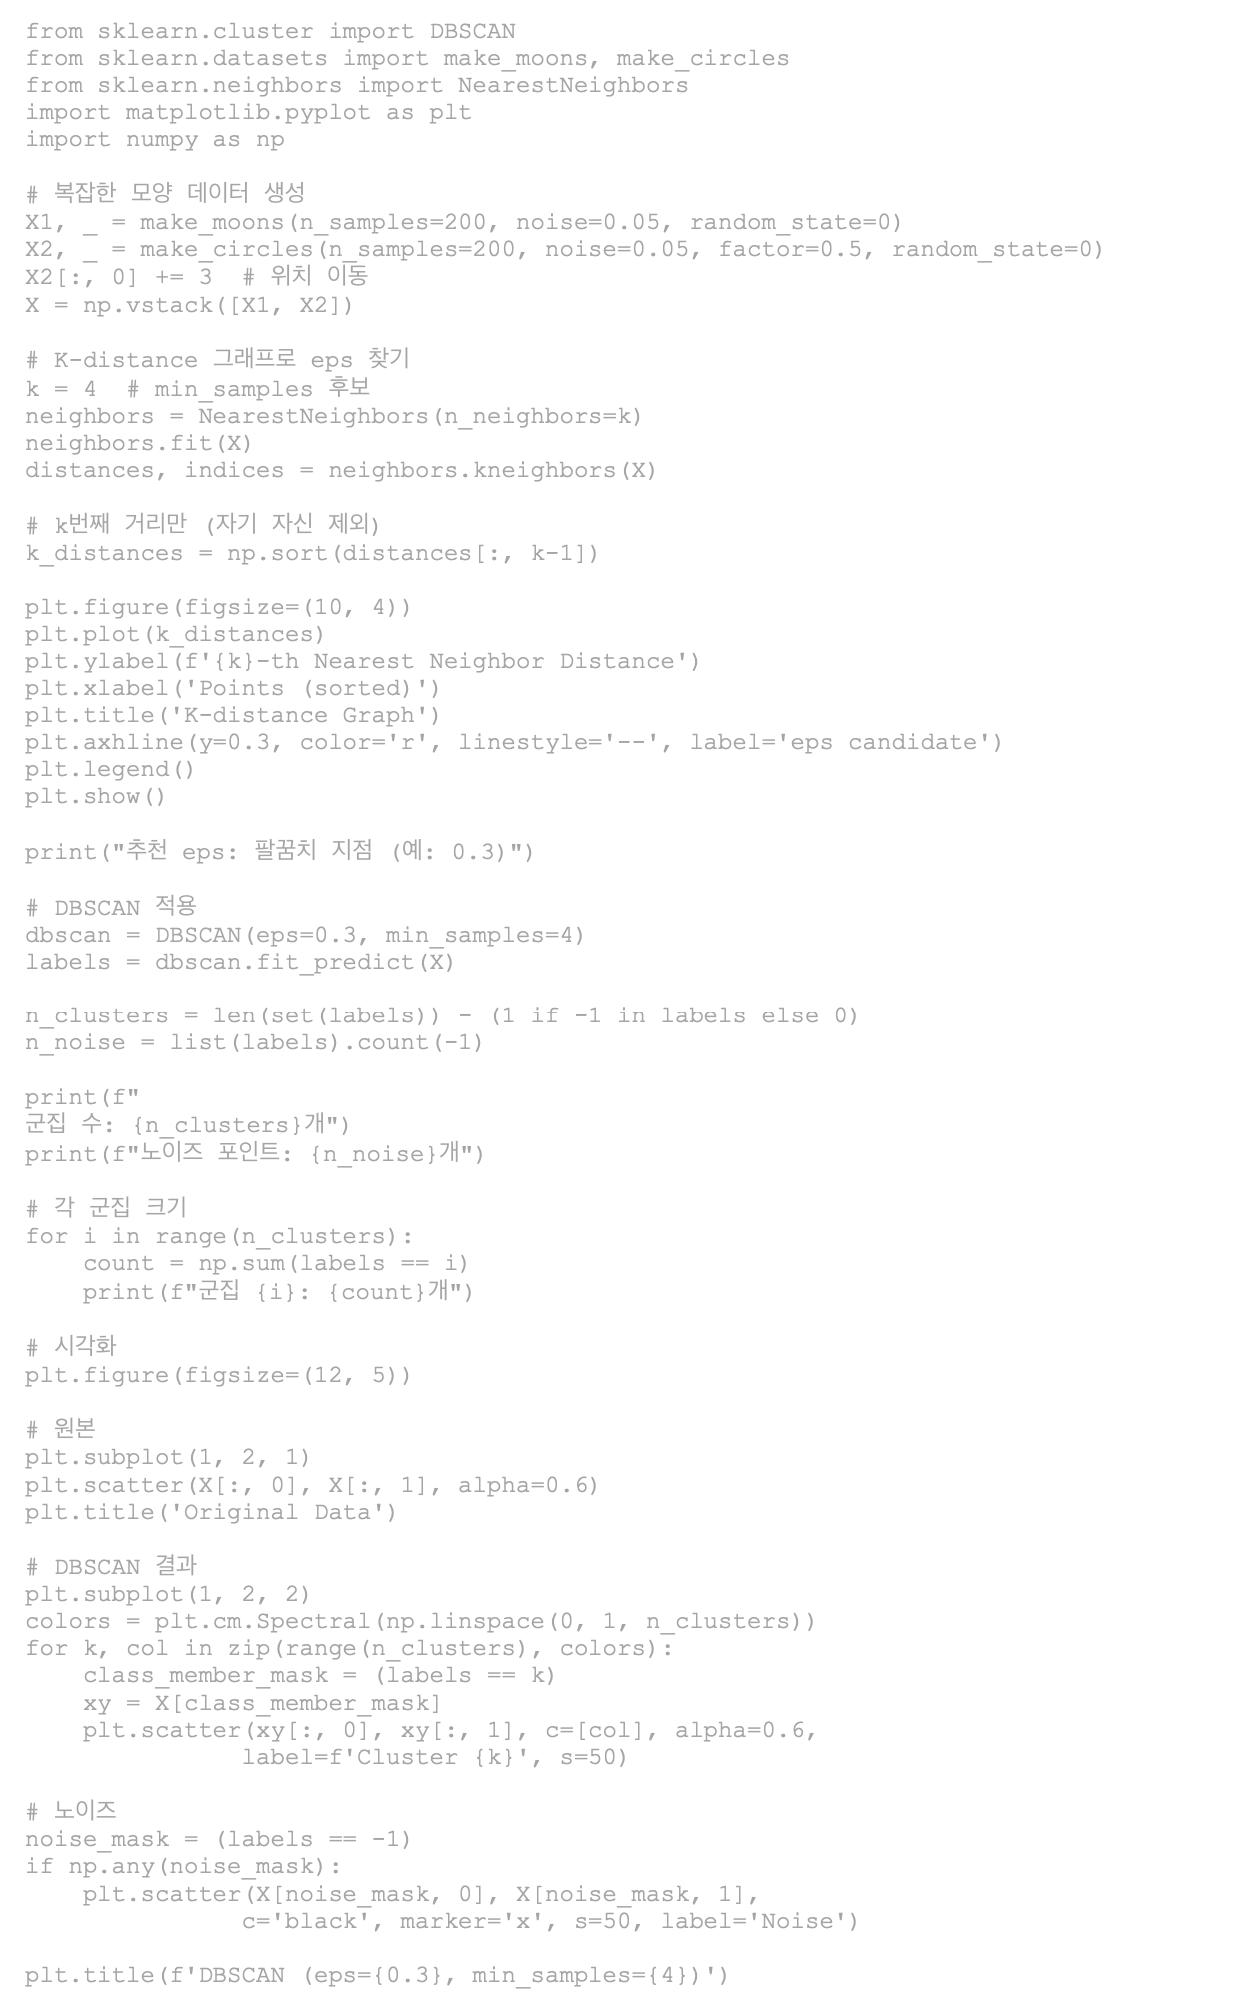
이 코드를 실행하면
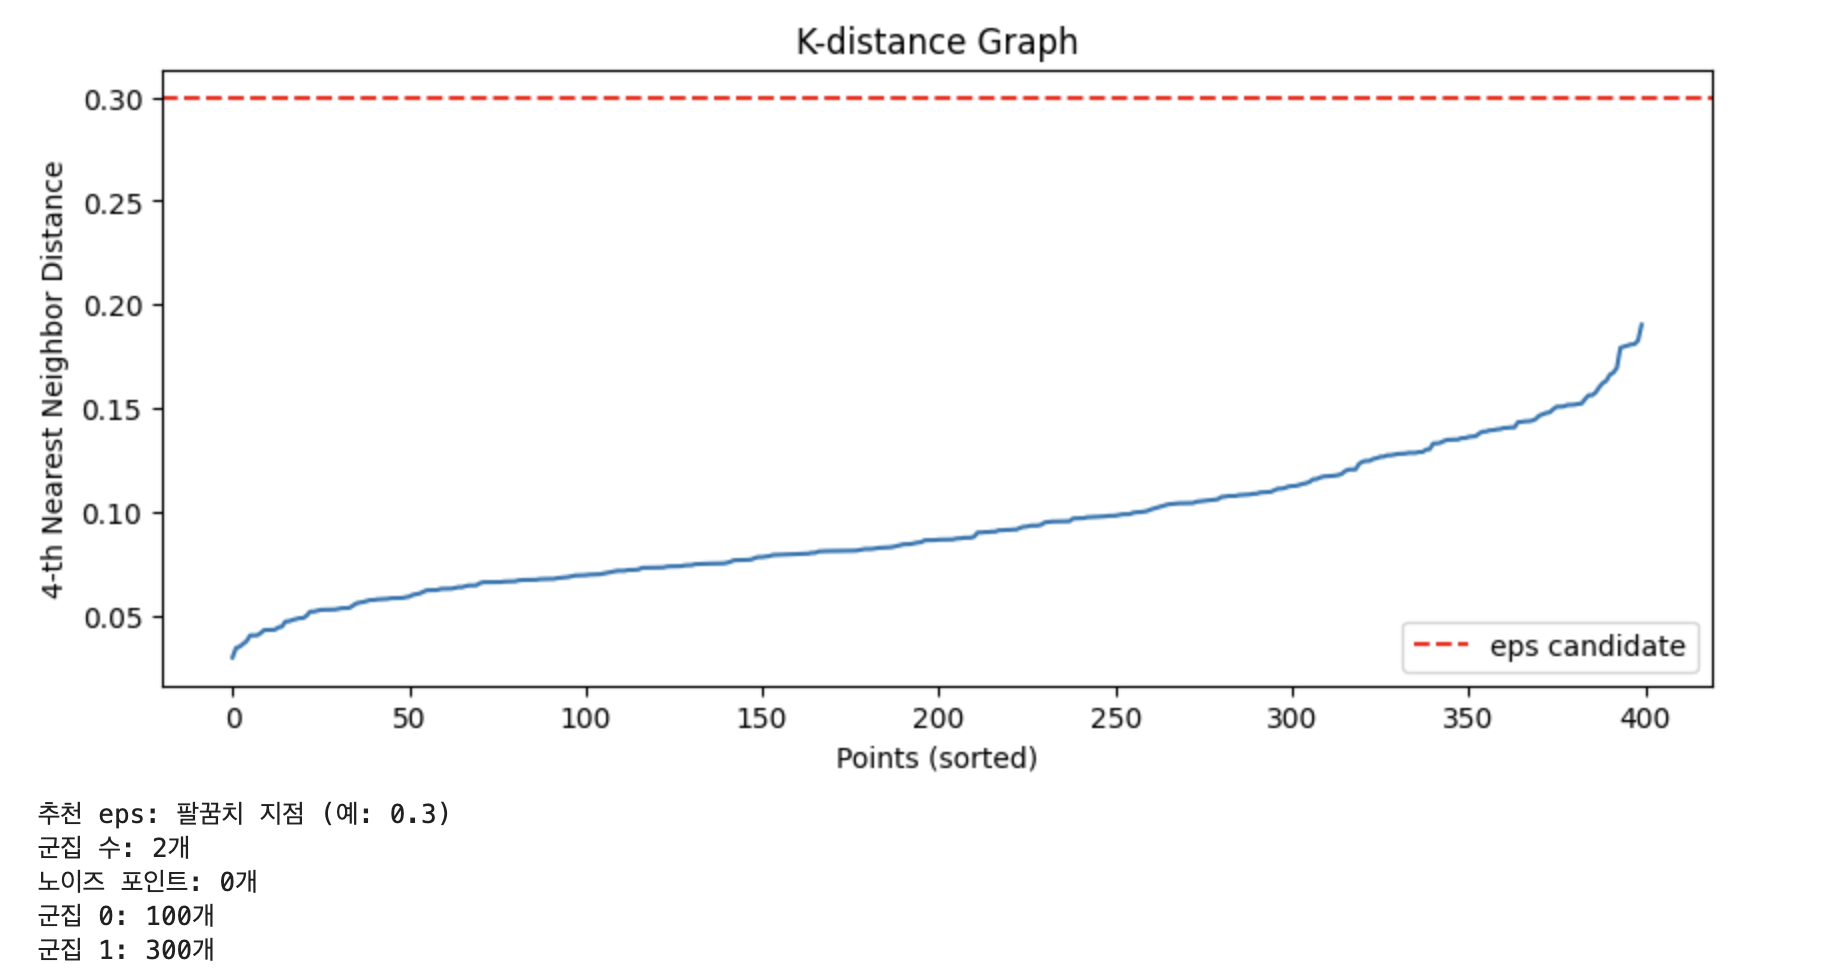
그래프가 완만하게 증가하다가 '팔꿈치(Elbow)'처럼 급격히 꺾여 올라가는 지점이 나타납니다.
이 결과 "팔꿈치" 지점이 eps 값의 좋은 후보가 되며, 코드에서는 이 지점을 0.3으로 판단하고 빨간색 점선으로 표시해줍니다.
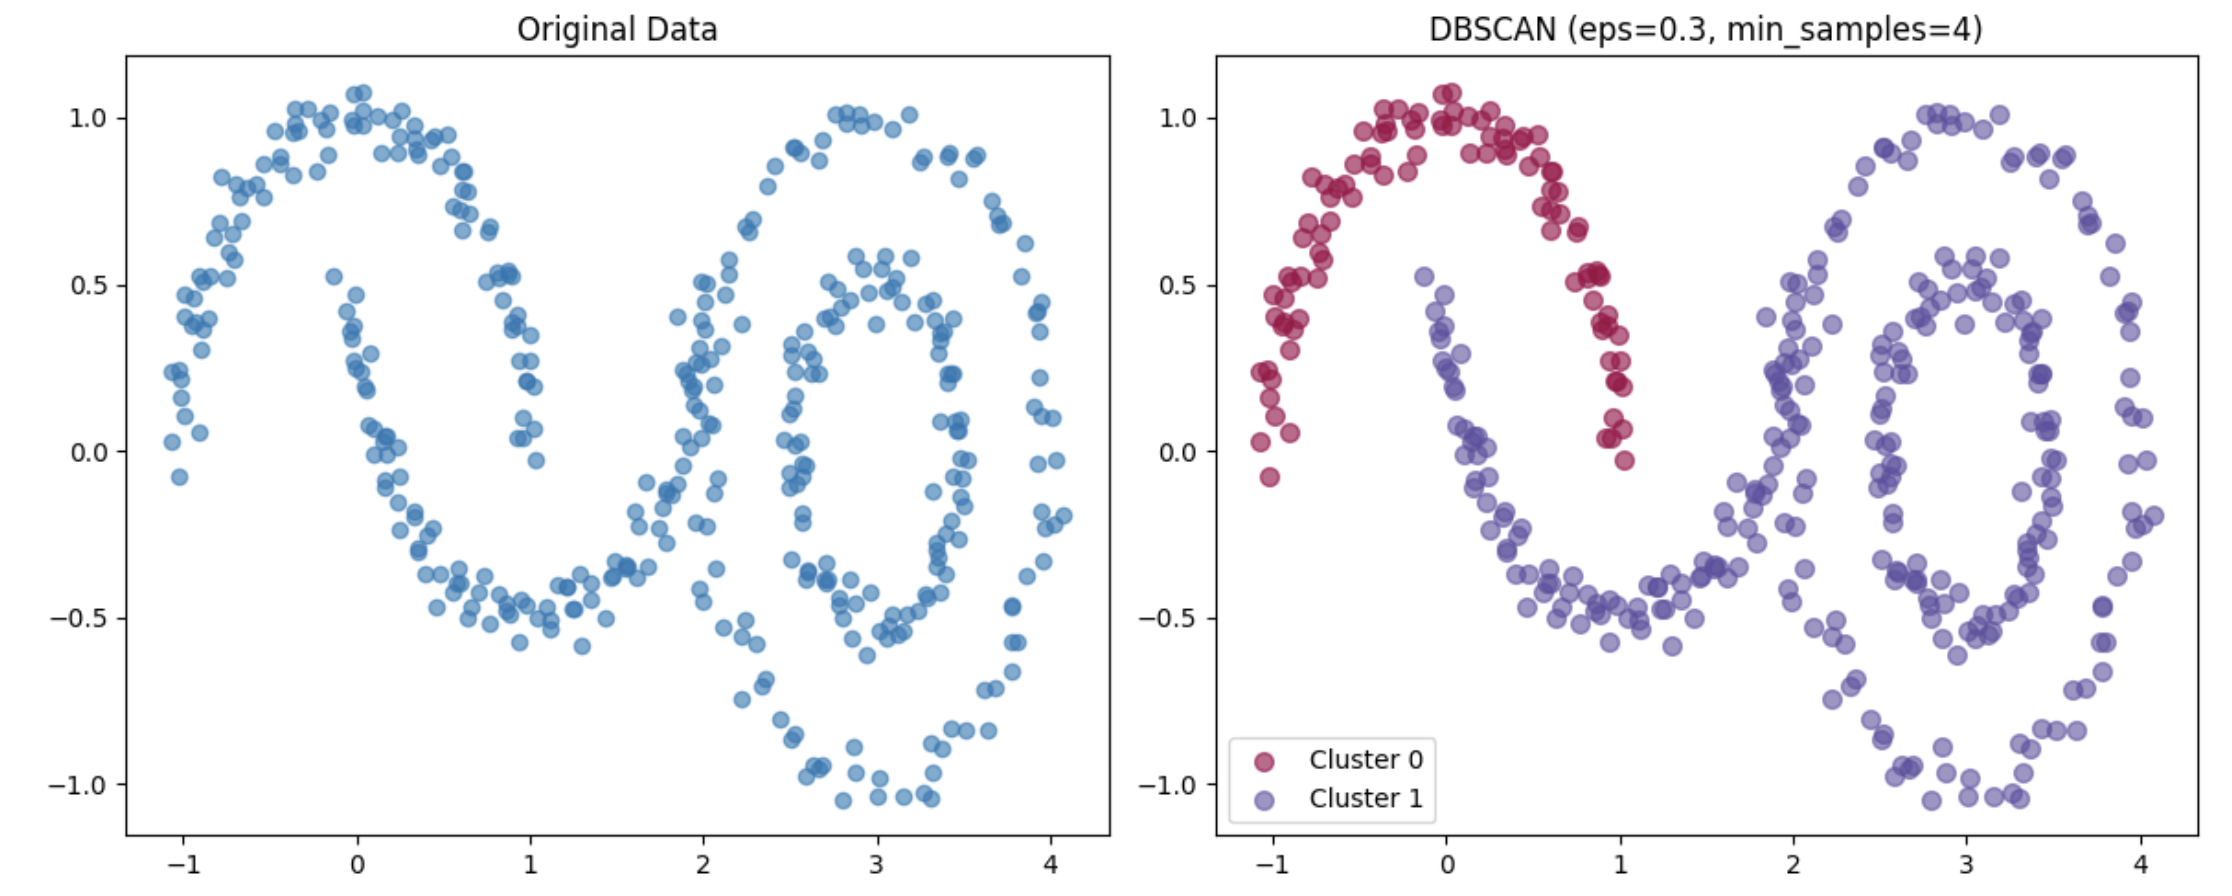
왼쪽(Original Data)은 make_moons로 생성된 초승달 2개와 make_circles로 생성된 동심원 2개가 합쳐진 총 400개의 데이터 포인트가 단일 색상으로 그려집니다.
오른쪽(DBSCAN)은 알고리즘이 데이터의 밀도를 기반으로 두 개의 뚜렷한 그룹(붉은색과 보라색)을 정확하게 찾아냈습니다.
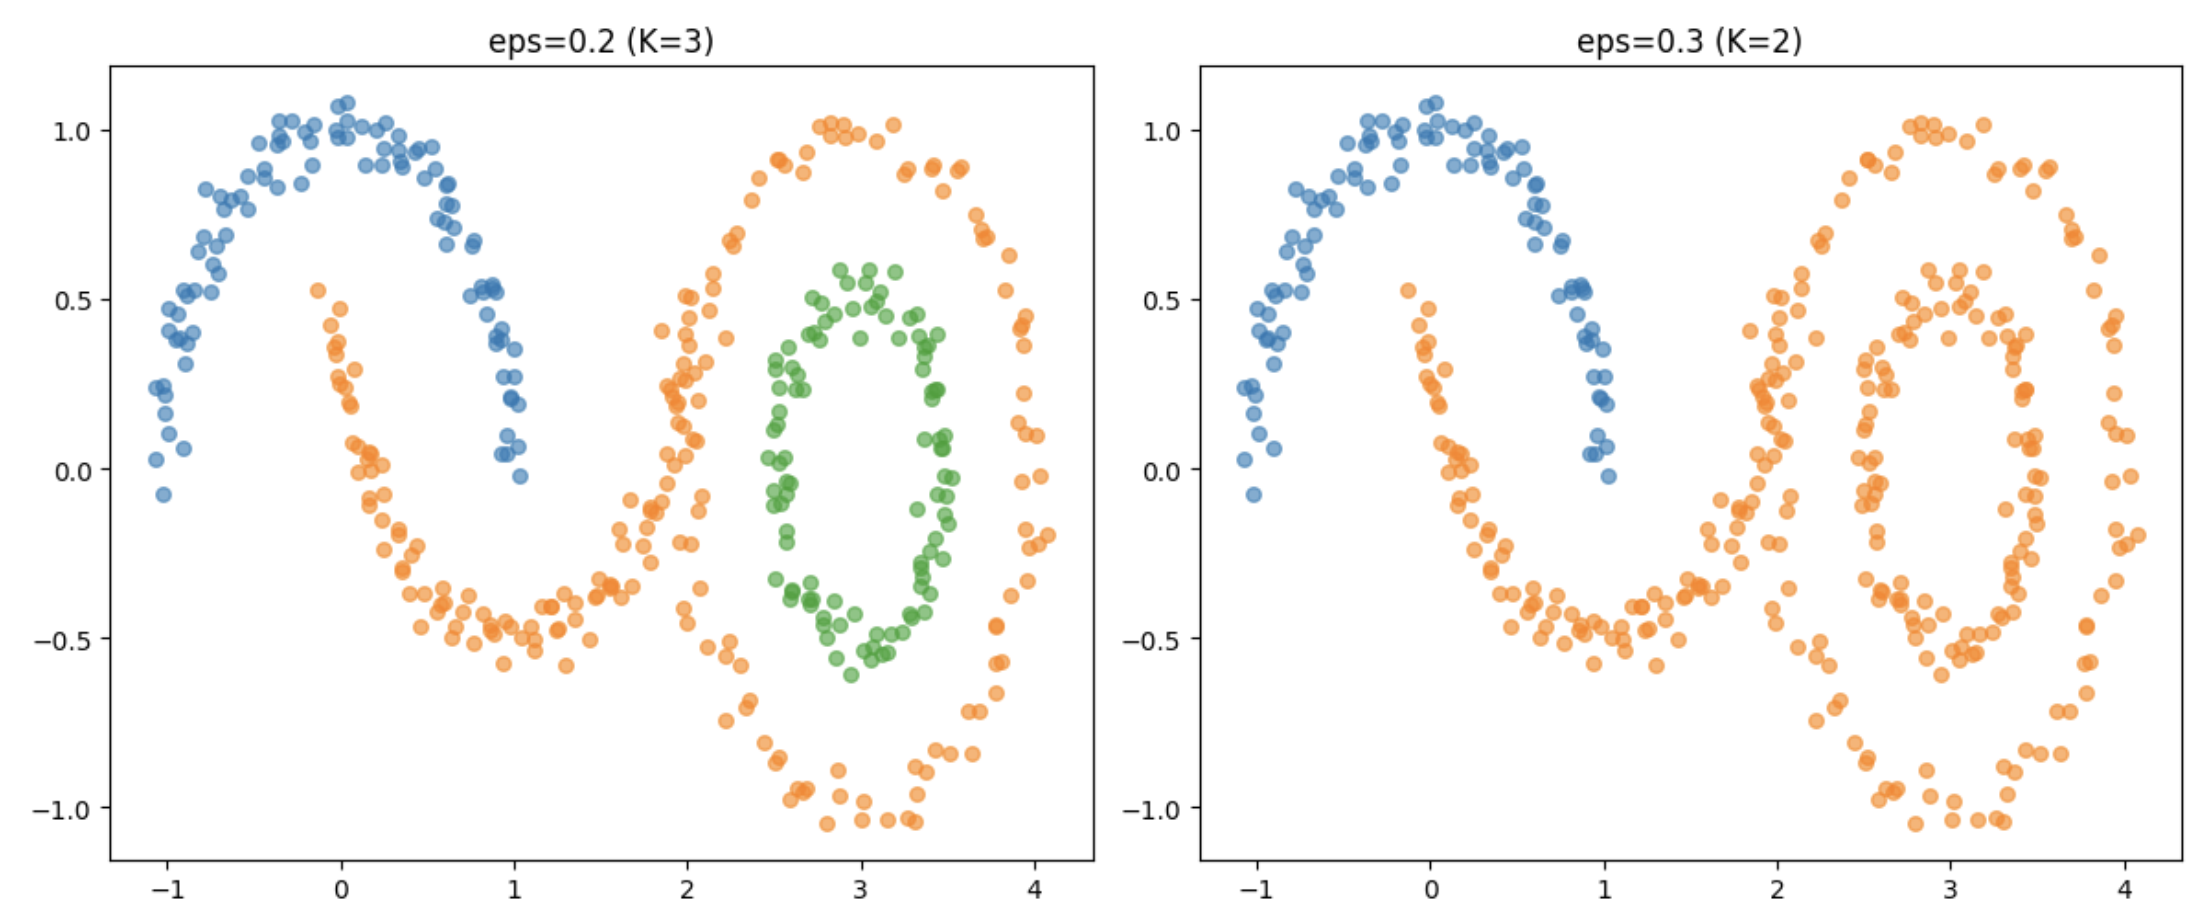
eps = 0.2는 eps 값이 매우 작습니다. 즉, "이웃"으로 인정되는 반경이 매우 좁아
대부분의 점이 '핵심점(Core point)'이 되지 못하고 군집으로 연결되지 못했을 것입니다.
시각적 특징: 플롯의 대부분이 검은색 'x' (노이즈)로 채워져 있고, 아주 빽빽하게 뭉친 영역만 작은 군집(낮은 K값)으로 겨우 식별되었을 수 있습니다.
eps = 0.3는 eps 값이 0.2보다 커지면서, 더 많은 점이 이웃으로 연결되기 시작이 되고, 이는 의미 있는 형태의 군집(K값이 증가)이 나타나기 시작하였고, 데이터의 밀도에 따라 적절한 군집이 생겼다는걸 의미합니다.
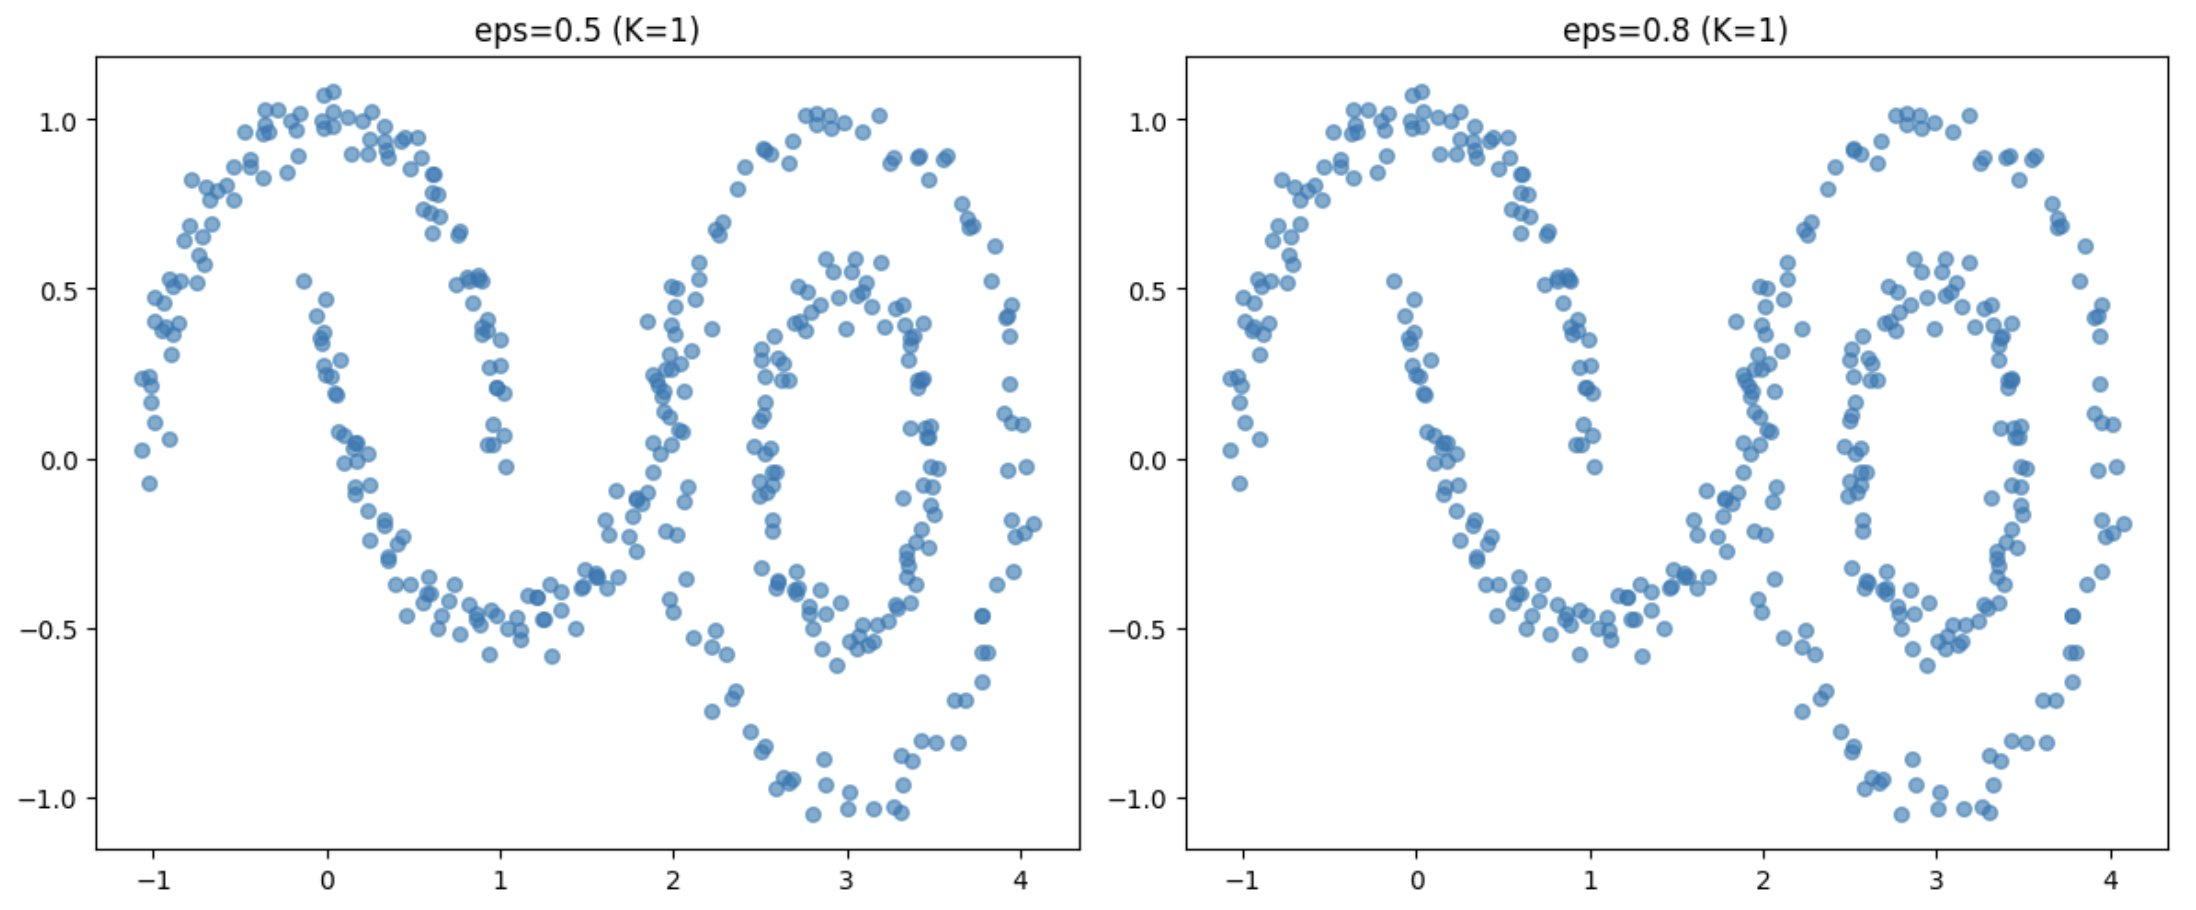
eps = 0.5은 eps 값이 더 커져, 꽤 넓은 반경을 이웃을 지정하지만,
eps=0.3에서 분리되어 있던 군집들이 이 eps 값에서는 서로 연결되어 더 큰 군집으로 합쳐졌을 수 있습니다. (K값은 0.3보다 오히려 감소할 수 있음)
eps = 0.8은 eps 값이 매우 커서 웬만한 점들은 모두 이웃으로 연결됩니다.
거의 모든 데이터 포인트가 하나의 거대한 군집(K=1)**으로 합쳐져서 색이 하나로 칠해지게 되었습니다.
결론 및 요약
- eps가 너무 작으면 (0.2) 대부분의 데이터를 노이즈로 판단합니다.
- eps가 너무 크면 (0.8) 모든 데이터를 하나의 군집으로 판단합니다.
- 따라서 eps = 0.3 일때, min_samples=4로 설정했을 때 군집화가 잘 되어있고 최적의 선택을 하였다라고 생각합니다.
저의 머신러닝 심화 2일차는 이렇게 정리가 끝이 났습니다..
심화 내용이다 보니 정리하는데 시간이 좀 걸리네요
글만 몇 시간째 보고 있으니 눈이 침침합니다...
그런 의미로 최근에 본 (남의 집) 고양이와 요즘에도 평화로운 우리 수업 사진을 끝으로 마무으리!!
바깥에서 생활하는 고얭이였는데 소품샵 사장님이 밥을 챙겨주시다보니 소품샵 안으로 살림 차리셨다고 합니댸용 아마 대문이 없어서 들락날락 거리기 쉬워서 뜨듯한 실내로 궁딩이 붙인게 아닐까..라는 사장님의 말씀
캐시템인 우주선.. 나랑 같이 수업듣는 동료분이 쉬는 시간에 조교님 근처에서 우주선 가지고 놀다가
조교님도 같이 삼총사 우주선이 되었다능🛸
위에 닭 키우신 분은 곧 잡아먹으신다고 합니다(?)