세 줄 요약
- 1분 Rollup이 원본(ClickHouse)과 어긋난 원인은 하나가 아니었다. 윈도우 경계, 워터마크, 재전송, 지연 도착이 동시에 숫자를 흔들었다.
- "MV로 바꾸면 되지 않을까?"는 더 나빴다. MV는 뷰가 아니라 INSERT 트리거라서 과거·삭제·중복 제거를 보지 못한다.
- 해결의 핵심은 더하지 말고, 다시 세는 것이다. 그리고 "돌고 있는가"가 아니라 "맞는가"를 감시하는 대사 지표가 필요하다.
0. 실험 환경
OWLBY(EDR 플랫폼)의 Dashboard Rollup 경로만 떼어 내 장애를 재현했다. 스키마는 운영 마이그레이션과 같은 컬럼·엔진·정렬 키를 쓴다.
| 구분 | 내용 |
|---|---|
| 원본 | ClickHouse 24.8 · edr_events · ReplacingMergeTree(updated_at) · PARTITION BY toDate(occurred_at) |
| Rollup | PostgreSQL 16 · dashboard_event_rollups · PK (bucket_start_at, endpoint_id, event_type) |
| 트래픽 | endpoint 3대 × 5분 · Event 1,425건 (가상 시계로 돌려 매번 같은 결과) |
| 비교 전략 | naive_window · naive_watermark(>, >=) · mv(raw, sum) · mv_state · fixed |
| 재현 코드 | team-C labs/incident-lab (python -m lab scenario s1, s1 --matrix, s1-mv) |
목데이터에는 장애 요인을 일부러 섞었다. 경계 Event는 항상 넣고, 나머지는 --inject로 하나씩 켜고 끈다.
| 요인 | 만드는 상황 | 실제로 생기는 이유 |
|---|---|---|
| 경계 Event | HH:MM:59.999 · 00.000 · 00.001에 20건씩 | 집계 윈도우 경계 |
resend | 같은 event_id를 새 ingested_at으로 재적재 (5%) | Kafka at-least-once 재전달 |
slow | ingested_at은 먼저 찍혔는데 Worker tick 이후에 커밋 | Storage Worker 여러 대, 느린 insert |
same_ms | 워터마크와 같은 ms로 찍힌 다른 배치가 tick 이후에 커밋 | 배치 단위 타임스탬프 |
late | occurred_at은 과거 분, ingested_at은 3분 뒤 (45건) | 오프라인 Agent 버퍼 flush |
skew | ingested_at이 10분 전으로 찍힌 배치 (30건) | 시계가 틀어진 호스트 |
1. 대시보드 숫자가 원본과 다르다
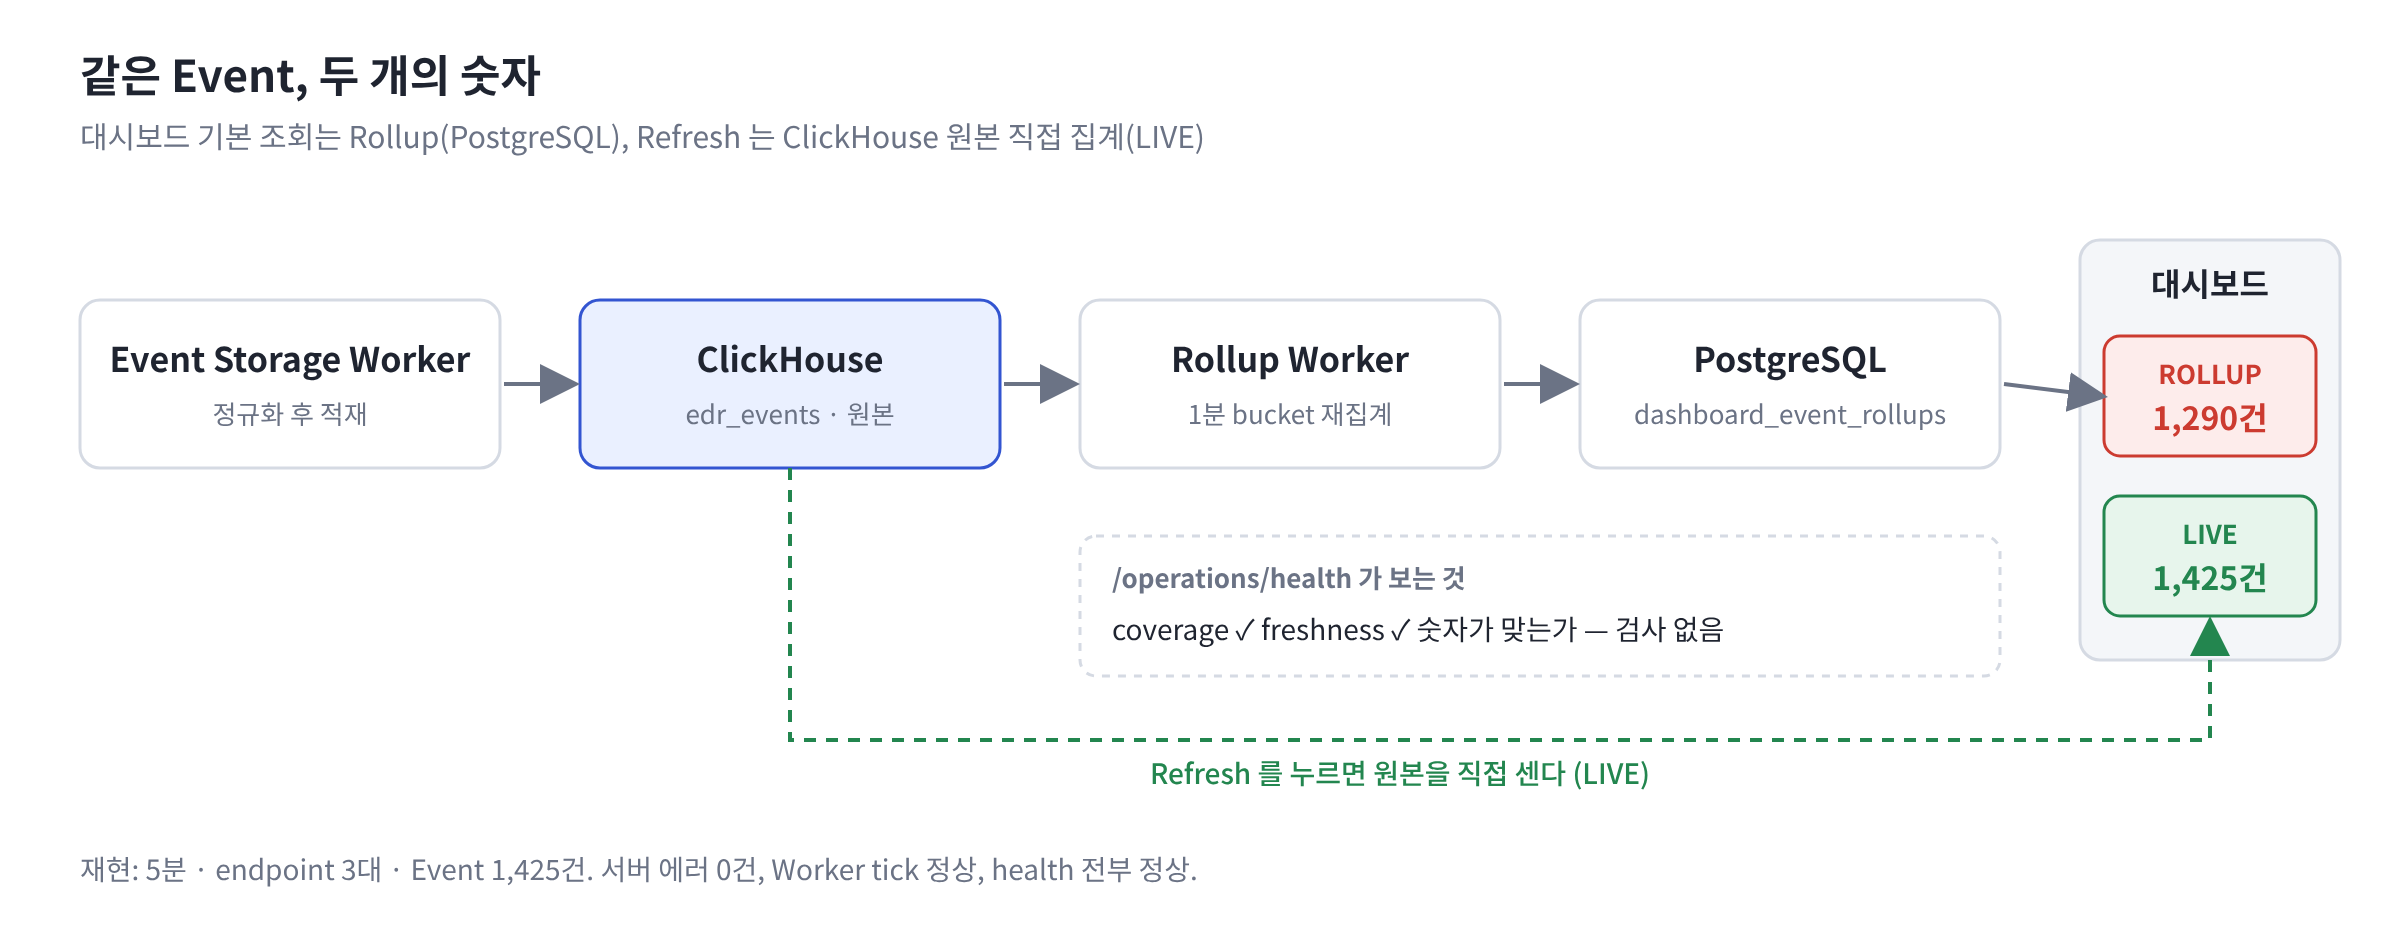
OWLBY 대시보드는 기본으로 PostgreSQL의 1분 Rollup을 읽는다. 사용자가 Refresh를 누를 때만 ClickHouse 원본을 직접 센다(LIVE).
5분 동안 Event 1,425건을 흘리고 Refresh를 눌렀다. 숫자가 바뀌었다.
| 조회 | Event 수 |
|---|---|
| ROLLUP (기본) | 1,290 |
| LIVE (Refresh) | 1,425 |
어떤 분은 부풀어 있고, 어떤 분은 100건 넘게 비어 있었다. 그런데 ClickHouse·PostgreSQL 에러는 0건이었다. Worker도 정상적으로 tick을 돌고 있었다.
2. 아무 지표도 울리지 않았다
이 사건은 지표로 잡히지 않았다. 잡힐 수가 없었다.
/operations/health 검사 | 무엇을 보나 | 이번 사건에서 |
|---|---|---|
| coverage | 최근 24시간의 모든 분이 재집계됐는가 | ✅ 통과 — 모든 분을 제때 돌았다 |
| freshness | 원본 최신 ingested_at과 Rollup 차이가 300초 이내인가 | ✅ 통과 — 최신 시각도 따라잡았다 |
| 정합성 | Rollup 숫자가 원본과 같은가 | — 검사 자체가 없었다 |
두 검사 모두 "집계가 돌았는가" 에 답한다. "집계가 맞는가" 에는 답하지 않는다.
⚠️ 최초 탐지는 사람이 Refresh를 누른 순간이었다. 사람이 먼저 발견했다는 것 자체가 탐지 실패다.
3. 무엇이 숫자를 틀리게 했나
3-1. 용의자 목록
지표가 범인을 가리켜 주지 않으니, 의심 가는 것을 다 꺼내 놓고 장애 요인을 하나씩만 켜서 지웠다.
| # | 용의자 | 확인 방법 | 판정 |
|---|---|---|---|
| 1 | ClickHouse·PostgreSQL 서버 이상 | 서버 상태, Worker 로그 | ❌ 무죄 — 에러 0건 |
| 2 | Storage Worker 적재 실패 | SELECT uniqExact(event_id) FROM edr_events FINAL | ❌ 무죄 — 원본은 정답 1,425건 |
| 3 | Rollup 윈도우 경계 | 경계 Event만 넣고 재현 | ✅ 유죄 — 분마다 정확히 +60 |
| 4 | ingested_at 워터마크 | 늦은 커밋만 켜고 재현 | ✅ 유죄 — −408 |
| 5 | 재전송 중복 | 재전송만 켜고 재현 | ✅ 유죄 — count()가 재전송분까지 센다 |
| 6 | 지연 도착 | 지연 도착만 켜고 재현 | ✅ 유죄 — −45 |
범인이 넷이었다. 하나를 찾고 멈췄다면 나머지 셋을 놓쳤을 것이다.
3-2. 추측 전에 대사(對査)부터
원본을 직접 센 값과 Rollup을 분 단위로 나란히 놓는다.
| 분 (UTC) | 원본 | Rollup | 차이 | diff_pct |
|---|---|---|---|---|
| 00:20 | 315 | 211 | −104 | −33.0% |
| 00:21 | 300 | 270 | −30 | −10.0% |
| 00:22 | 270 | 272 | +2 | +0.7% |
| 00:23 | 270 | 279 | +9 | +3.3% |
| 00:24 | 270 | 258 | −12 | −4.4% |
00:22의 +2는 거의 맞아 보인다. 하지만 (분, endpoint, event_type) 키로 쪼개 보면 불일치 키가 67개였다. +2는 맞은 게 아니라 중복과 누락이 상쇄된 값이다.
💡 총합이나 분 단위 합으로는 판정할 수 없다. 대사는 키 단위로 해야 한다.
3-3. 원인 ① — 분 경계마다 정확히 +60
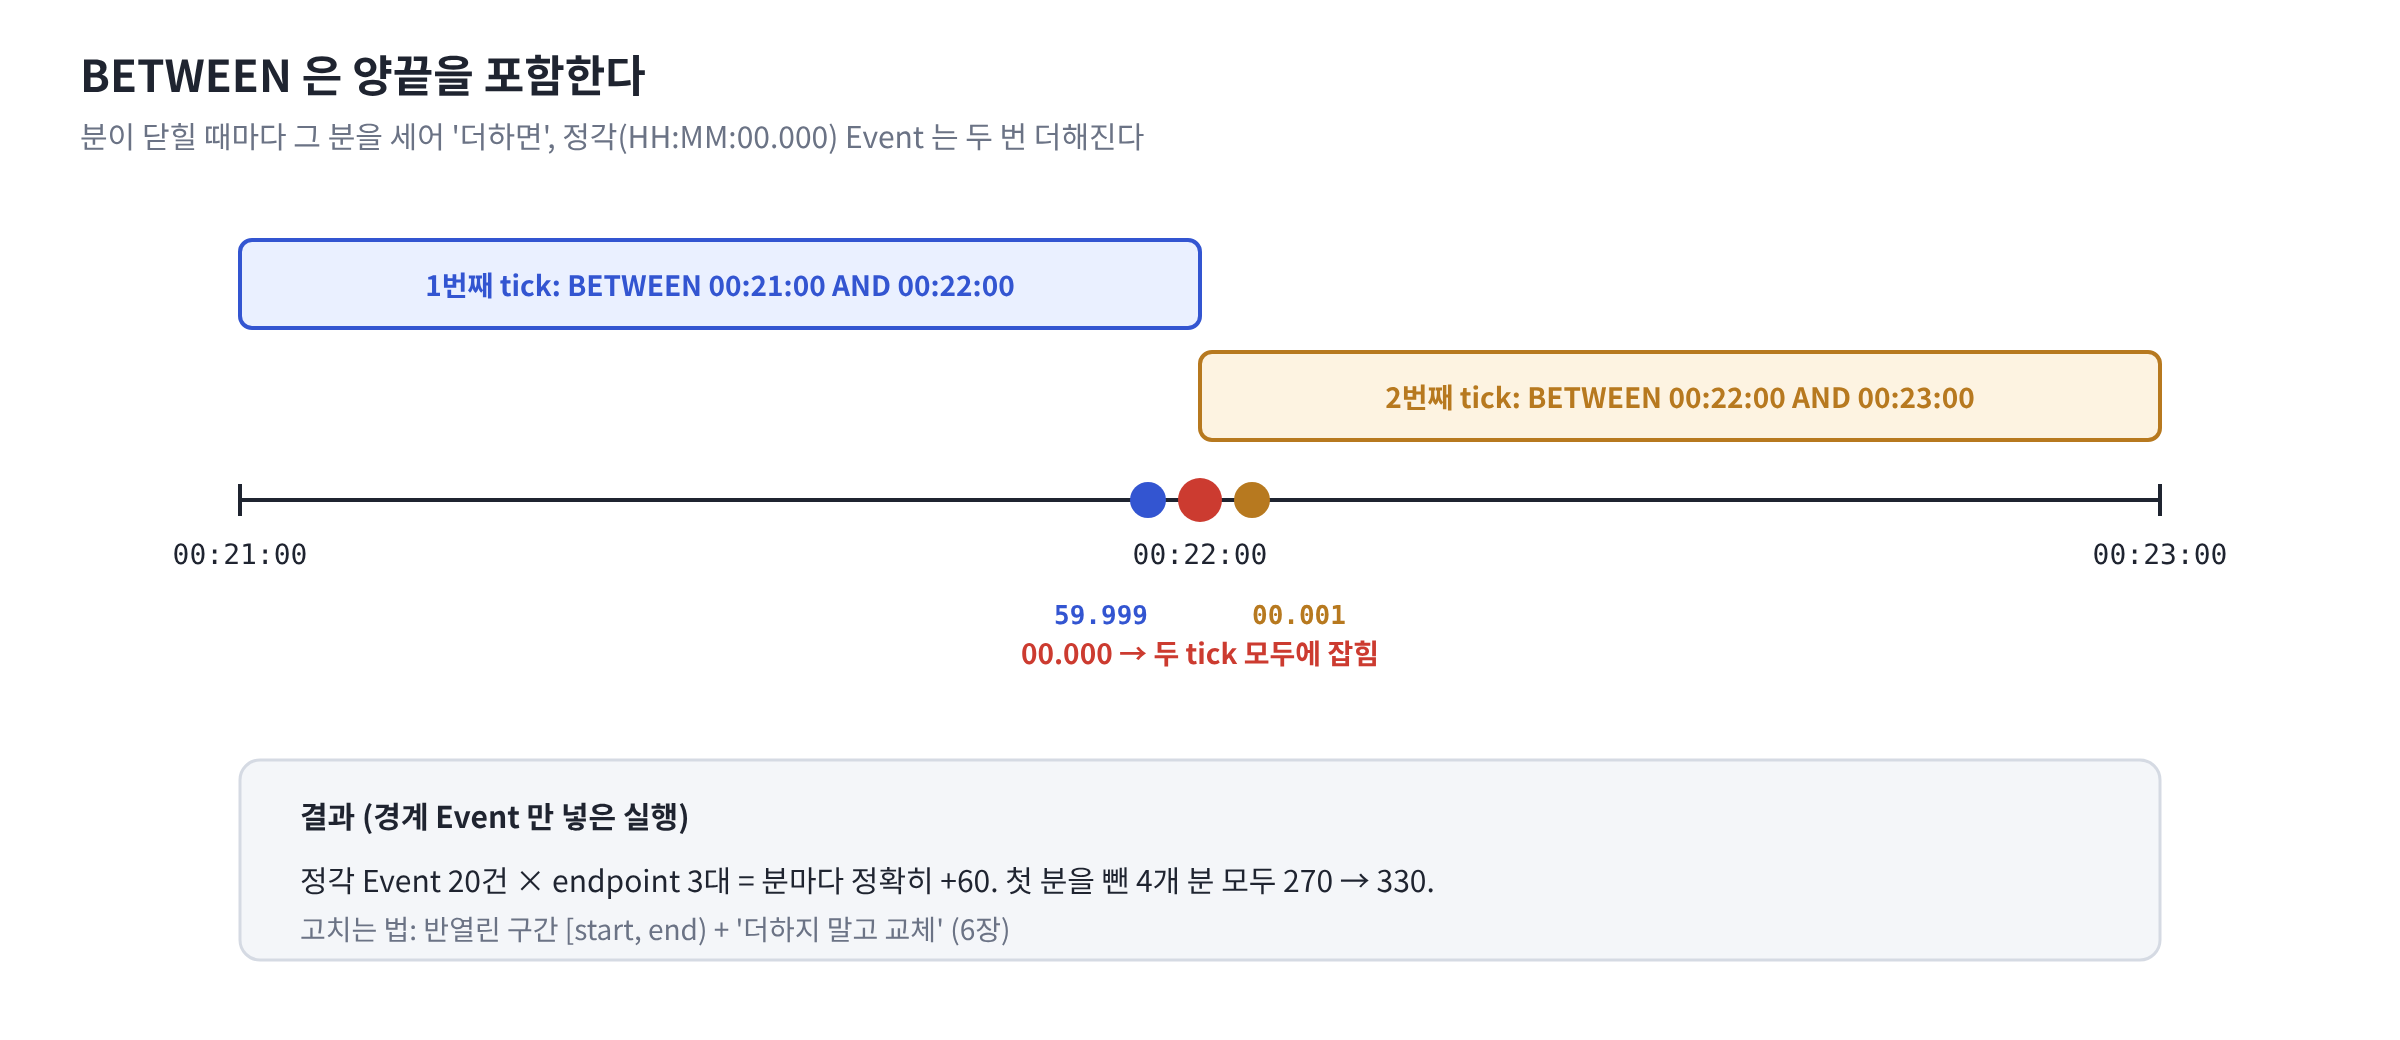
-- 분이 닫히면 그 분을 세어 PostgreSQL에 '더한다'
WHERE occurred_at BETWEEN '00:21:00.000' AND '00:22:00.000'   -- 양끝 포함
-- 다음 tick
WHERE occurred_at BETWEEN '00:22:00.000' AND '00:23:00.000' -- 00:22:00.000을 또 셈BETWEEN은 양끝을 포함한다. 정각 Event는 앞뒤 두 윈도우에 모두 잡혀 같은 bucket에 두 번 더해진다.- 윈도우를 닫은 뒤 도착한 Event는 다시 볼 기회가 없다. 지연 도착 45건과 늦은 커밋 97건이 그렇게 빠졌다.
3-4. 원인 ② — 늦게 커밋된 배치가 사라진다
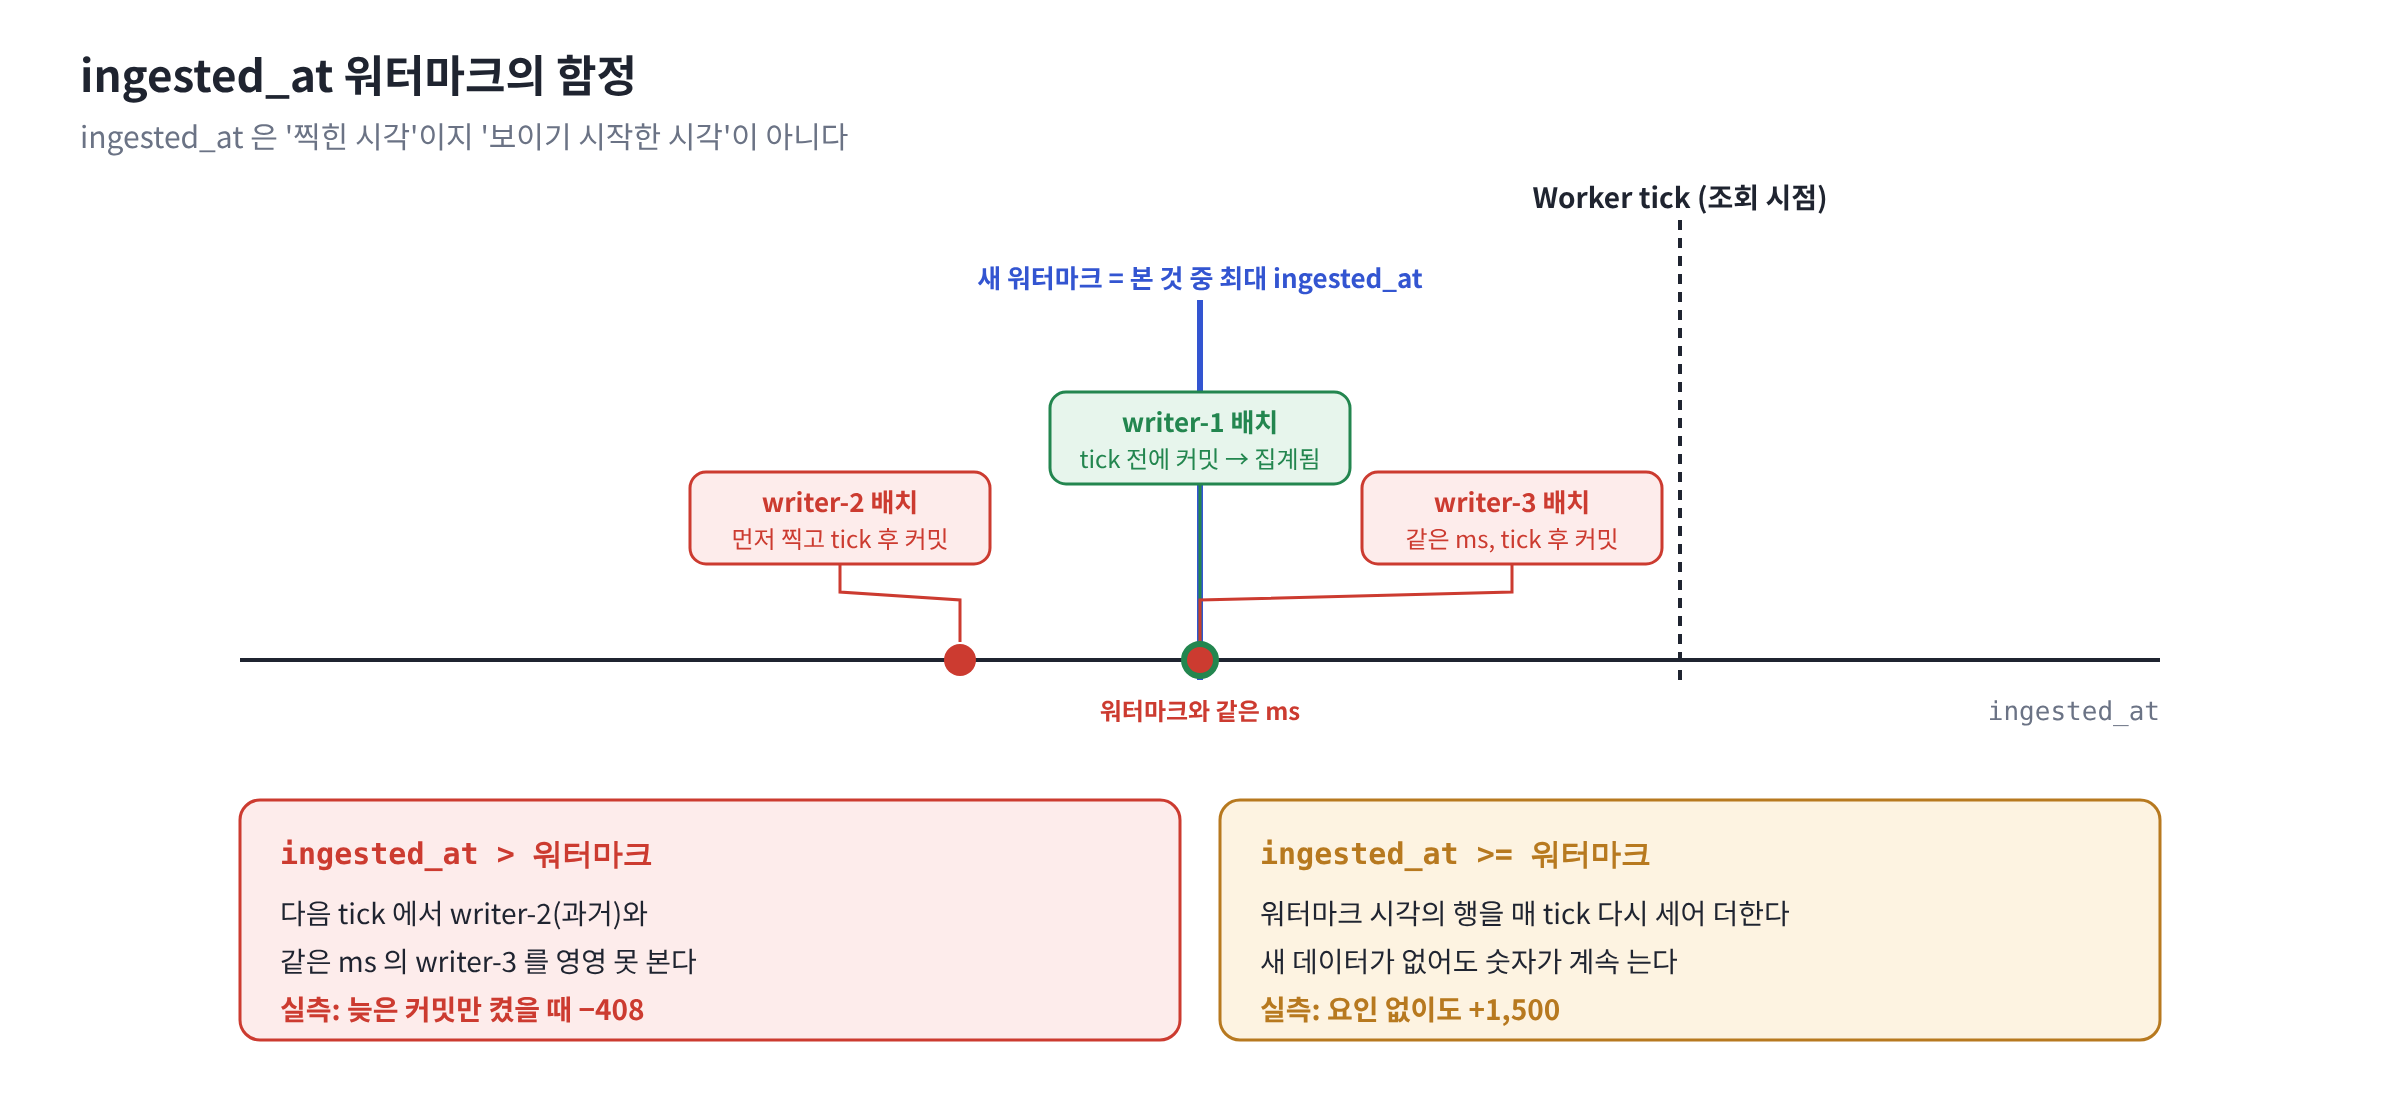
occurred_at 윈도우 대신 ingested_at 워터마크로 바꾸면 지연 도착은 잡힌다. 대신 비교 연산자에서 새 함정이 생긴다.
| 비교 | 깨지는 지점 | 실측 (그 요인만 켰을 때) |
|---|---|---|
ingested_at > 워터마크 | 먼저 찍혔거나 같은 ms로 찍힌 배치가 나중에 커밋되면 영원히 누락 | 늦은 커밋 −408, 같은 ms −408, 시계 오차 −30 |
ingested_at >= 워터마크 | 워터마크 시각의 행을 매 tick 다시 세어 더한다 | 요인 없이도 +1,500 |
💡
>든>=든, "마지막으로 본 시각 이후만 가져와 더한다"는 구조에서는 누락과 중복 중 하나를 피할 수 없다. 문제는 연산자가 아니라 더한다는 것 자체다.
4. "Worker 대신 MV로 바꾸면?" — 세 가지 오해
여기서 떠오르는 대안이 ClickHouse Materialized View다. "집계는 ClickHouse가 알아서 하고, Worker는 결과만 옮기면 된다."
count()를 SummingMergeTree에 쌓는 MV를 붙여 같은 트래픽을 다시 흘렸다. 결과는 −273에서 −644로 더 나빴다.
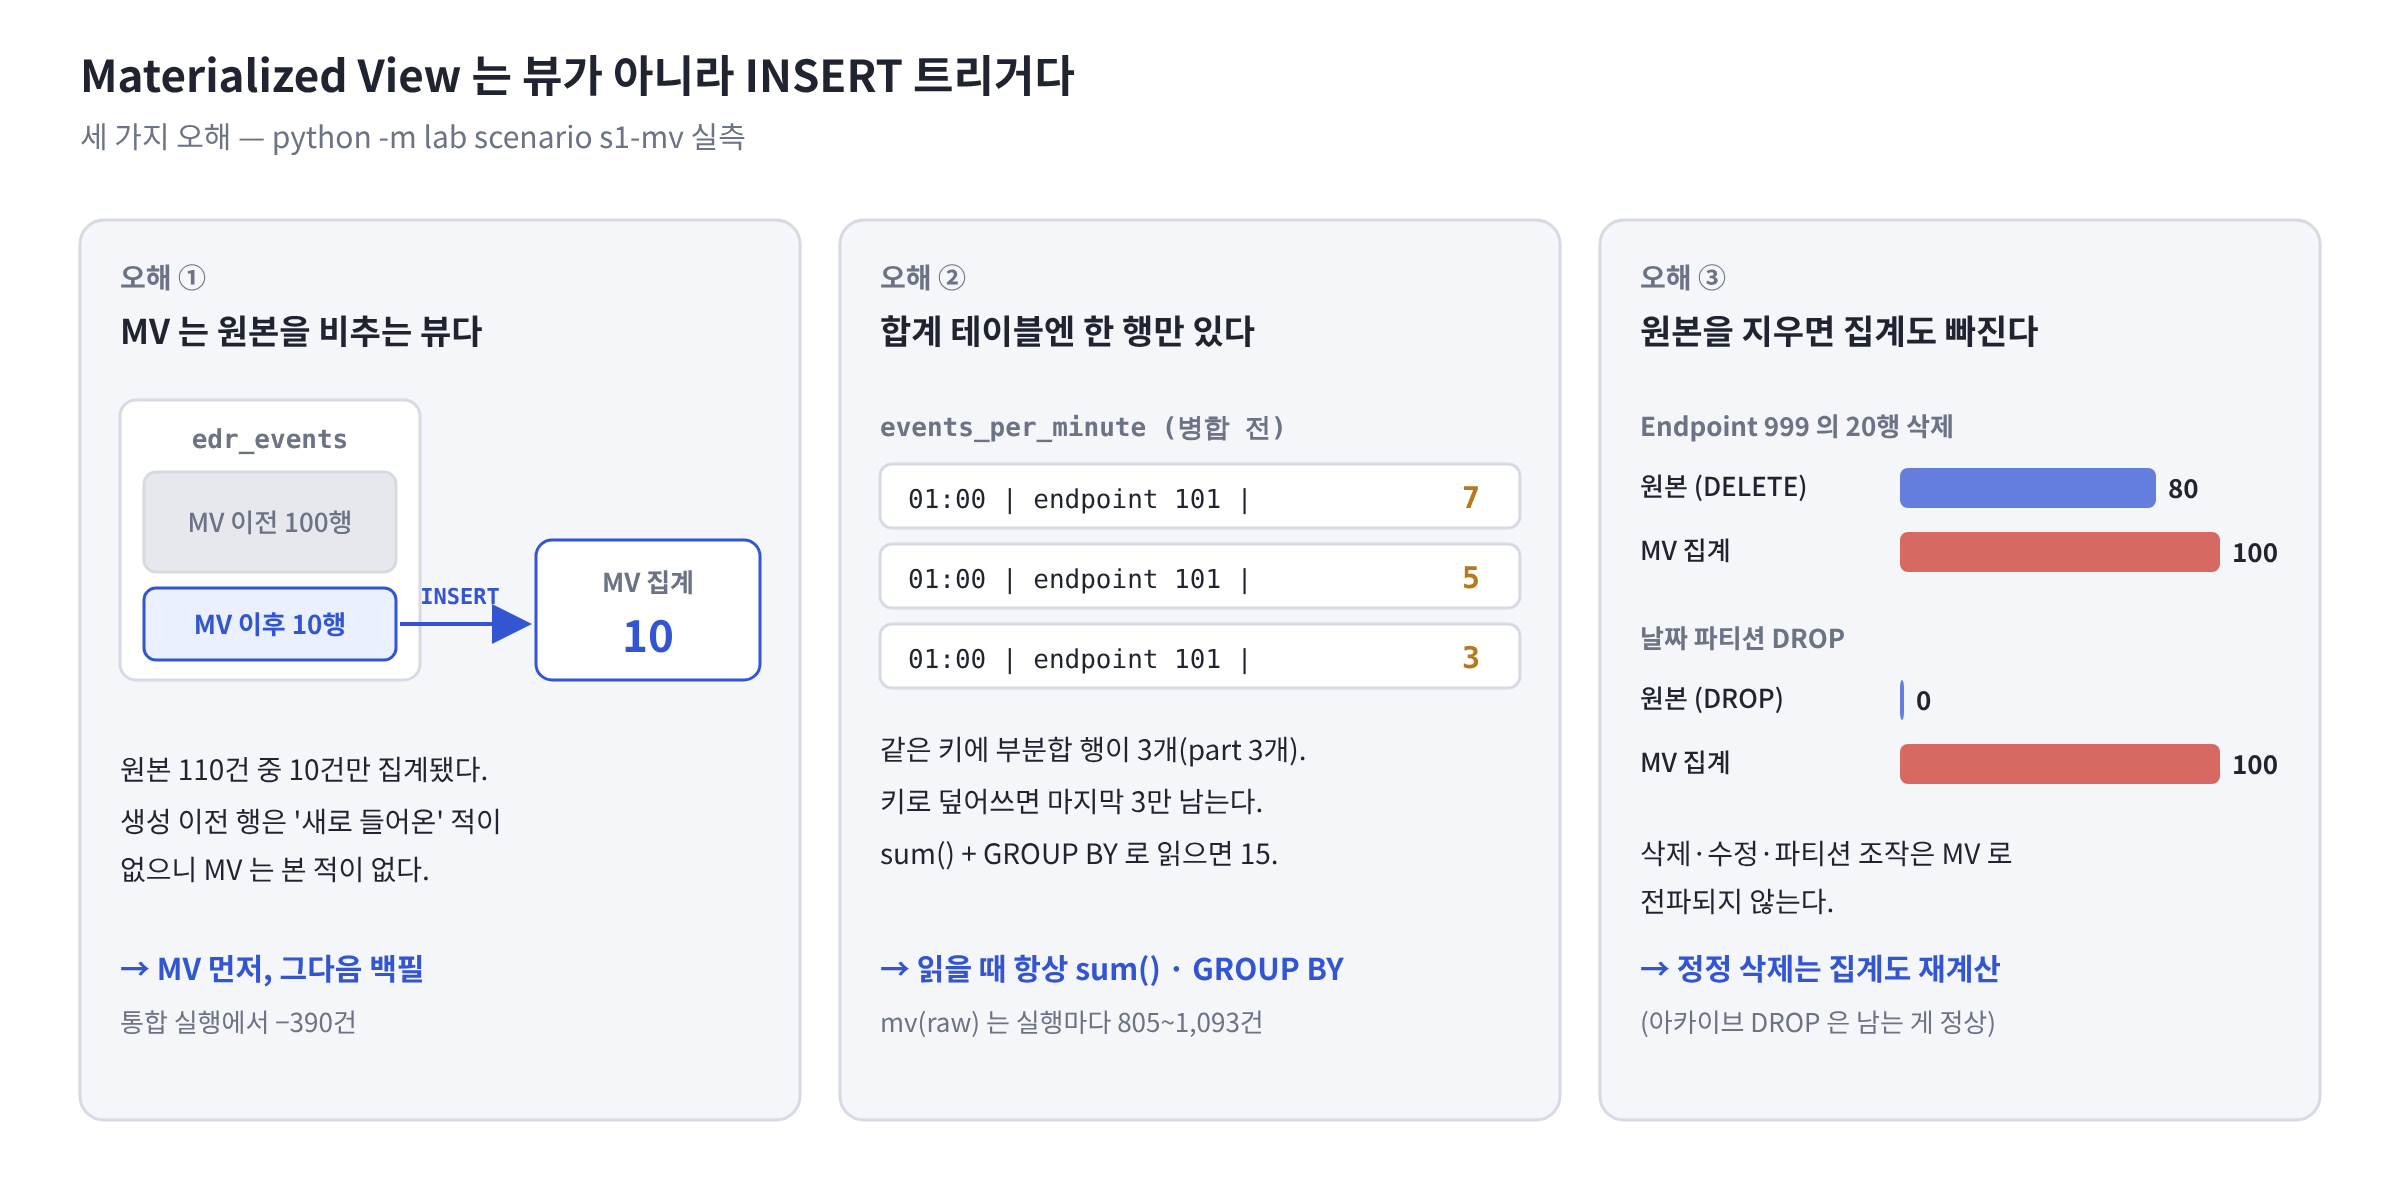
| 오해 | 실제 | 실측 | 처방 |
|---|---|---|---|
| ① MV는 원본 테이블을 집계한 뷰다 | INSERT 블록에만 반응하는 트리거. 생성 이전 데이터는 모른다 | 원본 110건 중 MV에는 10건 | MV를 먼저 만들고 과거는 백필 |
| ② SummingMergeTree에는 합쳐진 한 행이 있다 | 백그라운드 머지 전까지 부분합 행이 여러 개다 | 같은 키에 7·5·3 세 행, sum()은 15 | 읽을 때 항상 sum() + GROUP BY |
| ③ 원본을 지우면 집계에서도 빠진다 | DELETE · DROP PARTITION은 MV로 전파되지 않는다 | 원본 80 → 0, 집계는 100 그대로 | 정정 삭제 시 집계도 재계산 |
오해 ① MV는 트리거다
insert> edr_events 100행 — MV 만들기 전
sql> CREATE MATERIALIZED VIEW events_per_minute_mv TO events_per_minute AS
       SELECT toStartOfMinute(occurred_at), endpoint_id, count() ... GROUP BY ...
sql> SELECT sum(event_count) FROM events_per_minute      → 0
insert> edr_events 10행 — MV 만든 뒤
sql> SELECT count() FROM edr_events                     → 110
sql> SELECT sum(event_count) FROM events_per_minute      → 10
생성 이전 데이터는 "새로 들어온" 적이 없으니 MV는 본 적이 없다. 버그가 아니라 정의다. POPULATE는 채우는 동안 들어온 INSERT를 놓칠 수 있어서 운영 중인 테이블에는 답이 아니다.
오해 ② 읽는 방법이 틀렸다
insert> 배치 1 (7행), 배치 2 (5행), 배치 3 (3행) — 같은 1분, 같은 endpoint
sql> SELECT bucket_start_at, endpoint_id, event_count FROM events_per_minute
     2026-10-07 01:00:00 | 101 | 7
     2026-10-07 01:00:00 | 101 | 5
     2026-10-07 01:00:00 | 101 | 3
sql> SELECT sum(event_count) FROM events_per_minute     → 15
이 행들을 키 기준으로 PostgreSQL에 덮어쓰면 마지막 부분합(3)만 남는다. 같은 트래픽인데 실행할 때마다 Rollup이 805건에서 1,093건 사이로 달랐다. 같은 입력에 다른 답이 나오는 것 자체가 단서였다.
오해 ③ 삭제는 전파되지 않는다
insert> Endpoint 101 — 80행, Endpoint 999 — 20행
sql> ALTER TABLE edr_events DELETE WHERE endpoint_id = 999 SETTINGS mutations_sync = 2
sql> SELECT count() FROM edr_events                     → 80
sql> SELECT sum(event_count) FROM events_per_minute      → 100
sql> ALTER TABLE edr_events DROP PARTITION '2026-10-07'
sql> SELECT count() FROM edr_events                     → 0
sql> SELECT sum(event_count) FROM events_per_minute      → 100
💡 OWLBY에서는 양날의 칼이다. Storage Lifecycle Worker는 S3로 아카이브한 날짜 파티션을
DROP PARTITION으로 지운다. 이때 집계가 남는 건 원하는 동작이다. 반대로 잘못 들어온 데이터를 지우는 정정 삭제라면 집계도 따로 재계산해야 한다.
추가로 알아야 할 MV의 성질
| 성질 | 오해하면 나는 사고 | 실측 |
|---|---|---|
| 소스가 ReplacingMergeTree여도 MV는 중복 제거 전 블록을 본다 | 원본은 재전송이 정리되는데 집계에는 그대로 더해진다 | 재전송 10건 → 원본 10, MV 20 (원본 머지 후에도 20) |
| MV가 분 중간에 켜지면 그 분은 반쪽짜리 bucket이 된다 | 백필 범위를 잘못 잡으면 누락 또는 중복 | 정답 60 → 30 / 90 / 60 (아래) |
00:59 50행, 01:00:10 30행 → 01:00:37 MV 생성 → 01:00:40 30행
[A] occurred_at < 01:00:00 백필                    → 01:00 버킷 30  (누락)
[B] occurred_at < 01:01:00 백필                    → 01:00 버킷 90  (중복)
[C] 01:00 버킷 삭제 → occurred_at < 01:01:00 백필   → 01:00 버킷 60  (정답)
경계 버킷 백필은 이 글의 출발점과 같은 문제다. 윈도우 경계를 한 번만 세는 게 어렵다.
5. 원인은 하나가 아니었다
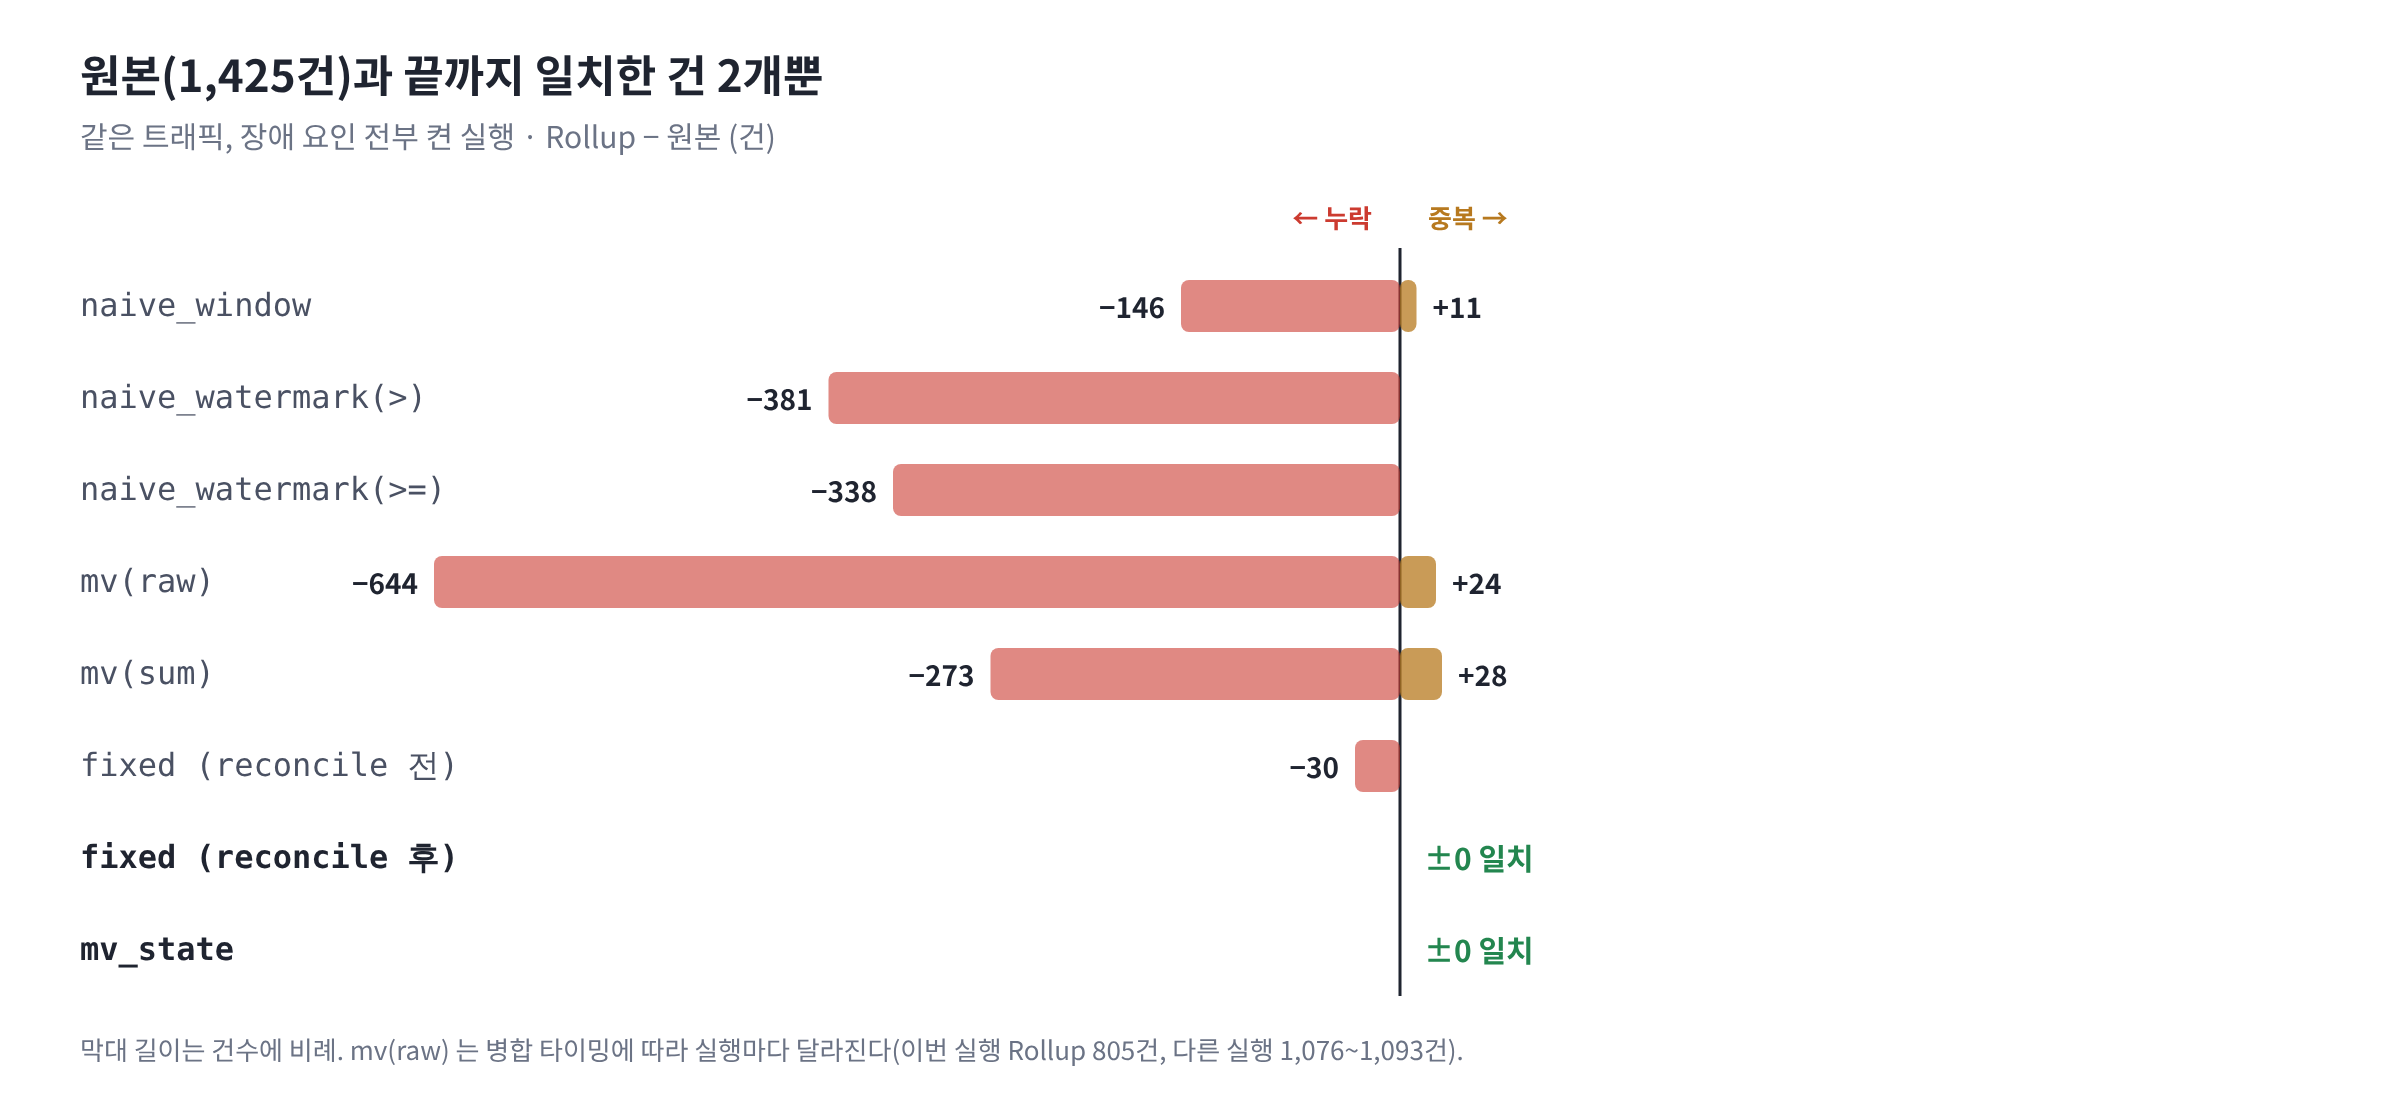
장애 요인을 하나씩만 켜면 어떤 요인이 어떤 전략을 깨는지 갈라진다. 셀은 Rollup − 원본(+중복 / −누락)이다.
| 전략 | 경계만 | resend | slow | same_ms | late | skew |
|---|---|---|---|---|---|---|
| naive_window | +240 | +332 | +2 / −97 | +2 / −97 | +240 / −45 | +210 |
| naive_watermark(>) | ✅ | +63 | −408 | −408 | ✅ | −30 |
| naive_watermark(>=) | +1,500 | +162 | +628 | +1,092 | +1,500 | +1,470 |
| mv(sum) | −390 | +40 / −378 | −282 | −282 | −390 | −390 |
| mv_state | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ |
| fixed | ✅ | ✅ | ✅ | ✅ | ✅ | −30 → ✅ (reconcile 후) |
naive_window의 skew는 +210으로 보이지만, 경계 중복 240건 안에 누락 30건이 숨어 있다.naive_watermark는 지연 도착에는 강하지만, 늦은 커밋·같은 ms에서는 408건을 잃는다.mv(sum)은 지연 도착·시계 오차는 잘 잡지만(INSERT 시점에 집계하므로), 설치 전 390건을 항상 잃는다.
resend 열과 mv(raw)는 ClickHouse 백그라운드 머지 타이밍에 따라 실행마다 조금씩 달라진다(예: naive_window resend +308~+332). 나머지 칸은 매번 같았다.
끝까지 맞은 두 방식의 공통점은 하나다. 더하지 않고, 다시 센다.
6. 해결 — 더하지 말고, 다시 센다
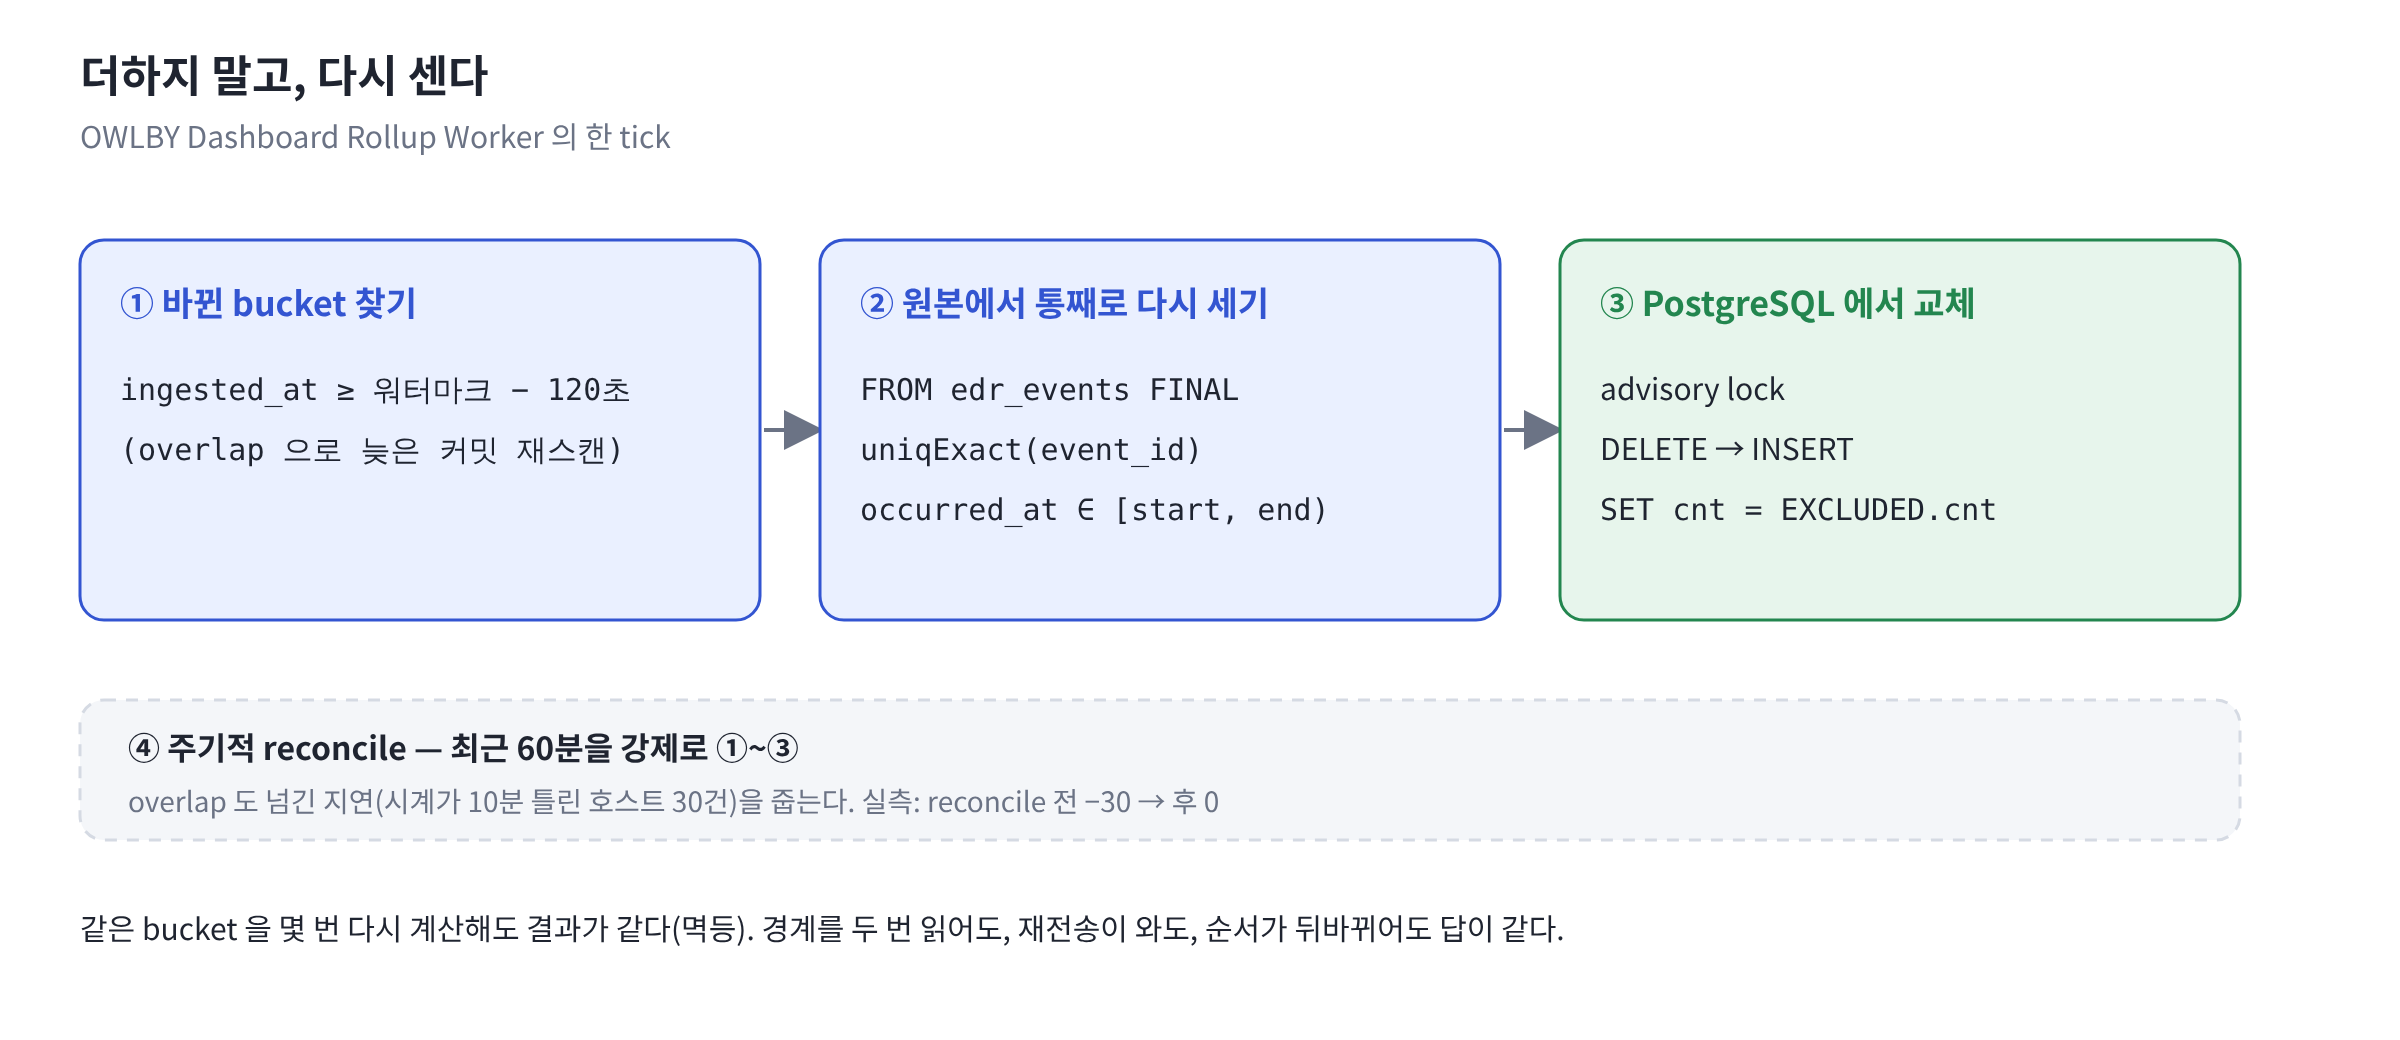
| 구분 | 조치 | 대가 |
|---|---|---|
| 응급 ① | 틀린 구간을 원본에서 강제 재집계 (--backfill-only --backfill-hours N) | 그 구간만큼 ClickHouse 조회 부하 |
| 응급 ② | (MV를 쓴 경우) 집계 테이블 조회에 GROUP BY + sum() | 없다 |
| 응급 ③ | 정정 삭제한 구간을 집계에서 지우고 재계산 | 재계산 동안 그 구간 조회가 흔들린다 |
| 근본 ① | 증분을 더하지 않는다. 바뀐 (endpoint, 분)을 원본에서 통째로 다시 세어 교체 | 바뀐 bucket마다 원본 재조회 |
| 근본 ② | FINAL + uniqExact(event_id), 범위는 반열린 구간 [start, end) | FINAL 비용 (dirty bucket만 읽어 완화) |
| 근본 ③ | 워터마크 이전 120초를 겹쳐 읽는 overlap + 주기적 reconcile | reconcile 주기만큼은 틀린 값이 보일 수 있다 |
| 근본 ④ | ClickHouse 조회부터 PG 교체까지 advisory lock으로 직렬화 | writer가 하나씩만 돈다 |
| 근본 ⑤ | MV가 꼭 필요하면 uniqExactState + "MV 생성 → 경계 버킷 삭제 → 백필" + -Merge 조회 | 원본의 77%를 추가 저장 |
OWLBY는 근본 ①~④(실험의 fixed)를 택했다. overlap만으로 −30까지 줄었고, reconcile 한 번으로 0이 됐다. 남은 30건은 ingested_at이 10분 늦게 찍힌, 시계가 틀어진 호스트의 Event였다.
6-1. 바뀐 bucket만 다시 센다
-- 1) 워터마크 - overlap 이후 들어온 행이 건드린 (endpoint, 분)을 찾는다
SELECT DISTINCT endpoint_id, toStartOfMinute(occurred_at) AS bucket
FROM edr_events
WHERE ingested_at >= {watermark} - INTERVAL 120 SECOND;

-- 2) 그 bucket만 원본에서 통째로 다시 센다
SELECT toStartOfMinute(occurred_at) AS bucket, endpoint_id, event_type,
       uniqExact(event_id) AS event_count
FROM edr_events FINAL
WHERE occurred_at >= {lo} AND occurred_at < {hi}
  AND (endpoint_id, toStartOfMinute(occurred_at)) IN ({dirty_keys})
GROUP BY bucket, endpoint_id, event_type;
-- 3) PostgreSQL: 한 트랜잭션 안에서 지우고 다시 넣는다
BEGIN;
SELECT pg_advisory_xact_lock(hashtext('dashboard_rollup'));
DELETE FROM dashboard_event_rollups r
USING unnest(%s::timestamptz[], %s::bigint[]) AS k(bucket_start_at, endpoint_id)
WHERE r.bucket_start_at = k.bucket_start_at AND r.endpoint_id = k.endpoint_id;
INSERT INTO dashboard_event_rollups (...) VALUES (...)
ON CONFLICT (bucket_start_at, endpoint_id, event_type)
DO UPDATE SET event_count = EXCLUDED.event_count; -- += 가 아니다
COMMIT;💡
event_count + EXCLUDED.event_count가 아니라EXCLUDED.event_count다. 이 차이가 이 사건의 절반이다. 같은 bucket을 몇 번 다시 계산해도 결과가 같아진다(멱등).
6-2. MV를 꼭 써야 한다면
CREATE TABLE events_per_minute_state (
    bucket_start_at DateTime('UTC'), endpoint_id UInt64, event_type LowCardinality(String),
    event_ids AggregateFunction(uniqExact, UUID)        -- 개수가 아니라 ID 집합
) ENGINE = AggregatingMergeTree ORDER BY (bucket_start_at, endpoint_id, event_type);

CREATE MATERIALIZED VIEW events_per_minute_state_mv TO events_per_minute_state AS
SELECT toStartOfMinute(occurred_at) AS bucket_start_at, endpoint_id, event_type,
       uniqExactState(event_id) AS event_ids
FROM edr_events GROUP BY bucket_start_at, endpoint_id, event_type;

-- MV를 먼저 만든 뒤 같은 SELECT로 백필한다
INSERT INTO events_per_minute_state SELECT ... FROM edr_events GROUP BY ...;

-- 읽을 때는 항상 -Merge + GROUP BY
SELECT bucket_start_at, endpoint_id, event_type, uniqExactMerge(event_ids)
FROM events_per_minute_state GROUP BY bucket_start_at, endpoint_id, event_type;
ID 집합이라 백필이 MV와 겹쳐도, 백필을 두 번 돌려도, 재전송이 와도 같은 답이 나온다. 실험에서 세 가지가 한꺼번에 일어났는데도 결과는 원본 고유 건수와 같은 110이었다.
6-3. 비용 비교 — 왜 OWLBY는 MV가 아니라 Worker인가
Event 100만 건(1시간, endpoint 50대), 로컬 ClickHouse 24.8, 조회 시간은 5회 중앙값이다.
| 방식 | 추가 저장 | 1시간 집계 조회 | 정확성 |
|---|---|---|---|
원본 재집계 (FINAL + uniqExact, fixed) | 없음 (원본 19.9 MiB) | 77 ms | ✅ 정확 |
uniqExactState MV (mv_state) | 15.3 MiB (원본의 77%) | 136 ms | ✅ 정확 |
count() + SummingMergeTree MV | 1.8 KiB | 3 ms | ❌ 틀림 (오해 ①·③, 재전송) |
- 정확한 MV는 ID 집합을 통째로 들고 있어서 원본만큼 무겁고, 이 규모에서는 읽기도 오히려 느렸다.
- 가벼운 MV는 틀린다.
- 그래서 OWLBY는 바뀐 bucket만 원본에서 다시 세는 Worker를 택했다.
7. 재발 방지 — "돌고 있다"가 아니라 "맞다"를 감시한다
7-1. 대사를 지표로 만든다
원인이 무엇이든, Rollup과 원본을 맞춰 보는 지표 하나만 있었으면 사람보다 먼저 잡혔다. 이번에 본 모든 증상은 대사에서 0이 아닌 차이로 나타났다.
-- 최근 1시간, 아직 Worker가 따라잡는 중인 마지막 2분은 제외
WITH src AS (
    SELECT toStartOfMinute(occurred_at) AS bucket, endpoint_id, event_type,
           uniqExact(event_id) AS cnt
    FROM edr_events FINAL
    WHERE occurred_at >= now() - INTERVAL 1 HOUR
      AND occurred_at <  toStartOfMinute(now()) - INTERVAL 2 MINUTE
    GROUP BY bucket, endpoint_id, event_type
)
SELECT count() AS mismatched_keys
FROM src FULL OUTER JOIN rollup_snapshot USING (bucket, endpoint_id, event_type)
WHERE src.cnt != rollup_snapshot.cnt;- 상한을 overlap(2분)만큼 더 잘라낸 게 요령이다. 따라잡는 중인 구간을 대사하면 매번 거짓 알람이 난다.
rollup_snapshot은 같은 범위의 PostgreSQL Rollup이다. 실제로는 애플리케이션에서 두 결과를 비교한다./operations/health에 coverage·freshness와 나란히 넣고, 불일치 키가 하나라도 있으면 degraded로 내린다.
💡 이 지표는 원인을 설명하지 않는다. "숫자가 틀렸다"만 말한다. 그거면 충분하다.
7-2. Rollup·MV 배포 체크리스트
- 집계 결과를 기존 값에 더하지 않고 교체하는가 (
SET cnt = EXCLUDED.cnt) - 시간 범위가 전부 반열린 구간
[start, end)인가.BETWEEN이 없는가 - 원본 집계가
count()가 아니라uniqExact(event_id)(또는FINAL)인가 - 워터마크를 쓴다면 overlap으로 겹쳐 읽고, 그래도 놓친 것을 reconcile이 줍는가
- (MV) TO 절로 타깃 테이블을 명시했는가
- (MV)
POPULATE대신 "MV 생성 → 경계 실측 → 경계 버킷 삭제 → 백필" 절차를 따랐는가 - (MV) 집계 테이블을 읽는 모든 쿼리가
GROUP BY+sum()또는-Merge규약을 지키는가 - (MV) 원본 삭제·수정·파티션 조작 때 집계를 함께 처리하는 런북이 있는가
- 이 집계에 대한 대사 지표와 알람이 걸려 있는가
7-3. 운영 중 감시할 것
| 대상 | 무엇을 보나 |
|---|---|
system.parts | 집계 테이블의 active 파트 수. 머지가 밀리면 규약을 어긴 조회가 더 크게 틀린다 |
system.mutations | 원본에 돈 mutation 이력. 집계 재계산이 필요하다는 신호 |
dashboard_rollup_state | source_max_ingested_at 차이(freshness). 돌고 있는지만 알려 준다 |
| 대사 지표 | 불일치 키 수. 맞는지를 알려 주는 유일한 값 |
8. 정리
| 질문 | 답 |
|---|---|
| 왜 숫자가 틀렸나 | 윈도우 경계 · 워터마크 · 재전송 · 지연 도착이 동시에. 원인은 하나가 아니었다 |
| MV로 바꾸면 되나 | 아니다. MV는 트리거라 과거·삭제·중복 제거를 보지 못하고, 합계 테이블은 머지 전까지 부분합이다 |
| 어떻게 고쳤나 | 바뀐 bucket을 원본에서 event_id 단위로 다시 세어 교체 + overlap + reconcile |
| 어떻게 다시 안 놓치나 | coverage·freshness 옆에 Rollup ↔ 원본 대사 지표를 둔다 |
집계는 더하는 게 아니라 다시 세는 것이다.
그리고 집계는 원본과 대사하지 않으면 틀린 줄 모른다. "돌고 있다"와 "맞다"는 다른 질문이다.