세 줄 요약
- Alert는 Primary에 저장됐는데, Read Replica를 읽는 대시보드에는 최대 17.8초 동안 보이지 않았다. 에러는 하나도 없었다.
- 범인은 "큰 배치"가 아니라 Replica에서 돌던 조회 하나였다. 조회와 충돌하는 WAL을 적용하지 못해 재생이 멈췄다.
- 해결의 핵심은 "몇 초 전 데이터를 보여줘도 되는가"를 조회마다 정하는 것이다. 지연을 없애는 공짜 설정은 없고, 지연을 어디로 옮길지 고를 뿐이다.
0. 실험 환경
OWLBY(EDR 플랫폼)의 Alert 저장 · 조회 경로만 떼어 내 장애를 재현했다. 스키마는 운영 마이그레이션의 alerts, incidents 테이블에서 필요한 컬럼만 남겼다.
| 구분 | 내용 |
|---|---|
| Primary | PostgreSQL 16 · alerts · incidents · Detection Worker가 저장 |
| Replica | PostgreSQL 16 Streaming Replica (hot standby) · 대시보드가 조회 |
| 기본 설정 | hot_standby_feedback = off, max_standby_streaming_delay = 30s (둘 다 PostgreSQL 기본값) |
| 읽기 라우팅 | replica · primary · lag_aware · read_your_writes 4가지 |
| 재현 코드 | team-C labs/incident-lab (python -m lab scenario s2, s2-deep) |
지연은 네 가지 방법으로 만들었다.
| 지연 주입 | 방법 | 실제로 생기는 상황 |
|---|---|---|
| 재생 정지 | pg_wal_replay_pause() | 운영자의 수동 정지, 복구 작업 |
| apply delay | recovery_min_apply_delay = 3s | 지연 복제 노드를 읽기 풀에 잘못 넣은 경우 |
| 재생 충돌 | Replica에 20초짜리 조회 + Primary에서 갱신·VACUUM | Replica에서 도는 무거운 리포트·대시보드 조회 |
| 대량 배치 | Primary에서 200만 행 UPDATE (한 트랜잭션 / 청크) | 일괄 수정 배치 |
1. 방금 저장한 Alert가 대시보드에 없다
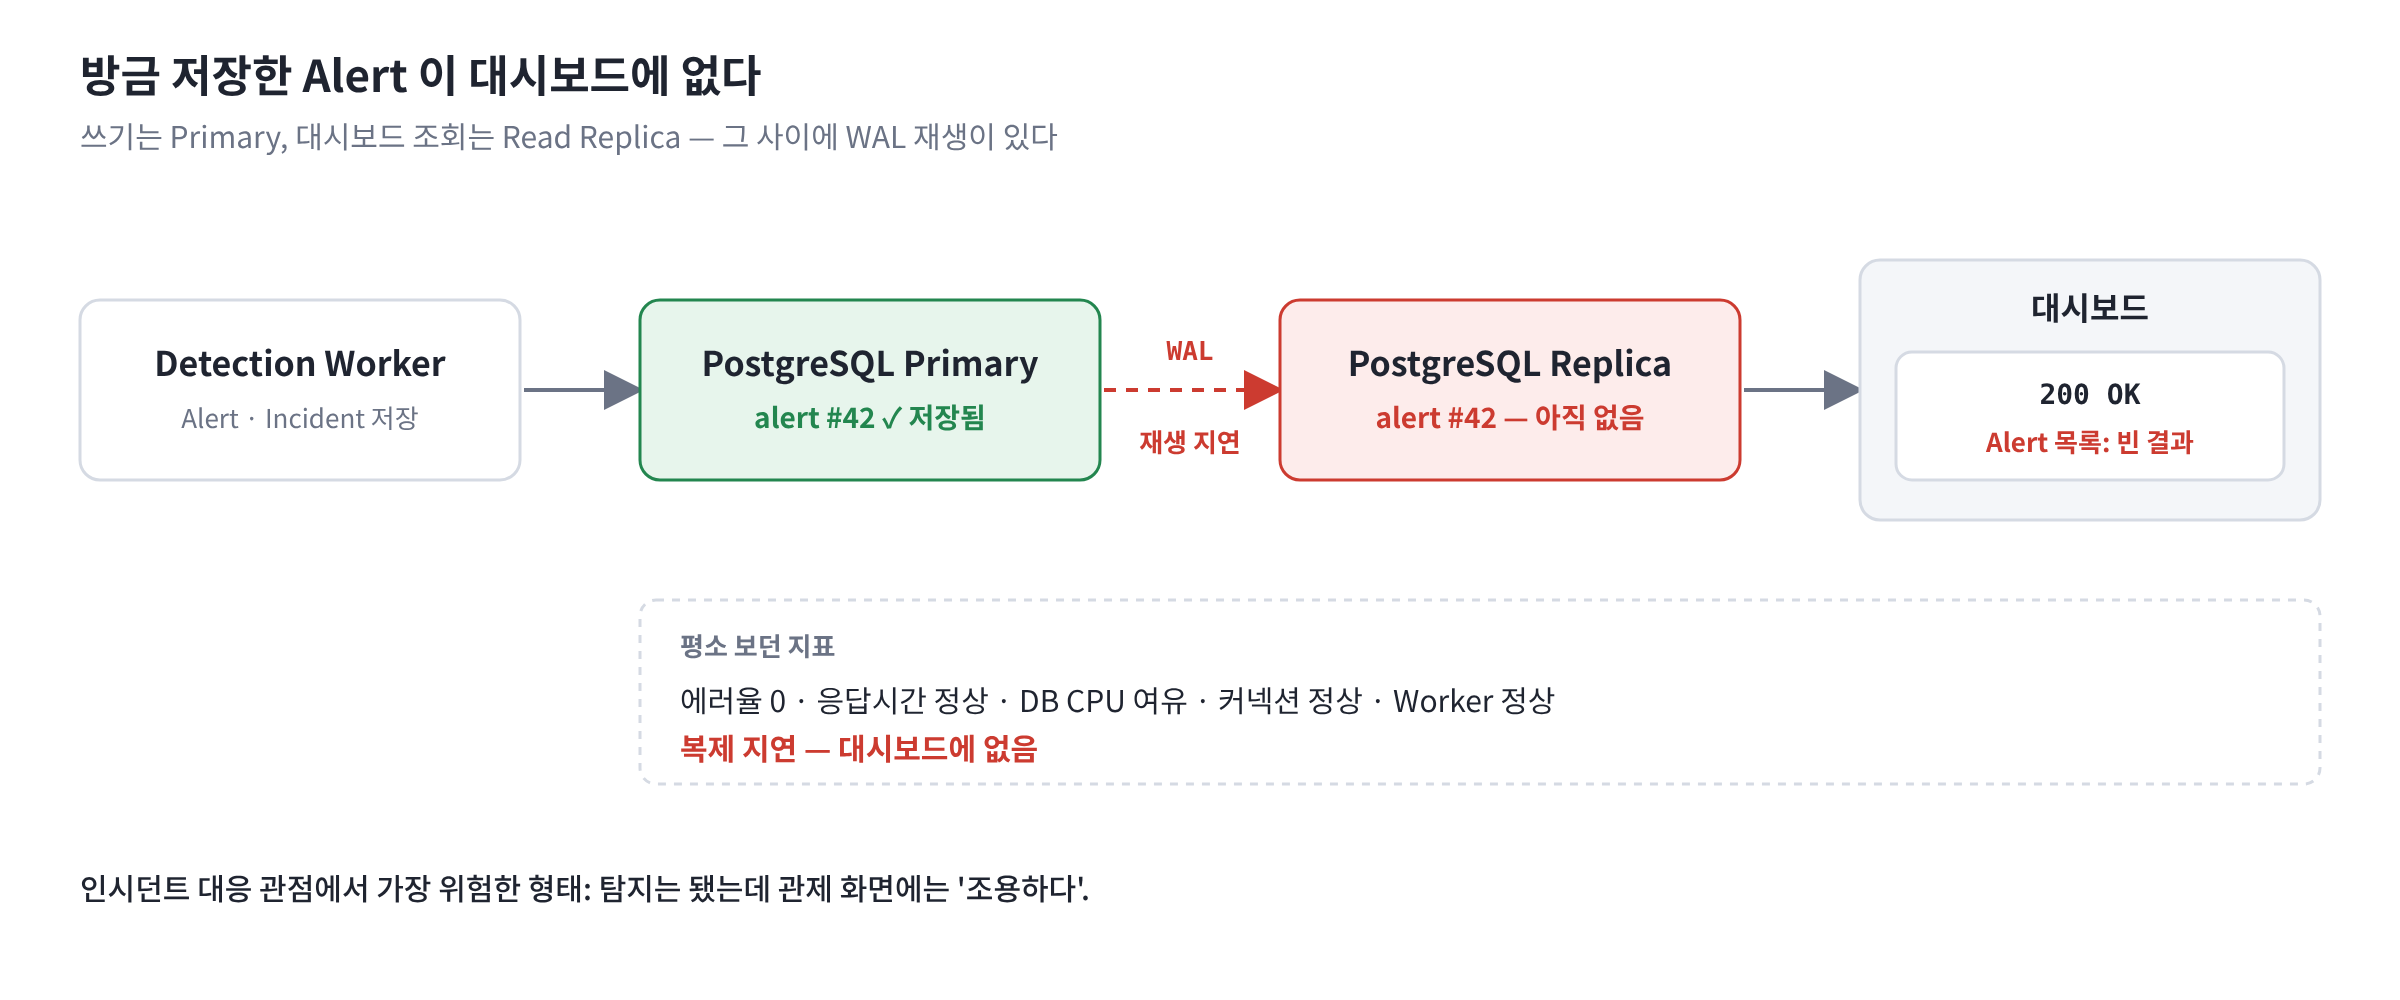
OWLBY는 쓰기와 읽기를 나눈다. Detection Worker는 Alert와 Incident를 Primary에 저장하고, 대시보드는 Read Replica에서 읽는다. 평소 복제 지연은 수 밀리초라 아무 문제가 없었다.
재현 실험에서 Replica에 무거운 조회가 도는 동안 Alert를 저장하고 곧바로 대시보드를 열었다.
| 조회 | 결과 |
|---|---|
| Primary 직접 조회 | Alert 있음 |
| 대시보드 (Replica) | 빈 목록. 15.4초 뒤에야 보였다 |
EDR에서 가장 위험한 형태다. 탐지는 됐는데 관제 화면은 조용하다. 잠시 뒤 새로고침하면 정상이라서, 사람은 "아까는 없었다"는 기억만 남기고 지나가기 쉽다.
2. 아무 지표도 울리지 않았다
에러가 없다. API는 200 OK를 반환하고, 조회 결과가 그냥 비어 있을 뿐이다.
| 평소 보던 지표 | 이번 사건에서 |
|---|---|
| API 에러율 · 응답시간 | ✅ 정상 — 빈 결과도 성공 응답이다 |
| DB CPU · 커넥션 | ✅ 정상 — Replica는 오히려 한가했다 |
| Worker 상태 | ✅ 정상 — Alert 저장은 전부 성공했다 |
| 복제 지연 | — 대시보드에 없었다 |
⚠️ 복제 지연은 평소 0에 붙어 있다. 바닥에 눌린 직선 그래프는 자리만 차지하는 것처럼 보여서 대시보드에서 빠지기 쉽다. 하지만 늘 0인 지표일수록 알람을 걸기 가장 쉽다. 0에서 벗어나는 순간이 곧 사건이기 때문이다.
3. 무엇이 Alert를 가렸나
3-1. 용의자 목록
저장에서 조회까지의 경로를 순서대로 놓고 한 칸씩 지웠다.
| # | 용의자 | 확인 방법 | 판정 |
|---|---|---|---|
| 1 | Alert 저장이 실패했다 | Primary에 직접 SELECT ... FROM alerts WHERE alert_id = 42 | ❌ 무죄 — Primary에 있다. 쓰기 코드는 조사 범위에서 빠진다 |
| 2 | API · 화면 캐시가 옛 값을 준다 | Replica에 직접 같은 SELECT | ❌ 무죄 — Replica에도 없다. 캐시보다 아래에서 이미 없다 |
| 3 | 복제가 끊겼다 | pg_stat_replication.state, pg_is_wal_replay_paused() | ❌ 무죄 — streaming, 정지 아님. 고장이 아니라 밀린 것이다 |
| 4 | 대량 배치가 Replica를 막았다 | 200만 행 UPDATE를 한 트랜잭션 / 청크로 실행 | 🔺 약함 — 배치 중에도 Alert 최대 0.46초 (3-3) |
| 5 | Replica의 조회가 WAL 재생을 붙잡았다 | 긴 조회 + Primary VACUUM, hot_standby_feedback off / on 비교 | ✅ 범인 — 재생이 멈춰 최대 17.8초 (3-4) |
3번과 5번의 차이가 분기점이다. "멈췄다"와 "못 따라간다"는 다른 사건이다. 복제가 끊겼다면 복제를 고쳐야 하지만, 여기서는 복제가 정상인 채로 재생만 밀렸다. 고칠 곳이 복제가 아니라 Replica를 쓰는 방식이라는 뜻이다.
3-2. 지연을 읽는 법 — 그리고 지표의 함정
PostgreSQL에서 복제 지연을 보는 방법은 크게 세 가지다.
| 지표 | 어디서 | 무엇을 재나 |
|---|---|---|
| LSN 차이 (바이트) | Primary: pg_wal_lsn_diff(pg_current_wal_lsn(), replay_lsn) | 아직 Replica가 적용하지 않은 WAL 양 |
replay_lag | Primary: pg_stat_replication | Primary가 WAL을 쓴 뒤 Replica가 적용했다고 보고하기까지 걸린 시간 |
now() - pg_last_xact_replay_timestamp() | Replica | 마지막으로 적용한 트랜잭션 이후 흐른 시간 |
세 지표를 같은 순간에 찍어 봤다. 상황마다 다른 말을 한다.
| 상황 | LSN 차이 | replay_lag | now() − last_replay | 새 Alert가 보이기까지 |
|---|---|---|---|---|
| 정상 (쓰기 직후) | 0 B | 0.00s | 0.51s | 6 ms |
| 한가함 (10초간 쓰기 없음) | 0 B | NULL | 10.02s | 12 ms |
| 재생 정지 + 쓰기 계속 | 11,888 B | 0.02s | 1.05s | 2초 안에 안 보임 |
| 재생 정지 + 5초간 쓰기 없음 | 12,560 B | 4.26s | 8.07s | — |
- 한가할 때
now() − last_replay는 지연 0인데도 10초로 커진다. 이것만 보고 알람을 걸면 밤마다 거짓 알람이 난다. - 재생이 막 멈췄을 때
replay_lag는 0.02초,now() − last_replay는 1초로 정상처럼 보인다. 실제로는 새 Alert가 보이지 않는다. - LSN 차이만 네 경우 모두 실제와 맞았다.
💡 시간 지표는 "마지막으로 무언가 일어난 때"를 기준으로 하기 때문에, 쓰기가 없으면 부풀고 재생이 막 멈추면 늦게 반응한다. 알람의 기준은 LSN 차이(바이트) 로 두고, 시간 지표는 LSN 차이가 0보다 클 때만 참고한다.
재생이 왜 밀리는지 보려면 Replica 쪽 뷰를 함께 본다.
-- Replica: 재생이 정지 상태인가
SELECT pg_is_wal_replay_paused();

-- Replica: 재생 충돌로 취소된 조회 수 (스냅샷 충돌, 락 충돌 등)
SELECT datname, confl_snapshot, confl_lock, confl_bufferpin
FROM pg_stat_database_conflicts;
3-3. 큰 배치 하나가 Replica를 막는가? — 엔진마다 다르다
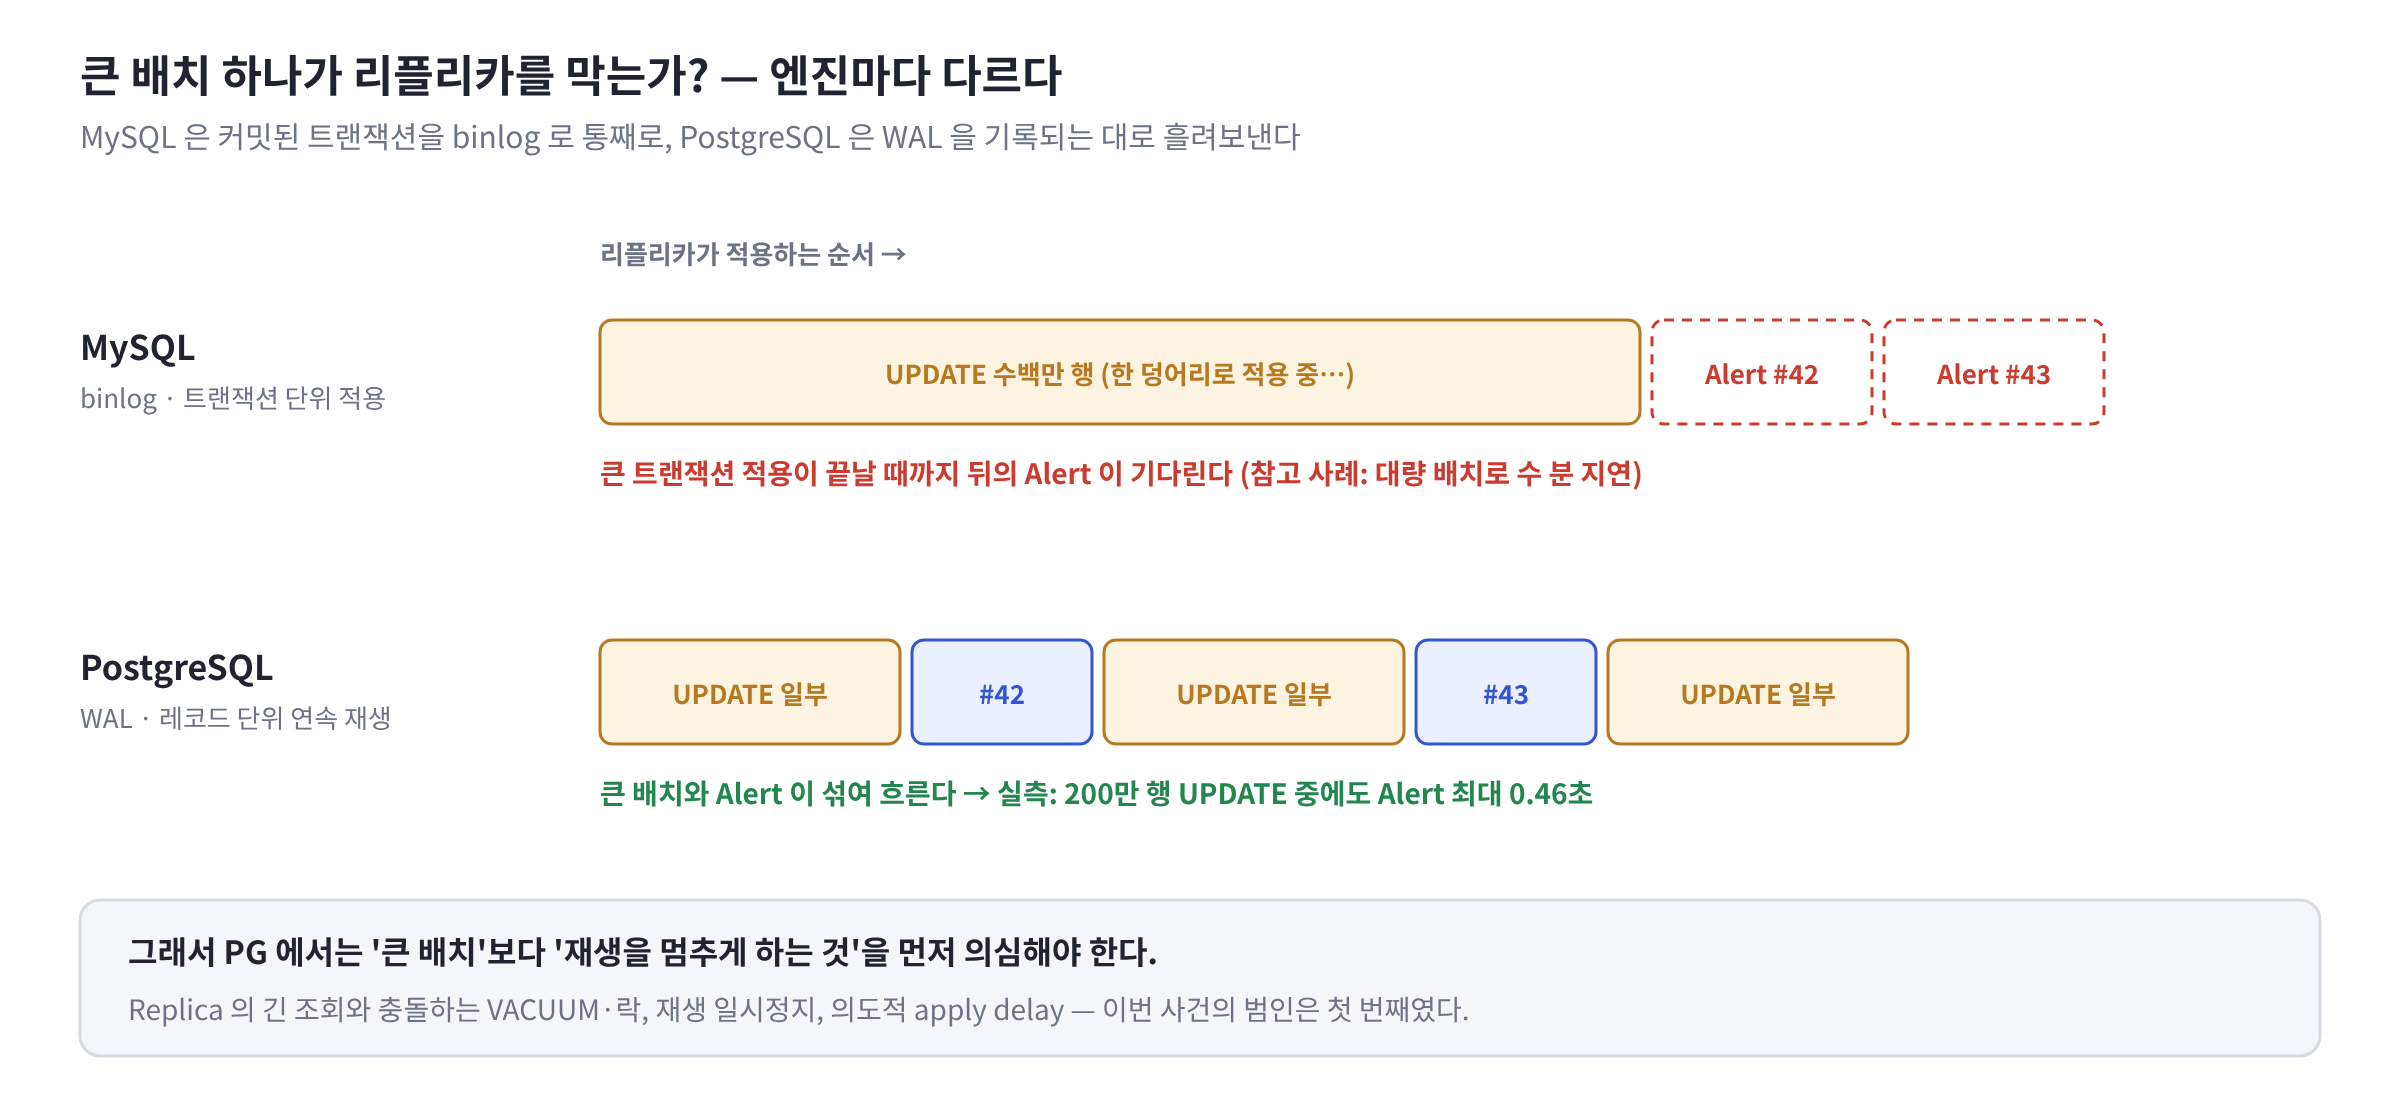
MySQL 복제 지연 사례에서 가장 흔한 원인은 "수백만 행을 바꾸는 단일 트랜잭션"이다. MySQL은 커밋된 트랜잭션을 binlog로 통째로 넘기고, Replica는 그 트랜잭션을 한 단위로 적용한다. 큰 트랜잭션이 끝날 때까지 뒤의 트랜잭션은 기다린다.
PostgreSQL에서도 그럴까? 200만 행 UPDATE를 돌리는 동안 0.2초마다 Alert를 저장하고, 각 Alert가 Replica에 보이기까지 걸린 시간을 쟀다.
| 방식 | 배치 시간 | 커밋 수 | 최대 지연 | Alert 가시성 p50 | p95 | 최대 |
|---|---|---|---|---|---|---|
| 한 트랜잭션 | 15.2s | 1 | 16.0 MB | 172 ms | 325 ms | 462 ms |
| 청크 (2만 행, 지연 4MB 초과 시 대기) | 20.4s | 100 | 9.4 MB | 41 ms | 138 ms | 422 ms |
- PostgreSQL은 WAL을 기록되는 대로 흘려보내 레코드 단위로 계속 재생한다. 큰 배치와 Alert가 섞여 흐르기 때문에, 배치 도중에도 Alert는 1초 안에 보였다.
- 청크로 나누면 지연이 줄긴 했다(p50 172 → 41 ms). 하지만 대시보드에서 Alert가 사라지는 수준의 차이는 아니었다.
💡 MySQL 사례를 PostgreSQL에 그대로 대입하면 엉뚱한 곳을 고치게 된다. PG에서는 "큰 배치"보다 재생을 멈추게 하는 것을 먼저 의심해야 한다.
⚠️ 이 실험은 Primary와 Replica가 같은 머신에 있는 로컬 환경이다. 운영처럼 Replica 디스크·네트워크가 느리면 같은 배치에서도 지연이 더 커질 수 있다.
3-4. 범인 — Replica의 조회가 재생을 붙잡았다
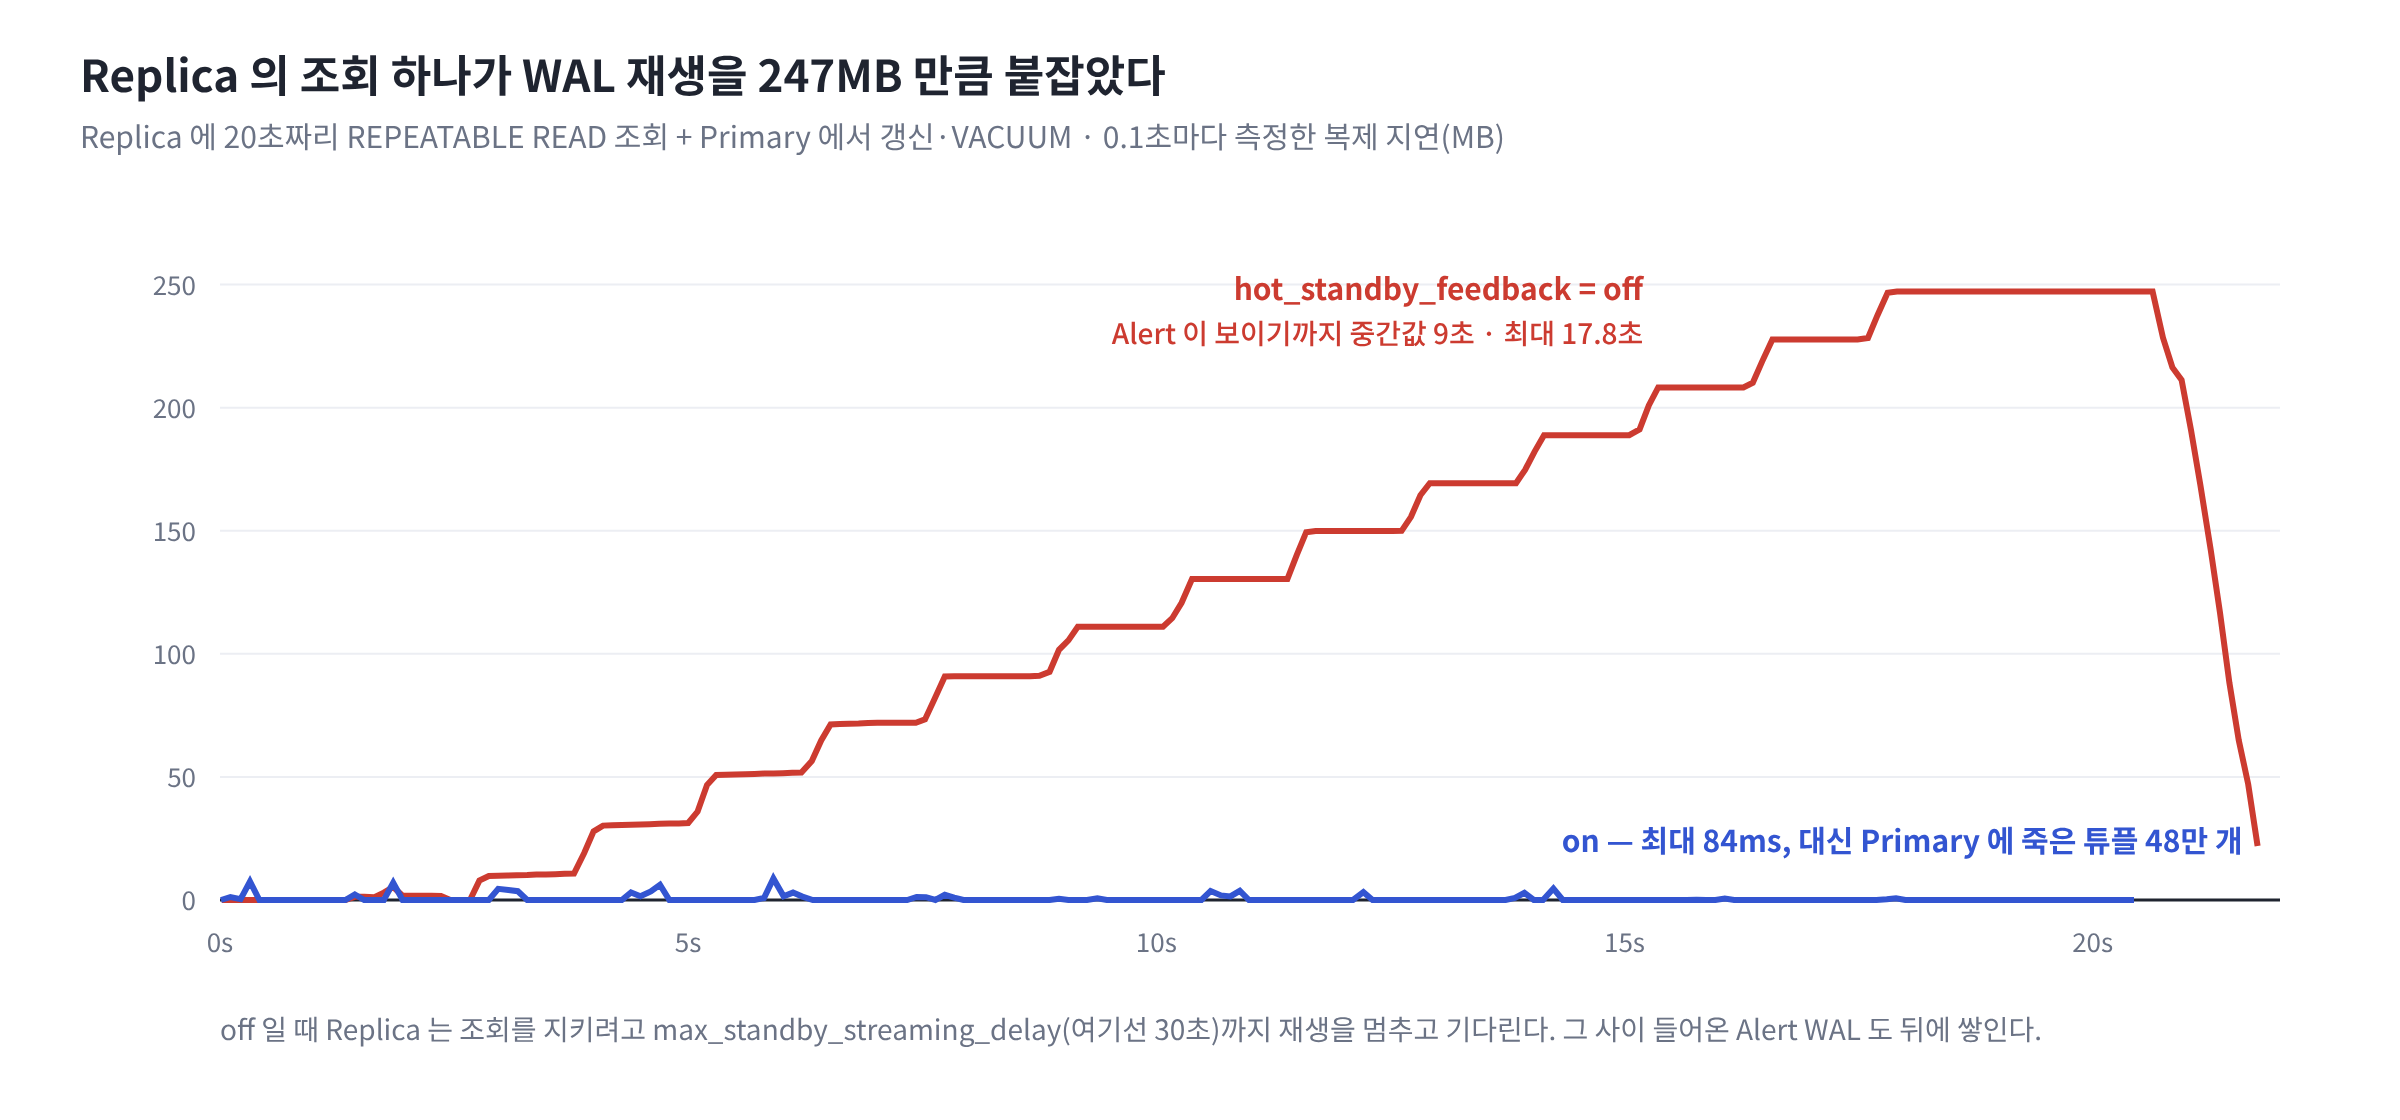
Replica에서 20초짜리 REPEATABLE READ 조회를 돌리고, 그동안 Primary에서 같은 테이블을 갱신하고 VACUUM했다. 대시보드의 무거운 집계 조회나 리포트가 Replica에서 도는 상황이다.
hot_standby_feedback | 최대 지연 | Alert 가시성 p50 | 최대 | Primary VACUUM 후 남은 죽은 튜플 |
|---|---|---|---|---|
| off (기본값) | 247.2 MB | 9.0 s | 17.8 s | 0 |
| on | 8.8 MB | 16 ms | 84 ms | 480,000 |
무슨 일이 일어났나:
- Primary의 VACUUM이 죽은 튜플을 지우고, 그 정리 기록이 WAL로 Replica에 간다.
- 그런데 Replica에는 아직 그 튜플을 봐야 하는 조회(스냅샷)가 살아 있다.
- Replica는 조회를 지키려고 정리 WAL 적용을 미룬다. 최대
max_standby_streaming_delay(여기서는 30초)까지 재생 전체를 멈추고 기다린다. - 그 뒤에 들어온 Alert INSERT의 WAL도 함께 막힌다. 그래프의 계단 모양이 그 대기다.
hot_standby_feedback = on이면 Replica가 "아직 이 튜플을 보고 있다"고 Primary에 알려 VACUUM이 그 튜플을 지우지 않는다. 충돌이 생기지 않으니 지연이 사라진다. 대신 Primary에 죽은 튜플 48만 개가 남는다. 지연을 Primary의 테이블 팽창으로 옮긴 것이다.
결정적 증거
- 지연이 커지기 시작한 시각이 Replica의 긴 조회가 시작된 시각과 일치한다.
- LSN 차이는 계단 모양으로 계속 벌어지는데, 복제 상태는
streaming이고 재생 정지도 아니다. - 같은 부하에서
hot_standby_feedback만 켜면 지연이 사라진다.
고장이 아니라 붙잡힌 것이다. 복제를 재시작할 문제가 아니라, Replica를 누가 어떻게 쓰는지의 문제다.
4. 해결 — 대시보드는 어디서 읽어야 하나
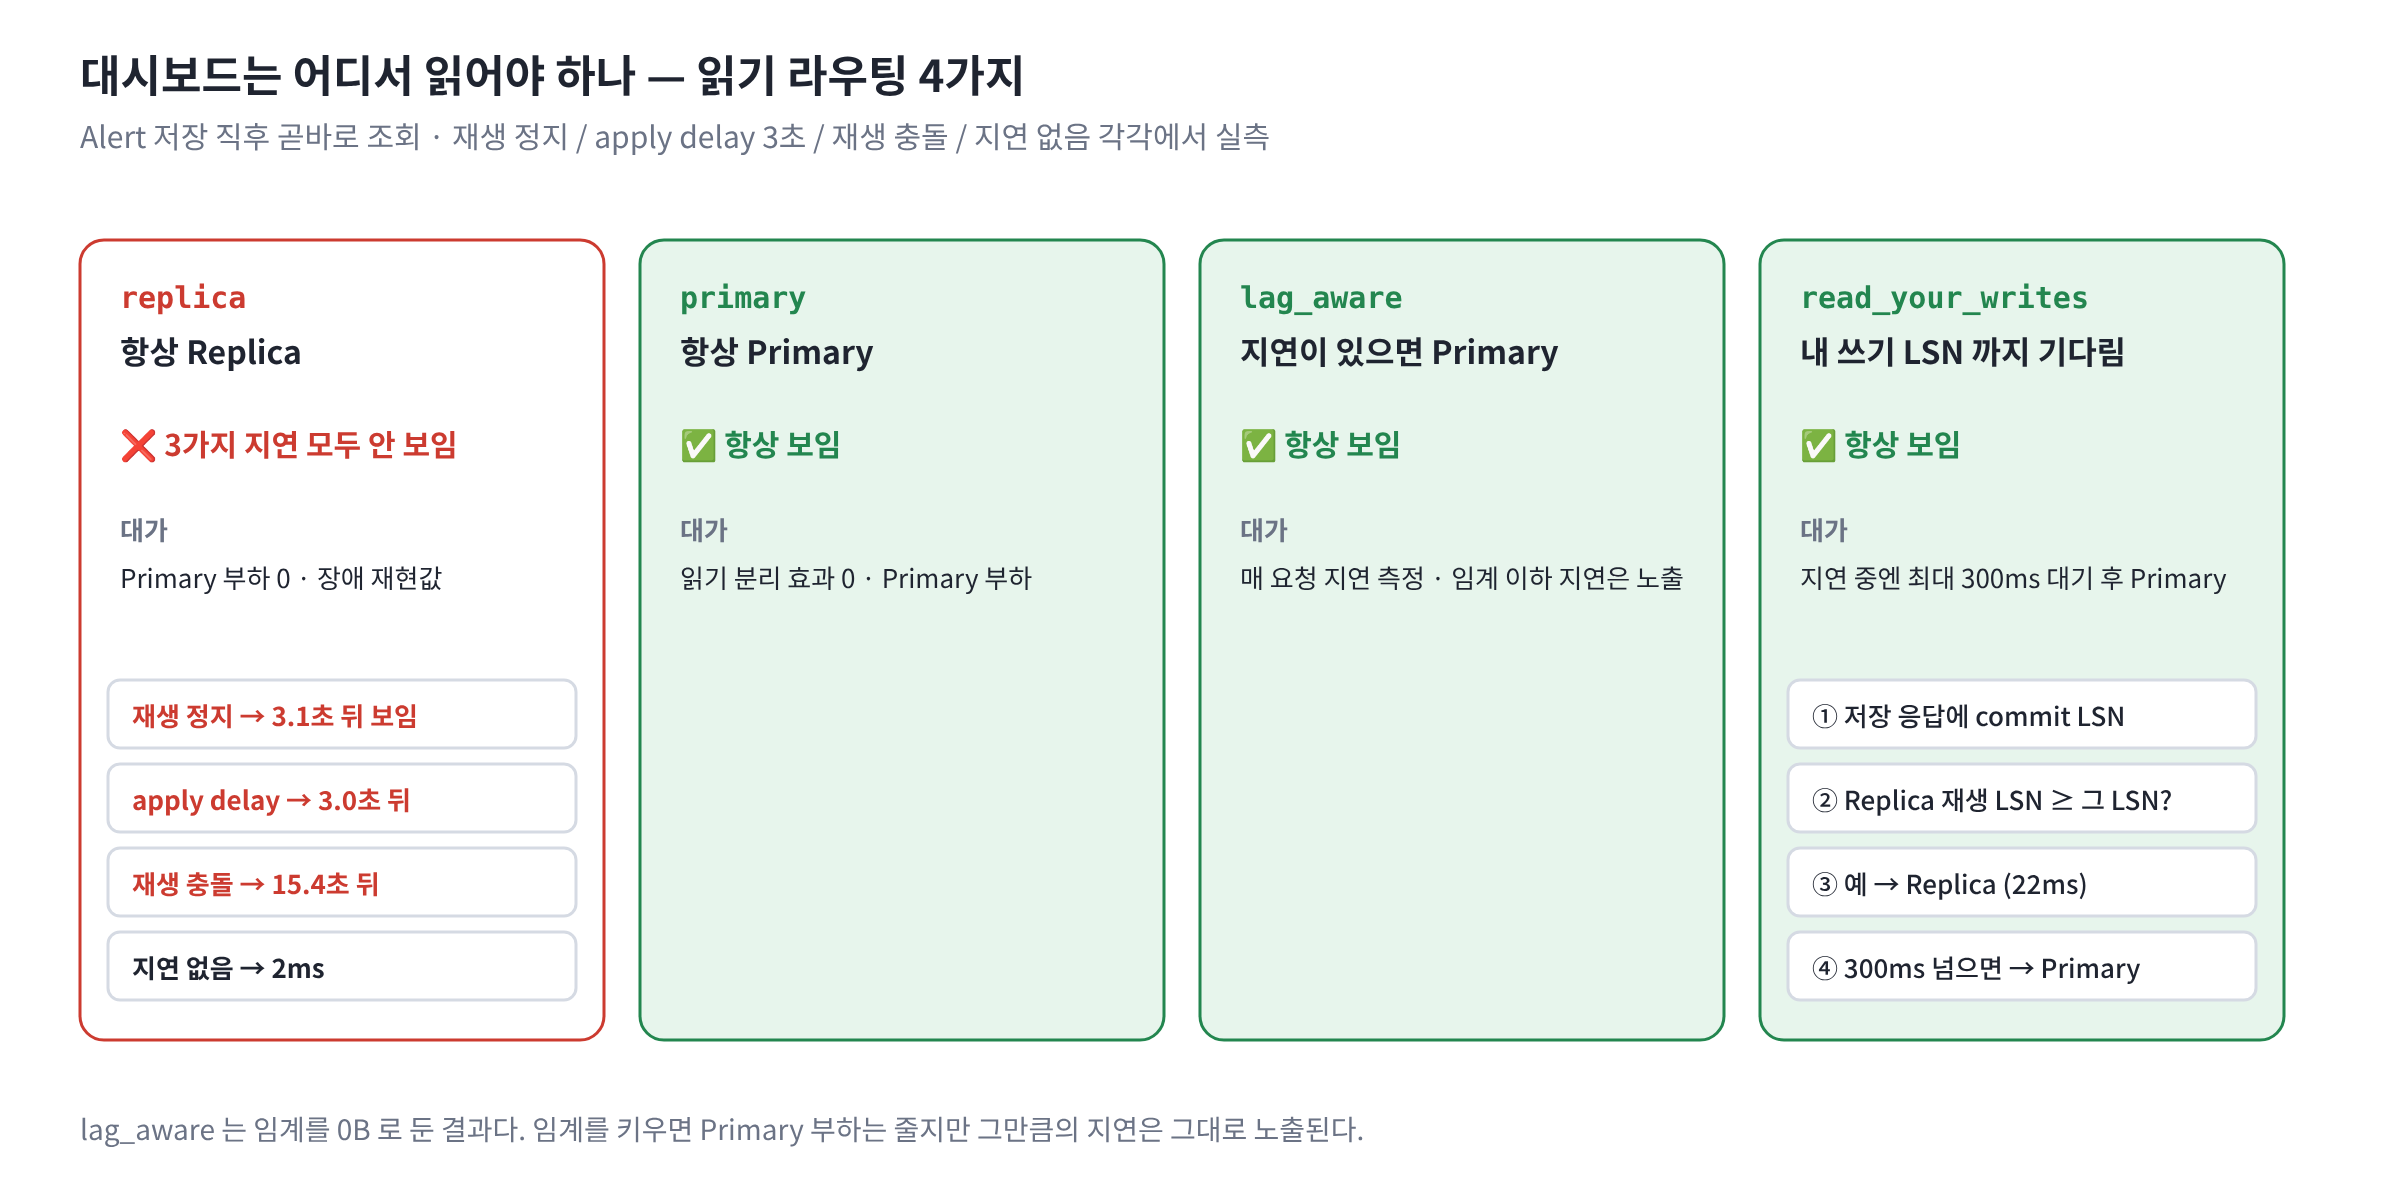
Alert를 저장하고 곧바로 조회하는 실험을 읽기 라우팅 4가지 × 지연 4가지로 돌렸다.
| 읽기 라우팅 | 재생 정지 | apply delay 3초 | 재생 충돌 | 지연 없음 | 대가 |
|---|---|---|---|---|---|
replica 항상 Replica | ❌ (3.1s 뒤 보임) | ❌ (3.0s 뒤) | ❌ (15.4s 뒤) | ✅ 2 ms | 장애 재현값 |
primary 항상 Primary | ✅ | ✅ | ✅ | ✅ | 읽기 분리 효과 0 |
lag_aware 지연이 있으면 Primary | ✅ | ✅ | ✅ | ✅ Replica | 매 요청 지연 측정. 임계를 키우면 그만큼 지연 노출 |
read_your_writes 내 쓰기 LSN까지 대기 | ✅ (300ms 대기 후 Primary) | ✅ | ✅ | ✅ Replica (22 ms) | 지연 중엔 최대 300ms 대기 |
4-1. 조회마다 정합성 요구를 나눈다
읽기 분리는 전부 아니면 전무가 아니다. 판단 기준은 하나다. "이 조회가 몇 초 전 데이터를 보여줘도 괜찮은가."
| OWLBY 조회 | 어디서 읽나 | 이유 |
|---|---|---|
| 방금 탐지된 Alert 목록, Alert 상세, 상태 변경 직후 화면 | Primary 또는 read-your-writes | 대응자가 지금 봐야 하는 것. 몇 초 늦으면 대응이 늦는다 |
| Incident 상세 · Investigation Graph | read-your-writes | 방금 묶인 Alert가 빠지면 사건이 다르게 보인다 |
| Overview 통계, Fleet 분포, 과거 기간 조회 | Replica | 몇 초 전 데이터여도 판단이 바뀌지 않는다 |
| 리포트 · 무거운 집계 | Replica (가능하면 전용 노드) | 서비스 Replica에서 돌면 3-4의 재생 충돌을 만든다 |
4-2. read-your-writes 구현
쓰기 응답에 커밋 LSN을 실어 보내고, 다음 조회에서 Replica가 그 LSN까지 재생했는지 확인한다.
-- Primary: Alert 저장 트랜잭션 커밋 직후, 현재 WAL 위치를 토큰으로 돌려준다
SELECT pg_current_wal_lsn();          -- 예: 0/89EF8AA8

-- Replica: 조회 전에 그 위치까지 재생했는지 확인
SELECT pg_last_wal_replay_lsn() >= '0/89EF8AA8'::pg_lsn;
-- true  → Replica에서 읽는다
-- false → 20ms 간격으로 다시 확인, 300ms를 넘기면 Primary로 폴백- 토큰은 응답 헤더(
X-Read-After-LSN)와 쿠키로 함께 내려 준다. - 지연이 없으면 대기 22ms 만에 Replica에서 읽는다. 지연이 있으면 300ms를 기다린 뒤 Primary로 간다.
- 타임아웃과 Primary 폴백은 반드시 있어야 한다. 없으면 재생이 멈춘 동안 조회도 같이 멈춘다.
5. 공짜 해결책은 없다
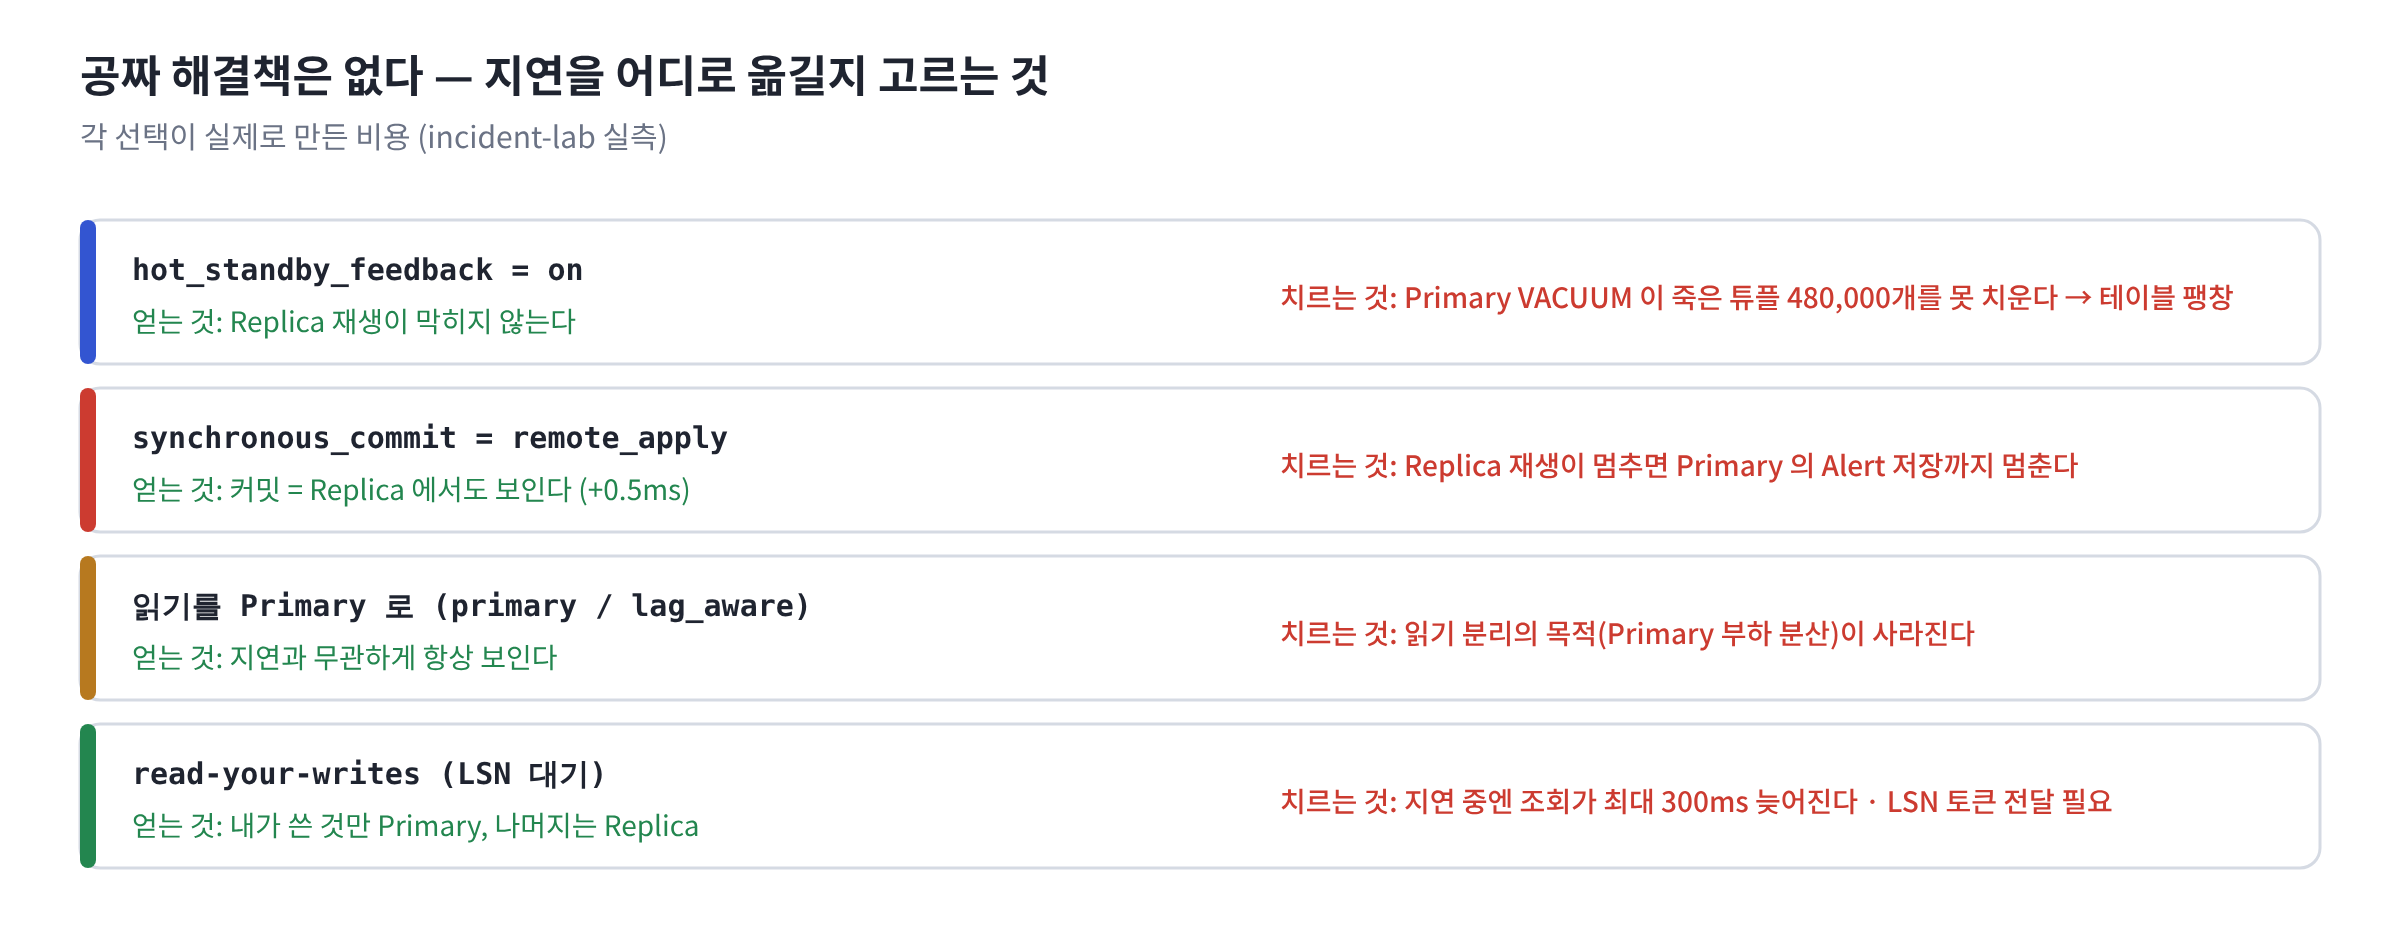
설정 하나로 지연을 없애려는 선택지도 측정했다.
| 커밋 방식 (Alert 저장 100회) | p50 | p95 |
|---|---|---|
| 비동기 (기본) | 1.2 ms | 1.8 ms |
synchronous_commit = remote_apply | 1.7 ms | 2.1 ms |
remote_apply는 Replica가 적용까지 마쳐야 커밋을 돌려준다. 평소에는 0.5ms만 늘어서 매력적으로 보인다. 그런데 Replica 재생을 멈추자 Primary의 Alert 저장 자체가 멈췄다. 재생을 재개할 때까지 5초 동안 커밋이 돌아오지 않았다.
| 선택 | 얻는 것 | 치르는 것 |
|---|---|---|
hot_standby_feedback = on | Replica 재생이 막히지 않는다 | Primary VACUUM이 죽은 튜플 480,000개를 못 치운다 → 테이블 팽창 |
synchronous_commit = remote_apply | 커밋 = Replica에서도 보인다 (+0.5ms) | Replica가 멈추면 Primary 쓰기까지 멈춘다. 탐지 파이프라인이 선다 |
읽기를 Primary로 (primary, lag_aware) | 지연과 무관하게 항상 보인다 | 읽기 분리의 목적(Primary 부하 분산)이 사라진다 |
| read-your-writes | 내가 쓴 것만 Primary, 나머지는 Replica | 지연 중엔 최대 300ms 늦어진다. LSN 토큰 전달이 필요하다 |
💡 EDR에서
remote_apply는 특히 위험하다. Replica 문제 하나가 Alert 저장을 멈추면, 복제 지연이 "탐지 자체의 장애"로 번진다.
6. 조치 정리
| 구분 | 조치 | 왜 듣는가 | 대가 |
|---|---|---|---|
| 응급 ① | 대응 화면(Alert 목록·상세)을 Primary 읽기로 전환 | 정합성이 즉시 회복된다 | Primary 부하 증가. 커넥션 풀 여유를 먼저 확인 |
| 응급 ② | Replica의 긴 조회를 찾아 취소 (pg_stat_activity) | 붙잡힌 재생이 바로 풀린다 | 그 조회를 낸 사용자는 결과를 못 받는다 |
| 응급 ③ | LSN 차이가 임계를 넘은 Replica를 읽기 풀에서 제외 | 사람 판단 없이 초 단위로 처리된다 | 남은 노드로 부하가 몰린다 |
| 근본 ① | 조회별 정합성 요구에 따라 라우팅 (4-1) + read-your-writes | 지연이 생겨도 대응 화면에 증상이 안 나타난다 | 조회마다 결정이 필요하다 |
| 근본 ② | 무거운 리포트·집계는 별도 Replica에서 | 서비스 Replica의 재생 충돌 원인을 없앤다 | 노드 비용 |
| 근본 ③ | 서비스 Replica에 짧은 statement_timeout | 긴 조회가 재생을 오래 붙잡지 못한다 | 무거운 조회가 실패한다 |
| 근본 ④ | max_standby_streaming_delay를 서비스 정합성 기준에 맞게 조정 | 재생이 기다리는 상한이 곧 최악의 지연이 된다 | 낮출수록 Replica 조회가 자주 취소된다 |
| 근본 ⑤ | hot_standby_feedback는 Primary 팽창 감시와 함께 켠다 | 재생 충돌 자체가 사라진다 | Primary 죽은 튜플 증가 (480,000개 실측) |
7. 재발 방지 — 지연을 보고, 지연이 길어지지 않게
7-1. 알람
| 알람 | 조건 | 왜 이 조건인가 |
|---|---|---|
| 복제 지연 | LSN 차이가 N MB를 넘음 | 3-2에서 네 경우 모두 맞은 유일한 지표. N은 서비스가 감당하는 지연을 실측해서 정한다 |
| 복제 끊김 | pg_stat_replication에 Replica 행이 없음, 또는 state != 'streaming' | 지연이 아니라 정지다. 저절로 회복되지 않는다 |
| 재생 정지 | pg_is_wal_replay_paused() = true | 누군가 멈춰 두고 잊은 경우 |
| 재생 충돌 | pg_stat_database_conflicts의 취소 수 증가 | 이번 사건의 직접 원인이 숫자로 남는 곳 |
| 측정 불가 | 지연 값이 NULL이거나 수집이 끊김 | 값이 없는 것을 0으로 취급하면 장애가 통째로 안 보인다 |
⚠️
now() − pg_last_xact_replay_timestamp()만으로 알람을 걸지 않는다. 쓰기가 없는 새벽에는 지연 0인데도 계속 커진다(3-2).
7-2. 구조적 예방
- 서비스 Replica에서 무거운 조회를 돌리지 않는다. 리포트·집계는 전용 노드로 보낸다. 이번 사건은 조회 하나에서 시작됐다.
- 기본 라우팅을 Primary로 두고, Replica는 명시적으로 고른다. 실수했을 때 결과가 정합성 버그인 쪽보다 Primary 부하가 조금 느는 쪽이 되돌리기 쉽다.
- 배치는 청크 커밋을 기본형으로 한다. PG에서는 효과가 작았지만, Primary WAL 폭증과 VACUUM 부담을 줄이는 습관으로 둔다.
- 임계는 측정으로 정한다. 스테이징에서 운영 규모 조회와 배치를 실제로 돌려 지연이 얼마까지 벌어지는지 잰다. 알람이 실제로 울리는지도 그때 확인한다.
7-3. 배포·운영 체크리스트
- 복제 지연(LSN 바이트) · 복제 상태 · 재생 정지 · 재생 충돌이 한 화면에 있다
- 지연 알람과 복제 끊김 알람이 Replica별로 걸려 있고, 최근 한 번은 실제로 울려 봤다
- 지표가 NULL이거나 사라진 상태를 정상(0)이 아니라 이상으로 처리한다
- 조회 경로마다 Primary / Replica / read-your-writes가 명시적으로 정해져 있다
- 대응 화면(Alert·Incident)은 Replica 지연과 무관하게 방금 저장된 데이터를 보여 준다
- 서비스 Replica에 무거운 리포트 조회가 돌지 않는다
-
hot_standby_feedback,max_standby_streaming_delay값을 의식적으로 정했다 - Primary로 읽기를 몰았을 때 커넥션 풀이 버티는지 확인했다
8. 정리
| 질문 | 답 |
|---|---|
| 왜 Alert가 안 보였나 | Replica의 긴 조회가 VACUUM 정리 WAL과 충돌해 재생이 최대 30초 멈췄다. 그 뒤의 Alert도 같이 막혔다 |
| 큰 배치가 원인 아닌가 | PG에서는 약했다. WAL을 연속 재생해서 200만 행 UPDATE 중에도 Alert는 0.46초 안에 보였다 |
| 지연은 어떻게 재나 | LSN 차이(바이트)로. 시간 지표는 한가할 때 부풀고 재생이 멈춘 직후엔 정상처럼 보인다 |
| 어떻게 고쳤나 | 대응 화면은 read-your-writes, 통계는 Replica. 무거운 조회는 서비스 Replica에서 뺀다 |
| 설정 하나로 안 되나 | hot_standby_feedback은 Primary 팽창, remote_apply는 Primary 쓰기 정지로 비용을 옮길 뿐이다 |
읽기 분리는 성능 최적화가 아니라 정합성 트레이드오프다.
Replica에서 읽기로 정한 순간 "몇 초 전 데이터를 보여줘도 된다"고 답한 것이다. 그 결정을 조회마다 하지 않았다면, 하지 않은 게 아니라 전부 괜찮다고 답한 것이다.