자료형
정수형
>>> 입력
a = 1000
print(a)

a = -7
print(a)

a = 0
print(a)

>> 출력
1000
-7
0
실수형
>>> 입력
a = 157.98
print(a)

a = -1377.8
print(a)

a = 5.
print(a)

a = -.7
print(a)

>> 출력
157.98
-1377.8
5.0
-0.7
리스트
- 대괄호([]) 안에 원소 넣어 초기화하고, 쉼표로 원소 구분
- 원소에 접근할 때는 인덱스 값을 괄호 안에 넣기
- 인덱스는 0부터 시작
리스트 만들기
>>> 입력
a = [1, 2, 3, 4, 5, 6]
print(a)
print(a[4])

# 빈 리스트 선언
b = list()
print(b)

c = []
print(c)

>>> 출력
[1, 2, 3, 4, 5, 6]
5
[]
[]
리스트 인덱싱과 슬라이싱
- 인덱싱 : 인덱스값을 입력하여 리스트의 특정한 원소에 접근하는 것
>>> 입력
a = [1, 2, 3, 4, 5, 6, 7, 8, 9]
# 뒤에서 첫 번째 원소
print(a[-1])

# 뒤에서 세 번째 원소
print(a[-3])

# 네 번째 원소 값 변경
a[3] = 7
print(a)

>>> 출력
9
7
[1, 2, 3, 7, 5, 6, 7, 8, 9]- 슬라이싱 : 리스트에서 연속적인 위치를 갖는 원소들을 가져와야 할 때
>>> 입력
a = [1, 2, 3, 4, 5, 6, 7, 8, 9]
# 두 번째 원소부터 네 번째 원소까지
print(a[1 : 4])

>>> 출력
[2, 3, 4]
리스트 컴프리헨션
- 리스트 컴프리헨션 : 대괄호([]) 안에 조건문과 반복문을 넣는 방식으로 리스트 초기화
>>> 입력
# 0부터 19까지 수 중 홀수만 포함하는 리스트
array = [i for i in range(20) if i % 2 == 1]
print(array)

# 1부터 9까지의 수 제곱값 포함하는 리스트
array = [i * i for i in range(1,10)]
print(array)

# N * M 크기의 2차원 리스트 초기화
n = 3
m = 4
array = [[0] * m for _ in range(n)]
print(array)

>>> 출력
[1, 3, 5, 7, 9, 11, 13, 15, 17, 19]
[1, 4, 9, 16, 25, 36, 49, 64, 81]
[[0,0,0,0], [0,0,0,0], [0,0,0,0]]
리스트 관련 기타 메서드
- append()
- 사용법 : 변수명.append()
- 설명 : 리스트에 원소를 하나 삽입할 때 사용
- sort()
- 사용법 : 변수명.sort()
- 설명 : 기본 정렬 기능으로 오름차순 정렬
- 부가 : (reverse=True) 하면 내림차순 정렬
- reverse()
- 사용법 : 변수명.reverse()
- 설명 : 리스트의 원소의 순서를 모두 뒤집기
- insert()
- 사용법 : 변수명.insert(삽입할 위치 인덱스, 삽입할 값)
- 설명 : 특정한 인덱스 위치에 원소를 삽입할 때 사용
- count()
- 사용법 : 변수명.count(특정 값)
- 설명 : 리스트에서 특정한 값을 가지는 데이터의 개수를 셀 때 사용
- remove()
- 사용법 : 변수명.remove(특정 값)
- 설명 : 특정한 값을 갖는 원소를 제거하는데, 값을 가진 원소가 여러 개면 하나만 제거
문자열
>>> 입력
data = 'Hello World'
print(data)

a = "Hello"
b = "World"
print(a + " " + b)

>>> 출력
Hello World
Hello World
튜플
- 튜플은 한 번 선언된 값을 변경할 수 없다.
- 리스트는 대괄호, 튜플은 소괄호 이용
딕셔너리(사전)
- 키와 값의 쌍을 데이터로 가지는 자료형
>>> 입력
data = dict()
data['사과'] = 'Apple'
data['바나나'] = 'Banana'
print(data)

# 키 데이터만 담은 리스트
key_list = data.keys()
# 값 데이터만 담은 리스트
value_list = data.values()
print(key_list)
print(value_list)


>>> 출력
{'사과' : 'Apple', '바나나' : 'Banana'}
집합
- 중복 허용 X
- 순서 X
>>> 입력
# 집합 자료형 초기화 방법 1
data = set([1, 1, 2, 3, 4, 4, 5])

# 집합 자료형 초기화 방법 2
data = {1, 1, 2, 3, 4, 4, 5}
print(data)

>> 출력
{1, 2, 3, 4, 5}
{1, 2, 3, 4, 5}
집합 자료형의 연산
- 합집합, 교집합, 차집합
>>> 입력
a = set([1, 2, 3, 4, 5])
b = set([3, 4, 5, 6, 7])

print(a | b)
print(a & b)
print(a - b)

>>> 출력
{1, 2, 3, 4, 5, 6, 7}
{3, 4, 5}
{1, 2}
집합 자료형 관련 함수
>>> 입력
data = set([1, 2, 3])
print(data)

# 새로운 원소 추가
data.add(4)
print(data)

# 새로운 원소 여러 개 추가
data.update([5, 6])
print(data)

# 특정한 값을 갖는 원소 삭제
data.remove(3)
print(data)

>>> 출력
{1, 2, 3}
{1, 2, 3, 4}
{1, 2, 3, 4, 5, 6}
{1, 2, 4, 5, 6}
조건문
score = 85

if score >= 70:
	print('성적이 70점 이상입니다.')
    if score >= 90:
    	print('우수한 성적입니다.')
else:
	print('성적이 70점 미만입니다.')

print('프로그램 종료합니다.')


>>> 출력
성적이 70점 이상입니다.
프로그램 종료합니다.
조건부 표현식
score = 85
result = "Success" if score >= 80 else "Fail"

print(result)

>>> 출력
Success
반복문
while문
i = 1
result = 0

# i가 9보다 작거나 같을 때 아래 코드 반복적으로 실행
while i <= 9:
	result += i
    i += 1

print(result)

>>> 출력
45
for문
score = [90, 85, 77, 65, 97]
cheating_list = {2, 4}

for i in ragne(5):
	if i + 1 in cheating_list:
    	continue
    if score[i] >= 80:
    	print(i + 1, "번 학생은 합격입니다.")

>>> 출력
1번 학생은 합격입니다.
5번 학생은 합격입니다.
함수
기본구조
def 함수명(매개변수):
	실행할 소스코드
    return 반환값
>>> 입력
a = 0
def func():
global a
a += 1
for i in range(10):
func()
print(a)
>>> 출력
10- global 키워드
함수 안에서 함수 밖의 변수 데이터를 변경해야 하는 경우, 함수에서 global 키워드를 이용
입출력
전형적인 소스코드
# 데이터 개수 입력
n = int(input())

# 각 데이터를 공백으로 구분하여 입력
dtat = list(map(int, input().split()))

data.sort(reverse = True)
print(data)


>>> 출력
5 ↵
65 90 75 34 99 ↵
[99, 90, 75, 65, 34]
공백을 기준으로 구분하여 데이터 입력
# n, m, k를 공백으로 구분하여 입력
n, m, k = map(int, input().split())

print(n, m, k)

>>> 출력
3 5 6 ↵
3 5 6
readline() 사용 소스코드
import sys

# 문자열 입력받기
data = sys.stdin.readline().rstrip()
print(data)

>>> 출력
Hello World ↵
Hello World
주요 라이브러리 문법
itertools
- 파이썬에서 반복되는 데이터를 처리하는 기능을 포함하고 있는 라이브러리
- 유용하게 사용가능한 클래스는 permutations, combinations
permutations
- 리스트와 같은 iterable 객체에서 r개의 데이터를 뽑아 일렬로 나열하는 모든 경우(순열) 계산
from itertools import permutations

data = ['A','B','C']
result = list(permutations(data, 3))

print(result)

>>> 출력
[('A', 'B', 'C'), ('A', 'C', 'B'), ('B', 'A', 'C'), ('B', 'C', 'A'), ('C', 'A', 'B'), ('C', 'B', 'A')]
combinations
- 리스트와 같은 iterable 객체에서 r개의 데이터를 뽑아 순서를 고려하지 않고 나열하는 모든 경우(조합)를 계산
from itertools import combinations

data = ['A','B','C']
result = list(combinations(data, 2))

print(result)

>>> 출력
[('A', 'B'), ('A', 'C'), ('B', 'C')]
product
- permutations와 같이 리스트와 같은 iterable 객체에서 r개의 데이터를 뽑아 일렬로 나열하는 모든 경우(순열)를 계산
- 원소 중복하여 뽑기
- 뽑고자 하는 데이터의 수를 repeat 속성값으로 넣기
from itertools import product

data = ['A','B','C']
result = list(product(data, repeat=2))

print(result)

>>> 출력
[('A', 'A'), ('A', 'B'), ('A', 'C'), ('B', 'A'), ('B', 'B'), ('B', 'C'), ('C', 'A'), ('C', 'B'), ('C', 'C')]
combinations_with_replacement
- combinations와 같이 리스트와 같은 iterable 객체에서 r개의 데이터를 뽑아 순서 고려하지 않고 나열하는 모든 경우(조합)를 계산
- 원소 중복하여 뽑기
from itertools import combinations_with_replacement

data = ['A','B','C']
result = list(combinations_with_replacement(data,2))

print(result)

>>> 출력
[('A', 'A'), ('A', 'B'), ('A', 'C'), ('B', 'B'), ('B', 'C'), ('C', 'C')]
heapq
- 힙(heap) 기능을 위해 heapq 라이브러리 제공
- 다익스트라 최단 경로 알고리즘을 포함해 다양한 알고리즘에서 우선순위 큐 기능을 구현하고자 할 때 사용
- heapq.heappush() : 힙에 원소 삽입할 때
- heapq.heappop() : 힙에서 원소 꺼낼 때
import heapq

def heapsort(iterable):
    h = []
    result = []

    # 모든 원소를 차례대로 힙에 삽입
    for value in iterable:
        heapq.heappush(h, value)

    # 힙에 삽입된 모든 원소를 차례대로 꺼내어 담기
    for i in range(len(h)):
        result.append(heapq.heappop(h))
    return result

result = heapsort([1,3,5,7,9,2,4,6,8,0])
print(result)

>>> 출력
[0, 1, 2, 3, 4, 5, 6, 7, 8, 9]- 파이썬에서는 최대 힙 제공 X
- heapq 라이브러리 이용하여 최대 힙 구현해야 할 때에는 원소의 부호를 임시로 변경하는 방식 사용
import heapq

def heapsort(iterable):
    h = []
    result = []

    # 모든 원소를 차례대로 힙에 삽입
    for value in iterable:
        heapq.heappush(h, -value)

    # 힙에 삽입된 모든 원소를 차례대로 꺼내어 담기
    for i in range(len(h)):
        result.append(-heapq.heappop(h))
    return result

result = heapsort([1,3,5,7,9,2,4,6,8,0])
print(result)

>>> 출력
[9, 8, 7, 6, 5, 4, 3, 2, 1, 0]
bisect
- 파이썬에서 이진 탐색을 쉽게 구현하도록 제공되는 라이브러리
- '정렬된 배열'에서 특정한 원소를 찾아야 할 때 효과적
- bisect_left(a, x) : 정렬된 순서를 유지하면서 리스트 a에 데이터 x를 삽입할 가장 왼쪽 인덱스를 찾는 데서드
- bisect_right(a, x) : 정렬된 순서를 유지하도록 리스트 a에 데이터 x를 삽입할 가장 오른쪽 인덱스를 찾는 메서드
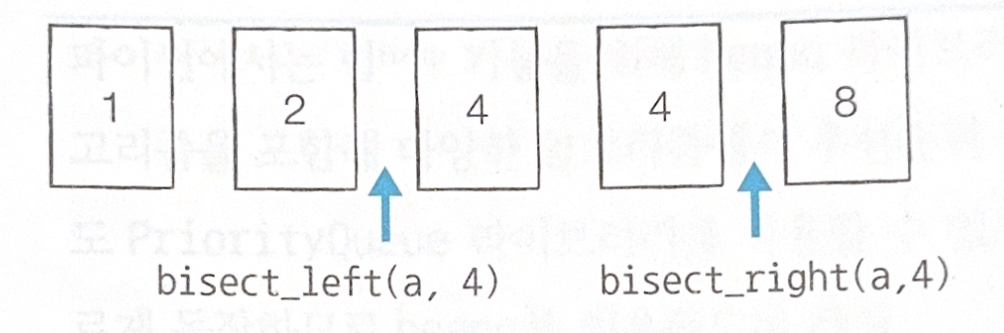
예를 들어 리스트 [1,2,4,4,8]이 있을 때, 새롭게 데이터 4를 삽입하려 한다
from bisect import bisect_left, bisect_right

a = [1,2,4,4,8]
x = 4

print(bisect_left(a,x))
print(bisect_right(a,x))

>>> 출력
2
4
'정렬된 리스트'에서 '값이 특정 범위에 속하는 원소의 개수'를 구하고자 할 때
from bisect import bisect_left, bisect_right

# 값이 [left_value, right_value]인 데이터의 개수를 반환하는 함수
def count_by_range(a, left_value, right_value):
    right_index = bisect_right(a, right_value)
    left_index = bisect_left(a, left_value)
    return right_index -  left_index

# 리스트 선언
a = [1,2,3,3,3,3,4,4,8,9]

# 값이 4인 데이터 개수 출력
print(count_by_range(a,4,4))

# 값이 [-1,3] 범위에 있는 데이터 개수 출력
print(count_by_range(a,-1,3))

>>> 출력
2
6
collections
- 유용한 자료구조를 제공하는 표준 라이브러리
- deque와 Counter 클래스 주로 사용
deque
- deque에서는 리스트 자료형과 다르게 인덱싱, 슬라이싱 등의 기능은 사용 X
- popleft() : 첫 번째 원소 제거
- appendleft(x) : 첫 번째 인덱스에 원소 x를 삽입
- append(x) : 마지막 인덱스에 원소 삽입
from collections import deque

data = deque([2,3,4])
data.appendleft(1)
data.append(5)

print(data)
print(list(data))

>>> 출력
deque([1, 2, 3, 4, 5])
[1, 2, 3, 4, 5]
Counter
- 등장 횟수를 세는 기능
- 리스트와 같은 iterable 객체가 주어졌을 때, 해당 객체 내부의 원소가 몇 번씩 등장했는지를 알려줌
from collections import Counter

counter = Counter(['red','blue','red','green','blue','blue'])

print(counter['blue'])  # blue가 등장한 횟수 출력
print(counter['green']) # green이 등장한 횟수 출력
print(dict(counter))    # 딕셔너리 자료형으로 변환

>>> 출력
3
1
{'red': 2, 'blue': 3, 'green': 1}
math
- 수학적인 기능을 포함하고 있는 라이브러리
- factorial(x) : x! 값 반환
- sqrt(x) : x의 제곱근 반환
- gcd(a,b) : a와 b의 최대 공약수 반환
import math

print(math.factorial(5))    # 5 팩토리얼
print(math.sqrt(7))         # 7의 제곱근
print(math.gcd(21, 14))     # 21과 15의 최대 공약수
print(math.pi)              # 파이
print(math.e)               # 자연상수 e

>>> 출력
120
2.6457513110645907
7
3.141592653589793
2.718281828459045
이것저것 학습 기록장