우선순위 큐
- 가장 높은 우선순위를 가진 항목에 접근, 삭제 연산과 임의의 우선순위를 가진 항목을 삽입하게 지원하는 자료구조
- 우선순위 큐 자료구조가 필요한 이유 : 삽입되는 항목이 임의의 우선순위를 가진다면 스택이나 큐는 새 항목을 삽입할 때마다 정렬 상태를 유지해야하는 문제점 O
이진 힙(Binary Heap)
-
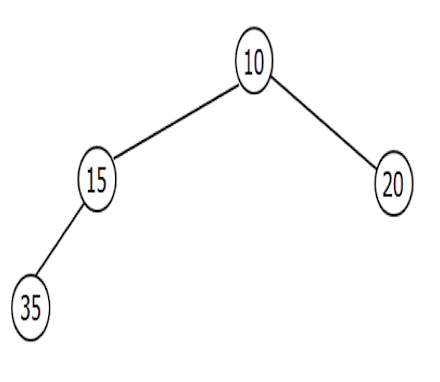
조건 1. 완전 이진 트리
-
조건 2. 부모의 우선순위 > 자식의 우선순위
-
특징
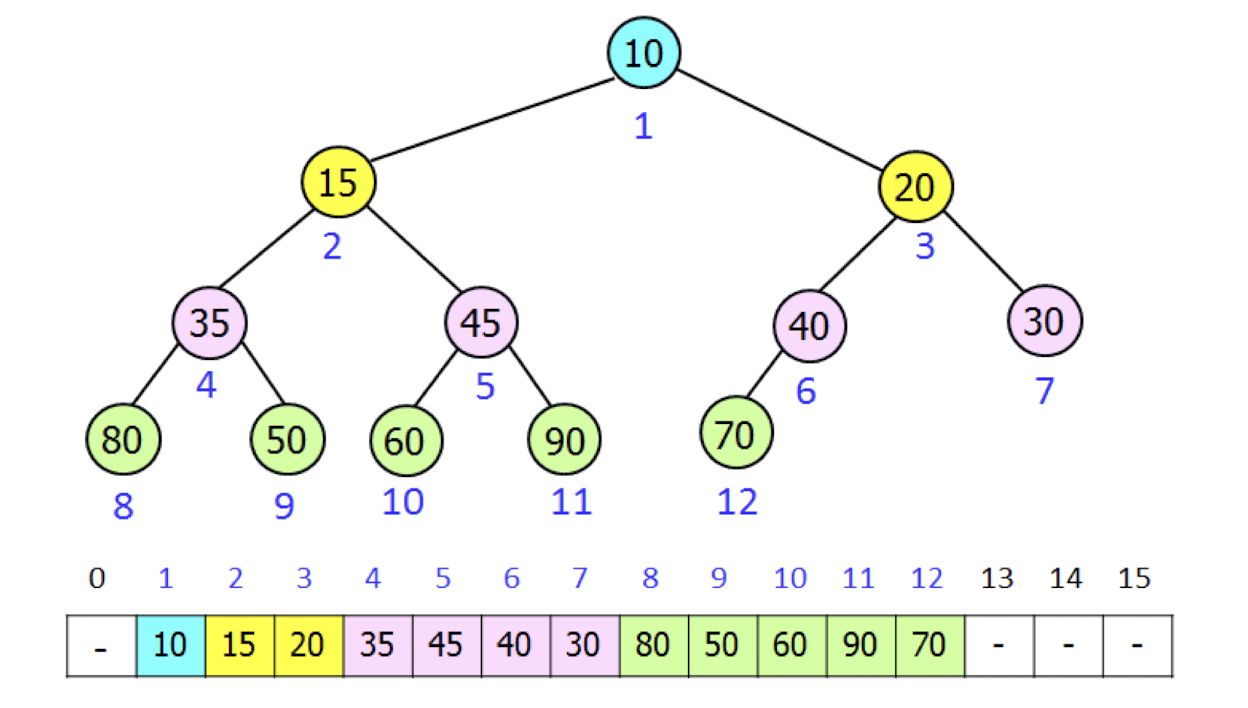
- 완전 이진 트리는 1차원 배열로 구현, 배열의 2번째 원소부터 사용함
배열 a에서 a[0]은 사용하지 않음
- 완전 이진 트리의 노드를 레벨 순회 순서에 따라 a[1]부터 차례로 저장
-
힙에서 부모와 자식 관계
a[i]의 자식은 a[2i]&a[2i+1]
a[j]의 부모는 a[j/2] (단 j/2의 정수만을 취함)
이진 힙의 종류
- 최소 힙 : 키가 작을수록 높은 우선순위
- 최대 힙 : 키가 클수록 더 높은 우선순위
최솟값 삭제
- 루트의 키 삭제
- 힙의 가장 마지막 노드(배열의 가장 마지막 항목)를 루트로 이동
- 힙 크기 1 감소
- 루트로부터 자식 중 작은 값을 가진 자식(승자)과 키 비교하여 힙 속성이 만족될 때까지 키 교환하며 이파리 방향으로 진행 - downheap
삽입
- 힙의 마지막 노드(배열의 마지막 항목)의 바로 다음 empty 원소에 새로운 항목을 저장
- 루트 방향으로 올라가면서 부모의 키와 비교하여 힙 속성이 만족될 때까지 노드 교환 - upheap
- 최소 힙인 경우 부모의 우선순위 > 자식의 우선순위 (부모의 키 값이 더 작음)
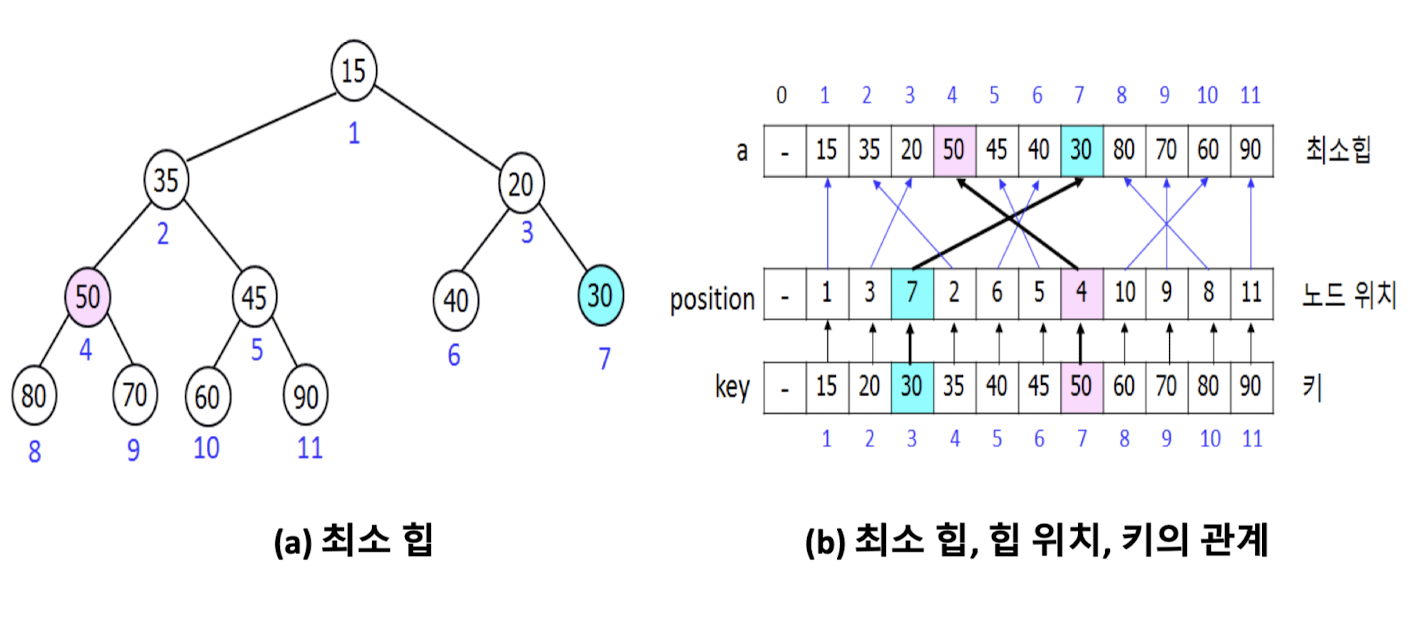
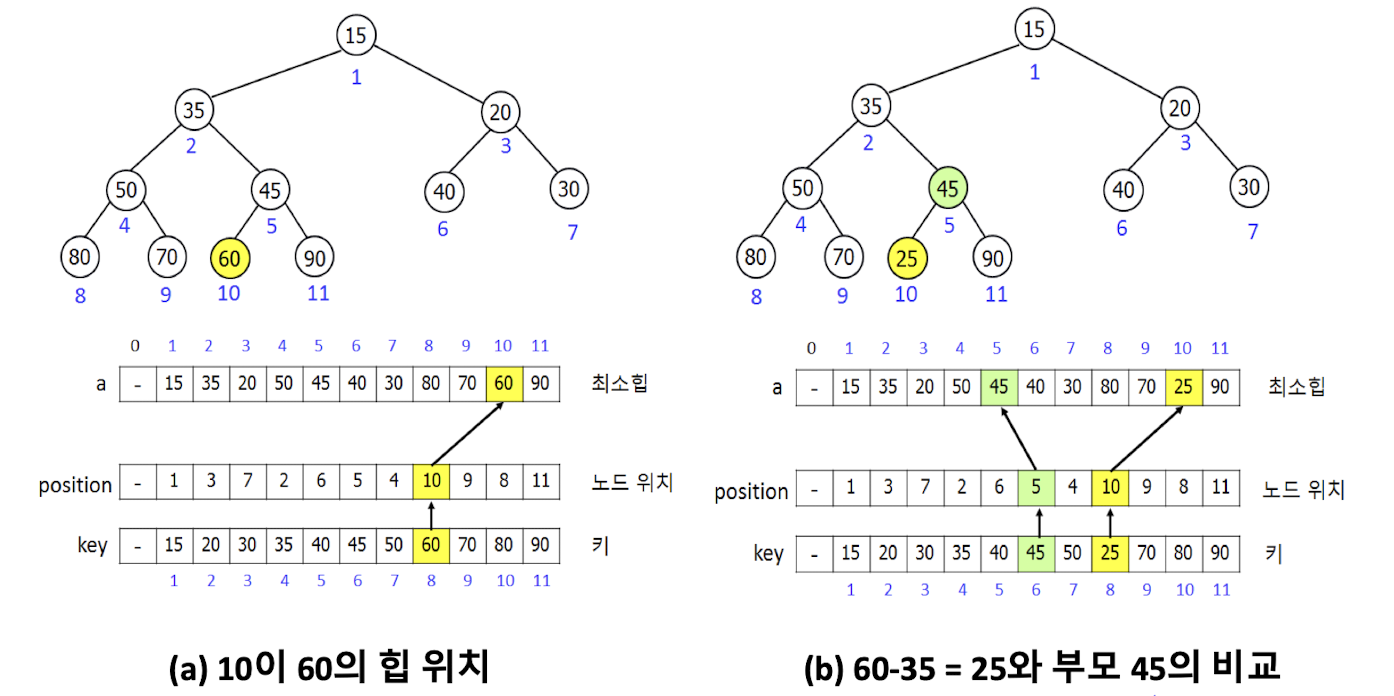
최소 힙, 힙 위치, 키의 관계
키 값 감소
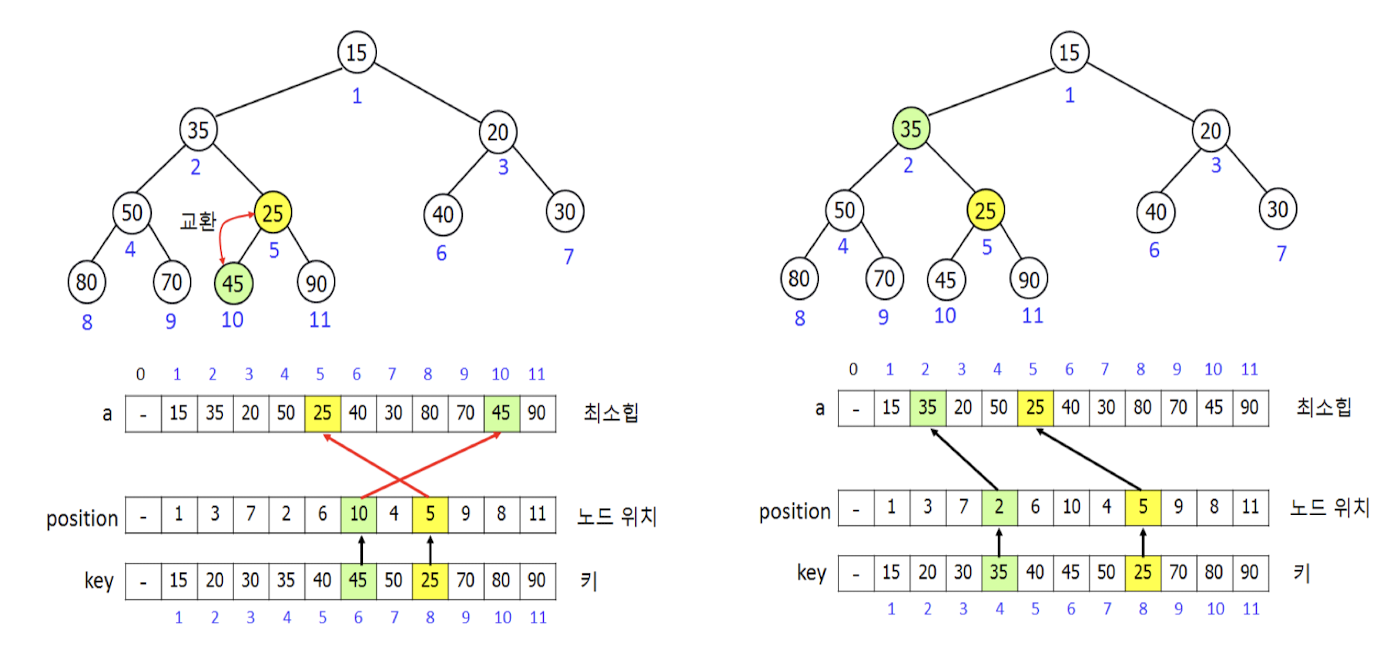
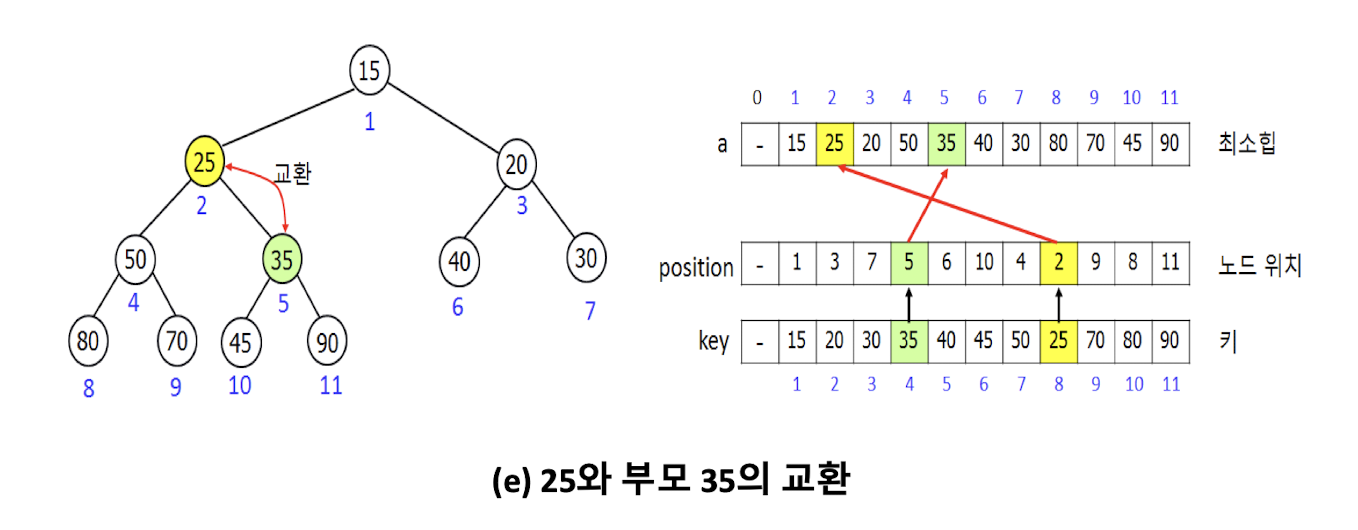
- key와 position 배열을 이용하여 노드를 탐색하여 키를 감소시킨 후, upheap을 수행하면서 힙 속성이 어긋나는 경우 부모 자식의 교환을 통해 힙 속성을 복원
- upheap을 수행하면서 부모 자식의 교환이 이루어지면 노드들의 힙에서의 위치가 바뀌므로 position 배열의 관련된 원소들도 갱신해야 함
ex) 60을 35만큼 감소
허프만 코딩
- 입력 파일의 문자 빈도수로 최소 힙을 이용하여 허프만 코드를 만들어 파일을 압축하고 나중에 복원하는 알고리즘
빈도수가 높은 문자에는 짧은 이진 코드(허프만 코드)를 부여하고, 빈도수가 낮은 문자에는 긴 이진 코드를 부여하여 압축 효율을 높인다.
허프만 압축
- 입력 파일을 스캔하여 각 문자의 빈도수를 계산하고,이 빈도수로 허프만 트리를 생성한 후, 트리에서 각 문자의 허프만 코드 추출
- 파일을 스캔하며 각 문자를 허프만 코드로 변환
허프만 트리 생성 알고리즘
- 입력 파일을 스캔하여 각 문자의 빈도수 계산
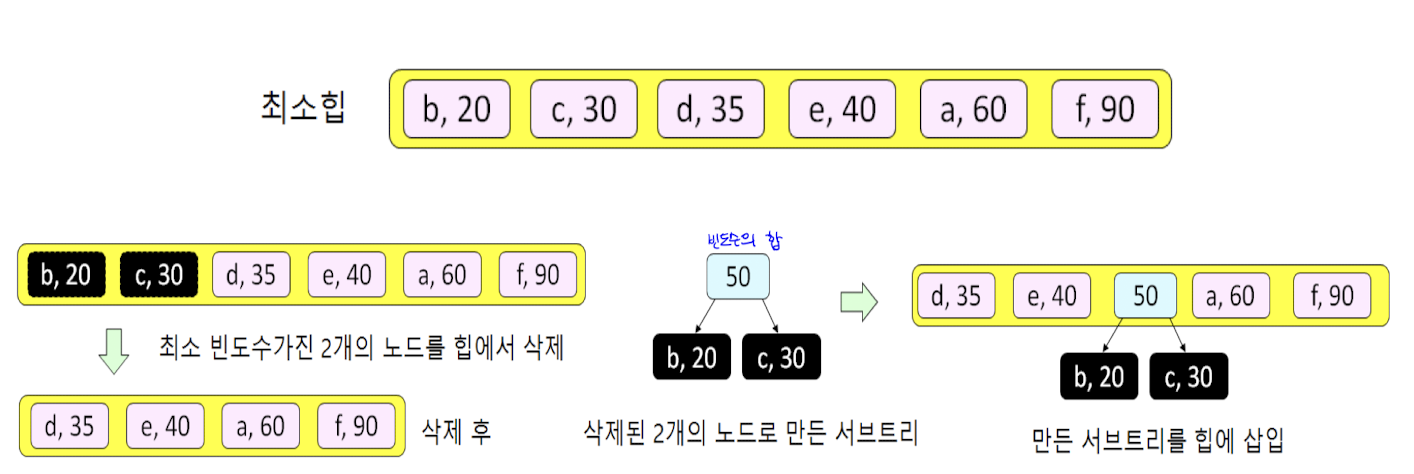
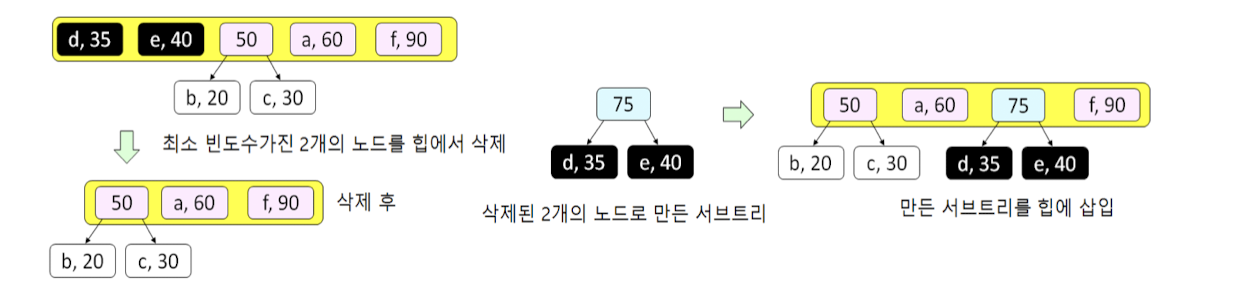
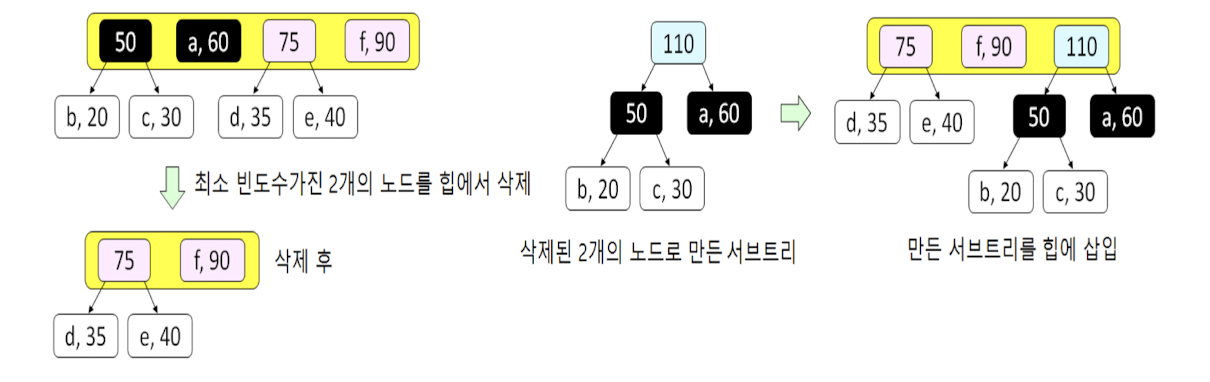
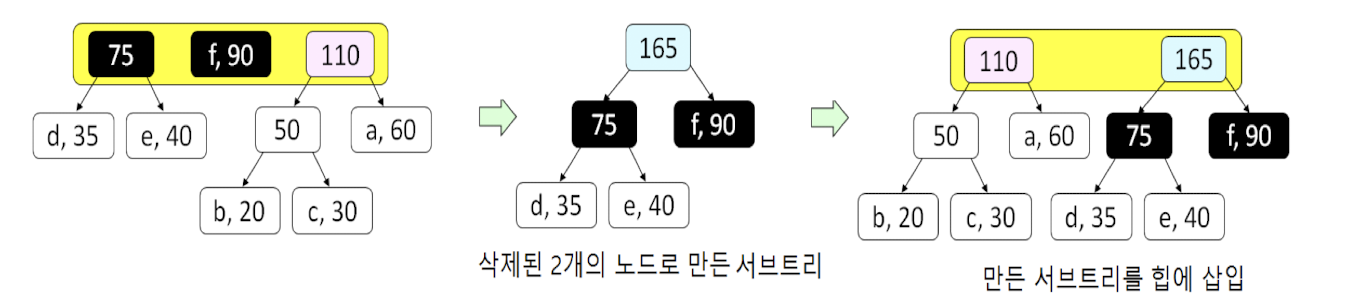
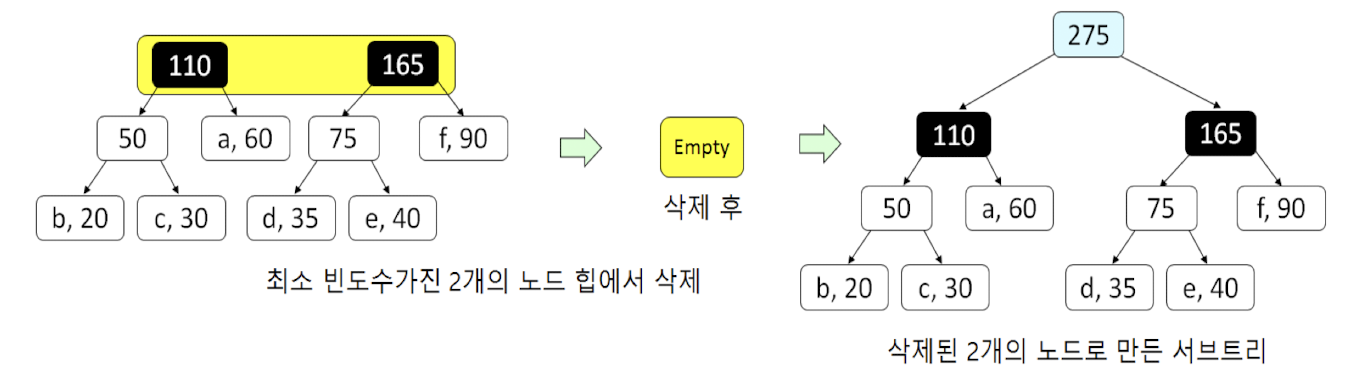
- 빈도수를 우선순위로 최소 힙 h를 구성
- while(힙의 크기 > 1)
e1 = h.delete_min();
e2 = h.delete_min();
t = new 항목(e1의 빈도수 + e2의 빈도수,
left = e1, right = e2);
h.insert(t); // 힙에 새로 만든 항목 삽입 - return h.delete_min();
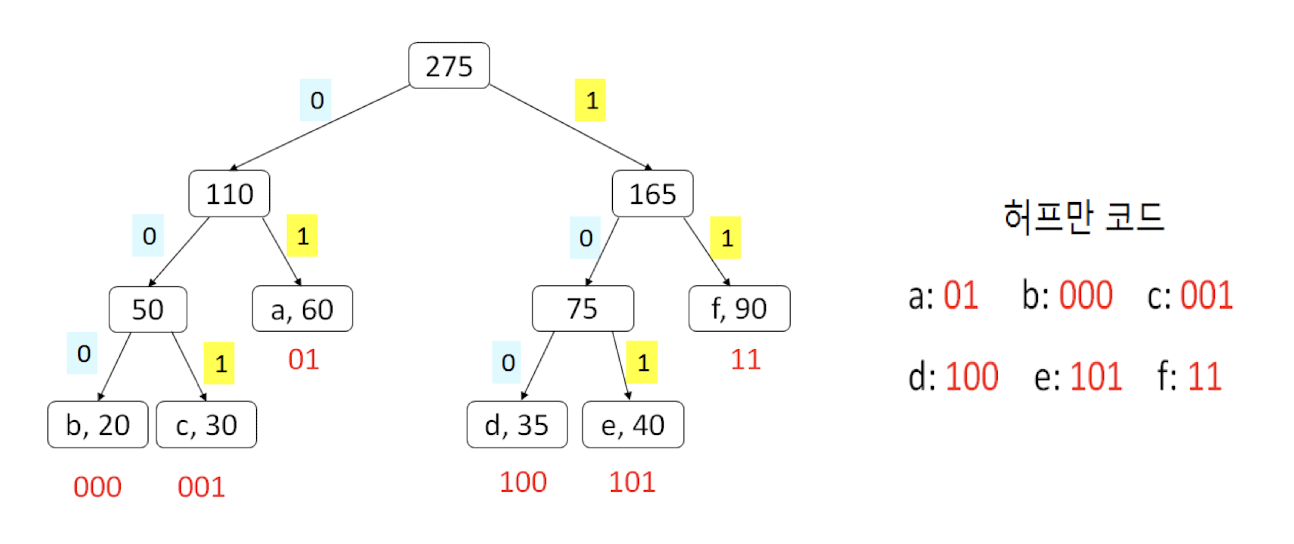
ex) 입력 파일이 6개의 문자 a, b, c, d, e, f로 구성되어 있고, 빈도수는 60, 20, 30, 35, 40, 90
허프만 코드
루트로부터 각 이파리로 내려가며 왼쪽으로 내려갈 땐 0, 오른쪽으로 내려갈 땐 1을 추가하면서 이파리에 있는 문자의 허프만 코드를 계산
- 접두어 속성
- 어떤 문자의 코드도 다른 문자의 코드의 접두어가 되지 않음
- a의 코드 00101, b의 코드 = 01
트리에서 루트로부터 a를 가진 이파리까니 내려가는 경로의 앞부분이 루트로부터 b를 가진 내부 노드로 가는 경로가 같음
- 허프만 트리에서는 내부 노드가 문자를 가질 수 없으므로 b가 001의 코드를 가질 수 없음
이것저것 학습 기록장