📌 개요
네이버 검색 Open API(뉴스)로 키워드 기반 기사 메타데이터를 수집하고, Streamlit UI에서 CSV로 즉시 다운로드하는 도구를 만들었습니다. 파일명/헤더 인코딩 이슈(
latin-1)까지 안전하게 처리한 버전입니다.
🚀 프로젝트 개요
- ✅ 공식 Open API로 뉴스 메타데이터 수집(제목/요약/링크/발행일)
- ✅ Streamlit UI: 키워드 입력 → 미리보기 → CSV 다운로드
- ✅ 헤더 이슈 제로:
data:URI 다운로드 방식으로latin-1인코딩 오류 근본 차단 - ✅ 안전한 키 관리:
.env+config.py - ✅ 검색 연산자 지원:
"정확일치",+반드시포함,-제외,A | B(OR) - ☑️ 확장 여지: 중복제거/날짜필터/Parquet·DB 저장/Scheduler/Docker
✅ 왜 Open API인가? (robots.txt/법/운영 관점)
- 뉴스 서비스는 robots.txt/이용약관이 엄격합니다. 임의 크롤링은 제한될 수 있어요.
- 네이버 검색 Open API(뉴스)를 사용하면 합법/안정적으로 검색 결과 메타데이터를 받을 수 있습니다.
- 본문 크롤링이 필요하면, 링크가 가리키는 원문 언론사 도메인의 정책을 별도로 확인해야 합니다.
✅ 기능 요약
- 키워드(한국어 OK)로 뉴스 검색 → 표 형태 미리보기(최대 1,000건)
- 중복 제거(
title + originallink기준) 옵션 - 날짜 필터(응답의
pubDate를 로컬에서 파싱) - CSV 다운로드 (브라우저 헤더 비사용:
data:URI) - 환경변수/
.env로 Client ID/Secret 안전 관리
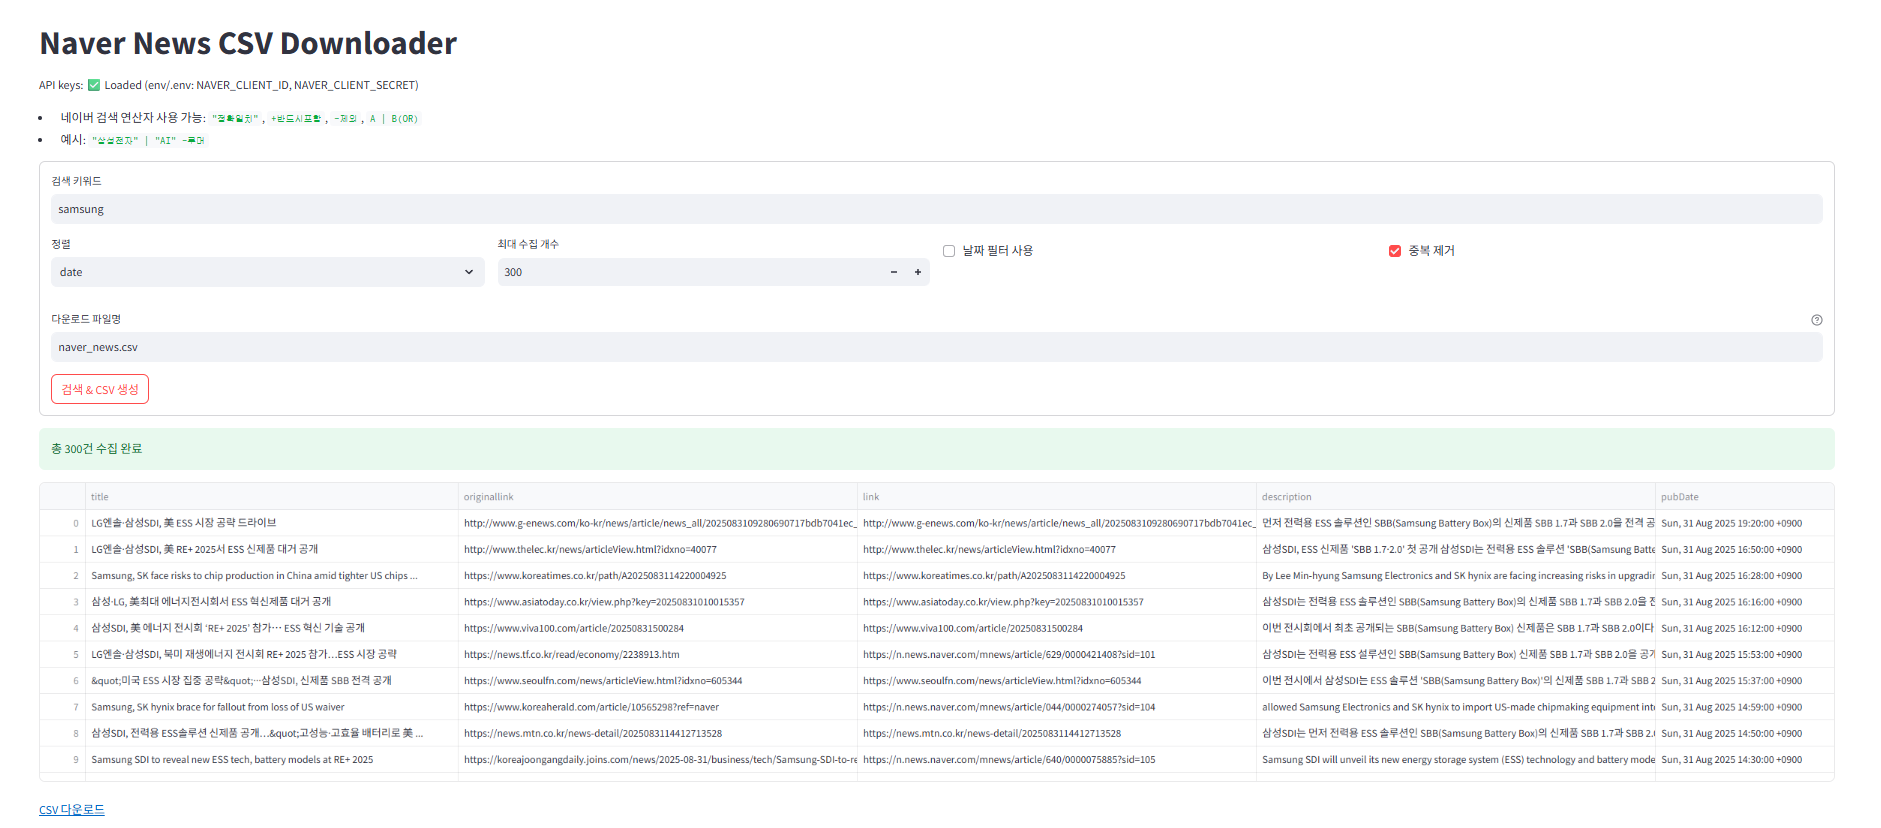
🖼️ 실행 화면
streamlit run app.py→ 브라우저에서 키워드 입력 → 표/다운로드 링크 표시
⚙️ 프로젝트 구조
web-crawler/
├─ app.py              # Streamlit UI (data-URI 다운로드 방식)
├─ config.py           # .env 로드 및 설정값 관리
├─ requirements.txt
└─ .env                # NAVER_CLIENT_ID / NAVER_CLIENT_SECRET (git ignore)
requirements.txt
streamlit==1.37.1
requests==2.32.3
python-dotenv==1.0.1
pandas==2.2.2
.env (루트에 생성, 커밋 금지)
NAVER_CLIENT_ID=여기_ID
NAVER_CLIENT_SECRET=여기_SECRET
MAX_ITEMS_DEFAULT=300
⚙️ config.py
from dataclasses import dataclass
import os
from dotenv import load_dotenv

load_dotenv()  # .env 로드

@dataclass
class Config:
    NAVER_CLIENT_ID: str = os.getenv("NAVER_CLIENT_ID", "")
    NAVER_CLIENT_SECRET: str = os.getenv("NAVER_CLIENT_SECRET", "")
    MAX_ITEMS_DEFAULT: int = int(os.getenv("MAX_ITEMS_DEFAULT", "300"))

cfg = Config()
필요하면 sanitize(허용문자만) 함수를 넣어 키에 섞인 제로폭 공백 등 특수문자를 제거할 수 있습니다.
⚙️ app.py (전체)
포인트:
requests.get(..., params=...)로 안전 인코딩,- CSV는
data:URI 링크로 다운로드(서버 헤더 미사용 →latin-1문제 근본 차단),- 파일명 ASCII 자동 치환.
# app.py  (data-URI download, safe for latin-1 environments)
import re
import time
import base64
import unicodedata
from datetime import datetime, date, timezone, timedelta
from typing import Optional, List, Dict, Any

import requests
import pandas as pd
import streamlit as st

from config import cfg  # NAVER_CLIENT_ID / NAVER_CLIENT_SECRET / MAX_ITEMS_DEFAULT

# ---------- Page ----------
st.set_page_config(page_title="Naver News CSV Downloader", layout="wide")
st.title("Naver News CSV Downloader")

# ---------- Utils ----------
def strip_tags(s: str) -> str:
    return re.sub(r"<.*?>", "", s or "")

def parse_pubdate(pub: str) -> Optional[datetime]:
    try:
        return datetime.strptime(pub, "%a, %d %b %Y %H:%M:%S %z")
    except Exception:
        return None

def make_safe_filename(name: str, default: str = "naver_news.csv") -> str:
    name = (name or "").split("/")[-1].split("\\")[-1]
    normalized = unicodedata.normalize("NFKD", name)
    ascii_only = "".join(ch for ch in normalized if 0 <= ord(ch) < 128)
    ascii_only = re.sub(r"[^A-Za-z0-9_.-]", "_", ascii_only)
    if not ascii_only.lower().endswith(".csv"):
        ascii_only += ".csv"
    return ascii_only or default

def fetch_news(query: str, client_id: str, client_secret: str,
               max_items: int = 300, sort: str = "date", sleep_sec: float = 0.25) -> List[Dict[str, Any]]:
    headers = {
        "X-Naver-Client-Id": client_id,
        "X-Naver-Client-Secret": client_secret,
        "User-Agent": "python-requests (naver-news)"
    }
    rows: List[Dict[str, Any]] = []
    start, display = 1, 100  # display 최대 100

    while len(rows) < max_items and start <= 1000:
        params = {"query": query, "display": display, "start": start, "sort": sort}
        r = requests.get("https://openapi.naver.com/v1/search/news.json",
                         headers=headers, params=params, timeout=15)
        if r.status_code != 200:
            raise RuntimeError(f"API error: status={r.status_code}")

        items = r.json().get("items", [])
        if not items:
            break

        for it in items:
            rows.append({
                "title": strip_tags(it.get("title")),
                "originallink": it.get("originallink"),
                "link": it.get("link"),
                "description": strip_tags(it.get("description")),
                "pubDate": it.get("pubDate"),
            })
            if len(rows) >= max_items:
                break

        start += display
        time.sleep(sleep_sec)
    return rows

def dedupe(rows, key=("title", "originallink")):
    seen, out = set(), []
    for r in rows:
        k = tuple(r.get(k) for k in key)
        if k not in seen:
            seen.add(k)
            out.append(r)
    return out

# ---------- API Key State ----------
api_ready = bool(cfg.NAVER_CLIENT_ID and cfg.NAVER_CLIENT_SECRET)
st.markdown(
    f"API keys: {'✅ Loaded' if api_ready else '❌ Missing'}  "
    "(env/.env: NAVER_CLIENT_ID, NAVER_CLIENT_SECRET)"
)

st.markdown(
    """
- 네이버 검색 연산자 사용 가능: `"정확일치"`, `+반드시포함`, `-제외`, `A | B(OR)`
- 예시: `"삼성전자" | "AI" -루머`
"""
)

# ---------- Form ----------
with st.form("search_form"):
    query = st.text_input("검색 키워드", placeholder='"삼성전자" | "AI" -루머', value="samsung")
    c1, c2, c3, c4 = st.columns([1,1,1,1])
    with c1:
        sort = st.selectbox("정렬", options=["date", "sim"], index=0)
    with c2:
        max_items = st.number_input("최대 수집 개수", min_value=1, max_value=1000,
                                    value=int(cfg.MAX_ITEMS_DEFAULT), step=50)
    with c3:
        do_filter_date = st.checkbox("날짜 필터 사용", value=False)
    with c4:
        do_dedupe = st.checkbox("중복 제거", value=True)

    d1, d2 = st.columns(2)
    start_date = end_date = None
    if do_filter_date:
        with d1:
            start_date = st.date_input("시작일", value=date.today())
        with d2:
            end_date = st.date_input("종료일", value=date.today())
            if end_date < start_date:
                st.warning("종료일이 시작일보다 이전입니다. 자동으로 교환합니다.")
                start_date, end_date = end_date, start_date

    filename = st.text_input("다운로드 파일명", value="naver_news.csv",
                             help="영문/숫자/_.- 권장 (한글은 자동 치환)")

    submitted = st.form_submit_button("검색 & CSV 생성")

# ---------- Submit ----------
if submitted:
    if not api_ready:
        st.error("API 키를 설정하세요. (NAVER_CLIENT_ID / NAVER_CLIENT_SECRET)")
        st.stop()
    if not query.strip():
        st.error("검색 키워드를 입력하세요.")
        st.stop()

    try:
        with st.spinner("뉴스 검색 중..."):
            rows = fetch_news(
                query=query,
                client_id=cfg.NAVER_CLIENT_ID,
                client_secret=cfg.NAVER_CLIENT_SECRET,
                max_items=int(max_items),
                sort=sort,
            )

        if do_dedupe:
            rows = dedupe(rows, key=("title", "originallink"))

        if do_filter_date and (start_date and end_date):
            sdt = datetime.combine(start_date, datetime.min.time()).replace(tzinfo=timezone(timedelta(hours=9)))
            edt = datetime.combine(end_date, datetime.max.time()).replace(tzinfo=timezone(timedelta(hours=9)))
            rows = [r for r in rows if (dt:=parse_pubdate(r.get("pubDate"))) and sdt <= dt <= edt]

        if not rows:
            st.warning("조건에 맞는 결과가 없습니다.")
            st.stop()

        df = pd.DataFrame(rows, columns=["title","originallink","link","description","pubDate"])
        st.success(f"총 {len(df):,}건 수집 완료")
        st.dataframe(df.head(50), use_container_width=True)

        # ---- Download via data URI (no HTTP header -> no latin-1 issue) ----
        csv_bytes = df.to_csv(index=False).encode("utf-8-sig")  # Excel 호환
        b64 = base64.b64encode(csv_bytes).decode("ascii")
        safe_name = make_safe_filename(filename)
        st.markdown(
            f'<a href="data:text/csv;charset=utf-8;base64,{b64}" download="{safe_name}">CSV 다운로드</a>',
            unsafe_allow_html=True
        )

    except Exception as e:
        msg = (str(e).encode("ascii", "ignore").decode("ascii")) or "unknown"
        st.error(f"Error: {msg}")
⚙️ API Health Check (최소 테스트)
UI 붙이기 전에 키/호출이 진짜 되는지 먼저 확인!
# test_api_min.py
import os, requests
from dotenv import load_dotenv
load_dotenv()

cid = os.getenv("NAVER_CLIENT_ID")
sec = os.getenv("NAVER_CLIENT_SECRET")

headers = {
  "X-Naver-Client-Id": cid,
  "X-Naver-Client-Secret": sec,
  "User-Agent": "python-requests (naver-news-test)"
}
params = {"query": "samsung", "display": 3, "start": 1, "sort": "date"}

r = requests.get("https://openapi.naver.com/v1/search/news.json",
                 headers=headers, params=params, timeout=15)

print("STATUS:", r.status_code)
if r.status_code != 200:
    print("BODY:", r.text[:500])
else:
    data = r.json()
    print("ITEMS:", len(data.get("items", [])))
    for i, it in enumerate(data.get("items", []), 1):
        print(f"{i}. {it.get('title')}")
🐛 트러블슈팅 (특히 Windows/브라우저 조합)
Error: 'latin-1' codec can't encode characters ...- 원인: HTTP 응답 헤더(
Content-Disposition)가 비ASCII(한글/이모지) 파일명을 처리 못할 때 발생. - 해결: 본 글의 data URI 다운로드 방식은 서버 헤더를 쓰지 않기 때문에 이 문제가 원천 차단됩니다.
- 추가 팁: 파일명은 ASCII 자동 치환(
make_safe_filename).
- 원인: HTTP 응답 헤더(
- 401/403: 키/앱 설정 확인(네이버 개발자센터에서 검색 API 추가, 키 오타/공백 제거)
- 429: 호출 한도 초과(검색 API 전체 25,000회/일)
- 키 로딩 실패:
.env경로/파일 인코딩/IDE 실행 경로 확인,python-dotenv로드 확인
🚀 확장 아이디어
- 🔁 스케줄링: GitHub Actions/크론으로 정기 수집 + S3 업로드
- 🧹 정제/중복 관리: 정규화 후 Parquet 저장 → Pandas/Polars/duckdb 분석
- 🧩 키워드 세트: 여러 키워드 배치 수집 + 결과 병합
- 📊 대시보드: Streamlit/Metabase/Superset으로 시간대별 기사량/키워드 트렌드 시각화
- 🧪 본문 분석: (허용 범위 내) 원문 페이지 텍스트 추출 → 토픽 모델링/키워드 추출
✅ 주의 사항
- 이 도구는 메타데이터 수집 용도입니다. 본문 수집/재배포는 각 언론사 약관·저작권을 반드시 확인하세요.
- 서비스 운영 시 레이트리밋/에러 재시도/로그 정책을 추가하세요.
🚀 마무리
- 실무에서 필요한 키워드 기반 기사 수집 + CSV 워크플로를 빠르게 만들 수 있습니다.
- 동일 패턴으로 다른 검색 API/데이터 소스에도 쉽게 확장 가능합니다.
✅ 참고
Java 개발자 | 사이드 프로젝트 마니아 | GPT 기반 자동화 툴 연구 중 기술 리뷰, 개발일지