과대적합과 과소적합
1.머신러닝의 근본적인 이슈는?
-
최적화와 일반화 사이
: 최적화란, 가능한 훈련 데이터에서 최고의 성능을 얻기 위해 모델을 조정
: 일반화란, 훈련된 모델이 이전 본적없는 데이터에서 얼마나 잘 수행되었는지 의미 -
과소적합과 과대적합
: 과소적합이란, 훈련 데이터의 손실이 낮아질 수록 테스트 손실이 낮아짐
: 과대적합이란, 훈련데이터에 특화된 패턴을 학습해서 훈련데이터 결과와 다르게 검증세트의 성능이 멈추고 감소하기 시작함 -
해결법
- 더 많은 훈련 데이터를 모으는 것
- 정보의 양을 조절하거나, 저장할 수 있는 정보에 제약을 가하는 것 (현실적)
2. 과대적합 예방법
1.네트워크 크기 축소
- 학습 파라미터의 수를 줄이는 것 (모델의 수 줄이는 것)
- 검증 손실이 감소할 때까지 층이나 유닛의 수를 늘리는 것
: 데이터에 알맞은 모델의 크기를 찾기 위해서는 각기 다른 구조를 평가해야한다. - 용량이 큰 네트워크는 더 빠르게 훈련데이터를 모델링 할 수 있지만, 과대적합에 민감해진다.
예시
1.작은 네트워크

2.큰 네트워크
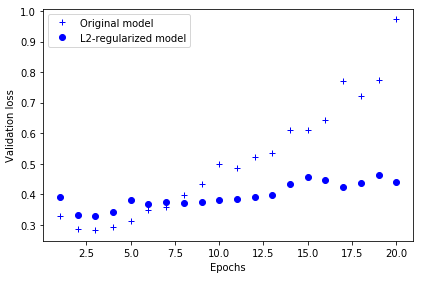
2.가중치 규제 추가
간단한 모델이 복잡한 모델보다 과대적합이 될 가능성이 높다.
간단한 모델이란, 파라미터 값 분포의 엔트로피가 작은 모델이다.
따라서 네트워크의 복잡도에 제한을 두어서 가중치가 작은 값을 가지도록 강제해야한다.
- 가중치 규제
: 가중치의 값을 균일화시켜서, 가중치가 작은 값을 가지도록 강제하는 것이다. - 가중치 규제 종류
1.L1 규제 : 가중치의 절댓값에 비례하는 비용 추가
2.L2 규제 : 가중치의 제곱에 비례하는 비용 추가, 가중치 감쇠
3.드롭아웃 추가
신경망을 위해서 사용이 되는 규제 중에서,가장 효과적이고 널리사용되는 방법이다.
학습과정에서 신경망의 일부를 사용하지 않는 방법이다.
훈련하는동안 무작위 층의 일부 출력 특성을 제외시킨다.
-
예시
: 드롭아웃의 비율 =0.5
: 학습 과정마다 랜덤으로 절반의 뉴런을 사용하지 않고 절반의 뉴런만을 사용 -
특징
: 신경망 학습시에만 사용하고, 예측 시에는 사용하지 않는 것이 일반적
: 학습시에 인공 신경망이 특정 뉴런에 의존되는 것을 방지
: 매번의 랜덤 선택(앙상블 효과)
: 드롭아웃 적용시, 벡터 일부가 무작위로 0으로 바뀜
: 각 샘플에 대해서 뉴런의 일부를 무작위하게 제거하면 뉴런의 부정한 협업을 방지하고 과대적합을 감소
출처
https://wikidocs.net/61374
https://github.com/gilbutITbook/006975/blob/master/4.4-overfitting-and-underfitting.ipynb