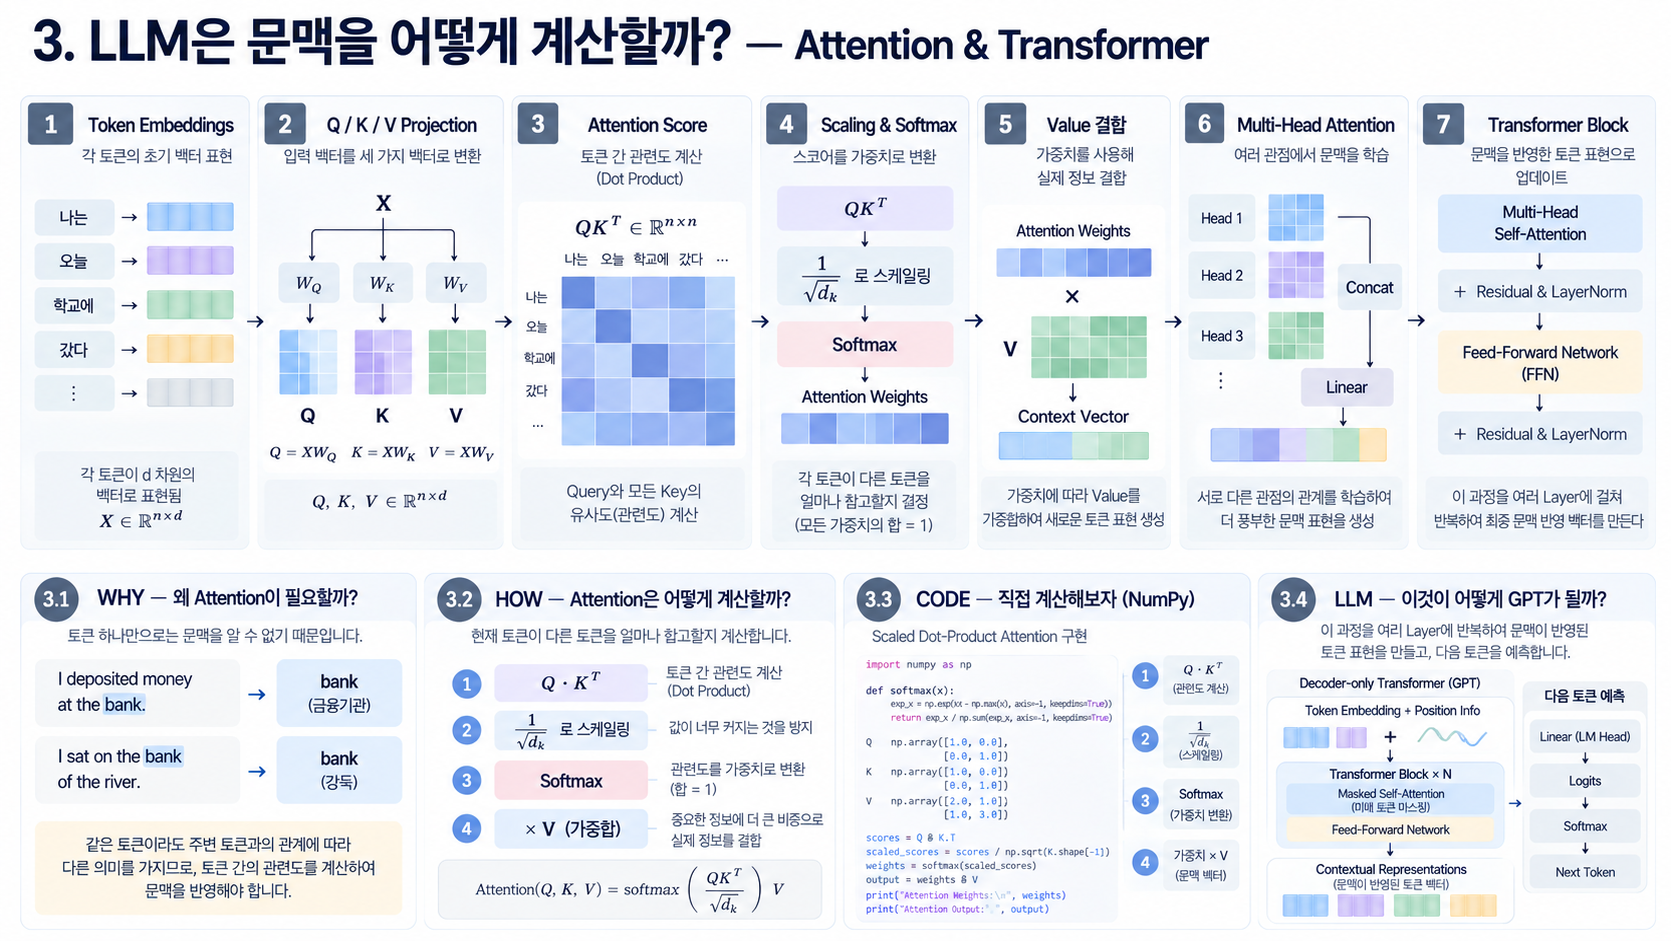
3. LLM은 문맥을 어떻게 계산할까? — Attention & Transformer
지금까지 우리는 LLM의 전체 흐름에서 두 단계를 지나왔다.
Language → Number → Context → Generation
───────────────
   여기까지
1편에서는 Vector, Matrix, Tensor, Dot Product, Softmax를 통해 LLM이 숫자를 어떻게 계산하는지 살펴봤다.
2편에서는:
Text
 ↓
Tokenization
 ↓
Token ID
 ↓
Embedding
 ↓
Token Vector
를 따라가며 Language가 Number로 변환되는 과정을 살펴봤다.
이제 문장은 숫자가 되었다.
예를 들어:
나는 → [0.21, -0.13, 0.72, ...]
오늘 → [0.44,  0.31, 0.08, ...]
학교 → [0.17, -0.52, 0.63, ...]
갔다 → [0.71,  0.19, 0.22, ...]
그런데 여기서 문제가 하나 남아 있다.
Vector가 되었다고 해서 문맥을 이해한 것은 아니다.
다음 두 문장을 보자.
I deposited money at the bank.

I sat on the bank of the river.
두 문장의 bank는 같은 표현이지만 의미는 다르다.
bank라는 Token 하나만 보는 것으로는 어떤 의미인지 결정하기 어렵다.
주변에 money, deposited가 있는지,
아니면 river, sat이 있는지를 함께 봐야 한다.
즉 LLM에는 다음 과정이 필요하다.
Token Vector
      ↓
다른 Token과의 관계 계산
      ↓
Context 반영
      ↓
Contextual Representation
이번 글은 README의 전체 흐름에서 바로 이 구간을 다룬다.
Language → Number → Context → Generation
           └───────┘
            이번 글
그리고 이번에도 같은 방식으로 기술을 분해한다.
WHY
왜 Token 사이의 관계를 계산해야 할까?

        ↓

HOW
Attention은 그 관계를 어떻게 계산할까?

        ↓

CODE
Q · Kᵀ → Scale → Softmax → V를 직접 계산해보자.

        ↓

LLM
이 연산은 어떻게 Transformer와 GPT가 될까?
3.0 WHY — Vector만으로는 왜 문맥을 알 수 없을까?
2편에서 Token ID를 Embedding Matrix에 넣어 Token Vector를 얻었다.
Token
 ↓
Token ID
 ↓
Embedding Matrix
 ↓
Token Embedding
하지만 Token Embedding은 Transformer가 문맥 계산을 시작하기 위한 초기 표현이다.
문장을 하나 보자.
나는 오늘 학교에서 친구를 만났다."만났다"를 이해하려면 주변 Token과의 관계가 필요하다.
나는
 │
오늘 ─────┐
 │        │
학교에서 ─┤
 │        │
친구를 ───┼──→ 만났다
누가 만났는가?
→ 나는
누구를 만났는가?
→ 친구를
어디에서 만났는가?
→ 학교에서
언제 만났는가?
→ 오늘
즉 문맥은 Token 하나 안에 독립적으로 존재하는 것이 아니라 Token 사이의 관계에서 만들어진다.
따라서 다음 문제가 생긴다.
하나의 Token이 다른 Token 중 어떤 정보를 얼마나 참고해야 할까?
Attention은 이 질문을 해결하기 위한 핵심 메커니즘이다.
3.1 WHY — Attention 이전에는 Sequence를 어떻게 처리했을까?
Attention의 필요성을 이해하려면 먼저 기존 Sequence Model을 간단히 살펴볼 필요가 있다.
Transformer 이전에는 자연어처럼 순서가 있는 데이터를 처리하기 위해 RNN(Recurrent Neural Network) 계열 모델이 널리 사용되었다.
RNN은 Sequence를 순서대로 처리한다.
나는 → 오늘 → 학교에 → 갔다각 시점에서는 현재 입력뿐 아니라 이전 시점의 정보를 담은 Hidden State를 전달받는다.
x₁ → h₁
      │
      ▼
x₂ → h₂
      │
      ▼
x₃ → h₃
      │
      ▼
x₄ → h₄
개념적으로:
현재 입력
   +
이전까지의 정보
   ↓
새로운 Hidden State
를 반복하는 구조다.
이 방식은 Sequence 정보를 다루는 데 유용했지만 구조적인 제약도 있었다.
Sequential Processing
앞의 계산 결과가 다음 계산에 필요하다.
h₁ → h₂ → h₃ → h₄따라서 Sequence의 여러 위치를 완전히 독립적으로 한 번에 계산하기 어렵다.
Long-range Dependency
Sequence가 길어질수록 멀리 떨어진 정보 사이의 관계를 효과적으로 유지하고 학습하는 것이 어려워질 수 있다.
철수가 어제 도서관에서 빌린 책을
친구에게 보여준 뒤 집으로 돌아와서
저녁에 그것을 읽었다.
↑                               ↑
멀리 떨어진 관계
LSTM과 GRU 같은 구조는 이러한 문제를 완화하기 위해 등장했다.
하지만 여기서 관점을 바꿔볼 수 있다.
정보를 계속 순서대로 전달하지 않고, 현재 Token이 필요한 Token을 직접 참고하게 할 수는 없을까?
이 질문에서 Attention의 핵심 아이디어를 이해할 수 있다.
3.2 HOW — Attention: 어떤 Token을 얼마나 볼 것인가?
다음 문장을 보자.
나는 어제 도서관에서 빌린 책을 오늘 반납했다."반납했다"의 표현을 만들 때 모든 Token의 정보가 동일하게 중요할 필요는 없다.
개념적으로:
나는        ── 낮은 관련도
어제        ── 관련
도서관에서  ── 관련
빌린        ── 높은 관련도
책을        ── 높은 관련도
오늘        ── 관련
반납했다    ← 현재 위치
Attention은 각 Token과 다른 Token 사이의 관련도를 계산하고, 그 결과를 이용해 필요한 정보를 서로 다른 비중으로 결합한다.
전체 아이디어는 다음과 같다.
Token A와 Token B의 관계
          ↓
        Score
          ↓
        Weight
          ↓
중요한 정보에 더 큰 비중
          ↓
새로운 Token Representation
즉 Attention을 한 문장으로 압축하면:
현재 Token의 표현을 만들 때 다른 Token의 정보를 얼마나 참고할지 계산하는 메커니즘
이라고 볼 수 있다.
그렇다면 모델은 Token 사이의 관련도를 어떻게 계산할까?
여기서 Query, Key, Value가 등장한다.
3.3 HOW — Query, Key, Value는 왜 필요할까?
입력 Token Representation을 (X)라고 하자.
Attention에서는 하나의 입력 표현으로부터 세 종류의 Vector를 만든다.
[
Q = XW_Q
]
[
K = XW_K
]
[
V = XW_V
]
여기서:
- (W_Q) = Query Projection Weight
- (W_K) = Key Projection Weight
- (W_V) = Value Projection Weight
이며 모두 학습 가능한 Weight Matrix다.
구조로 보면:
              X
        ┌─────┼─────┐
        ↓     ↓     ↓
       WQ    WK    WV
        ↓     ↓     ↓
        Q     K     V
왜 같은 Token에서 굳이 세 Vector를 만들까?
역할이 다르기 때문이다.
Query
현재 Token이 어떤 정보를 찾고 있는지를 나타내는 역할로 이해할 수 있다.
Query
"나는 어떤 정보와 관련되어 있는가?"
Key
각 Token이 Query와 얼마나 관련되는지 비교하기 위한 표현이다.
Query ↔ Key
       ↓
   Relation Score
Value
Attention Weight가 결정된 후 실제로 가져와 결합할 정보다.
Attention Weight
       ×
     Value
       ↓
실제 전달되는 정보
직관적으로 정리하면:
Q : 무엇을 찾을 것인가?

K : 나와 얼마나 관련 있는가?

V : 선택되면 어떤 정보를 전달할 것인가?
다만 이 표현은 이해를 위한 직관이다.
실제로 Q, K, V가 사람이 직접 정의한 질문·키워드·내용인 것은 아니다.
모두 입력 Vector에 학습된 Matrix를 곱해 만들어지는 Vector Representation이다.
3.4 HOW — Dot Product가 Attention Score가 된다
이제 1편에서 배운 Dot Product가 다시 등장한다.
두 Vector (a), (b)의 Dot Product는:
[
a \cdot b
]
였다.
여러 차원의 두 Vector 관계를 하나의 Scalar 값으로 만들 수 있었다.
Attention에서는 이 연산을 Query와 Key 사이에 사용한다.
[
QK^T
]
예를 들어 "반납했다"의 Query가 다른 Token의 Key와 비교된다고 생각해보자.
Query("반납했다")

      │
      ├── Key("나는")       → 0.8
      │
      ├── Key("도서관")     → 1.4
      │
      ├── Key("책")         → 4.7
      │
      └── Key("오늘")       → 2.1
이 값들이 Attention Score의 기반이 된다.
즉 1편에서 배웠던:
Vector A · Vector B
        ↓
Scalar
        ↓
Vector 관계 표현
이 Transformer에서는:
Query · Key
     ↓
Attention Score
로 사용되는 것이다.
그래서 Dot Product를 먼저 배웠던 이유가 여기서 드러난다.
3.5 HOW — 왜 √dₖ로 나눌까?
Attention에서는 Dot Product 결과를 바로 Softmax에 넣지 않는다.
Query와 Key의 차원을 (d_k)라고 할 때:
[
\frac{QK^T}{\sqrt{d_k}}
]
처럼 Scaling을 수행한다.
왜 필요할까?
Vector의 차원이 커지면 Dot Product 값의 크기도 커질 수 있다.
지나치게 큰 값들이 Softmax에 들어가면 출력 분포가 매우 뾰족해질 수 있고, 학습 과정에서 Gradient가 지나치게 작아지는 구간이 생길 수 있다.
따라서 Dot Product 값을 적절한 범위로 조정한다.
Q · Kᵀ
   ↓
큰 Score가 만들어질 수 있음
   ↓
÷ √dₖ
   ↓
Scaled Attention Score
그래서 이 연산을 Scaled Dot-Product Attention이라고 부른다.
3.6 HOW — Softmax: Score를 Weight로 바꾼다
Scaling까지 했지만 아직 값은 단순한 Score다.
예를 들어:
나는        0.8
도서관      1.4
책          4.7
오늘        2.1
이 Score를 상대적인 Attention Weight로 바꾸기 위해 Softmax를 사용한다.
Attention Scores
       ↓
    Softmax
       ↓
Attention Weights
개념적으로:
나는        0.02
도서관      0.04
책          0.82
오늘        0.12
           ────
           1.00
처럼 합이 1인 분포가 만들어진다.
따라서:
Q · Kᵀ
   ↓
Scaling
   ↓
Softmax
   ↓
Attention Weight
가 된다.
여기서도 1편에서 배운 Softmax가 그대로 돌아왔다.
1편에서는:
Scores
 ↓
Softmax
 ↓
Probability-like Distribution
을 배웠고,
Attention에서는:
Attention Scores
 ↓
Softmax
 ↓
Attention Weights
로 사용된다.
3.7 HOW — Value: 실제로 어떤 정보를 가져올까?
이제 어떤 Token을 얼마나 참고할지 결정했다.
다음 단계는 그 Token에서 실제 정보를 가져오는 것이다.
여기서 Value가 사용된다.
Attention Weight × Value예를 들어:
0.02 × V("나는")

0.04 × V("도서관")

0.82 × V("책")

0.12 × V("오늘")
를 계산한 뒤 모두 합한다.
수식으로는:
[
Output = \sum_i \alpha_i V_i
]
여기서 (\alpha_i)는 각 Token의 Attention Weight다.
따라서 Q/K/V의 역할을 다시 정리하면:
Query + Key
     ↓
얼마나 참고할 것인가?

Value
     ↓
무슨 정보를 가져올 것인가?
이제 Attention의 전체 구조를 조립할 수 있다.
3.8 HOW — Scaled Dot-Product Attention을 조립해보자
처음부터 Attention 공식을 외우는 대신 지금까지 만든 연산을 하나씩 합쳐보자.
Step 1. Query와 Key의 관계를 계산한다
[
QK^T
]
Query
  ×
Key
  ↓
Attention Score
Step 2. Score를 Scaling한다
[
\frac{QK^T}{\sqrt{d_k}}
]
Attention Score
      ↓
    Scale
      ↓
Scaled Score
Step 3. Softmax로 Weight를 만든다
[
softmax\left(\frac{QK^T}{\sqrt{d_k}}\right)
]
Scaled Score
     ↓
  Softmax
     ↓
Attention Weight
Step 4. Value를 결합한다
[
softmax\left(\frac{QK^T}{\sqrt{d_k}}\right)V
]
결국:
[
\boxed{
Attention(Q,K,V)
softmax\left(
\frac{QK^T}{\sqrt{d_k}}
\right)V
}
]
가 된다.
하지만 중요한 것은 공식을 암기하는 것이 아니다.
이 식은 결국:
관계를 계산하고
      ↓
Score 크기를 조정하고
      ↓
상대적 Weight를 만들고
      ↓
필요한 정보를 결합한다
라는 네 단계의 연산을 하나로 표현한 것이다.
3.9 HOW — Self-Attention은 무엇이 다를까?
Attention 중에서도 Transformer의 핵심은 Self-Attention이다.
Self-Attention에서는 같은 Sequence의 Token Representation들로부터 Q, K, V를 만든다.
              X
        ┌─────┼─────┐
        ↓     ↓     ↓
       WQ    WK    WV
        ↓     ↓     ↓
        Q     K     V
         \    │    /
          Attention
              ↓
       Updated Tokens
예를 들어:
나는 / 오늘 / 학교에서 / 친구를 / 만났다라는 Sequence가 있다면 각 Token은 다른 Token을 참고할 수 있다.
나는 ───────────────┐
오늘 ───────────┐   │
학교에서 ────┐  │   │
친구를 ──────┼──┼───┤
             ↓
           만났다
그리고 이 계산은 "만났다" 하나에만 이루어지는 것이 아니다.
Sequence의 모든 Token 위치에서 수행된다.
3.10 HOW — Attention Matrix: 모든 관계를 한 번에 계산한다
Token이 네 개 있다고 해보자.
나는 / 오늘 / 학교 / 갔다각 Token이 다른 모든 Token과 관계를 계산하면 개념적으로 다음과 같은 Matrix를 만들 수 있다.
           Key

          나는   오늘   학교   갔다

Query 나는  0.1    0.2    0.2    0.5

      오늘  0.1    0.5    0.1    0.3

      학교  0.2    0.1    0.5    0.2

      갔다  0.2    0.2    0.5    0.1
행은 Query 위치,
열은 Key 위치를 나타낸다고 생각할 수 있다.
Token 수가 (n)이면 Token 간 관계는 기본적으로:
[
n \times n
]
형태의 Attention Matrix로 표현된다.
여기서 1편의 Matrix 연산이 실제 Transformer 계산과 연결된다.
그리고 동시에 한 가지 문제도 보이기 시작한다.
Sequence Length 증가
       ↓
Attention Matrix 증가
       ↓
계산량과 Memory 사용 증가
기본적인 Self-Attention의 Score Matrix 계산은 Sequence Length에 대해 (O(n^2)) 규모로 커진다.
긴 Context를 효율적으로 처리하는 것이 현대 LLM에서 중요한 연구 주제인 이유 중 하나다.
3.11 HOW — GPT는 미래 Token을 보면 안 된다: Causal Mask
여기서 일반적인 Self-Attention과 GPT의 Attention 사이에 중요한 차이가 생긴다.
GPT는 다음 Token을 예측하는 Autoregressive Language Model이다.
예를 들어:
나는 오늘 학교에 ___다음 Token을 예측해야 하는데 학습 중 정답이 되는 미래 Token을 미리 참고하면 문제가 된다.
따라서 미래 위치에 대한 Attention을 막는다.
          나는   오늘   학교   갔다

나는       ✓      X      X      X

오늘       ✓      ✓      X      X

학교       ✓      ✓      ✓      X

갔다       ✓      ✓      ✓      ✓
이를 Causal Mask라고 한다.
따라서 각 위치에서는:
Token 1 → Token 1

Token 2 → Token 1, 2

Token 3 → Token 1, 2, 3

Token 4 → Token 1, 2, 3, 4
까지만 볼 수 있다.
이 구조 덕분에 GPT는:
이전 Tokens
    ↓
현재 Context Representation
    ↓
다음 Token 예측
이라는 Autoregressive Generation 구조를 유지할 수 있다.
Attention이 이제 Next Token Prediction과 직접 연결되기 시작한다.
3.12 HOW — Multi-Head Attention: 하나의 관계만 보면 충분할까?
지금까지는 하나의 Attention 연산만 생각했다.
하지만 언어에는 다양한 관계가 존재한다.
예를 들어:
나는 오늘 학교에서 친구를 만났다."만났다"는 여러 Token과 서로 다른 방식으로 관련될 수 있다.
직관적으로 생각하면:
만났다 ↔ 친구
       대상과의 관계

만났다 ↔ 오늘
       시간과의 관계

만났다 ↔ 학교
       장소와의 관계
하나의 Attention Head만 사용하는 대신 여러 개의 Head를 사용해 서로 다른 Projection 공간에서 관계를 계산할 수 있다.
                 Input
                   │
       ┌───────────┼───────────┐
       ↓           ↓           ↓
     Head 1      Head 2      Head 3
       ↓           ↓           ↓
   Attention   Attention   Attention
       └───────────┼───────────┘
                   ↓
                 Concat
                   ↓
           Linear Projection
이를 Multi-Head Attention이라고 한다.
각 Head는 서로 다른 (W_Q), (W_K), (W_V) Projection을 사용한다.
따라서 같은 입력을 보더라도 서로 다른 표현 공간에서 Token 관계를 계산할 수 있다.
다만 여기서 주의해야 한다.
Head 1은 문법, Head 2는 시간, Head 3은 장소를 담당한다는 식으로 고정된 역할이 사전에 지정되는 것은 아니다.
이런 예시는 Multi-Head의 직관을 설명하기 위한 것이다.
실제로 각 Head가 학습하는 패턴은 학습 과정에서 결정된다.
3.13 HOW — Attention만으로 Transformer가 완성될까?
여기까지 보면:
Attention = Transformer처럼 생각하기 쉽다.
하지만 Transformer Block에는 Attention 외에도 중요한 구성 요소들이 있다.
개념적으로 단순화하면:
Input
  │
  ▼
Multi-Head Self-Attention
  │
  ▼
Residual Connection
  │
  ▼
Normalization
  │
  ▼
Feed-Forward Network
  │
  ▼
Residual Connection
  │
  ▼
Normalization
  │
  ▼
Output
실제 모델에 따라 LayerNorm의 위치 등 세부 구조는 달라질 수 있지만, 핵심 구성 요소를 이해하기에는 이 흐름이 중요하다.
3.14 HOW — Residual Connection: 기존 정보를 버리지 않는다
Transformer처럼 Layer가 깊어지면 각 Layer에서 계속 새로운 변환이 이루어진다.
이때 입력 정보를 바로 버리는 대신 변환 결과에 원래 입력을 더해주는 구조를 사용할 수 있다.
x ──────────────────┐
│                   │
▼                   │
Attention           │
│                   │
▼                   │
Output ─────────────┤
                    ▼
                    +
개념적으로:
[
y = x + F(x)
]
이다.
이를 Residual Connection 또는 Skip Connection이라고 한다.
Residual Connection은 깊은 Network의 학습을 돕고 원래 Representation이 다음 Layer로 전달될 수 있는 경로를 제공한다.
3.15 HOW — Layer Normalization: Representation을 안정적으로 다룬다
Transformer에서는 Layer Normalization(LayerNorm)도 중요한 역할을 한다.
각 Layer를 거치며 Representation의 값이 계속 변화한다.
LayerNorm은 Feature Dimension을 기준으로 값을 정규화하고 학습 가능한 scale과 bias를 적용해 학습을 안정화하는 데 도움을 준다.
개념적으로:
Representation
      ↓
LayerNorm
      ↓
정규화된 Representation
Transformer 구현을 보면 LayerNorm이 자주 등장하는 이유다.
다만 Transformer 구조에 따라:
Post-Norm과
Pre-Norm등 Normalization의 위치가 다를 수 있다.
따라서 하나의 그림을 모든 Transformer의 절대적인 구조라고 생각하면 안 된다.
3.16 HOW — Feed-Forward Network: Attention 다음에는 무엇을 할까?
Attention은 Token 사이의 정보를 섞는 역할을 한다.
하지만 Transformer Block에는 각 Token 위치의 Representation을 추가로 변환하는 Feed-Forward Network(FFN)도 존재한다.
개념적으로:
Attention Output
      ↓
Linear
      ↓
Activation
      ↓
Linear
      ↓
FFN Output
각 Token 위치에 같은 FFN이 적용되지만, 각 위치의 입력 Representation은 이미 Attention을 통해 Context 정보를 반영하고 있다.
따라서 아주 단순화하면:
Attention
↓
Token 사이에서 정보 교환

FFN
↓
각 Token Representation을 추가 변환
으로 역할을 구분할 수 있다.
현대 LLM에서는 FFN 구조와 Activation도 다양한 방식으로 발전했지만, 이번 글에서는 Transformer Block의 기본 역할에 집중한다.
3.17 HOW — Transformer Block을 조립해보자
이제 구성 요소들을 합쳐보자.
Token Representations
        │
        ▼
Multi-Head Self-Attention
        │
        ├──── Residual
        ▼
Normalization
        │
        ▼
Feed-Forward Network
        │
        ├──── Residual
        ▼
Normalization
        │
        ▼
Updated Token Representations
하나의 Transformer Block은 Token Representation을 입력받아 문맥 정보가 더 반영된 새로운 Representation을 만든다.
그리고 실제 Transformer에서는 이 Block이 여러 번 쌓인다.
Token Embeddings
      ↓
Transformer Block 1
      ↓
Transformer Block 2
      ↓
Transformer Block 3
      ↓
      ...
      ↓
Transformer Block N
      ↓
Final Hidden Representations
즉 Token Representation은 고정된 상태로 유지되는 것이 아니라 Layer를 지나면서 계속 업데이트된다.
3.18 HOW — Embedding에서 Contextual Representation까지
이제 2편에서 남겨두었던 질문을 해결할 수 있다.
Token Embedding
      ↓
      ?
      ↓
Contextual Representation
? 안에는 Transformer Layer들의 문맥 계산이 있었다.
Token Embedding
      ↓
Q / K / V Projection
      ↓
Self-Attention
      ↓
Multi-Head Attention
      ↓
Residual + Normalization
      ↓
Feed-Forward Network
      ↓
Transformer Layers
      ↓
Contextual Representation
따라서:
bank라는 같은 Token도 서로 다른 문장에서 Transformer를 통과하면 주변 Context에 따라 서로 다른 내부 Representation을 갖게 될 수 있다.
money → bank ← deposited
          ↓
Contextual Representation A


river → bank ← sat
          ↓
Contextual Representation B
2편에서 만들었던 Number가 Context를 가진 Number로 바뀌는 순간이다.
3.19 CODE — Scaled Dot-Product Attention을 직접 계산해보자
이제 지금까지 배운 Attention을 직접 계산해보자.
복잡한 Framework 대신 1편에서 사용했던 NumPy를 다시 사용한다.
먼저 Q, K, V를 간단한 Matrix로 만든다.
import numpy as np

Q = np.array([
    [1.0, 0.0],
    [0.0, 1.0]
])

K = np.array([
    [1.0, 0.0],
    [0.0, 1.0]
])

V = np.array([
    [2.0, 1.0],
    [1.0, 3.0]
])
Step 1. Attention Score
scores = Q @ K.T

print(scores)
여기서:
Q @ K.T는 Query와 모든 Key 사이의 Dot Product를 Matrix 연산으로 한 번에 계산한다.
Step 2. Scaling
d_k = K.shape[-1]

scaled_scores = scores / np.sqrt(d_k)

print(scaled_scores)
Query/Key Dimension의 제곱근으로 나누어 Score를 조정한다.
Step 3. Softmax
def softmax(x):
    exp_x = np.exp(
        x - np.max(x, axis=-1, keepdims=True)
    )

    return exp_x / np.sum(
        exp_x,
        axis=-1,
        keepdims=True
    )

weights = softmax(scaled_scores)

print(weights)
각 Query가 Key들을 얼마나 참고할지 나타내는 Attention Weight가 만들어진다.
Step 4. Value 결합
output = weights @ V

print(output)
Attention Weight에 따라 Value Vector를 결합한다.
전체를 연결하면:
import numpy as np


def softmax(x):
    exp_x = np.exp(
        x - np.max(x, axis=-1, keepdims=True)
    )

    return exp_x / np.sum(
        exp_x,
        axis=-1,
        keepdims=True
    )


Q = np.array([
    [1.0, 0.0],
    [0.0, 1.0]
])

K = np.array([
    [1.0, 0.0],
    [0.0, 1.0]
])

V = np.array([
    [2.0, 1.0],
    [1.0, 3.0]
])


scores = Q @ K.T

scaled_scores = scores / np.sqrt(K.shape[-1])

weights = softmax(scaled_scores)

output = weights @ V


print("Attention Scores")
print(scores)

print("\nAttention Weights")
print(weights)

print("\nAttention Output")
print(output)
결국 코드 역시 공식과 정확히 같은 흐름이다.
Q @ K.T
   ↓
Attention Score

   ↓

÷ sqrt(d_k)
   ↓
Scaled Score

   ↓

Softmax
   ↓
Attention Weight

   ↓

@ V
   ↓
Attention Output
즉:
[
Attention(Q,K,V)
softmax\left(
\frac{QK^T}{\sqrt{d_k}}
\right)V
]
를 코드로 그대로 옮긴 것이다.
3.20 LLM — 이 Attention이 어떻게 GPT가 될까?
이제 마지막으로 지금까지 배운 연산을 실제 LLM 구조 안에 넣어보자.
Transformer에는 크게:
Transformer
   │
   ├── Encoder
   │
   └── Decoder
라는 구조적 구분이 있다.
이후 목적에 따라 다양한 Transformer 계열 모델이 등장했다.
Encoder-only
→ BERT 계열

Encoder-Decoder
→ T5 계열 등

Decoder-only
→ GPT 계열
우리가 이 시리즈에서 주로 살펴보는 생성형 LLM은 Decoder-only Transformer 계열과 직접 연결된다.
GPT 계열에서는 Causal Self-Attention을 사용해 미래 Token을 가린 상태에서 이전 Context를 이용한다.
Token Embeddings
       +
Position Information
       ↓
Masked / Causal
Multi-Head Self-Attention
       ↓
Feed-Forward Network
       ↓
Transformer Block
       ↓
× N Layers
       ↓
Contextual Representations
이제 모델 내부에는 단순한 Token Embedding이 아니라 앞선 Context가 반영된 Representation이 만들어졌다.
하지만 아직 답변은 나오지 않았다.
예를 들어:
나는 오늘 학교에라는 Context를 Transformer가 처리했다고 해보자.
마지막 Hidden Representation에는 지금까지의 Context 정보가 반영되어 있다.
그렇다면 다음 질문은:
이 Contextual Representation을 이용해 다음 Token을 어떻게 선택할까?
이다.
이 질문이 바로 다음 편으로 이어진다.
3.21 이번 글을 Why → How → Code → LLM으로 다시 정리하면
WHY
왜 Attention이 필요한가?
Token Embedding
      ↓
Token 하나의 초기 표현

하지만

Context
=
Token 사이의 관계

      ↓

Attention 필요
HOW
Attention은 어떻게 문맥을 계산하는가?
Input
 ↓
Q / K / V
 ↓
QKᵀ
 ↓
Scale
 ↓
Softmax
 ↓
Attention Weight
 ↓
Weighted Sum of V
 ↓
Contextualized Output
그리고:
Self-Attention
      ↓
Multi-Head Attention
      ↓
Residual / LayerNorm
      ↓
FFN
      ↓
Transformer Block
으로 확장된다.
CODE
수학식은 실제 코드에서:
Q @ K.T
 ↓
/ sqrt(d_k)
 ↓
softmax()
 ↓
@ V
로 구현할 수 있었다.
LLM
그리고 이 연산을 여러 Transformer Layer에서 반복하면:
Token Embeddings
       ↓
Transformer Layers
       ↓
Contextual Representations
       ↓
Next Token Prediction
으로 이어진다.
3.22 지금까지의 전체 흐름
이제 README에서 잡았던 첫 번째 축을 다시 보자.
Language → Number → Context → Generation지금까지의 내용을 실제 기술로 바꾸면:
Language
   │
   ▼
Tokenization
   │
   ▼
Token IDs
   │
   ▼
Embedding
   │
   ▼
Number
   │
   ▼
Self-Attention
   │
   ▼
Transformer
   │
   ▼
Contextual Representation
   │
   ▼
Context
즉 우리는 이제:
Language → Number → Context까지 왔다.
그리고 두 번째 축도 그대로 유지되고 있다.
WHY
왜 필요한가?

↓

HOW
어떻게 계산하는가?

↓

CODE
실제로 계산해본다.

↓

LLM
실제 모델의 어디에 사용되는가?
1편에서 배운:
Vector
Matrix
Dot Product
Softmax
는 Attention의 계산 도구가 되었고,
2편에서 배운:
Tokenization
Token ID
Embedding
Position Information
은 Transformer의 입력이 되었다.
그리고 이번 편에서 이 둘이 처음으로 하나의 구조 안에서 만났다.
        1. Vector & NumPy
              │
              │ Dot Product
              │ Softmax
              │ Matrix
              ▼
2. Tokenization & Embedding
              │
              │ Token Vector
              ▼
     3. Attention
              │
              ▼
        Transformer
              │
              ▼
   Contextual Representation
이제 남은 것은 마지막 단계다.
Language → Number → Context → Generation
                              ──────────
                                NEXT
다음 글
4. Transformer는 어떻게 다음 Token을 선택할까? — Training & Inference
Transformer는 Context를 반영한 Representation을 만들었다.
그런데 어떻게:
나는 오늘 학교에다음에 "갔다" 같은 Token을 선택할까?
다음 글에서는:
Contextual Representation
        ↓
Linear / LM Head
        ↓
Logits
        ↓
Softmax
        ↓
Token Probability
        ↓
Next Token
을 따라간다.
그리고 여기서 한 단계 더 나아가:
Next Token Prediction
Pre-training
Loss
Cross-Entropy
Parameter Update
Inference
Temperature
Top-k
Top-p
Autoregressive Generation
을 연결한다.
즉 다음 편에서는 지금까지 만든 Transformer가 어떻게 학습되고, 어떻게 실제로 다음 Token을 생성하는지 살펴본다.
Language
   ↓
Number
   ↓
Context
   ↓
Generation
드디어 LLM의 기본 동작 구조가 완성된다.