LLM.zip | 압축 해제
1.[LLM.zip | 압축 해제] README
인공지능의 가장 밑바닥 데이터 처리부터 출발해, 대형 언어 모델(LLM)에 이르기까지의 전 과정을 하나의 거대한 '인과관계'로 연결하여 이해하는 것에 가장 큰 중점을 두고 구성한 목차 입니다. 학습의 시작(1장)과 끝(8장)이 모두 LLM으로 감싸여 있다는 점입니
2.[LLM.zip | 압축 해제] 0. LLM 동작원리 - Token에서 Transfer까지
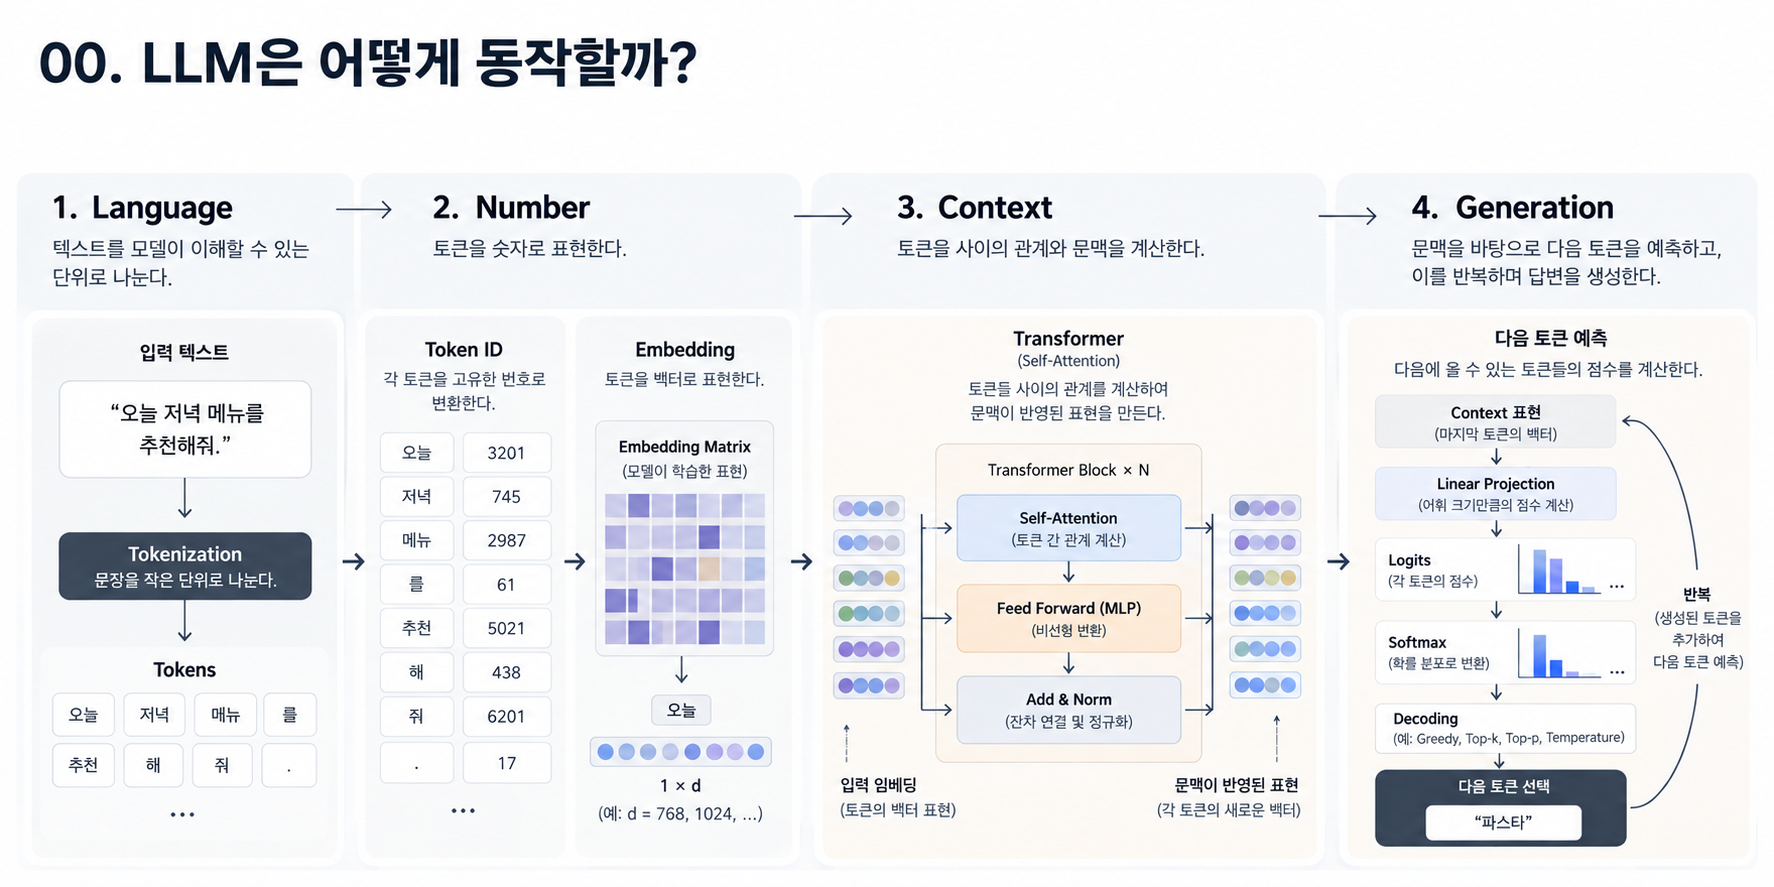
00. LLM은 어떻게 동작할까? LLM에게 질문을 입력하면 몇 초 안에 자연스러운 답변이 돌아온다. 사용자 입장에서 과정은 단순하다. 문장을 입력하면 답변이 나온다. 그래서 처음 LLM을 접하면 그 안에서 정확히 무슨 일이 일어나는지 알기 어려운 하나의 거대한
3.[LLM.zip | 압축 해제 ] 1. LLM 계산과 백터 연산- Vector, NumPy, Softmax까지
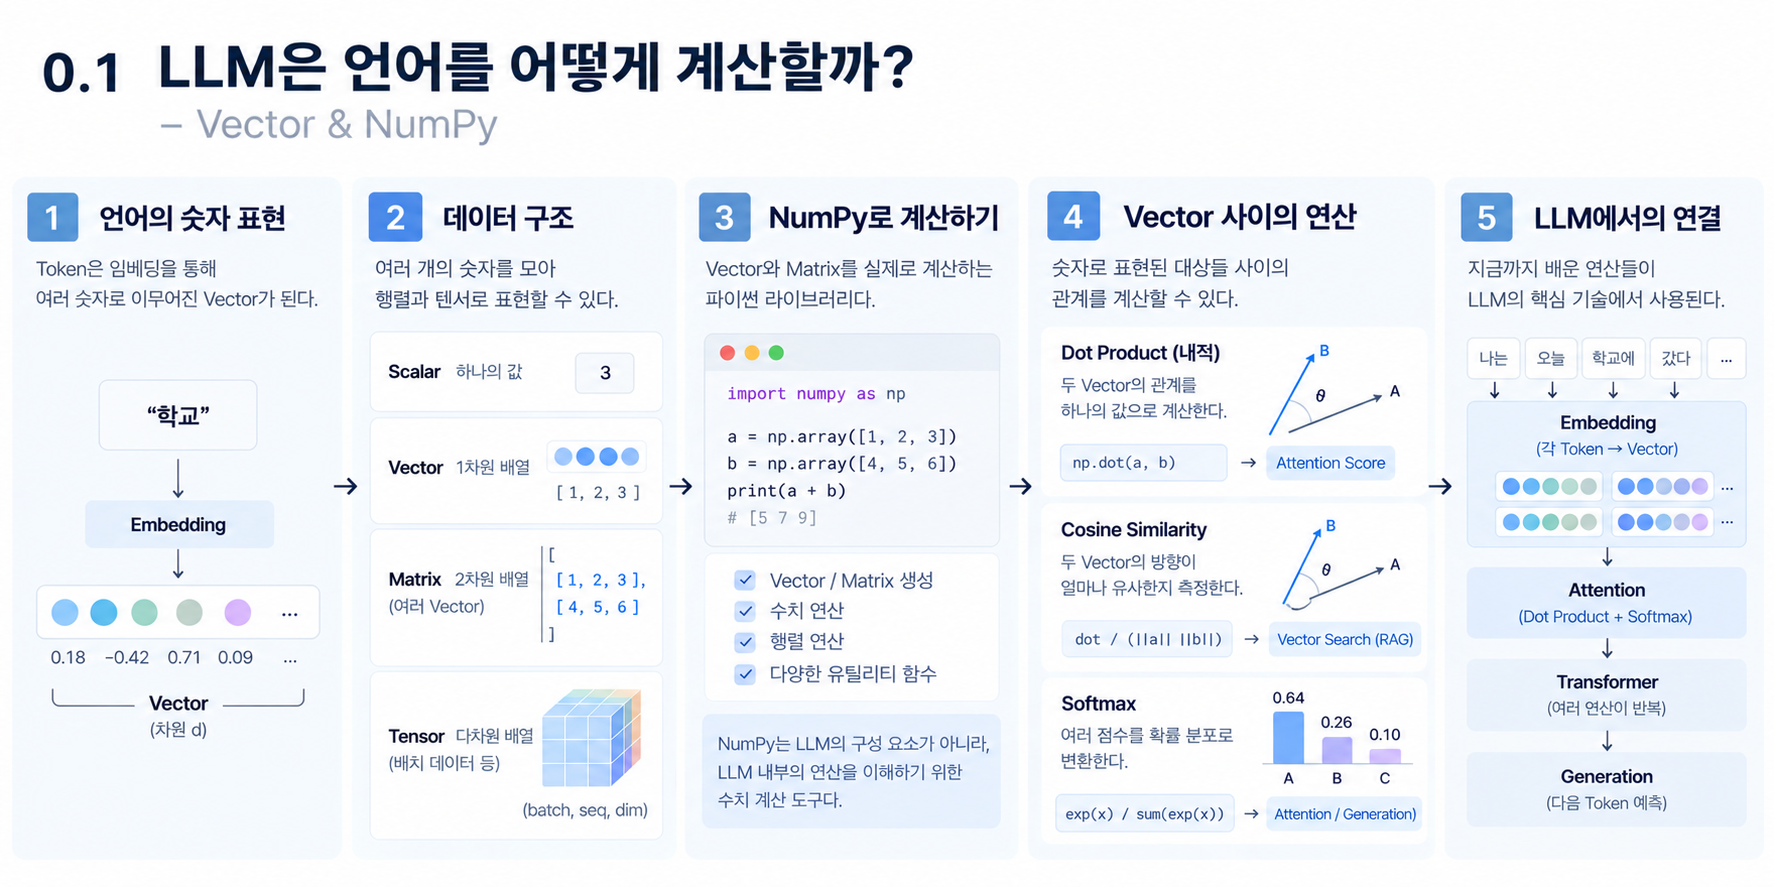
지난 편에서는 LLM이 입력된 Text를 처리하고 답변을 생성하기까지의 전체 흐름을 살펴봤다.그 과정에서 중요한 변환 하나가 있었다.우리가 사용하는 언어가 모델 내부에서는 Vector라는 숫자 표현으로 변환된다.그런데 여기서 몇 가지 질문이 생긴다.Vector는 정확히
4.[LLM.zip | 압축 해제 ] 2. Text에서 Vector까지의 여정 - Tokenization & Embedding
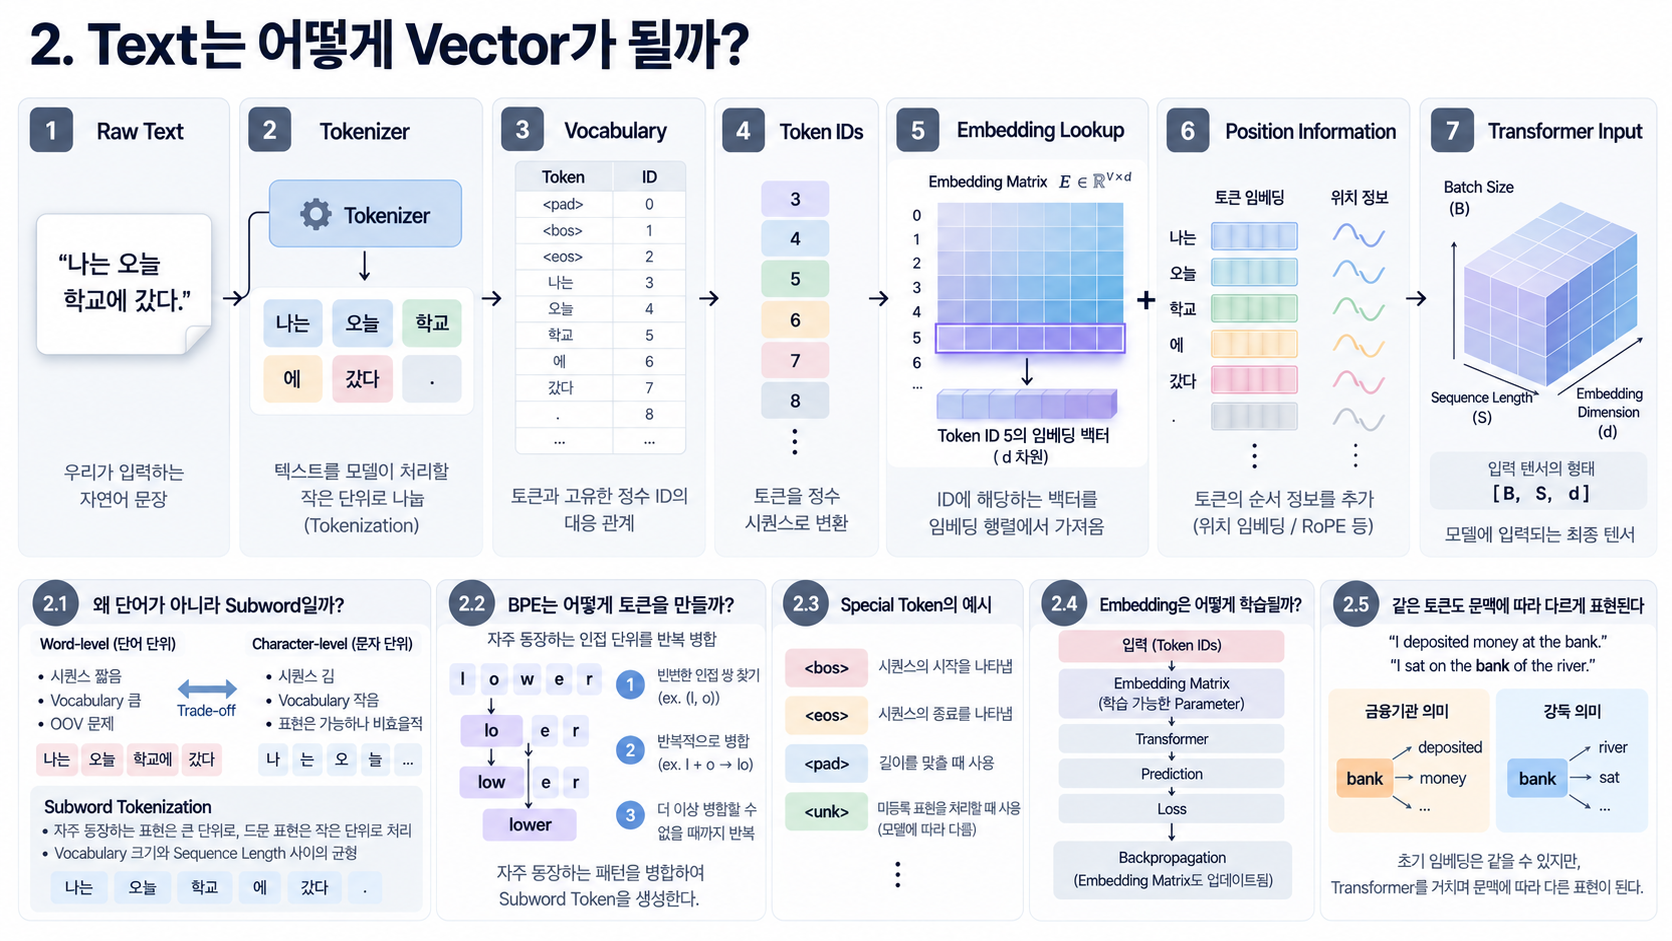
| 개념 | 중요도 | 이 편에서 알아야 하는 핵심 | |---|---|---| | Tokenizer | 필수 | Text → Token 변환을 수행하는 구성 요소 | | Token | 필수 | 모델이 Text를 처리하는 기본 단위 | | Tokenization | 필
5.[LLM.zip | 압축 해제] 3. 문맥을 수학으로 계산한다 - Attention & Transformer
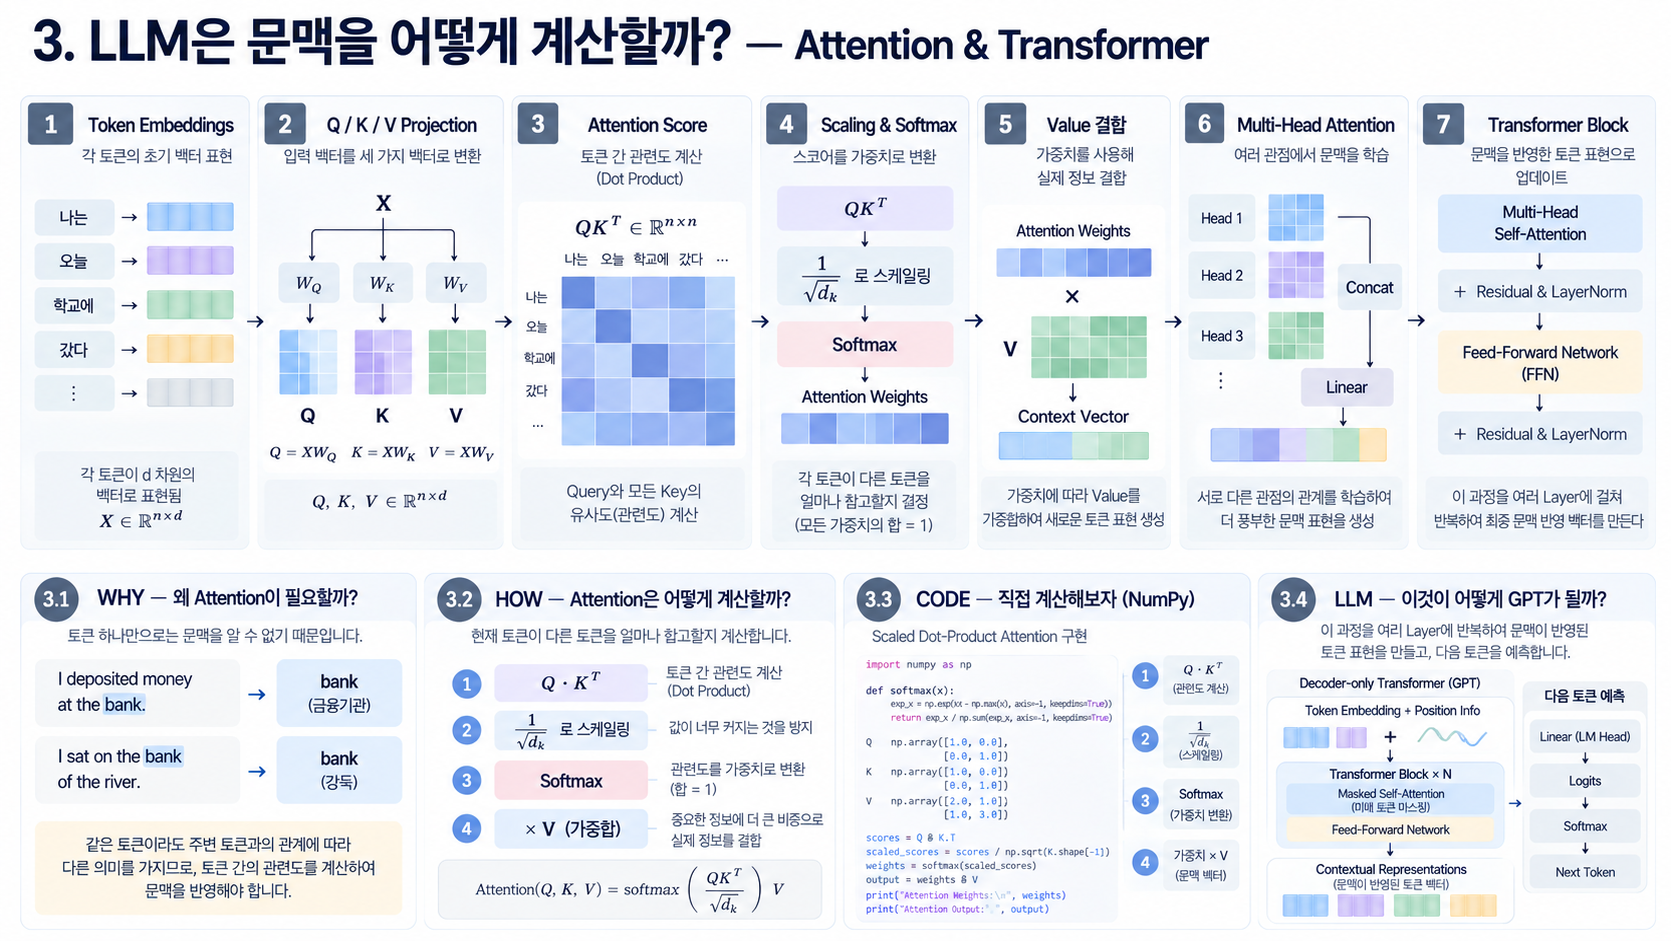
3. LLM은 문맥을 어떻게 계산할까? — Attention & Transformer 지금까지 우리는 LLM의 전체 흐름에서 두 단계를 지나왔다. 1편에서는 Vector, Matrix, Tensor, Dot Product, Softmax를 통해 LLM이 숫자를 어떻
6.[LLM.zip | 압축 해제] 4. Transformer는 어떻게 다음 Token을 선택할까? — Training & Inference
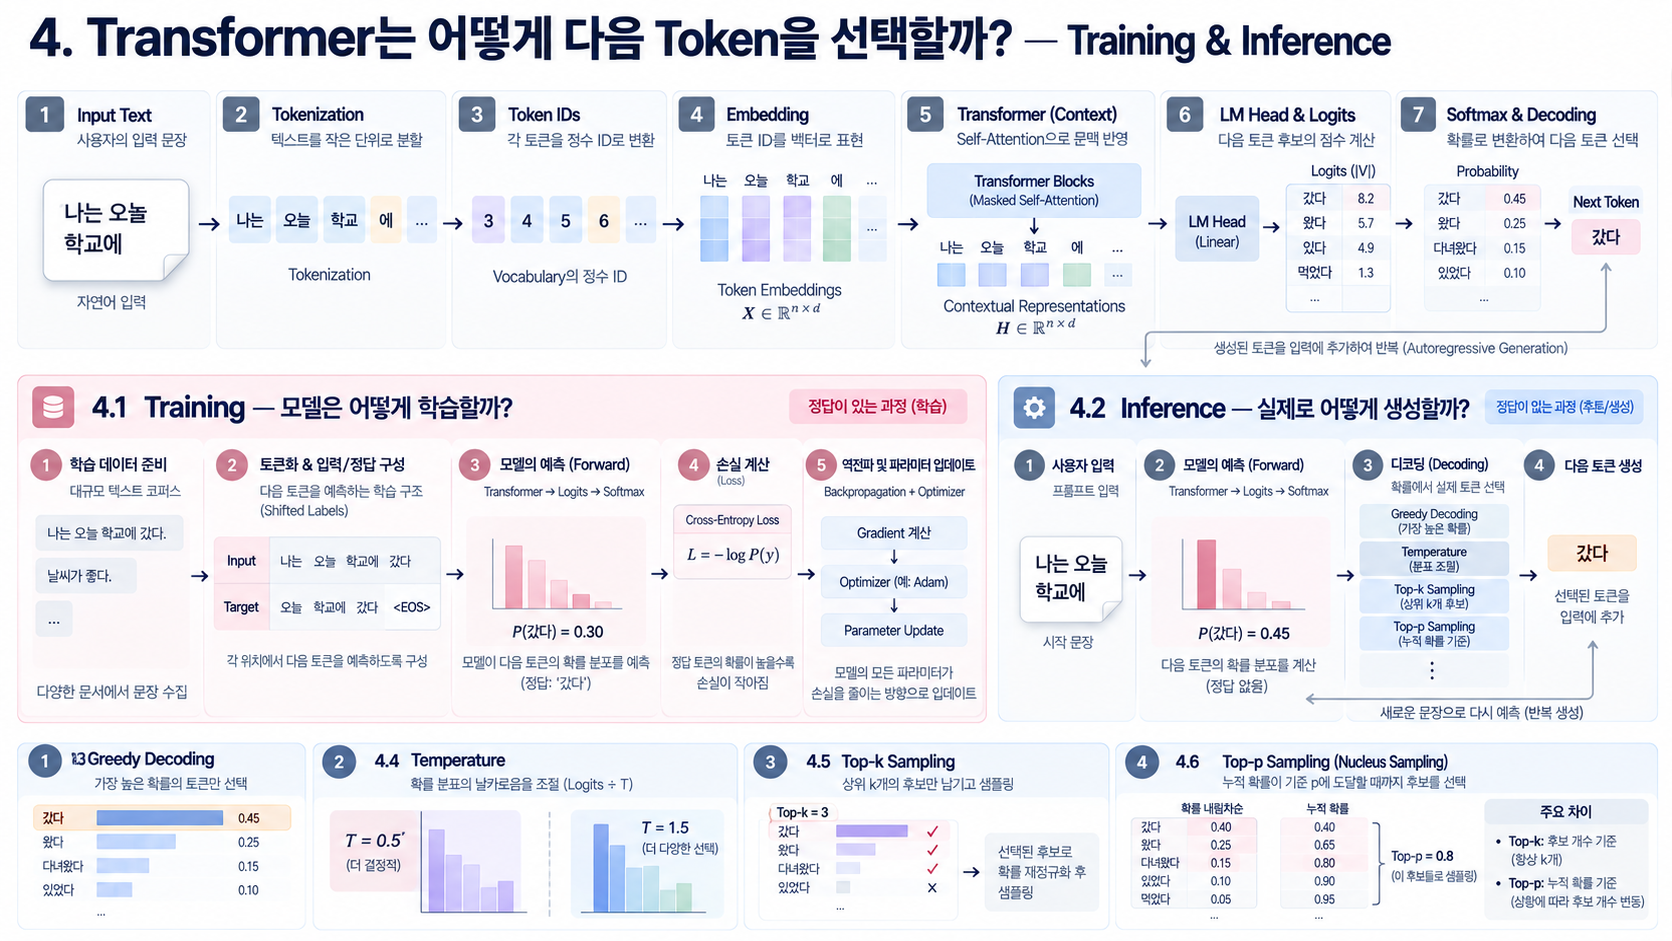
지금까지 우리는 LLM의 전체 흐름에서 세 단계를 지나왔다.1편에서는 Vector, Matrix, Tensor, Dot Product, Softmax를 통해 LLM이 숫자를 어떻게 계산하는지 살펴봤다.2편에서는:를 따라가며 Language가 Number로 변환되는 과정
7.[LLM.zip | 압축 해제] 5. 모르는 정보를 어떻게 찾아올까? — RAG & Vector Search
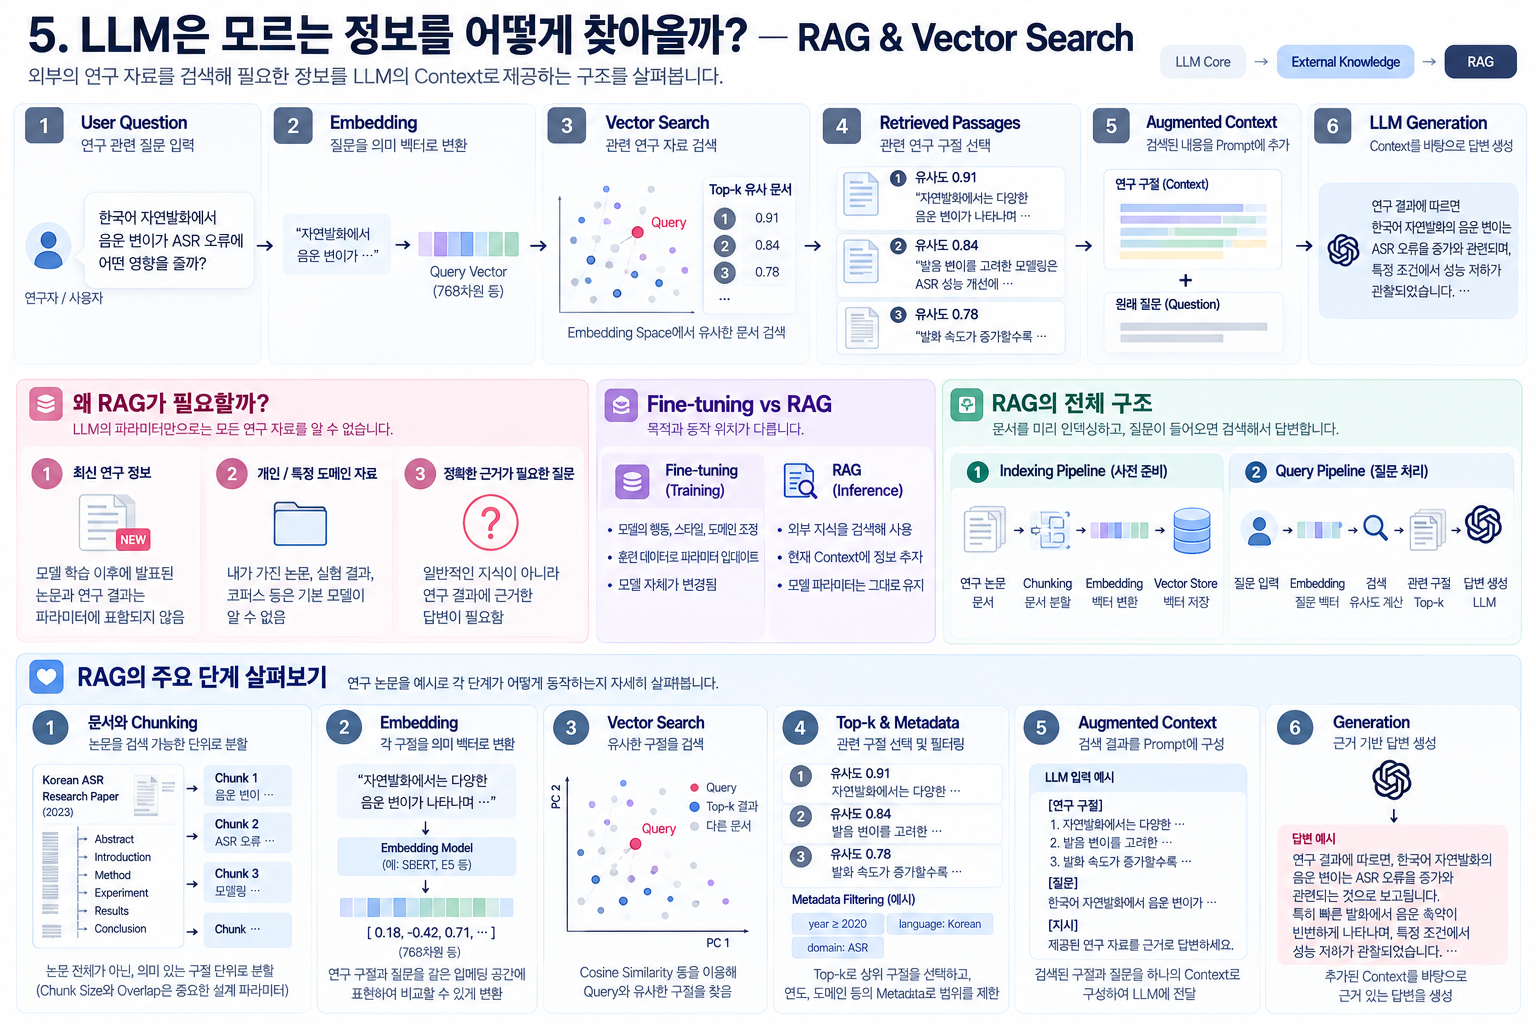
5. LLM은 모르는 정보를 어떻게 찾아올까? — RAG & Vector Search 지금까지 우리는 LLM 내부의 기본 동작을 하나씩 열어봤다. Text는 Token으로 나뉘고, Token은 Vector가 되고, Transformer는 Vector 사이의 관계
8.[LLM.zip | 압축 해제] 6. 도구 호출과 에이전트 인포그래픽— Tool Calling & Agent
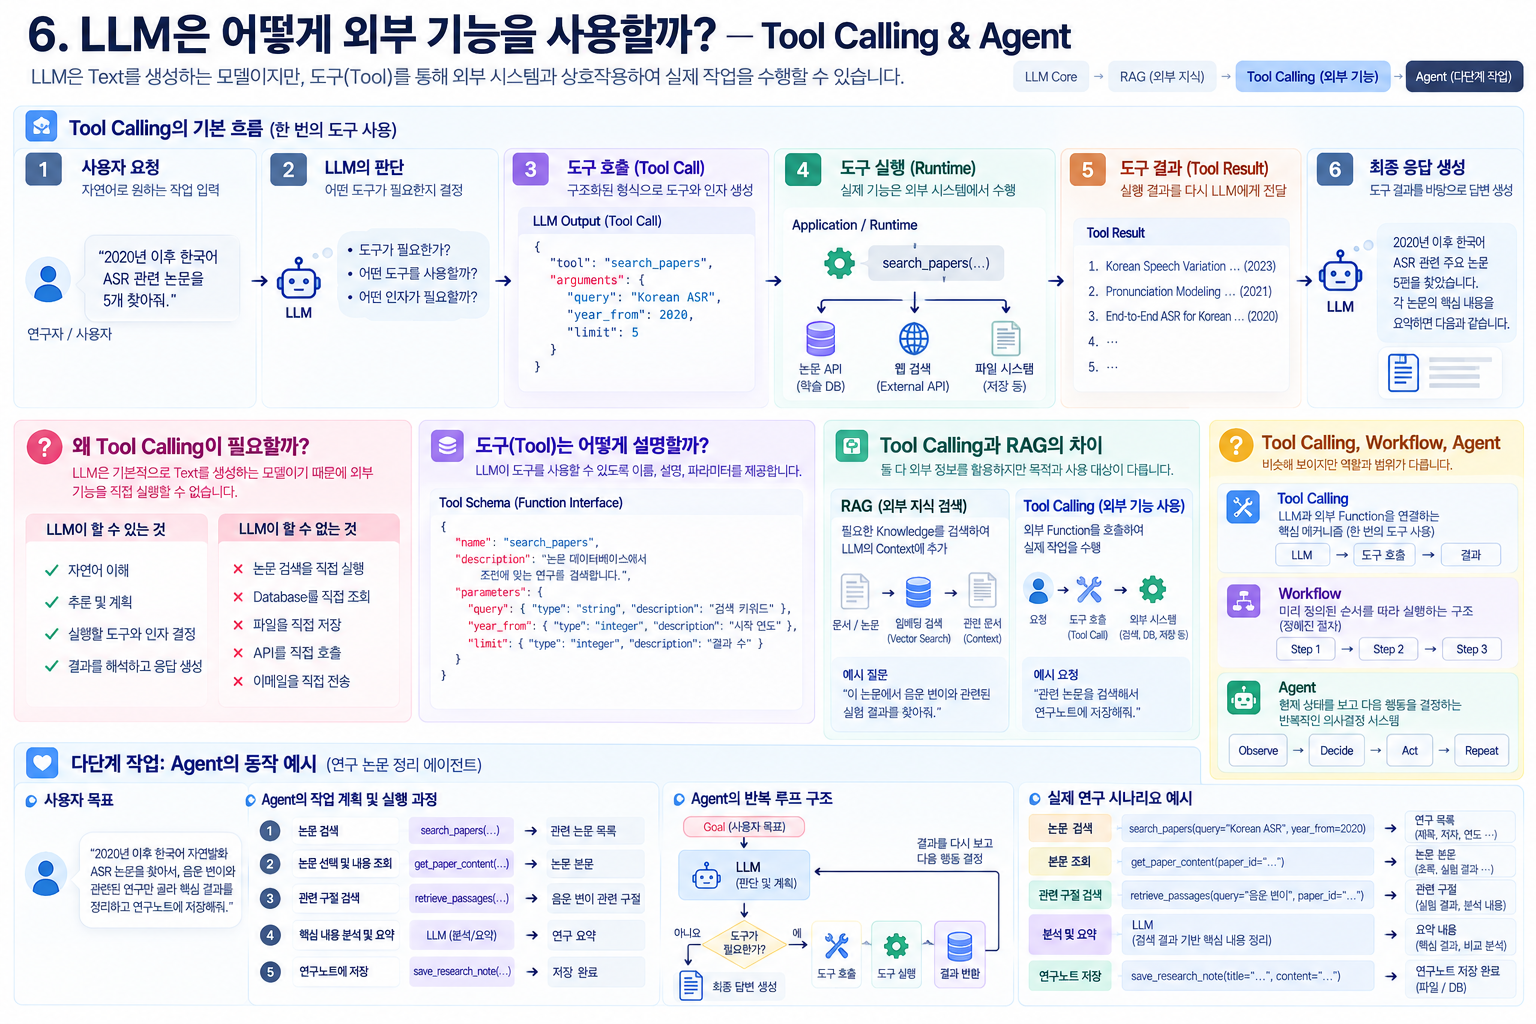
6. LLM은 어떻게 외부 기능을 사용할까? — Tool Calling & Agent 5편에서는 LLM이 자신의 Parameter 밖에 있는 정보를 사용하는 방법을 살펴봤다. RAG를 이용하면 LLM은 외부의 논문, 문서, Database 등에 있는 정보를 검색해
9.[LLM.zip | 압축 해제] 7. Final — LLM System 재조립
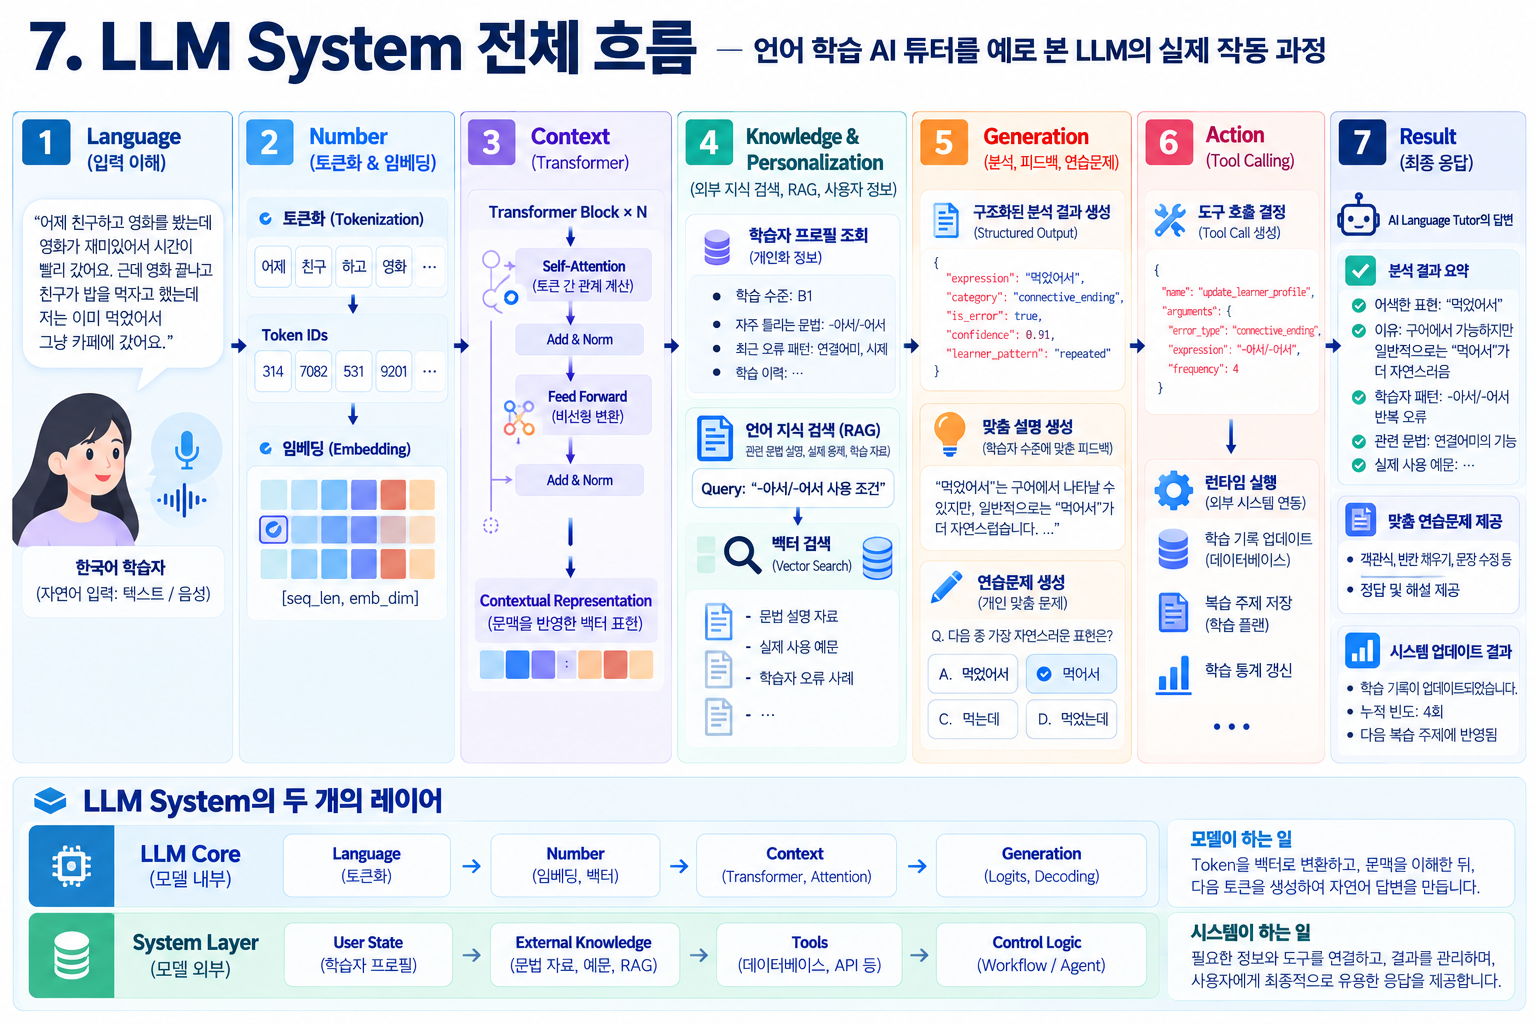
7. Final — LLM System 다시 조립하기 chapter.0에서 처음 LLM을 바라봤을 때 구조는 아주 단순했다. 사용자가 Text를 입력하면 LLM이 답변을 만든다. 겉으로 보면 이게 전부다. 하지만 chapter.1부터 6까지 이 Black Box