0.0 LLM은 어떻게 동작할까?
LLM에게 질문을 입력하면 몇 초 안에 자연스러운 답변이 돌아온다.
User
 │
 ▼
"오늘 저녁 메뉴를 추천해줘."
 │
 ▼
LLM
 │
 ▼
"오늘은 파스타를 추천해요."
사용자 입장에서 과정은 단순하다.
문장을 입력하면 답변이 나온다.
그래서 처음 LLM을 접하면 그 안에서 정확히 무슨 일이 일어나는지 알기 어려운 하나의 거대한 Black Box처럼 느껴지기도 한다.
하지만 이 Black Box의 Hood를 열어보면, 하나의 답변이 만들어지기까지 여러 기술이 순서대로 연결되어 있다는 것을 볼 수 있다.
Input Text
    ↓
Tokenization
    ↓
Token
    ↓
Token ID
    ↓
Embedding
    ↓
Vector
    ↓
Transformer
    ↓
Logits
    ↓
Probability
    ↓
Next Token
    ↓
Generation
처음 보면 낯선 용어가 많다.
Token, Embedding, Vector, Attention, Transformer, Logits...
하지만 이번 편에서 이 모든 기술의 내부 원리를 이해할 필요는 없다.
이번에는 먼저 완성된 LLM을 하나의 시스템으로 바라보면서, 입력한 문장이 어떤 과정을 거쳐 답변으로 만들어지는지 전체 흐름을 따라가려고 한다.
그리고 이후 편부터 Hood 안의 부품을 하나씩 꺼내볼 것이다.
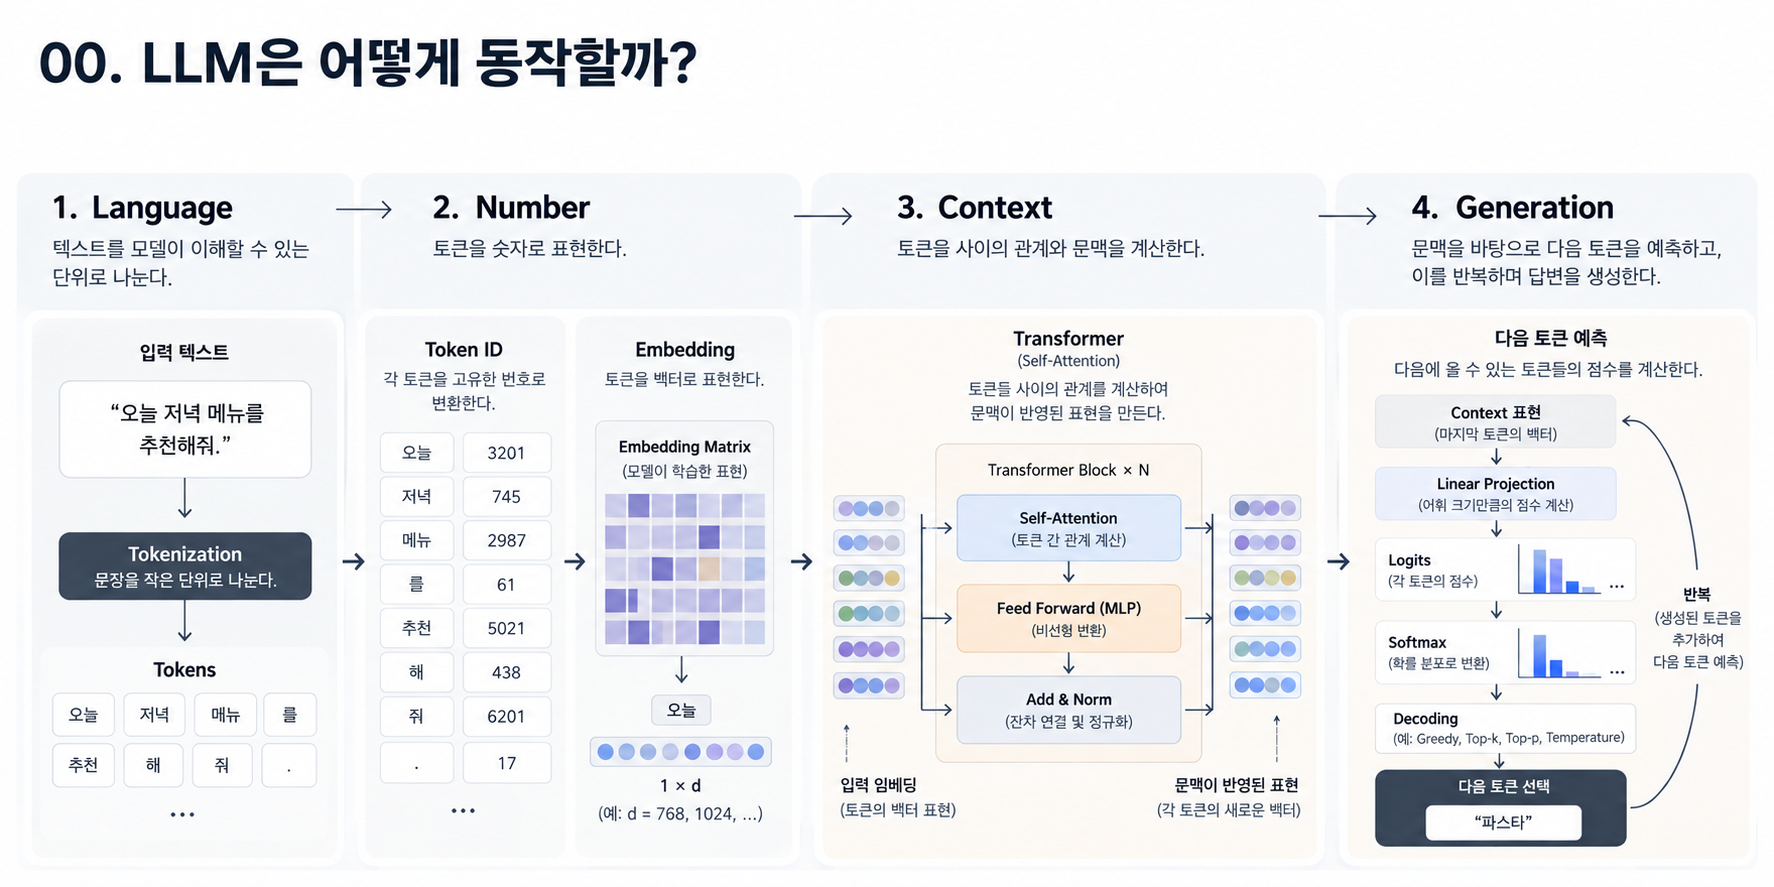
이 시리즈에서 계속 따라가게 될 가장 큰 흐름은 다음과 같다.
Language
    ↓
Number
    ↓
Context
    ↓
Generation
언어를 계산할 수 있는 숫자로 바꾸고,
그 숫자들 사이의 관계를 이용해 문맥을 계산하고,
그 문맥을 바탕으로 다음 Token을 예측한다.
우선 첫 번째 질문부터 시작해보자.
0.1. LLM은 무엇을 하는 모델일까?
LLM은 Large Language Model, 대규모 언어 모델을 의미한다.
그렇다면 그 안에 있는 Language Model은 무엇을 하는 모델일까?
다음 문장을 한번 생각해보자.
나는 배가 고파서 밥을 ___.빈칸에는 여러 표현이 들어갈 수 있다.
먹었다
먹는다
샀다
버렸다
...
문법적으로 들어갈 수 있는 표현은 여러 개지만, 모든 후보가 똑같이 자연스럽게 느껴지지는 않는다.
앞에 배가 고파서라는 내용이 있기 때문에 우리는 자연스럽게 먹었다와 같은 표현을 떠올릴 가능성이 높다.
Language Model이 다루는 문제도 이와 비슷하다.
지금까지 주어진 내용을 바탕으로 다음에 무엇이 등장할 가능성이 높은지를 계산한다.
LLM에서는 이를 Next Token Prediction이라고 한다.
조금 단순화하면 다음과 같이 생각할 수 있다.
지금까지의 내용
       ↓
다음에는 무엇이 올까?
       ↓
후보들의 가능성 계산
       ↓
다음 Token 선택
여기서 중요한 점이 하나 있다.
Next Word Prediction이 아니라 Next Token Prediction이다.
왜 Word가 아니라 Token일까?
이 질문을 따라가려면 먼저 모델이 우리가 입력한 문장을 어떻게 받아들이는지 알아야 한다.
0.2. 모델은 문장을 그대로 계산할 수 없다 — Tokenization
우리는
나는 오늘 학교에 갔다.라는 문장을 보면 자연스럽게 하나의 문장으로 읽는다.
하지만 컴퓨터가 이 문장을 사람처럼 그대로 읽고 계산할 수 있는 것은 아니다.
LLM이 텍스트를 처리하려면 먼저 입력을 모델이 다룰 수 있는 단위로 나눌 필요가 있다.
여기서 Tokenization이 등장한다.
Tokenization은 입력된 Text를 작은 단위로 나누는 과정이고, 이렇게 나누어진 각각의 단위를 Token이라고 한다.
Text
 ↓
Tokenization
 ↓
Tokens
그리고 Tokenization을 수행하는 구성 요소를 Tokenizer라고 한다.
여기서 한 가지 주의할 점이 있다.
Token은 반드시 하나의 단어가 아니다.
하나의 단어가 하나의 Token이 될 수도 있지만, 하나의 단어가 여러 Token으로 나뉠 수도 있다.
문장부호나 단어의 일부 역시 Token이 될 수 있다.
어떻게 나뉘는지는 사용하는 Tokenizer와 Vocabulary에 따라 달라진다.
Vocabulary는 간단히 말하면 모델이 사용하는 Token들의 목록이다.
아주 단순화해서 생각하면 다음과 같다.
Vocabulary

Token        ID
----------------
<A>           0
<B>           1
<C>           2
<D>           3
...
Vocabulary 안의 각각의 Token에는 고유한 번호가 대응된다.
이 번호를 Token ID라고 한다.
그래서 지금까지의 흐름을 조금 더 확장하면 다음과 같다.
Text
 ↓
Tokenization
 ↓
Token
 ↓
Token ID
사람이 사용하는 언어가 조금씩 모델이 계산할 수 있는 형태에 가까워지고 있다.
그런데 여기서 또 하나의 문제가 생긴다.
Token에 번호를 붙였다고 해서 모델이 그 Token의 의미를 알게 된 것은 아니다.
0.3. Token ID는 의미가 아니다 — Embedding
예를 들어 어떤 Tokenizer에서 다음과 같은 Token ID가 있다고 가정해보자.
"cat" → 3124
"dog" → 851
그렇다면
3124 > 851이므로 cat이 dog보다 더 크거나 중요하다는 의미일까?
그렇지 않다.
Token ID는 각각의 Token을 구분하기 위해 붙인 식별자일 뿐이다.
학생에게 학번을 부여한다고 해서 학번의 크기가 학생의 의미나 특성을 나타내지 않는 것과 비슷하다.
그렇다면 새로운 질문이 생긴다.
Token을 실제 모델의 연산에 사용할 수 있는 형태로 어떻게 표현할까?
여기서 Embedding이 등장한다.
Embedding은 Token을 일정한 차원의 Vector(벡터) 형태로 표현한다.
개념적으로 보면 다음과 같다.
"cat"
  ↓
Token ID
  ↓
Embedding
  ↓
[0.21, -0.47, 0.81, 0.13, ...]
이제 하나의 Token이 여러 숫자로 이루어진 Vector로 표현되었다.
Token
 ↓
Token ID
 ↓
Embedding
 ↓
Vector
여기서 이 시리즈의 첫 번째 큰 변환이 일어난다.
Language
    ↓
Tokenization
    ↓
Token
    ↓
Embedding
    ↓
Vector
    ↓
Number
우리가 사용하는 Language가 모델이 계산할 수 있는 Number의 세계로 들어온 것이다.
그렇다면 왜 하필 Vector일까?
Vector에는 무엇을 표현할 수 있을까?
그리고 Vector와 Vector 사이의 관계는 어떻게 계산할까?
이 질문 때문에 이후 Vector, Matrix, Tensor, Dot Product, Cosine Similarity 같은 개념이 필요해진다.
하지만 아직 하나의 문제가 더 남아 있다.
Token을 Vector로 바꾸는 것만으로 언어의 의미를 충분히 처리할 수 있을까?
0.4. 같은 표현도 문맥에 따라 의미가 달라진다 — Context
다음 두 문장을 살펴보자.
I deposited money at the bank.

I sat on the bank of the river.
두 문장 모두 bank라는 같은 표현을 가지고 있다.
하지만 첫 번째 문장의 bank는 금융기관을 의미하고, 두 번째 문장에서는 강둑을 의미한다.
같은 표현이지만 주변에 어떤 정보가 함께 있는지에 따라 의미가 달라진다.
즉 언어에서는 하나의 Token 자체뿐만 아니라
그 Token이 어떤 Context(문맥) 안에 있는가
가 중요하다.
그러면 모델 입장에서는 새로운 문제가 생긴다.
Token을 Vector로 만들었다.
        ↓
하지만 주변 Token과의 관계는?
        ↓
문맥은 어떻게 반영하지?
이 문제를 해결하기 위해 LLM을 이해하는 데 매우 중요한 개념이 등장한다.
Attention이다.
0.5. Token 사이의 관계를 계산한다 — Attention
문장에는 여러 Token이 존재한다.
Token A
Token B
Token C
Token D
Token E
각 Token을 완전히 독립적으로 바라본다면, 문장 안에서 어떤 Token이 서로 관련되어 있는지 충분히 반영하기 어렵다.
그래서 모델에는 Token과 Token 사이의 관계를 계산하는 과정이 필요하다.
Token A ─┐
Token B ─┤
Token C ─┼──→ 서로 어떤 관계가 있을까?
Token D ─┤
Token E ─┘
여기서 핵심적인 역할을 하는 것이 Attention이다.
그리고 입력 안의 Token들이 서로를 참고하며 관계를 계산하는 핵심 메커니즘이 Self-Attention이다.
Self-Attention에서는 이후 자세히 배우게 될 세 가지 개념이 등장한다.
Query (Q)
Key   (K)
Value (V)
지금은 Q·K·V가 정확히 어떻게 계산되는지 알 필요는 없다.
00편에서 중요한 것은 왜 Attention이 필요해졌는가다.
Token을 Vector로 표현했다.
        ↓
하지만 Vector 하나만 봐서는
문맥을 충분히 알 수 없다.
        ↓
다른 Token과의 관계를 계산해야 한다.
        ↓
Attention
전체 Pipeline에서 보면 다음 위치에 해당한다.
Embedding
    ↓
Vector
    ↓
Self-Attention
    ↓
Token 사이의 관계 계산
    ↓
Context가 반영된 표현
즉,
Embedding이 Token을 계산 가능한 Vector로 표현한다면, Attention은 Token들이 서로 어떤 관계를 가지는지를 계산하는 데 핵심적인 역할을 한다.
그리고 이 Attention을 핵심 메커니즘으로 사용하는 구조가 바로 Transformer다.
0.6. 문맥을 처리하는 핵심 구조 — Transformer
LLM을 공부하면 가장 자주 만나게 되는 용어 중 하나가 Transformer다.
GPT 역시 Transformer 아키텍처를 기반으로 한다.
Transformer 내부에는 Self-Attention만 존재하는 것은 아니다.
아주 단순화하면 하나의 Transformer Block 안에는 다음과 같은 구성 요소들이 있다.
┌─────────────────────┐
│  Transformer Block  │
│                     │
│   Self-Attention    │
│          ↓          │
│  Feed Forward / MLP │
│                     │
│  + Residual / Norm  │
└─────────────────────┘
그리고 이러한 Block이 여러 Layer에 걸쳐 반복된다.
Input
  ↓
Transformer Block
  ↓
Transformer Block
  ↓
Transformer Block
  ↓
 ...
각 Block의 세부 연산은 03편에서 직접 살펴볼 것이다.
지금은 전체 Pipeline에서 Transformer가 담당하는 역할에 집중해보자.
Text
 ↓
Tokenization
 ↓
Token
 ↓
Embedding
 ↓
Vector
 ↓
Transformer
 ↓
Context가 반영된 표현
앞에서는 Language를 Number로 바꿨다.
이제 Transformer에서는 그 숫자 표현 사이의 관계를 이용해 Context를 처리한다.
Language
   ↓
Number
   ↓
Context
그렇다면 문맥을 처리한 다음에는 무엇을 해야 할까?
처음의 목표로 다시 돌아가보자.
Language Model이 해야 하는 일은 Next Token Prediction이었다.
이제 계산된 Context를 바탕으로 실제 다음 Token을 결정해야 한다.
0.7. 다음 Token 후보에 점수를 매긴다 — Logits
예를 들어 지금까지 다음과 같은 Context가 주어졌다고 해보자.
대한민국의 수도는모델은 이제 다음에 어떤 Token이 등장할지 예측해야 한다.
이를 위해 다음 Token이 될 수 있는 후보들에 대해 점수를 계산한다.
이 점수를 Logit이라고 한다.
설명을 위해 임의의 값을 사용하면 다음과 같이 생각할 수 있다.
Token 후보       Logit
-----------------------
서울              8.7
부산              4.2
한국              3.8
도쿄              1.1
...
여기서 중요한 것은 Logit은 아직 확률이 아니라는 것이다.
각 Token 후보에 대해 모델이 계산한 raw score라고 생각하면 된다.
그렇다면 이 점수들을 어떻게 확률처럼 비교할 수 있을까?
여기서 Softmax가 등장한다.
Logits
   ↓
Softmax
   ↓
Probability Distribution
Softmax를 적용하면 Logit을 Token 후보들에 대한 확률 분포로 변환할 수 있다.
설명을 위한 예시로 보면,
서울     0.82
부산     0.08
한국     0.06
도쿄     0.01
...
와 같은 형태다.
이제 모델은 각 Token이 다음에 등장할 가능성을 비교할 수 있다.
하지만 아직 답변은 만들어지지 않았다.
여러 후보 중 실제로 다음 Token 하나를 선택해야 한다.
0.8. 어떤 Token을 선택할까? — Inference & Decoding
가장 단순하게 생각하면 가장 높은 확률을 가진 Token을 선택할 수 있다.
하지만 실제 생성에서는 항상 가장 높은 확률의 Token만 선택하는 것은 아니다.
어떤 방식으로 Token을 선택하느냐에 따라 생성되는 문장의 특성이 달라질 수 있다.
이 과정에서 만나게 되는 개념들이
Greedy Decoding, Temperature, Top-k, Top-p 등이다.
Probability Distribution
          ↓
   Decoding Strategy
          ↓
 ┌────────┼────────┐
 │        │        │
Greedy   Top-k    Top-p
          │
     Temperature
          ↓
      Next Token
이러한 개념은 04편 Training & Inference에서 자세히 살펴볼 것이다.
지금은
모델이 계산한 확률 분포를 바탕으로 다음 Token 하나를 선택한다.
는 것만 기억하면 충분하다.
그런데 여기서 또 하나의 질문이 생긴다.
Token 하나를 예측하는 모델이 어떻게 여러 문장으로 이루어진 긴 답변을 만들 수 있을까?
0.9. Next Token Prediction의 반복 — Generation
LLM은 긴 답변 전체를 처음부터 완성한 뒤 한 번에 꺼내놓는 방식으로 생성하지 않는다.
하나의 Token을 생성하고, 그 Token을 기존 Context에 추가한 뒤, 다시 다음 Token을 예측한다.
아주 단순화하면 다음과 같다.
"대한민국의"
      ↓
Next Token Prediction
      ↓
"수도는"
생성된 Token이 기존 Context에 추가된다.
"대한민국의 수도는"그리고 다시 예측한다.
"대한민국의 수도는"
          ↓
Next Token Prediction
          ↓
"서울"
다시 추가한다.
"대한민국의 수도는 서울"그리고 또 다음 Token을 예측한다.
"대한민국의 수도는 서울"
             ↓
Next Token Prediction
             ↓
"입니다"
이 과정이 계속 반복된다.
Context
   ↓
Next Token Prediction
   ↓
Next Token
   ↓
Context에 추가
   ↓
새로운 Context
   ↓
Next Token Prediction
   ↓
Next Token
   ↓
   ...
이러한 반복을 통해 하나의 Token이 문장이 되고, 문장이 이어져 하나의 답변이 만들어진다.
즉 우리가 보고 있는 긴 답변도 기본적으로는
지금까지 주어진 Context를 바탕으로 Next Token을 예측하는 과정의 반복
으로 생성된다.
이제 처음에 등장했던 Language Model의 역할이 다시 연결된다.
Language Model
      ↓
Next Token Prediction
      ↓
Next Token
      ↓
Context에 추가
      ↓
Next Token Prediction
      ↓
...
      ↓
Generation
0.10. 이제 전체 Pipeline을 다시 보자
처음에는 서로 다른 기술처럼 보였던 개념들을 다시 하나의 흐름으로 연결해보자.
Input Text
    │
    ▼
Tokenization
    │
    ▼
  Token
    │
    ▼
 Token ID
    │
    ▼
Embedding
    │
    ▼
 Vector
    │
    ▼
Transformer
(Self-Attention)
    │
    ▼
  Logits
    │
    ▼
 Softmax
    │
    ▼
Probability
    │
    ▼
Next Token
    │
    ▼
Generation
    │
    └──────────────↺
복잡해 보이지만 크게 세 구간으로 나누면 훨씬 단순해진다.
Language → Number
Text
 ↓
Tokenization
 ↓
Token
 ↓
Token ID
 ↓
Embedding
 ↓
Vector
우리가 사용하는 언어를 모델이 계산할 수 있는 숫자 표현으로 변환한다.
Number → Context
Vector
 ↓
Self-Attention
 ↓
Transformer
 ↓
Contextual Representation
숫자로 표현된 Token 사이의 관계를 계산하고 Context를 반영한다.
Context → Generation
Context
 ↓
Logits
 ↓
Softmax
 ↓
Probability
 ↓
Next Token
 ↓
Generation
Context를 바탕으로 다음 Token의 가능성을 계산하고, Token을 선택하는 과정을 반복한다.
결국 이번 편에서 살펴본 긴 Pipeline을 다시 압축하면 다음과 같다.
Language
    ↓
Number
    ↓
Context
    ↓
Generation
이것이 앞으로 이 시리즈 전체에서 계속 따라가게 될 하나의 지도다.
0.11. 그런데 LLM은 여기서 끝날까?
지금까지 살펴본 것은 주로 LLM 자체가 Text를 받아 다음 Token을 생성하는 과정이었다.
Tokenization
     ↓
Embedding
     ↓
Transformer
     ↓
Next Token Prediction
     ↓
Generation
하지만 실제 우리가 사용하는 LLM Application에는 LLM만 존재하는 것은 아니다.
예를 들어 모델 내부에 없는 문서를 검색해야 할 수도 있다.
회사 Database에서 정보를 가져와야 할 수도 있다.
검색 API를 호출하거나 실제 외부 기능을 실행해야 할 수도 있다.
LLM 자체의 생성 능력만으로 해결하기 어려운 문제가 생기는 것이다.
그래서 LLM은 다시 외부로 확장된다.
                     User
                      │
                      ▼
                 Application
                      │
              ┌───────┴───────┐
              │               │
              ▼               ▼
             RAG          Tool Calling
              │               │
        Embedding          API / DB
              │               │
          Vector DB            │
              │               │
              └───────┬───────┘
                      ▼
                     LLM
                      │
                      ▼
                   Response
여기서 RAG, Vector DB, Tool Calling, Agent 같은 기술이 등장한다.
이들은 Transformer 내부의 또 다른 Layer라기보다, LLM을 외부 지식과 시스템에 연결하여 더 큰 Application으로 확장하는 과정에서 사용되는 기술이다.
그래서 이 시리즈의 흐름 역시 LLM 내부에서 끝나지 않는다.
Language
   ↓
Number
   ↓
Context
   ↓
Generation
   ↓
External Knowledge / Tools
   ↓
LLM Application
05편에서는 RAG를 통해 외부 지식을 연결하고,
06편에서는 Tool Calling과 Agent를 통해 LLM이 외부 시스템과 상호작용하는 구조까지 확장해볼 것이다.
0.12. 이제 Hood를 하나씩 열어보자
이번 편에서는 많은 용어가 등장했다.
Tokenization
Token
Token ID
Vocabulary
Embedding
Vector
Attention
Self-Attention
Transformer
Logits
Softmax
Probability
Next Token Prediction
Generation
하지만 이 용어들을 한 번에 외우는 것이 이번 편의 목표는 아니다.
더 중요한 것은 각 기술이 왜 필요한지, 그리고 전체 Pipeline에서 어디에 위치하는지를 이해하는 것이다.
우리가 따라온 흐름을 다시 보면 각 기술은 이전 단계에서 생긴 질문에 대한 답으로 등장했다.
LLM은 무엇을 할까?
        ↓
Next Token Prediction


그런데 Text를 어떻게 처리하지?
        ↓
Tokenization


Token ID는 단순한 번호인데
어떻게 계산에 사용하지?
        ↓
Embedding / Vector


Vector만으로 문맥을 알 수 있을까?
        ↓
Attention


Token 사이의 관계와 문맥을
어떻게 반복적으로 처리하지?
        ↓
Transformer


Transformer의 결과에서
다음 Token을 어떻게 정하지?
        ↓
Logits → Softmax → Probability


Token 하나를 예측해서
어떻게 긴 답변을 만들지?
        ↓
Next Token Prediction의 반복
        ↓
Generation
이렇게 보면 각각의 기술은 독립적으로 등장한 것이 아니다.
앞 단계에서 해결하지 못한 문제 때문에 다음 기술이 필요해진다.
그리고 앞으로의 시리즈에서는 이 질문을 조금 더 깊게 파고들 것이다.
각 기술을 공부할 때 사용할 흐름은 동일하다.
Why
 │
 │ 왜 필요한가?
 ▼
How
 │
 │ 어떻게 동작하는가?
 ▼
Code
 │
 │ 실제로 구현하면 어떻게 되는가?
 ▼
LLM
   LLM의 어디에서 사용되는가?
00편에서는 완성된 LLM의 Hood를 먼저 열어 전체 지도를 살펴봤다.
이제 01편부터는 이 지도 안에 있는 기술을 하나씩 꺼내 Why → How → Code → LLM의 순서로 살펴본다.
첫 번째 대상은 Vector다.
앞에서 우리는 자연스럽게 이런 말을 사용했다.
Token
 ↓
Embedding
 ↓
Vector
하지만 아직 중요한 질문에 답하지 않았다.
Vector는 정확히 무엇일까?
왜 언어를 하나의 숫자가 아니라 여러 숫자로 표현할까?
두 Vector가 비슷하다는 것은 무엇을 의미할까?
그리고 이 계산이 Attention과 RAG에서 어떻게 다시 등장할까?
다음 편에서는 이 질문을 시작으로 Vector, Matrix, Tensor, NumPy, Dot Product, Cosine Similarity, Softmax를 직접 다뤄본다.
그리고 각각의 수학 개념이 단순한 이론으로 끝나는 것이 아니라,
Dot Product
     ↓
Attention

Cosine Similarity
     ↓
Similarity Search
     ↓
RAG
처럼 이후 LLM 기술에서 어떻게 다시 등장하는지도 연결해볼 것이다.
Language → Number → Context → Generation
LLM의 전체 지도를 먼저 보고,
이제 그 안의 기술을 하나씩 꺼내본다.Why → How → Code → LLM
왜 필요한지 이해하고, 어떻게 동작하는지 살펴보고, 직접 구현해본 뒤 다시 LLM으로 돌아온다.
하나씩 Hood를 열어보자.