Introduction
기존 Video VLM 벤치마크는 비교적 일상적이고 예측 가능한 상황을 많이 다루기 때문에, 모델이 실제로 추론한 것인지 학습 데이터의 패턴을 재현한 것인지 구분하기 어렵다.
BlackSwanSuite는 사고, 장난 등 unexpected event를 활용해 VLM의 두 가지 reasoning 능력을 평가한다.
- Abductive reasoning: 제한된 관찰에서 가장 plausible한 설명을 찾는 것
- Defeasible reasoning: 새로운 증거가 들어오면 기존 가설을 수정하거나 폐기하는 것
Abduction = hypothesis generation
Defeasibility = hypothesis revision
논문은 하나의 관찰에 대해 여러 설명이 존재할 수 있음을 인정하면서도, abductive reasoning에서는 그중 가장 plausible한 설명을 찾는 데 초점을 둔다.
Tasks
비디오는 세 구간으로 나뉜다.
V_pre → V_main → V_post
- V_pre: 사건 이전
- V_main: unexpected event
- V_post: 사건 이후 결과
Forecaster
V_pre만 보고 다음 사건을 예측한다.
“What happens next?”
Detective
V_pre와 V_post를 보고 숨겨진 V_main을 추론한다.
“What happened in the middle?”
- Gen: 자유 형식 생성
- MCQ: 3개 선택지 중 선택
- Y/N: 기존 hypothesis의 유효성 판단
Detective는 주로 abductive reasoning을 평가하고, 새로운 evidence를 바탕으로 기존 hypothesis를 검증하는 과정에서는 defeasible reasoning도 평가한다.
Reporter
전체 비디오를 보고 사건을 설명한다.
- Gen
- MCQ
- Y/N
전체 evidence가 공개된 뒤 기존 hypothesis가 여전히 유효한지도 평가한다.
Dataset
BlackSwanSuite는 Oops! dataset의 test set에서 unexpected event가 하나 포함된 영상을 가져와 총 1,655개 비디오를 구성했다.
Annotation은 세 단계로 진행된다.
- V_pre만 공개 → 다음에 일어날 수 있는 hypothesis 3개 작성
- V_post 추가 공개 → 기존 hypothesis를 valid/invalid로 판단하고 필요한 경우 새로운 hypothesis 작성
- V_main 공개 → hypothesis를 다시 검증하고 실제 사건을 설명
Detective–Gen의 reference에는 V_post를 본 뒤에도 valid한 기존 hypothesis와 새롭게 작성된 hypothesis가 함께 포함된다.
Experimental Setup
MCQ와 Y/N은 accuracy로 평가하고, Generative task는 다음 metric을 사용한다.
- CLIP Score
- LLM-Match
- Human Evaluation
Human Evaluation에서는 다음 항목을 평가한다.
- Correctness
- Depth and Thoughtfulness
- Level of Detail
- Visual Entailment
CLIP Score는 여러 reference와 모델 답변 중 가장 높은 similarity를 사용한다. 저자들은 이를 통해 모델이 어떤 plausible explanation이라도 생성하면 보상하고자 했다.
평가 모델로는 GPT-4o, Gemini 1.5 Pro, LLaVA-Video, VILA, VideoChat2, VideoLLaMA 2 등을 사용했다.
Results
전반적으로 인간이 모델보다 높은 성능을 보였으며, 특히 Detective와 Reporter에서 차이가 컸다.
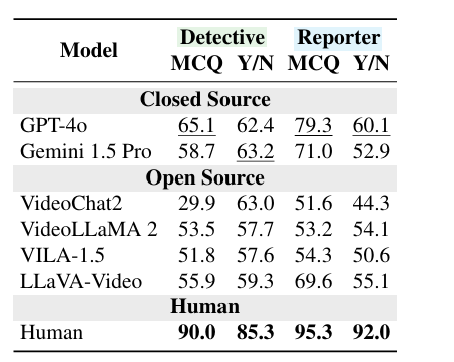
Detective에서 GPT-4o는 인간보다
- MCQ: 24.9%p
- Y/N: 26%p
낮았다.
Reporter에서도 각각 21%p, 32%p의 차이가 나타났다.
모델은 장면 전체의 흐름은 이해하더라도 누가 무엇을 했는지와 같은 세밀한 시각 정보를 구분하는 데 어려움을 보였다.
Generative Detective에서는 CLIP이나 LLM-Match상 모델과 인간의 차이가 크지 않았지만, Human Evaluation에서는 인간이 Correctness, Thoughtfulness, Detail에서 더 높은 평가를 받았다.
저자들은 reference-based metric이 reference와 다르지만 plausible한 답변을 낮게 평가할 수 있다는 한계도 언급한다.
Analysis
Detective를 풀기 위해서는 세 가지 능력이 필요하다.
Perception → Comprehension → Abductive Reasoning
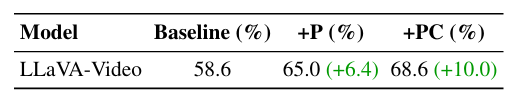
LLaVA-Video에 사람이 작성한 perception 정보를 제공하면 +6.4%p, perception과 comprehension을 모두 제공하면 +10%p 성능이 향상됐다.
이는 모델의 실패가 reasoning뿐 아니라 기초적인 시각 인식과 사건 이해 문제에서도 발생한다는 것을 보여준다.
Chain-of-Thought
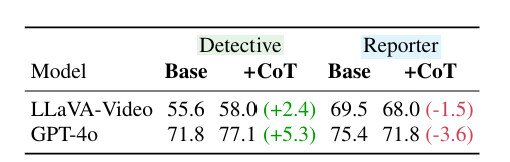
CoT는 Detective에서는 성능을 향상시켰지만 Reporter에서는 오히려 성능이 감소했다.
또 GPT-4o는 reasoning 과정에서 실제 visual evidence보다 일반적인 상식이나 사전 기대를 가정해 잘못된 결론을 내리는 경우가 있었다.
Hard Subset
저자들은 Detective 단계에서 생성된 모든 hypothesis가 Reporter 단계에서 invalidated된 사례를 hard subset으로 정의했다.
GPT-4o의 경우:
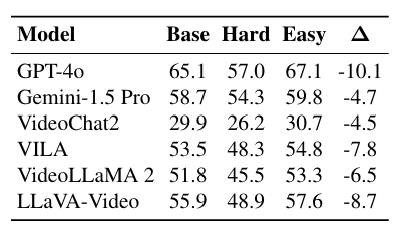
- Easy: 67.1%
- Hard: 57.0%
으로 hard subset에서 약 10.1%p 낮은 성능을 보였다.
저자들은 이를 통해 모델이 예측하기 어려운 unexpected event에서 더 큰 어려움을 겪는다고 분석한다.
Reasoning Types
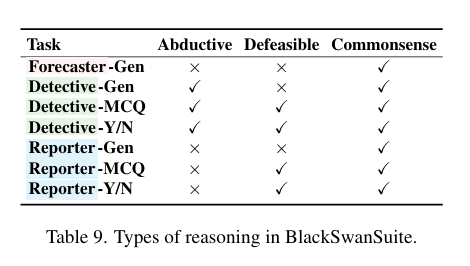
BlackSwanSuite의 각 task는 abductive reasoning, defeasible reasoning, commonsense reasoning 중 서로 다른 능력을 평가한다.
Detective
Detective는 와 를 바탕으로 숨겨진 사건 의 가장 plausible한 원인을 추론해야 하므로 abductive reasoning을 평가한다.
- Detective–Gen: abductive reasoning
- Detective–MCQ / Y/N: abductive + defeasible reasoning
특히 MCQ와 Y/N은 defeasible reasoning을 서로 다른 방식으로 평가한다.
- MCQ: 여러 hypothesis를 비교해 가장 적절한 것을 선택하는 상대적 판단
- Y/N: 새로운 context가 주어졌을 때 하나의 hypothesis가 여전히 유효한지 판단하는 독립적·절대적 판단
Reporter
Reporter는 전체 영상을 본 뒤 기존 hypothesis를 다시 검증한다.
따라서 Reporter–MCQ와 Reporter–Y/N은 defeasible reasoning을 평가하지만, 이미 이 공개되어 있기 때문에 abductive reasoning은 요구하지 않는다.
Forecaster / Reporter–Gen
Forecaster–Gen과 Reporter–Gen은 abductive·defeasible reasoning보다는 open-ended event prediction 또는 description을 평가한다.
또한 모든 task는 공통적으로 temporal processing과 visual commonsense reasoning, 특히 일반적이지 않은 사건을 이해하고 예측하는 능력을 평가한다.
Data Quality and Metrics
Data Quality Validation
저자들은 데이터셋 품질을 확인하기 위해 무작위로 선택한 60개 annotation을 두 명의 expert가 독립적으로 검증했다.
평가 기준은 다음과 같다.
- Correctness
- Level of Detail
- Grammar
검증 과정에서 일부 annotation은 낮은 영상 품질이나 annotator의 부주의 때문에 valid한 설명을 invalid로 판단하거나, 반대로 잘못 판단한 사례가 있었다.
또 일부 annotator가 실제 상황을 설명할 수 있는 obvious explanation을 놓치는 경우도 있었다.
Metrics
Generative task에서는 CLIP Score와 LLM-Match를 사용한다.
- CLIP Score: reference와 generated response의 semantic similarity를 계산
- LLM-Match: Llama 3.1 8B가 reference와 generated response의 의미 유사도를 1~5점으로 평가
LLM-Match는 pairwise score의 maximum이 아니라 mean을 사용해, 모델이 생성한 여러 답변의 다양성까지 함께 반영한다.
BLEU와 ROUGE도 함께 보고하지만, BlackSwanSuite의 generative task는 multiple valid answers가 존재하는 open-ended task이기 때문에 표현이 다른 정답을 낮게 평가할 수 있다.
따라서 저자들은 BLEU/ROUGE가 generative reasoning 성능을 정확히 평가하기에는 한계가 있다고 본다.
Human Evaluation and Baselines
Human Evaluation
Generative task의 human evaluation은 네 가지 기준으로 진행된다.
- Correctness: 주어진 영상 정보에 기반해 가능한 사건을 올바르게 설명하는가
- Depth and Thoughtfulness: 설명에 충분한 reasoning이 포함되어 있는가
- Level of Detail: 사람, 물체, 행동을 구분할 정도로 구체적인가
- Visual Contradiction: 설명이 영상 내용과 모순되는가
평가자는 자신의 판단에 대한 이유도 작성해야 했으며, 초기 평가를 통해 성실하게 task를 수행한 32명의 annotator를 선별해 이후 평가에 사용했다.
비용 문제로 각 비디오를 여러 annotator가 반복 평가하지는 못했으며, 대신 추가적인 qualitative analysis를 수행했다.
Baselines
평가에는 closed-source와 open-source VLM을 모두 사용했다.
Closed-source
- GPT-4o
- Gemini 1.5 Pro
Open-source
- VideoChat2
- VideoLLaMA 2
- VILA
- LLaVA-Video
모델에 따라 전체 비디오를 직접 입력하거나 여러 frame을 sampling해서 제공했다. Detective에서는 공통적으로 을 숨긴 상태에서 와 만 볼 수 있도록 구성했다.
Generative task에서는 매번 동일한 답만 생성하지 않도록 sampling을 사용했다.
Task Prompts
Task별 prompt도 비교적 직접적으로 구성되어 있다.
- Forecaster–Gen: 다음에 어떤 일이 일어날 수 있는지 설명
- Detective–Gen: 숨겨진 중간 frame에서 무슨 일이 있었는지 설명
- Detective–MCQ: hidden frame을 가장 잘 설명하는 선택지 선택
- Detective–Y/N: 주어진 hypothesis가 영상에 비추어 성립하는지 Yes/No 판단
- Reporter–Gen: 전체 영상에서 무슨 일이 일어나는지 설명
- Reporter–MCQ / Y/N: 전체 context를 바탕으로 설명이나 hypothesis를 검증
Additional Results
Qualitative Results
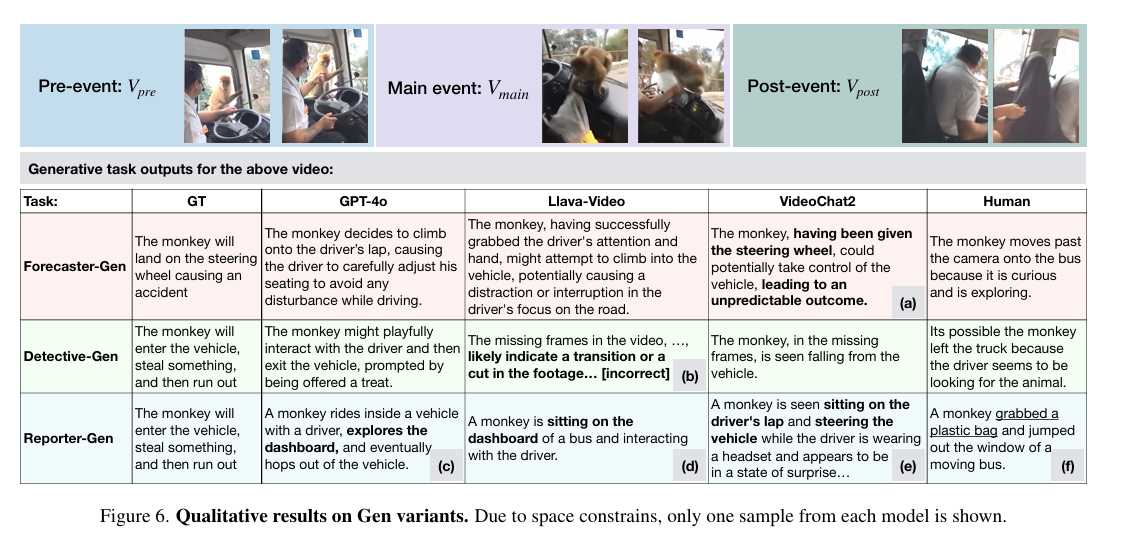
Generative task의 qualitative result를 보면, 모델은 Forecaster–Gen에서는 다음에 일어날 일을 비교적 그럴듯하게 예측하지만 불확실성이나 hallucination이 섞이는 경우가 있다.
예를 들어 VideoChat2는 실제로 보이지 않은 “운전대를 건네받았다”는 행동을 만들어냈고, 동시에 “unpredictable outcome”처럼 불확실한 표현을 사용했다. 저자들은 uncertainty 자체는 틀린 것은 아니지만, 질문을 회피하는 방식으로 나타날 수 있다고 지적한다.
Detective–Gen에서는 LLaVA-Video가 missing frame에서 무슨 일이 있었는지 추론해야 하는 지시를 잘못 이해하고, 오히려 왜 frame이 빠져 있는지를 설명하는 오류를 보였다.
Reporter–Gen에서는 모든 모델이 원숭이가 비닐봉지를 집어 들고 차량에서 나가는 2초 미만의 순간적인 핵심 사건을 놓쳤다. 반면 human response는 이 사건을 명확하게 설명했다.
Additional Quantitative Results
LLaVA-Video의 72B 모델과 7B 모델도 비교했다.
무작위로 선택한 MCQ와 Y/N 데이터 20%에서 72B 모델은 7B보다 전반적으로 높은 성능을 보였으며, 일부 결과는 가장 좋은 closed-source 모델에 가까운 수준까지 향상됐다.
즉 모델 규모를 키우면 성능이 개선되지만, BlackSwanSuite의 reasoning task 자체가 완전히 해결되는 수준은 아니었다.
Perception and Comprehension Analysis
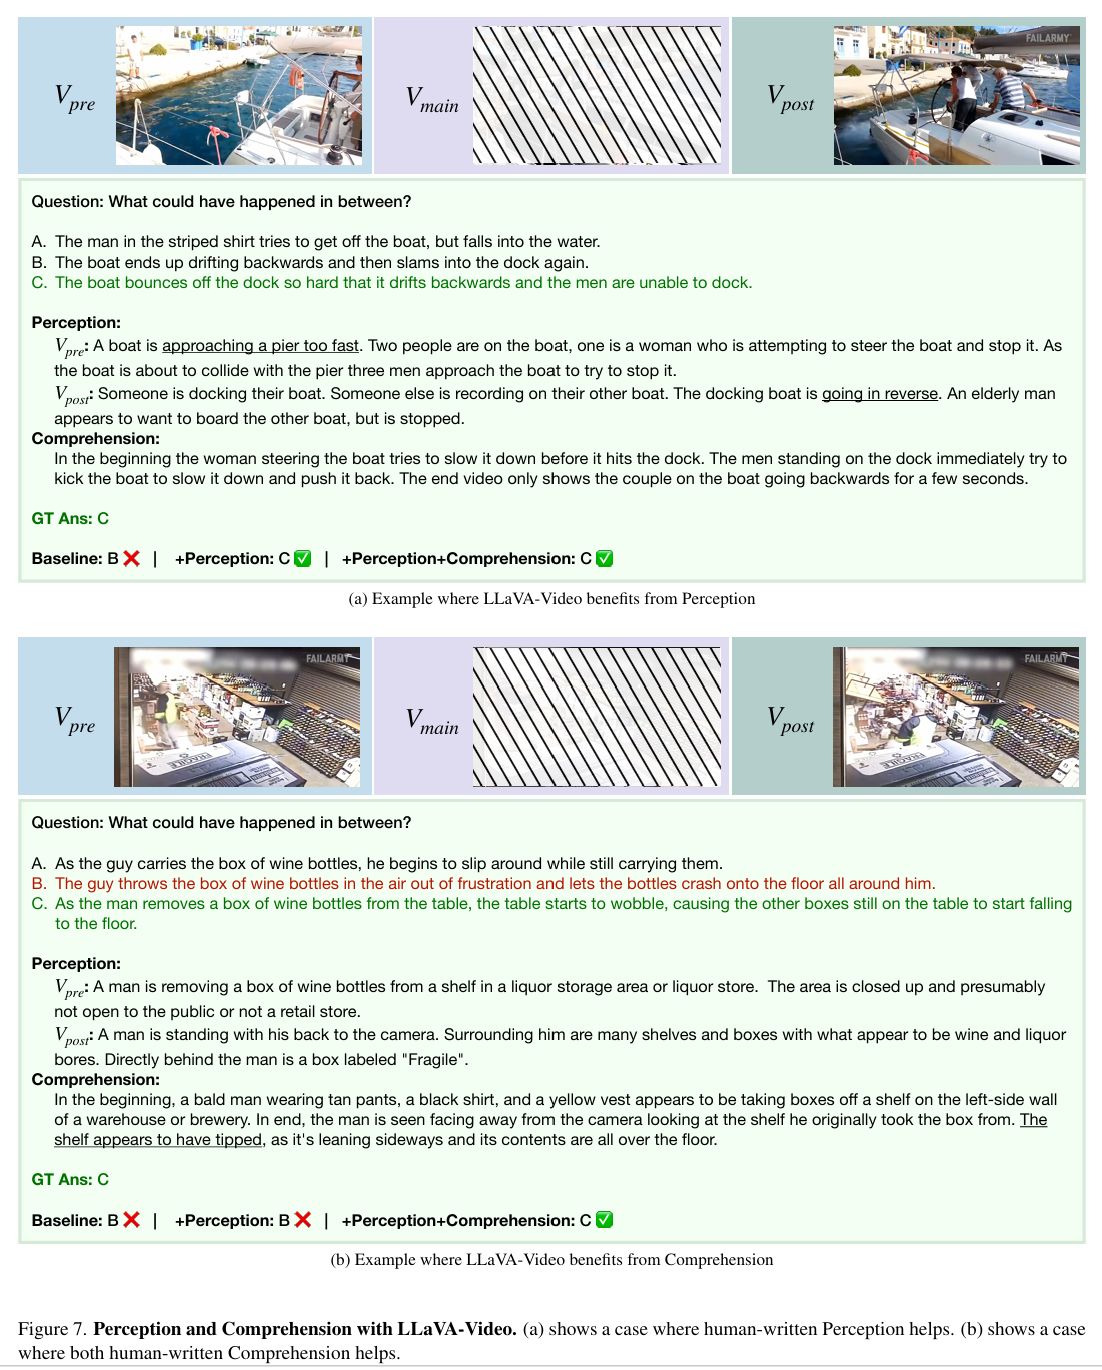
저자들은 Detective의 실패가 단순한 reasoning 문제인지 확인하기 위해, 모델에 human-written perception과 comprehension 정보를 추가로 제공했다.
첫 번째 사례에서는 baseline이 오답이었지만, 와 에 대한 사람의 perception description을 제공하자 정답을 맞혔다.
두 번째 사례에서는 perception 정보만으로는 여전히 틀렸지만, 앞뒤 장면의 차이를 설명한 comprehension 정보까지 추가했을 때 정답으로 바뀌었다.
이를 통해 Detective의 실패가 abductive reasoning 자체뿐 아니라, 영상의 세부 정보를 인식하고 앞뒤 변화 관계를 이해하는 과정에서도 발생할 수 있음을 보여준다.
Additional Quantitative Results
LLaVA-Video의 7B와 72B 모델을 비교한 결과, 더 큰 72B 모델이 일부 task에서는 성능이 향상됐지만 모든 평가에서 일관되게 좋아지지는 않았다.
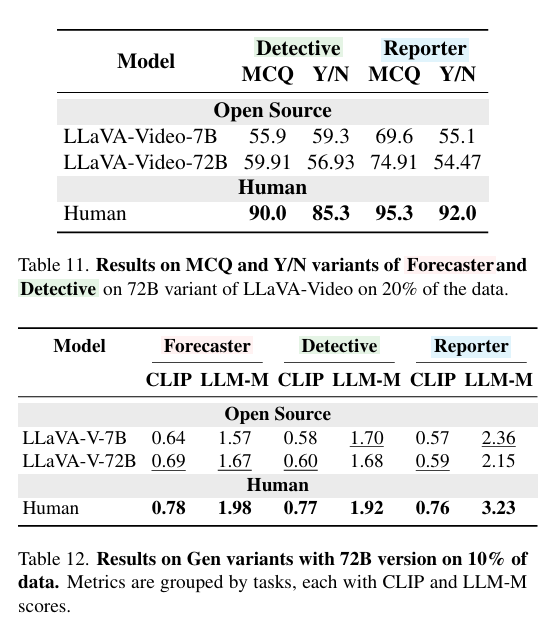
예를 들어 Detective에서는
- MCQ: 55.9 → 59.91
- Y/N: 59.3 → 56.93
으로 MCQ는 향상됐지만 Y/N은 오히려 감소했다.
Generative task에서도 72B가 7B보다 일부 CLIP Score에서는 높았지만, LLM-Match에서는 큰 차이가 없었다. 저자들은 전반적으로 72B와 7B의 generative 성능이 비슷한 수준이라고 분석한다.
즉 model scaling이 일부 성능 향상에는 도움이 되지만, abductive / defeasible reasoning 성능을 안정적으로 개선하는 것은 아니다.
Dataset Split
BlackSwanSuite는 validation과 test set을 약 절반씩 나눈다.
-
Validation set: 827 videos
- GT label 공개
- Hard subset 95개
-
Test set: 828 videos
- GT label 비공개
- Hard subset 224개
Test set에는 hard subset이 더 많이 포함되어 있어 validation set보다 상대적으로 더 어렵게 구성되어 있다.
Analysis Details
Perception / Comprehension
저자들은 Detective–MCQ에서 모델의 실패 원인을 분리하기 위해 사람이 작성한 perception description과 comprehension description을 prompt에 추가했다.
- Perception: , 에 무엇이 보이는지 설명
- Comprehension: 두 구간 사이에 어떤 변화가 발생했는지 설명
이 정보를 추가했을 때 LLaVA-Video의 성능이 향상되어, abductive reasoning 이전의 visual perception과 event understanding 자체도 중요한 병목임을 확인했다.
Chain-of-Thought
GPT-4o의 CoT 사례를 분석한 결과, step-by-step reasoning이 올바른 답을 유도하는 경우도 있었지만 장면에 대한 사전 기대(preconception)가 reasoning에 개입해 오답으로 이어지는 경우도 있었다.
즉 CoT가 항상 visual evidence에 충실한 reasoning을 보장하지는 않았다.
Limitations
저자들은 다음과 같은 한계를 제시한다.
- Data Source: Oops! dataset의 기존 영상을 사용하기 때문에, 일부 VLM이 유사한 영상을 pre-training 과정에서 이미 접했을 가능성이 있다.
- Evaluation Metrics: Accuracy는 reasoning 과정의 깊이나 논리성을 직접 측정하지 못하고, generative task의 metric 역시 open-ended explanation의 미묘한 차이를 충분히 평가하기 어렵다.
- Human Evaluation: Generative task는 여러 답이 가능한 만큼 human evaluation에도 bias가 개입할 수 있다.
- Pre-training: 평가 모델들이 abductive / defeasible reasoning을 직접적으로 학습한 모델은 아니기 때문에, 낮은 성능이 학습 방식의 영향일 수 있다.
- Explanation Complexity: 현재 annotation은 free-form explanation 중심이며, intuitive physics와 같은 더 구조화된 reasoning은 다루지 않는다.
- Size and Diversity: 15,469개의 질문을 포함하지만 매우 드물고 다양한 unexpected event를 모두 대표하기에는 한계가 있다.
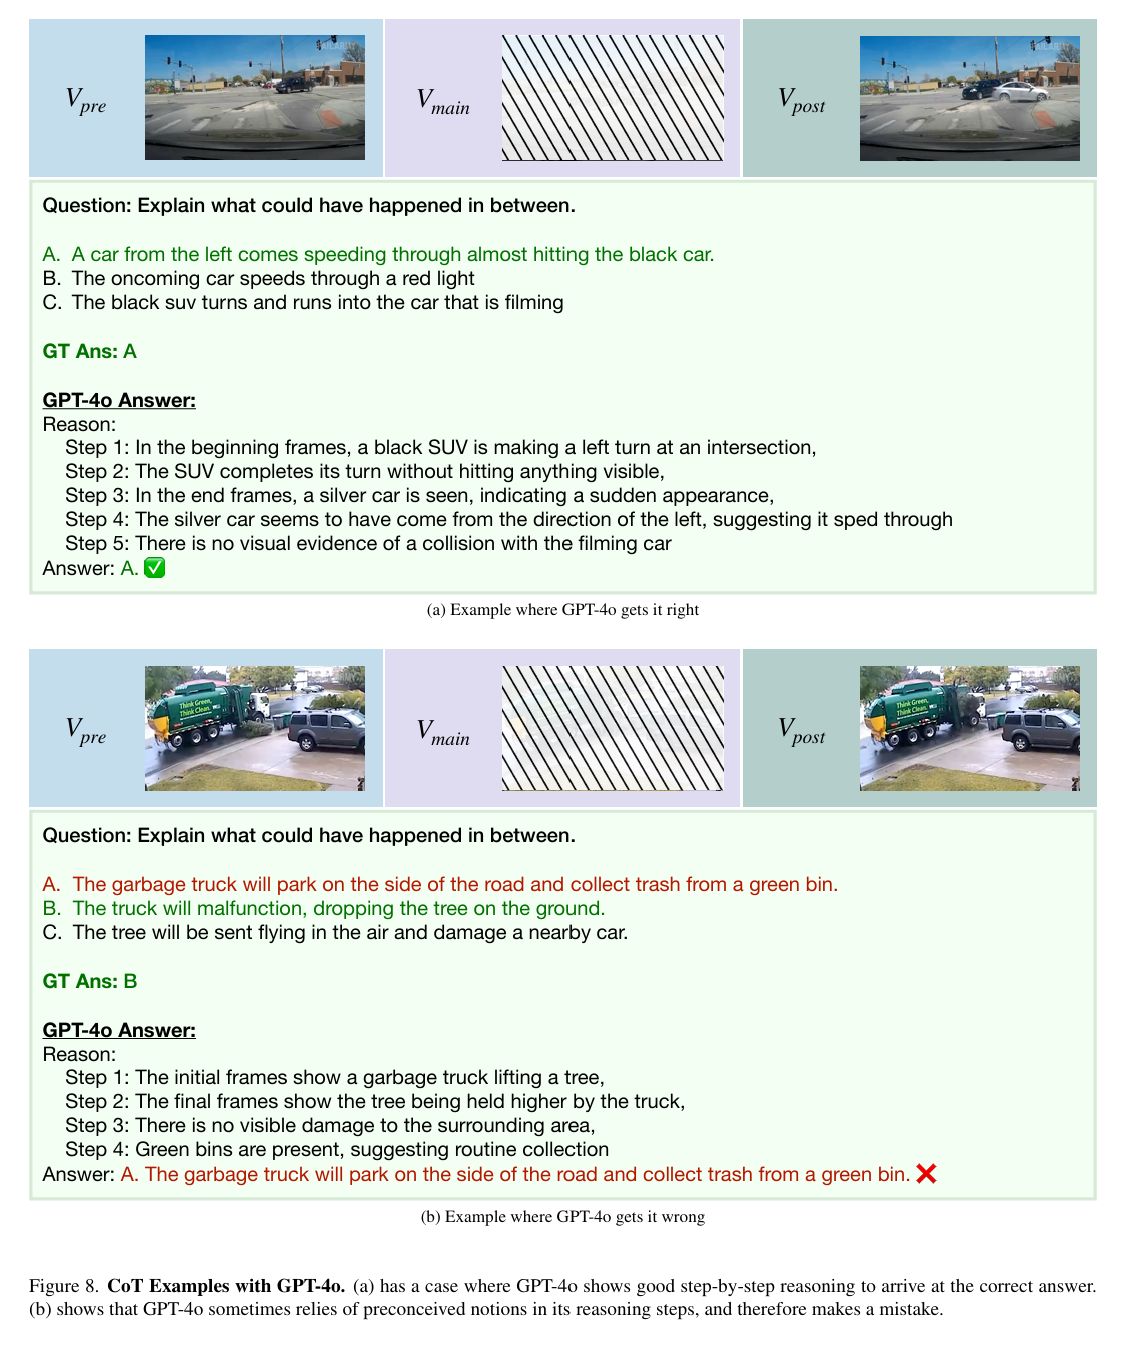
Chain-of-Thought Analysis
GPT-4o에 CoT를 적용하면 일부 사례에서는 step-by-step reasoning을 통해 올바른 답에 도달한다.
하지만 다른 사례에서는 실제 visual evidence보다 장면에 대한 사전 기대나 일반적인 상식에 의존해 오답을 선택하기도 한다.
예를 들어 쓰레기차가 등장한 영상에서 GPT-4o는 “쓰레기차는 보통 쓰레기를 수거한다”는 일반적인 패턴에 끌려 실제 unexpected event인 차량 고장을 놓쳤다.
즉 CoT가 reasoning 과정을 늘려주기는 하지만, 그 과정이 항상 visual evidence에 충실한 것은 아니다.