Paper Notes
1.Black Swan: Abductive and Defeasible Video Reasoning in Unpredictable Events
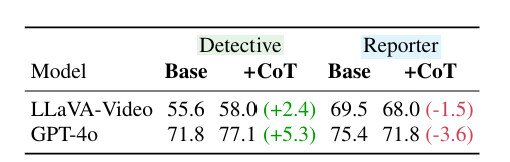
이전에 검토했던 Video VLM 연구 방향에서 참고한 논문이다. 현재는 해당 주제를 진행하고 있지는 않지만, unexpected event에서의 abductive / defeasible reasoning을 다룬 benchmark라는 점이 흥미로워 간단히 정리해둔다.
2026년 8월 28일
2.DeepSeekMath: Pushing the Limits of Mathematical Reasoning in Open Language Models (24.02)
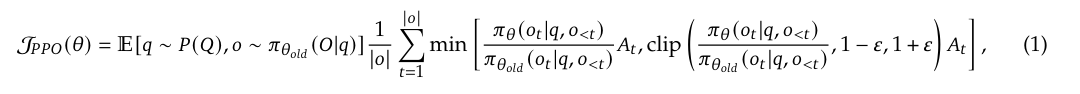
PPO에서 출발해 GRPO가 왜 필요한지, Critic 없이 group reward로 Advantage를 계산하는 과정과 Outcome/Process Supervision까지 정리합니다.
2026년 9월 16일
3.Neural Discrete Representation Learning
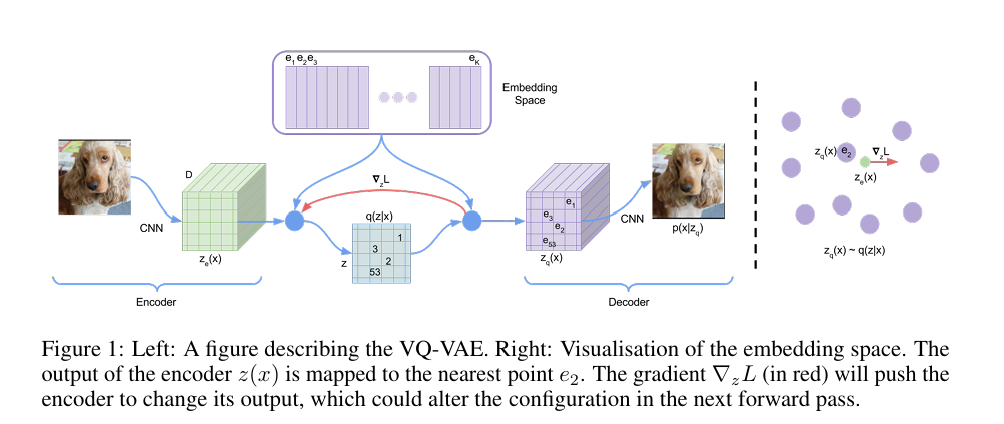
VQ-VAE의 discrete latent, Vector Quantization, Straight-Through Estimator와 이미지·음성 실험을 중심으로 정리했다.
2026년 9월 20일
4.BLIP-2: Bootstrapping Language-Image Pre-training with Frozen Image Encoders and Large Language Models(2023)

1. Problem: Frozen Model 사이의 Modality Gap 대규모 VLP 모델을 End-to-End로 학습하면 Image Encoder와 Language Model 양쪽을 업데이트해야 하므로 학습 비용이 커진다. BLIP-2는 이미 강력한 Pretra
2026년 9월 21일
5.LLAVA - Visual Instruction Tuning (NeurIPS 2023)
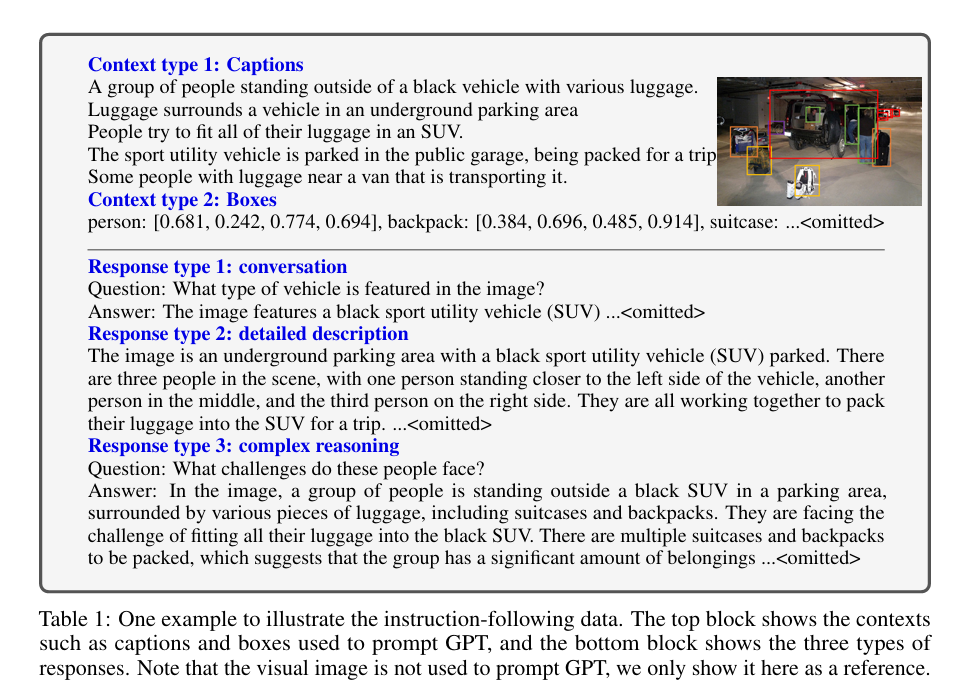
GPT-4로 visual instruction data를 생성하고 CLIP과 Vicuna를 연결해, 이미지 이해를 넘어 사용자의 자연어 지시를 따르는 multimodal assistant를 만든 LLaVA를 정리한다.
4일 전
6.Dream to Control: Learning Behaviors by Latent Imagination (ICLR 2020)
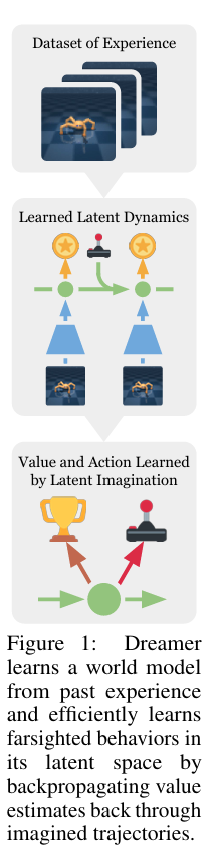
Dreamer는 latent space에서 미래를 상상하고, 장기 value의 gradient를 Actor까지 역전파해 policy를 학습하는 model-based RL 방법이다.
약 9시간 전