
- 서비스 URL: https://ai-examgenerator.co.kr/
- 운영 인프라: Naver Cloud Platform (VPC, s2-g3a 인스턴스) 기반 무중단 운영
- 기술 스택 총괄: FastAPI + React 19 (TypeScript) + Redis Queue + PostgreSQL
1. 들어가며: 왜 프로덕션을 다시 뜯어고쳤는가
기존에 가동되던 MVP(최소 기능 제품) 모델은 '기능의 작동' 측면에서는 문제가 없었다. PDF를 올리면 문제가 추출되었고, 버튼을 누르면 시험지가 만들어졌다. 하지만 실제 유저(학원 강사 및 교육자)들이 유입되어 장시간 화면 체류를 하며 수십 개의 시험지를 동시에 편집하고, AI 변형 문제를 대량으로 생성하기 시작하자 숨겨져 있던 아키텍처적 한계와 병목이 무더기로 쏟아졌다.
가장 큰 문제는 장시간 텍스트와 지문을 읽어야 하는 교육 플랫폼의 도메인 특성을 간과한 다크 네이비 테마(#050A14)였다. 개발자에게는 익숙할지 몰라도, 한밤중에 문제 출제를 위해 화면을 째려봐야 하는 강사들에게는 눈의 피로도를 극대화하는 주범이었다.
여기에 프론트엔드 컴포넌트 곳곳에 하드코딩된 상태 관리와 useEffect 기반의 무분별한 API 요청은 서버 가용 자원을 갉아먹고 있었다. 단순한 코드 쪼개기 식의 리팩토링이 아니라, 사용자가 비용을 지불하고 쓸 만한 '프리미엄 상용 서비스(Production Ready)' 수준으로 인프라와 프론트엔드 데이터 흐름을 끌어올리기 위해 밤새며 진행했던 대대적인 구조 개편과 디버깅의 기록을 기술 덤프 형태로 담백하게 남겨둔다.
2. Phase 1: 비주얼 프리미엄 리디자인 및 레이아웃 패러다임 변화
2.1 하드코딩된 스타일의 부채와 Tailwind v4 시스템화
-
문제 상황 (Problem):
초기 코드 베이스는 빠르게 화면을 뽑아내기 위해 디자인 시스템 정의 없이 작업을 진행했다. 그 결과 컴포넌트 내부 곳곳에 인라인 스타일이나 파편화된 색상값들이 무차별적으로 흩어져 있었다. 전면적인 라이트 테마(White Theme) 리뉴얼이 결정되었을 때, 이 하드코딩된 값들이 전방위적인 발목을 잡았다. 배경색 하나를 바꾸기 위해 수십 개의 파일 내부 인라인 스타일을 수동으로 전수조사해야 하는 전형적인 '디자인 기술 부채'였다. -
해결 채널 (Solution):
기존의 어두운 테마를 완전히 배제하고, 교육 플랫폼 특유의 깨끗하고 명확한 인상을 주기 위해 화이트(White) 배경과 Premium Blue (#0064FF)를 메인 브랜드 컬러로 낙점했다. 코드의 지속 가능성을 위해 Tailwind CSS v4의 @theme 지시어를 도입하여 파편화된 디자인 리소스를 전역에서 선언적으로 자산화했다.
[테마 선언 세부 구조]
- brand-50: #EFF6FF (연한 블루 강조 배경)
- brand-100: #DBEAFE (배지 및 컴포넌트 아웃라인)
- brand-600: #0064FF (브랜드 메인 컬러)
- brand-700: #0050CC (버튼 호버 및 액션 상태)
- 주 그라디언트: 135도 각도의 #0064FF에서 #7C3AED(바이올렛) 연동
인라인으로 박혀있던 하드코딩 색상들을 bg-brand-50, text-brand-600 형태의 시맨틱 클래스로 전면 전환했다. 라이트 테마가 자칫 심심하고 평면적인 인상을 주는 문제를 해결하기 위해 UI 디테일에 입체감을 더했다.
주요 대시보드 카드 상단에는 h-0.5 규격의 수평 그라디언트 액센트 라인을 심어 시선이 분산되는 것을 막았고, 로그인 및 회원가입 피처 패널 배경에는 radial-gradient와 blur-3xl, opacity-40 효과를 유기적으로 조합한 배경 글로우 오브(Glow Orb) 아트를 은은하게 깔아 유저가 시각적으로 프리미엄 대시보드에 진입했다는 공간감을 연출했다.
2.2 공간 확보를 위한 Sidebar 제거 및 Top Nav 아키텍처 전환
- 의사결정 배경 (Background):
수능형 출제 툴의 프론트엔드가 가진 가장 독특한 제약 조건은 바로 '지문(Passage)과 문항(Question)의 비대칭적 레이아웃 보장'이다. 장문의 영어 독해 지문이나 복잡한 국어 비문학 지문 하나가 좌측에 배치되면, 우측에는 그 지문에 종속된 새끼 문제 2~3개가 묶음 형태로 나열되어야 한다.
기존의 고정형 좌측 사이드바(Sidebar) 구조는 데스크톱 가로 화면 영역 중 무려 260px 이상을 무조건 선점하고 시작했기에, 정작 중요한 시험지 편집기(ExamBuilderPage) 화면에서 지문 카드와 문제 카드가 가로로 찌그러지며 극심한 레이아웃 붕괴를 유발했다. 강사들은 지문을 읽기 위해 마우스 스크롤을 끝없이 내려야 했다.
- 리팩토링 방향:
콘텐츠 가로폭의 한계를 깨부수기 위해 기존 좌측 사이드바 구조를 도끼로 찍어내듯 전면 제거하고, 모든 메인 메뉴를 상단 헤더 영역으로 통합하는 상단 네비게이션(Top Nav) 패러다임으로 대대적인 뼈대 공사를 진행했다.
그 결과 가로 가용 영역이 100% 온전히 확보되면서 좌측 지문 스트림 pool과 우측 문항 스트림 pool이 황금 비율로 유연하게 늘어나는 반응형 2단 레이아웃을 완성했다.
- 사용자 경험(UX) 마이크로 튜닝:
플랫폼의 브랜딩 퀄리티를 디테일하게 조정하기 위해 유저와의 소통 어조를 시스템적으로 분리했다. 사용자가 직관적으로 가이드를 받고 액션을 취하는 프론트엔드 UI 컴포넌트와 모달 안내 구문에는 다정하고 자연스러운 '해요체'("문제를 분석하고 있어요. 잠시만 기다려 주세요.")를 일관되게 적용했다.
반면, 예외 처리 팝업, 보안 가드레일 경고, 토스페이먼츠 결제 승인 확인 등 시스템의 무결성과 신뢰성이 최우선으로 담보되어야 하는 핵심 커널 레이어에는 엄격한 '합쇼체'("인증에 실패하였습니다. 관리자에게 문의하십시오.")를 구분 사용하여 유저가 플랫폼에 느끼는 무의미한 불확실성을 미세한 수준까지 정제했다.
3. Phase 2: 비동기 데이터 관리 및 네트워크 요청 제어 고도화
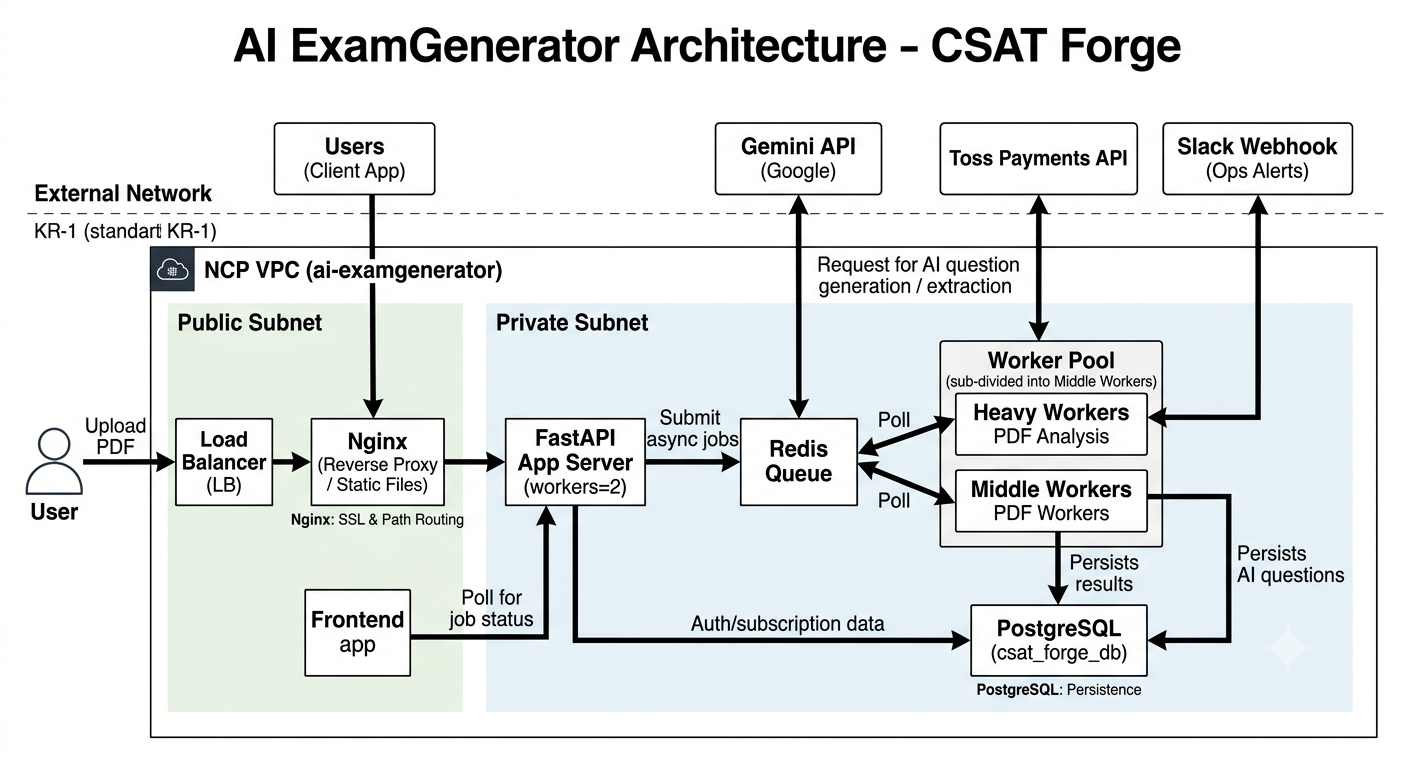
[AI ExamGenerator 전역 인프라 아키텍처 및 비동기 Job Queue 토폴로지]
💡 사용 가이드: 이 아키텍처는 NCP Private Subnet에 격리된 FastAPI 앱 서버와 Redis 큐, 그리고 Heavy/Middle 워커 풀이 데이터 스토리지 및 외부 Gemini API와 상호작용하는 물리적 흐름을 명시합니다.
3.1 useEffect 기반 데이터 패칭의 한계와 TanStack Query v5 전면 도입
- 직면한 구조적 병목 (Challenge):
초기 대시보드와 세션 상세 화면은 21개가 넘는 라우팅 페이지 내부에서 비동기 데이터를 가져오기 위해 커스텀 상태와 useEffect 훅을 복잡하게 난사하고 있었다.
당시 소스 코드는 컴포넌트 내부에서 비동기 fetch가 발생할 때 컴포넌트 상태에 데이터 의존성이 결합되어 있었다. 이 방식은 컴포넌트가 사소한 로컬 state 변경으로 인해 재렌더링될 때마다 무의미한 중복 HTTP 요청을 서버로 날렸고, 프론트엔드 단에 캐싱 레이어가 아예 없다 보니 페이지를 이동할 때마다 화면 전체가 하얗게 깜빡거리며 덜컹거리는 플리커링(Flickering) 현상이 심각했다. 데이터 소유권과 정합성이 컴포넌트 생명주기에 완전히 종속되어 있어 데이터가 조금만 꼬여도 디버깅이 불가능한 임계점에 부딪혔다.
- 구조적 개선 (Solution):
과감하게 모든 비동기 상태 코드를 걷어내고 React Query (TanStack Query v5)로 전면 마이그레이션을 단행했다. 우선 데이터 캐시 상태의 무결성을 격리하기 위해 src/lib/queryClient.ts와 캐시 키를 중앙 제어하는 src/lib/queryKeys.ts 팩토리를 신설했다.
[중앙화 캐시 키 구조 설계 명세]
- sessionKeys.all: ['sessions'] 고정 레이어
- sessionKeys.lists: ['sessions', 'list'] 배열 매핑
- sessionKeys.detail(id): ['sessions', 'detail', id] 1대1 매핑 구조화
전역에 일관된 캐싱 정책을 주입하여 한 번 가져온 세션 목록과 시험지 리스트는 메모리에 안전하게 유지되도록 구조화했고, 유저가 페이지를 이동하더라도 깜빡임 없이 즉시 스냅샷 데이터를 보여주어 체감 렌더링 속도를 극대화했다.
- 스마트 폴링 최적화 (Polling Optimization):
유저가 업로드한 PDF 기출문제 데이터는 백엔드 내부에서 Redis Queue를 거쳐 Heavy Worker 프로세스들이 백그라운드로 소화하는 구조다. 따라서 프론트엔드는 워커의 연산이 끝날 때까지 서버의 세션 상태가 ANALYZING에서 DONE으로 바뀌는지 지속적으로 체크해야 하는 숙명이 있었다.
기존 브라우저의 setInterval 타이머 기반 폴링은 컴포넌트가 언마운트되거나 예기치 못한 네트워크 단절(401 Unauthorized, 503 Service Unavailable 등)이 터져도 타이머 객체가 브라우저 메모리에 좀비처럼 살아남아 서버로 무차별 쿼리를 연사하는 결함이 있었다.
이 문제를 해결하기 위해 useQuery의 선언적 옵션인 refetchInterval 매커니즘을 적극 활용하여 폴링 파이프라인을 완전히 지능화했다. queryFn 내부에 수동 타이머 가동 로직을 전부 걷어내는 대신, 수신된 세션 데이터 모델 구조 내부의 status 필드값이 정확히 'ANALYZING'일 때만 3000ms(3초) 주기로 자동 리페치 오퍼레이션을 트리거하도록 설계하고, staleTime을 5000ms로 조율했다.
이 패턴 도입 후, 작업이 진행 중일 때만 네트워크 파이프라인이 정밀하게 가동되고, 작업 완수(DONE) 혹은 에러 처리 시 즉시 백엔드 트래픽 링크가 차단되어 무의미한 DB 데드락 및 커널 소켓 고갈 부하를 완전히 차단할 수 있었다.
3.2 AbortController 스키마를 활용한 데이터 경쟁 상태(Race Condition) 방지
- 잠재적 결함 발견 (Edge Case):
유저의 네트워크 레이턴시가 요동치는 실서버 상용 인프라 환경에서 심각한 상태 꼬임 버그가 제보되었다. 사용자가 대시보드 화면에서 네트워크 응답 속도가 느린 '세션 전체 목록' 메뉴를 클릭한 직후, 서버 응답이 미처 오기 전에 재빨리 바로 아래에 있는 '시험지 전체 목록' 메뉴를 연속으로 타다닥 클릭했을 때 발생했다.
브라우저 네트워크 스레드는 뒤늦게 도착한 '세션 전체 목록'의 HTTP 응답 객체를 수신하고 프론트엔드 상태(State)를 뒤늦게 업데이트해 버렸다. 결과적으로 주소창과 화면 헤더는 '시험지 목록' 페이지를 가리키고 있는데, 정작 본문 데이터 카드는 '세션 목록'의 내용이 출력되어 버리는 치명적인 데이터 경쟁 상태(Race Condition) 현상이었다.
- 해결 메커니즘 (Cancellation Pattern):
React Query v5 레이어로 진입하면서 모든 백엔드 API 통신 전용 Axios 함수가 웹 표준 인터페이스인 AbortSignal을 필수적으로 주입받아 하부 네트워크 소켓에 바인딩하도록 시그니처 아키텍처를 강제했다.
데이터를 호출하는 통신 컨텍스트 함수에 인자로 signal 객체를 열어두고, axios.get 요청 구조의 옵션 프로퍼티 필드에 { signal } 인스턴스를 다이렉트로 바인딩 결합을 명시했다.
이 구조 하에서는 유저가 특정 메뉴를 클릭해 비동기 요청을 발생시킨 후, 응답이 완료되기 전에 다른 페이지로 넘어가거나 컴포넌트를 이탈(언마운트)하는 순간 React Query가 자동으로 해당 단계를 인지하고 하부 브라우저 소켓 단에 AbortController.abort() 인스턴스 시그널을 즉시 날려버린다.
네트워크 레벨에서 뒤늦게 날아오는 낙오 응답 패킷들을 브라우저가 수신 단계에서 다이렉트로 폐기(Cancel) 처리함으로써 상태 꼬임 현상을 완벽히 방어해 냈고, 서버 자원의 불필요한 IO 대기 병목까지 우아하게 해결하는 성과를 거두었다.
4. Phase 3: AI 파이프라인 및 문서 렌더링 혁신 (수식 및 레이아웃과의 전쟁)
4.1 웹 렌더링의 한계와 LaTeX 수식 디버깅 (The PNG Bridge 아키텍처)
-
직면한 장애 (Problem):
우리 서비스의 핵심 가치는 AI가 수능 및 모의고사 기출 PDF를 완벽하게 분석하고, 문맥과 난이도를 보존한 채 신규 변형 문제를 생성하는 것이다. 하지만 수학, 과학, 경제 지문에 필수적으로 포함되는 LaTeX 수식 기호( 등)가 가장 거대한 기술적 장벽이었다.
웹 화면에서는 KaTeX 라이브러리를 통해 실시간으로 수식이 미려하게 렌더링되었지만, 유저가 시험지 편집을 모두 마치고 'Microsoft Word(.docx) 파일로 내보내기'를 실행하는 순간 대형 결함이 터졌다. Word 문서 내부에서 수식 전체가 깨진 외계어 문자열이나 가공되지 않은 생형태의 텍스트 코드(\frac{a}{b}등)로 노출되는 현상이었다. Word 파일 표준 포맷(OpenXML)은 웹 표준 CSS나 브라우저 기반의 수학 렌더링 엔진을 전혀 인지하지 못하기 때문에 발생하는 고질적인 인프라 불일치 문제였다. -
아키텍처적 해결 기법 (Solution - Hybrid Rendering):
텍스트 포맷으로 수식을 전달하는 방식을 과감히 포기하고, 수식 영역만 고해상도 투명 PNG 이미지 바이너리로 동적 가공하여 Word 문서 내부에 바이너리 스트림으로 직접 이식하는 하이브리드 렌더링 아키텍처, 일명 'The PNG Bridge' 메커니즘을 고안하고 구현했다.
[The PNG Bridge 파이프라인 제어 단계]
1. 정규식 기반 수식 적출: 백엔드 파이프라인 내부에서 지문과 문제 오프셋을 파싱하여 달러 기호로 감싸진 LaTeX 문장 영역만 정밀하게 정규식 스캔으로 추출한다.
2. Headless Chromium 이미지화: 백엔드 워커 풀 하부에 Puppeteer(Headless Chromium)와 경량화된 KaTeX 자산만 탑재한 독립 렌더링 프로세스를 가동했다. 적출된 수식 문자열을 이 미니멀 렌더러에 통과시켜, 글자 배경이 투명하게 처리된 300dpi 이상의 고해상도 수식 PNG 이미지를 동적으로 추출해 낸다.
- 결정적 블라인드 스팟 디버깅 (Redis Binary Corruption):
매번 사소한 수식 하나를 새로 그릴 때마다 Puppeteer 프로세스를 대기 상태에서 깨워 연산하는 것은 극심한 CPU 오버헤드와 자원 병목을 유발했다. 이를 방지하기 위해 수식 원문 문자열을 MD5 해시 토큰으로 치환하여, 한 번 생성된 수식 PNG 바이너리를 Redis에 24시간 동안 보관하는 캐시 레이어를 추가했다.
그러나 캐시 레이어 도입 직후 특정 수식 이미지들이 엑스박스로 뜨며 바이너리가 통째로 깨지는 장애를 마주했다. 원인을 패턴 인식으로 역추적한 결과, 백엔드 전역에서 Redis 연결 시 사용하던 decode_responses=True 옵션이 주범이었다. Redis 클라이언트가 수식 이미지용 순수 PNG 바이너리 데이터까지 UTF-8 문자열로 강제 디코딩을 시도하면서 바이트 스트림이 왜곡되어 깨지는 현상이었다.
이를 해결하기 위해 일반 텍스트 및 세션 상태용 Redis 클라이언트와 별개로, 바이너리 전용 데이터 처리를 위해 decode_responses=False 옵션을 부여한 바이너리 전용 Redis 클라이언트 인스턴스를 엄격히 분리 운영하도록 서버 소켓 레이어를 수정했다. 이후 수식 이미지 로딩 레이턴시가 획기적으로 제거되며 Cache Hit 시 완전히 0ms에 수렴하는 극적인 성능 개선을 달성했다.
4.2 수능 표준 인프라 규격 구현: 2단(2-Column) 레이아웃 밸런서 알고리즘
-
도전 과제 (Challenge):
실제 상용 환경에서 유저들이 편집 툴에 기대하는 결과물의 퀄리티는 단순히 줄글로 정렬된 문서가 아니었다. 실제 한국교육과정평가원 모의고사나 수능 시험지와 완벽하게 동일한 구조를 가진 좌/우 2단(2-Column) 레이아웃 출력을 필수적으로 요구했다. 웹 화면의 유연한 반응형 배치를 엄격한 인쇄 여백 규격 및 단 구분에 맞춰 통제해야 하는 고난도 레이아웃 제어 알고리즘이 필요했다. -
알고리즘 반영 및 트레이드오프:
Puppeteer의 프린트 미디어 쿼리와 CSS Paged Media 표준 스펙을 서비스 커스텀 형태로 확장 가공하여 두 가지 핵심 문제를 격파했다.
첫 번째는 단절 방지(keepNext 매커니즘) 구현이다. 문제 컨테이너가 좌측 단 맨 아래 경계선에 애매하게 걸칠 경우, 지문 텍스트는 좌측 단 맨 밑에 남고 ①~⑤번 정답 선택지는 우측 단 맨 위로 강제 분할되어 가독성이 심각하게 깨지는 현상이 발생했다. 이를 해결하기 위해 개별 문항 카드에 break-inside: avoid 속성을 엄격히 바인딩하고, 상위 지문과 하위 문항 번호 그룹의 픽셀 높이를 커널 내부에서 동적으로 연산하여 단 경계 영역의 임계치를 침범하는 즉시 그룹 전체를 우측 단 혹은 다음 페이지의 시작점으로 통째로 밀어버리는 높이 계산 분기 알고리즘을 구축했다.
두 번째는 선택지 문항 오토 밸런싱(Auto Balancing)이다. 수학 수식이나 영어 보기 문장의 길이는 문항마다 완전히 다르다. 이를 고정된 가로폭에 가두면 텍스트가 겹치거나 깨진다. 선택지 문장의 문자열 길이를 바이트(Byte) 수 기준으로 실시간 연산하여, 길이가 매우 짧은 단어 형태면 1열 5행(가로로 촘촘히 배치) 구조로 축을 짜고, 중간 길이면 2열 구조, 문장 형태로 길어지면 5열(한 행에 보기 하나씩 세로 배치)로 CSS Grid 아키텍처 축을 실시간 가변 전환하는 자동 밸런서 알고리즘을 반영하여 실제 배포 인쇄물의 외관 완성도를 수능 규격과 완벽히 일치시켰다.
5. Phase 3.5: 상용 결제 및 크레딧 원장 관리를 위한 데이터 모델링 (ERD)
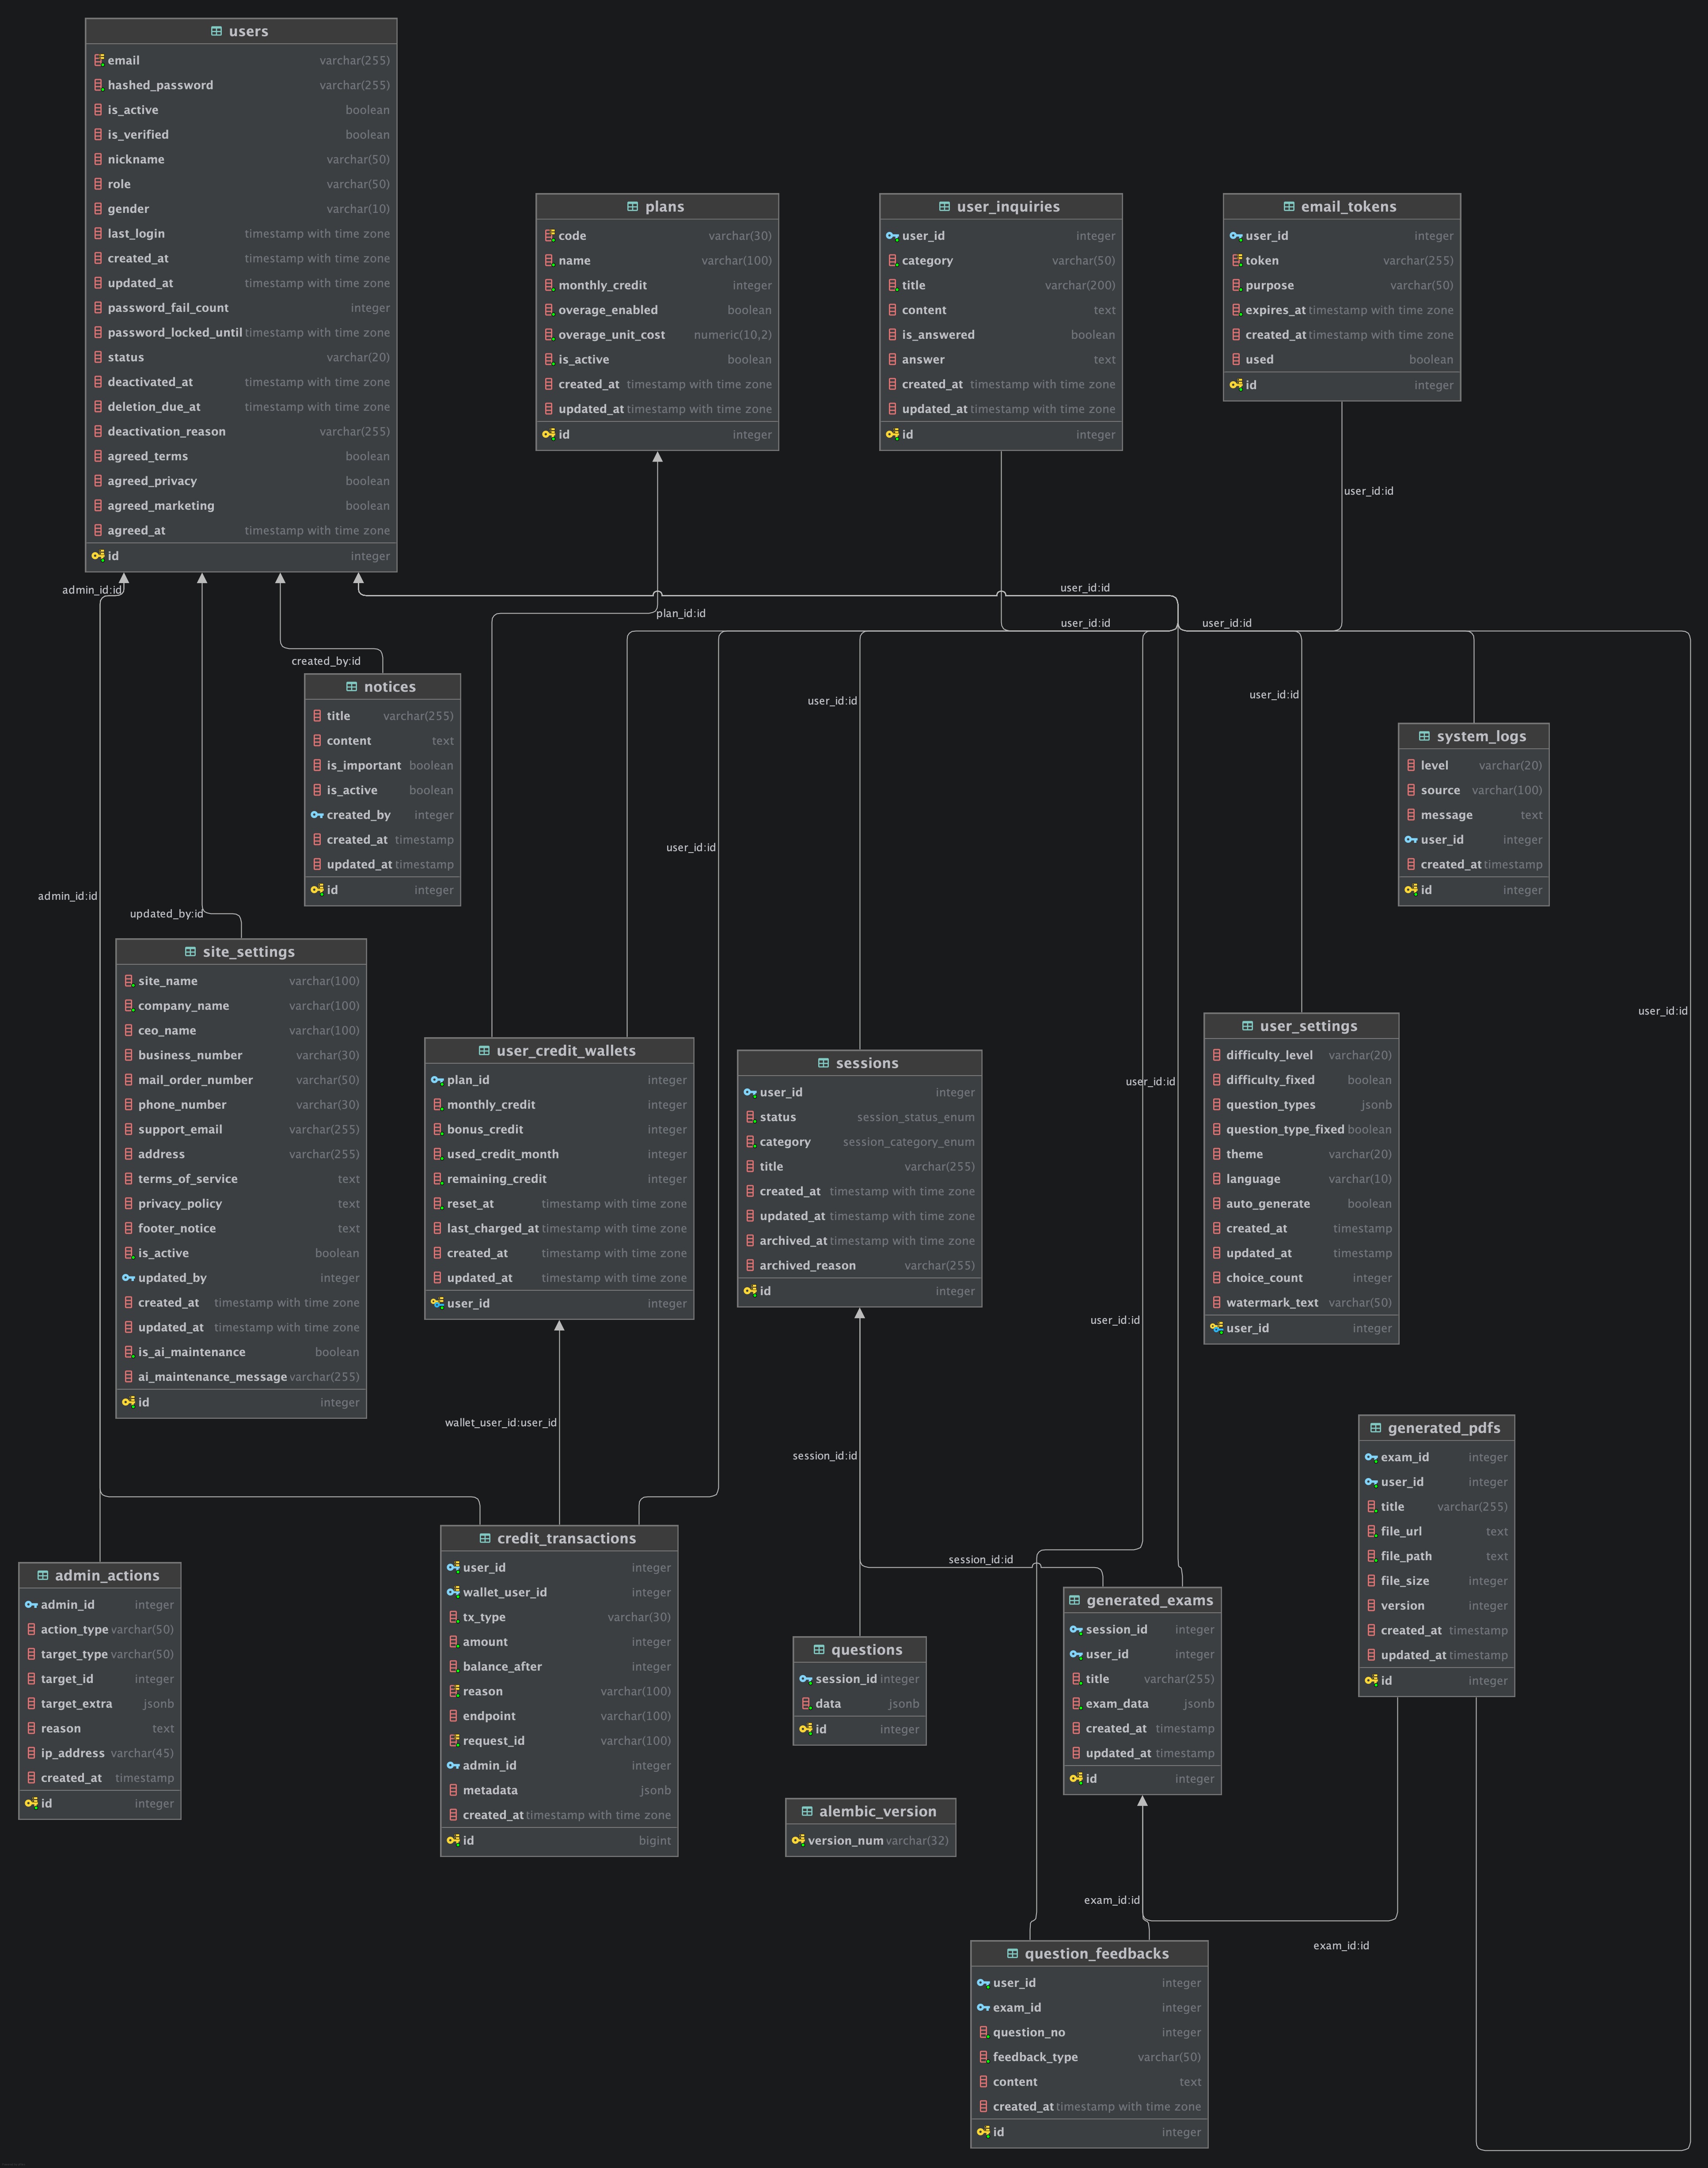
AI 변형 문항 생성 서비스는 AI 추론비용(토큰 소모)과 Puppeteer 커널 렌더링 비용이 지속적으로 발생하는 고비용 비즈니스 구조를 가진다. 따라서 데이터베이스 설계 단계에서부터 사용자 인증, AI 콘텐츠 스트림, 구독 결제 및 크레딧 원장(Ledger) 간의 정밀한 참조 무결성과 트랜잭션 정합성이 담보되어야 했다.
[데이터베이스 스키마 핵심 도메인 분기 구조]
- Identity & Access: users ↔ user_settings, user_credit_wallets (1:1 강제 분리)
- Content & Automation: sessions ↔ questions ↔ generated_exams ↔ generated_pdfs (1:N 체인 구조)
- Billing Ledger: payment_customers ↔ payment_methods ↔ subscriptions ↔ billing_attempts (멱등성 보안 구조)
5.1 크레딧 차감 멱등성 및 원장 관리 정책 (wallet & transactions)
사용자가 AI 변형 생성을 트리거할 때, 크레딧 차감과 AI 작업 승인은 단 하나의 트랜잭션 오류도 허용하지 않는 엄격한 금융 서비스의 규칙을 따라야 한다. 이를 위해 잔액을 실시간으로 캐싱 제어하는 user_credit_wallets 테이블과 모든 입출금 변경 이력을 영구 보관하는 원장 테이블인 credit_transactions 구조를 완전히 이중화하여 결합했다.
유저가 작업을 요청하면 시스템은 먼저 user_credit_wallets에서 remaining_credit 잔액을 사전 체크(Pre-check)하여 부족할 경우 비동기 큐 진입을 원천 차단한다. 작업이 성공적으로 완수되면, 원장 테이블에 DEDUCT 트랜잭션을 삽입하고 동시에 지갑의 잔액을 감산 처리한다.
만약 AI 워커 풀 내부에서 예기치 못한 에러나 타임아웃이 발생해 Job이 최종 실패(FAILED)하는 상황이 터지면, 원장에 REFUND 로그를 즉시 생성하고 잔액을 복구하는 트랜잭션 롤백 매커니즘을 적용했다. 모든 거래 이력에는 유저 브라우저 세션의 고유 request_id를 외래키 수준으로 연동하여 데이터 중복 차감(Double Spending) 버그를 원천 봉쇄했다.
5.2 토스페이먼츠 빌링키(BillingKey) 보안 암호화 적재 (Database Privacy)
토스페이먼츠의 빌링키 기반 정기 자동결제 시스템을 구축할 때 가장 중요한 보안 원칙은 구매자의 민감한 카드 정보(카드번호, 유효기간, CVC 원문 등)를 서버에 절대 저장하지 않는 것이다. 대행사로부터 안전하게 발급받은 문자열 토큰인 billingKey만을 저장 운영하되, 이 역시 평문 데이터로 적재하는 위험을 회피하고자 애플리케이션 커널 단에서 복합 암호화 스펙을 적용했다.
payment_methods 테이블을 설계할 때 빌링키 필드를 billing_key_encrypted, billing_key_iv, billing_key_tag 3가지 필드로 쪼개어 배치했다. 서버는 .env 환경 변수로 격리된 32바이트의 TOSS_BILLING_AES_KEY를 기반으로 암호화 강도가 가장 우수한 AES-256-GCM 알고리즘을 호출하여 소스 데이터를 암호화한 뒤 인스턴스 형태로 데이터베이스에 밀어 넣는다.
정기 스케줄러 배치 장비가 작동할 때만 이 대칭키를 복사해 메모리 상에서만 일시 복호화하여 토스 결제 API 엔드포인트와 통신하므로, 설령 DB 인스턴스가 통째로 스냅샷 덤프 유출 공격을 당하는 최악의 장애 시나리오가 발발하더라도 암호화 키 없이는 빌링키 탈취 및 복호화가 원천적으로 불가능하도록 강력한 보안 무결성 가드레일을 완성했다.
6. Phase 4: 운영 안정성 및 상용 전환 (Production Ready)
6.1 실서비스 관측성 인프라 수립 (Sentry 전역 연동)
- 구현 세부:
사용자가 대량의 비동기 AI 문제 생성 태스크를 백그라운드 워커 큐에 적재하고 브라우저를 이탈하는 구조 특성상, 운영자가 인지하지 못하는 커널 내부의 예외 발생(Gemini API Rate Limit 429 에러, 타임아웃 등)을 실시간으로 추적해야 했다. 프론트엔드 대역에는@sentry/react인터페이스를, FastAPI 백엔드에는sentry-sdk레이어를 동시에 연동하여 전역 예외 캡처 시스템을 완벽히 안착시켰다.
개발 단계 환경에서는 신속한 트러블슈팅을 위해 상세 로직 에러 스택을 리턴하도록 설정했지만, 실서비스 프로덕션 환경에서는 내부 스키마 및 보안 자산 노출을 완벽하게 격리 차단하기 위해 유저에게는 사전에 정의된 직관적인 에러 코드 필드만 안전하게 송출하고, 구체적인 원인 분석 Trace 로그는 Sentry 관리자 대시보드와 Slack Webhook 감사 채널로 즉시 릴레이 분기되도록 데이터 차단벽을 공고히 다졌다.
6.2 토스페이먼츠 정기 결제 웹훅(Webhook) 유실 대응 및 멱등성 보장
- 장애 예방 설계:
정기 구독 과금 비즈니스를 유기적으로 제어하기 위해 사용자가 결제수단을 등록하고 스케줄러가 자동결제를 트리거하는 구조를 도입했다. 이때 유저 카드의 순간적인 한도 초과, 통신사 망 불안정 등으로 인해 결제 대행사(PG) 측에서 발송하는 비동기 결제 완료 신호가 유실되거나 중복 유입될 치명적인 금융 리스크가 상존했다.
백엔드 내부에 POST /billing/webhook/toss 보안 수신 엔드포인트를 개설하고, 수신되는 헤더의 Toss-Signature 서명 값을 HMAC-SHA256 알고리즘으로 엄격히 상호 검증하도록 가드레일을 짰다.
특히 웹훅 수신 원본 이벤트를 데이터베이스에 적재할 때, 결제사에서 부여한 고유 이벤트 식별자를 dedupe_key 필드로 삼아 유니크 인덱스(Unique Index) 제약 조건을 걸었다. 이 설계 덕분에 결제사 내부 허브 장비의 일시적 결함으로 인해 동일한 결제 성공 신호가 1초 내에 중복으로 2번 유입되더라도, 데이터베이스 테이블 레벨에서 최초 1회 요청만 유효하게 정산 처리하고 두 번째 인스턴스는 조용히 차단(Ignore)함으로써 중복 크레딧 지급이나 원장 데이터 손상 금융 사고 리스크를 시스템적으로 완벽히 예방했다.
6.3 pg_dump 기반의 무중단 일일 백업 인프라 구축
- 인프라 자동화:
VPC 가상 인스턴스의 하드웨어 결함이나 예기치 못한 스토리지 손상 등 재해 복구(DR) 시나리오의 골든타임을 확보하기 위해 백엔드 핵심 코어 단에 데이터 자동 백업 스크립트(scripts/db_backup.sh)를 심었다.
유저 트래픽 유입이 거의 없는 매일 새벽 3시에 시스템 크론탭(Cron) 데몬이 깨어나 PostgreSQL 가동 엔진 전체를 pg_dump 지시어로 안전하게 추출한 뒤, gzip으로 압축하여 별도의 보호 디렉토리로 격리 이전한다.
서버의 내부 스토리지 용량 고갈을 막기 위해 14일 보존 정책(14 Days Rotation)을 코딩하여, 보관 주기를 초과한 구형 압축 파일은 리눅스 커널 명령어가 자동으로 탐색하여 파기하도록 일련의 인프라 파이프라인 무중단 자동화를 완성했다.
배포 일주일 전에 터진 버그 두 개
프로덕션 안정화를 어느 정도 마무리하고 실사용 트래픽을 지켜보고 있었는데, 배포까지 딱 일주일 남은 시점에 꽤 골치 아픈 버그를 두 개 연달아 밟았다.
시작은 시험지 검수였다. 실제 수능 영어 PDF(45문항)를 올려서 변형 시험지를 뽑고, 원본이랑 한 문항씩 대조해보고 있었는데 이상한 걸 발견했다. 원본 21번(디지털 플랫폼 지문)이 결과물에서 완전히 똑같은 지문으로 두 번, 서로 다른 문항 번호에 들어가 있었다. 33번은 아예 세 번, 매번 다르게 paraphrase된 채로 나왔다. 처음엔 "AI가 같은 청크 안에서 헷갈려서 중복 생성했나보다" 하고 넘기려 했는데, 전체를 대조해보니 원본 28문항 중 9개가 중복이었고 결과 시험지 40문항 중 12개(30%)가 그냥 순수 복제였다.
원인을 찾아 들어가보니 추출 단계에 있었다. PDF에서 문항을 뽑을 때 목표 개수를 못 채우면 recovery pass라고, 놓친 문항을 찾으려고 한 번 더 훑는 과정이 있는데, 이 재추출 과정에서 같은 문항을 또 뽑아오면서 지문 텍스트가 아주 미세하게(공백 하나, 구두점 하나) 다르게 나오는 경우가 있었다. 그런데 중복인지 판별하는 기준이 "지문 텍스트가 정확히 같은가"였다. 텍스트가 한 글자만 달라도 완전히 다른 문항 취급을 해버리니, 문항 번호는 시험지 안에서 절대 안 겹친다는 뻔한 사실을 무시하고 애먼 지문 문자열 매칭에 기대고 있었던 셈이다.
고치는 건 오래 안 걸렸다. 판별 기준을 지문 텍스트에서 문항 번호로 바꾸면 끝이었다. 근데 고치고 나서 신나서 재테스트했는데 결과가 하나도 안 바뀌어서 당황했다. 알고 보니 예전에 이미 업로드해둔 세션을 재사용해서 테스트한 거였다. 추출은 세션 업로드할 때 딱 한 번만 실행되고 DB에 저장되니까, 버그 고치기 전에 이미 중복으로 박힌 데이터는 당연히 그대로 남아있을 수밖에. PDF를 완전히 새 세션으로 다시 올려서 돌리고 나서야 28문항 대 28문항, 중복 0건으로 딱 맞아떨어지는 걸 확인했다. 덤으로 예전엔 40문항 만드느라 AI를 그만큼 더 호출했는데 이제 28개만 정확히 만드니 체감 속도도 눈에 띄게 빨라졌다.
같은 로직이 다른 과목에서도 버티는지 궁금해서 일부러 파싱이 까다로운 걸 하나 골랐다. 경희대 편입학 수학 시험지였는데, PDF 텍스트 레이어 자체가 적분, 행렬, 급수 기호로 범벅이 돼서 추출된 원문이 꽤 지저분했다. 30문항을 선택해서 변형을 돌렸는데 결과물이 딱 15문항만 나왔다. 한 번 더 돌려봤더니 이번에도 정확히 1번부터 15번까지만, 16번부터 30번(선형대수 파트)은 통째로 없었다. 이렇게 깔끔하게 재현되는 걸 보고 운이 나쁜 게 아니라 뭔가 구조적으로 막히고 있다는 확신이 들었다.
세션 업로드 화면에서 문항 선택할 땐 30개가 다 보였으니 추출 자체는 문제가 없었고, 생성/복구 단계에서 뒤쪽 문항들이 유독 못 버티고 있었다. 코드를 다시 열어봤다. 문항 하나가 완성도 문제(선택지 누락, 해설이 placeholder로 남는 등)로 걸리면 그 문항 하나만 따로 다시 생성해서 복구하는 함수가 있는데, 이 함수가 AI를 호출할 때 토큰 예산을 아예 안 넘기고 있었다. 기본값 4000으로 고정. 지문 기반 청크 생성 쪽은 예전에 청크 크기에 비례해서 토큰 예산을 늘리도록 이미 고쳐놨었는데, 정작 단건 복구 경로는 그 수정에서 빠져 있었다.
문제는 4000토큰이 영어 지문 문제엔 충분해도 선형대수 뒷부분(고윳값, 수반행렬, column space, 최소제곱법 같은)처럼 해설이 여러 단계로 길게 이어지는 문항엔 부족했다는 거다. 답이 잘리고, 잘린 채로 복구를 네 번 재시도해도 매번 같은 이유로 또 잘리니 결국 드롭될 수밖에 없었다. 하필 뒤로 갈수록 문제 난이도와 해설 길이가 늘어나는 구조라 정확히 절반 지점부터 무너진 거였다. repair 함수에 토큰 예산을 명시적으로 늘려서 지정하도록 고쳤다. 이건 실제 API 호출 비용이 들어가는 부분이라 로컬에서 바로 재현 검증은 못 했고, 배포해서 같은 PDF로 다시 돌려보는 걸로 검증을 이어가는 중이다.
두 버그 다 패턴이 비슷했다. 예전에 비슷한 걸 이미 한 번 고쳤는데, 그 수정이 커버 못 한 경로가 하나씩 더 있었던 거다. 파이프라인이 추출, 생성, 검증, 복구로 여러 단계 나뉘어 있다 보니 한 곳을 고쳐도 같은 유형의 구멍이 다른 단계에 그대로 남아있는 일이 계속 생긴다. 배포 전에 원본이랑 결과물을 문항 단위로 하나하나 대조해보는 걸 안 했으면 둘 다 그냥 모르고 넘어갔을 것 같다.
7. 주요 성과 및 엔지니어링 스토리를 마치며
이번 상용화 고도화 단계를 정면으로 통과하며 얻은 가장 큰 엔지니어링적 소득은 "돌아가는 쓰레기 코드를 비즈니스가 지속 가능한 견고한 아키텍처로 전환할 때의 트레이드오프"를 온전히 내 손으로 겪어냈다는 점이다.
단순히 useEffect와 useState를 난사하며 화면에 데이터를 띄우고 상태 결함에 허덕이던 과거의 패러다임에서 벗어나, TanStack Query v5 캐싱 레이어를 전역에서 유기적으로 제어하고 비동기 Job 상태에 따라 폴링 주기를 유연하게 조율하여 백엔드 소켓 자원 트래픽을 획기적으로 경감시키는 성능 최적화를 일구어낼 수 있었다.
또한, 가상 도메인 표준 명세와 문서 포맷의 한계를 극복하기 위해 백엔드 하부에 Puppeteer 기반 고해상도 수식 이미지 캐싱 브릿지(The PNG Bridge)를 아키텍처링하고, 수능 규격의 2단 출력 레이아웃 시스템을 설계해 나간 과정은 에듀테크 도메인이 마주하는 고유의 난제들을 공학적으로 정면 돌파해 낸 매우 값진 시간이었다. 이 날것의 기록이 나처럼 비슷한 화면과 인프라 인스턴스를 붙잡고 밤을 지새우는 수많은 풀스택 엔지니어들에게 자그마한 힌트와 뼈대가 되기를 바란다.
프로젝트 관련 자산 및 라이브 링크
더 자세한 아키텍처 명세나 실서비스의 프로덕션 환경이 궁금하신 분들은 아래 링크를 참고해 주세요. 주니어 엔지니어의 치열한 삽질이 담긴 프로젝트입니다. 자유로운 피드백이나 기술적 논의는 언제나 환영합니다!
- 공식 웹 서비스: AI ExamGenerator 바로가기
- GitHub 레포지토리: CSAT_Forge(AI ExamGenerator) 소스 코드 원본
- 개발자 포트폴리오: Seongwon Park Portfolio
- 문의 및 피드백 이메일: swp20138993@gmail.com
