안개가 자욱한 산 위에 서 있습니다. 앞은 한 치도 안 보이지만, 발밑이 어느 쪽으로 기울어 있는지는 느낄 수 있죠. 그 기울기만 믿고 한 걸음씩 내려가면 결국 계곡 바닥에 닿습니다. ⛰️
이게 AI 학습의 전부이고, 그 "발밑 기울기"를 숫자로 만드는 도구가 미분입니다. 1부에서는 미분의 정의와 수치미분, 연쇄법칙(역전파의 원리), 그리고 여러 방향의 기울기를 모은 그래디언트까지 다룹니다.
📘 이 글은 위키독스 도서 Zero to 머신러닝 딥러닝 Master 의 00-04 미분·경사하강법 — 안개 낀 산에서 내려오기 (1부) 을 블로그용으로 다듬은 글입니다.
💻 실습 코드: GitHub · 🏠 mldict.net · ✍️ 기술 블로그
💻 이 글의 코드:
00-04-derivative-gradient-descent· Open in Colab — 핵심 코드와 실제 실행 결과는 글 아래 💻 GitHub 실습 섹션에 있습니다.
⬅️ 이전 글: #04 최소제곱법과 정규방정식 — 선형회귀가 머신러닝의 첫 모델인 이유 (파이썬 NumPy) \
➡️ 다음 글: #06 경사하강법 완전 정복 — 학습률·발산 조건·선형회귀·자동미분 (딥러닝 수학, 2부)
TL;DR — 3줄 요약
- 미분 = 두 점을 무한히 가깝게 붙였을 때의 기울기이고, 코드에서는 중심차분으로 근사합니다.
- 연쇄법칙 은 함수를 거꾸로 따라가며 기울기를 곱하는 규칙으로, 역전파의 뼈대입니다.
- 그래디언트는 편미분을 모은 벡터로, 함수가 가장 빠르게 증가하는 방향을 가리킵니다.
✏️ 꼭 알아야 할 TIP
📈 핵심 개념: 미분은 "지금 이 순간의 변화 속도"이고, 경사하강법은 그 변화 속도(기울기)를 나침반 삼아 가장 낮은 곳을 찾아가는 방법입니다.
🧭 한 줄 비유: 안개 낀 산에서 발밑 경사만 느끼며 한 걸음씩 계곡으로 내려가는 것 — 그것이 바로 AI 학습입니다.
🔑 이 장을 관통하는 한 줄 공식:
이 한 줄이 코드에서는
x = x - lr * df(x)딱 한 줄이 됩니다. 수식 한 줄 = 코드 한 줄, 이 대응을 계속 확인하며 읽어보세요.⚖️ 가장 중요한 포인트: 보폭(학습률 )이 너무 크면 발산하고, 너무 작으면 한없이 느립니다. 이 장에서는 "얼마나 커야 발산하는지"를 수식으로 직접 유도하고 코드로 확인합니다.
🏗️ 실무에서 사용하는 이유: 신경망의 가중치가 수십억 개여도 원리는 위 한 줄뿐입니다. SGD·Adam·RMSProp 등 모든 최적화 기법의 뿌리가 경사하강법입니다.
📋 선행지식 (Prerequisites)
- 📐 중학교 수준의 일차함수와 기울기 = (y 변화량)/(x 변화량)
- 🔢 거듭제곱 표기 , 및 사칙연산 — 이것만 알면 충분합니다
- 🧮 함수의 개념: 입력 를 넣으면 출력 가 나온다
- 🧭 (선택) 00-01 벡터의 성분 개념 — 그래디언트를 벡터로 쓸 때 필요
- 📈 (선택) 00-03 최소제곱법 — 5단계 응용에서 같은 문제를 경사하강법으로 다시 풉니다
💬 ※ 극한·미분을 한 번도 안 배웠어도 괜찮습니다. 1단계에서 숫자 표로 직접 확인하며 시작합니다.
🎯 학습 목표
☐ 🚗 미분이 "순간 변화율"이라는 것을 자동차 속도계 비유로 설명할 수 있다 🟢 초급
☐ 🔬 극한 정의 를 숫자 표로 직접 확인하고 손으로 유도할 수 있다 🟢 초급
☐ 📐 의 미분 을 이항정리로 유도하고 적용할 수 있다 🔵 중급
☐ 🔗 연쇄법칙을 3단계 이상 합성함수에 적용하고, 시그모이드 미분을 직접 유도할 수 있다 🔵 중급 ⭐
☐ 💻 수학공식을 그대로 파이썬 함수로 옮기고, 수치미분으로 검증할 수 있다 🔵 중급 ⭐
☐ 🧭 편미분과 그래디언트를 구분해 설명하고 벡터로 계산할 수 있다 🔵 중급
☐ ⛰️ 경사하강법을 손으로 5스텝 계산하고, 코드로 재현할 수 있다 🔵 중급
☐ ⚠️ 발산 조건 을 직접 유도하고 실험으로 확인할 수 있다 🔴 심화 ⭐
☐ 🚀 00-03의 선형회귀를 경사하강법으로 다시 풀어 정규방정식과 같은 답이 나옴을 보일 수 있다 🔴 심화 🚀
☐ 🔀 NumPy → DeZero → PyTorch → TensorFlow → JAX 대응을 설명할 수 있다 🔴 심화 🚀
📊 핵심 학습 내용 — 수식과 코드의 대응
| 단계 | 학습 내용 | 핵심 수학공식 | 대응하는 코드 |
|---|---|---|---|
| 1️⃣ | 미분의 정의 | (f(x+h)-f(x-h))/(2*h) | |
| 2️⃣ | 미분 공식·연쇄법칙 | , | def df(x): return n*x**(n-1) |
| 3️⃣ | 편미분·그래디언트 | np.array([df_dx, df_dy]) | |
| 4️⃣ | 경사하강법 | x = x - lr * df(x) | |
| 5️⃣ | 발산 조건·선형회귀 응용 | , | gw = 2/m * np.sum(e*X) |
| 6️⃣ | 프레임워크 연결 | 자동미분(autograd) | loss.backward(); opt.step() |
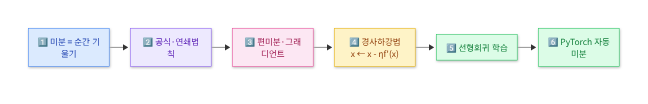
🗺️ 시각화 ① — 이번 장의 전체 흐름
📍 1단계 — 미분(Derivative)이란 무엇인가?
🔎 ① 핵심 정의 — 무엇인가?\
미분이란 "어떤 값이 지금 이 순간 얼마나 빠르게 변하고 있는가"를 숫자로 나타낸 것입니다. 곡선 위 한 점에서 그은 접선의 기울기가 그 지점의 미분값입니다.
❓ 왜 필요한가?\
신경망을 학습시키려면 "가중치를 어느 방향으로, 얼마나 바꿔야 오차가 줄어드는가"를 알아야 합니다. 이 질문에 숫자로 답해주는 유일한 도구가 미분입니다. 미분이 없으면 AI는 학습할 수 없습니다.
⏰ 언제 사용하는가?\
손실함수를 최소화하는 모든 순간 — 즉 딥러닝 학습 과정 전체에서 사용됩니다.
💜 더 쉽게 이해하기 — 🚗 자동차 속도계
🚦 운전 중 계기판에 "현재 속도 60km/h"라고 떠 있습니다. 이 숫자는 "위치가 시간에 따라 얼마나 빠르게 변하는가"를 알려줍니다.
🛑 신호등 앞에서는 0km/h, 🛣️ 고속도로에서는 100km/h — 속도는 매 순간 달라집니다. 이렇게 "지금 이 순간의 변화 정도"를 계산하는 도구가 미분이고, 속도계는 사실 "위치를 시간으로 미분한 값"을 보여주는 장치입니다.
📸 조금 더 정확히 말하면, "1시간 동안 60km 갔다"는 평균 속도이고, 속도계가 보여주는 건 "찰나의" 속도입니다. 이 평균 → 찰나로 넘어가는 과정이 바로 다음에 나올 극한입니다.
🔢 진행 과정 — 평균 기울기에서 순간 기울기로
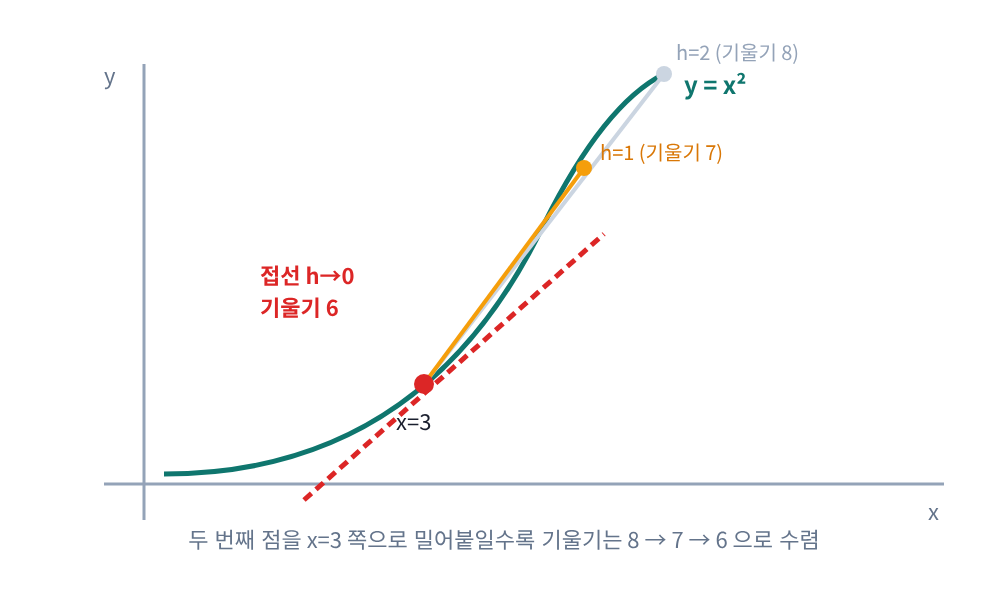
- 곡선 위에 두 점 와 를 찍는다
- 두 점을 잇는 직선(할선)의 기울기를 구한다 → 평균 변화율
- 를 점점 작게 만든다 (0.1 → 0.01 → 0.001 …)
- 두 점이 겹칠 만큼 가까워지면 할선은 접선이 된다
- 그때 수렴하는 값이 순간 변화율 = 미분값 ✅
🔬 수학공식 ① — 평균 변화율과 미분의 정의
평균 변화율(할선의 기울기)
미분(순간 변화율) — 를 0으로 보낸 극한
변수 정의\
• : 원래 함수 (예: 위치, 손실)\
• : 두 점 사이의 아주 작은 간격 (0에 한없이 가까워지지만 0은 아님)\
• : 도함수 — "에서의 순간 기울기"를 돌려주는 새로운 함수\
• : "를 0에 한없이 가깝게 했을 때 다가가는 값"\
\
📌 표기법: , , 는 모두 같은 뜻입니다. 딥러닝에서는 주로 형태로 만나게 됩니다.
📖 수학적 의미 — 의 에서 직접 유도하기
정의에 , 을 그대로 대입해봅시다.
놀랍게도 분모의 가 깔끔하게 약분되어 만 남았습니다. 이제 이면 답은 6입니다. ✅
📊 정말 6으로 수렴하는지 숫자로 확인하기 — 위 유도가 맞다면, 를 줄일수록 는 6에 가까워져야 합니다.
| 계산값 | 6과의 차이 | 관찰 | |
|---|---|---|---|
| 1 | 7.000000 | 1.0 | 아직 멀다 |
| 0.1 | 6.100000 | 0.1 | 가까워짐 |
| 0.01 | 6.010000 | 0.01 | 차이 = 그 자체! |
| 0.001 | 6.001000 | 0.001 | 유도식 와 일치 ✅ |
| 0.000001 | 6.000001 | 0.000001 | 🎯 6으로 수렴 |
📌 손으로 유도한 식 가 표의 모든 줄과 정확히 일치합니다. 수학이 맞다는 것을 숫자로 확인한 셈입니다. 🎉
🔬 직관적 의미
를 줄이는 것은 "곡선을 현미경으로 계속 확대하는 것"과 같습니다. 🔬 아무리 휘어진 곡선이라도 충분히 확대하면 직선처럼 보입니다. 그 직선의 기울기가 바로 그 점의 미분값입니다. 지구가 둥글지만 우리 눈에는 땅이 평평해 보이는 것과 같은 원리입니다. 🌍
📐 시각화 ② — 할선이 접선으로 변해가는 과정
⚙️ 구현 원리 — 컴퓨터는 극한을 계산할 수 없다\
컴퓨터에는 "를 0에 무한히 가깝게" 만드는 기능이 없습니다. 그래서 아주 작은 를 실제로 대입해서 근사하는데, 이를 수치미분(numerical differentiation)이라고 합니다. 여기에 두 가지 방식이 있습니다.
🔬 수학공식 ② — 전진차분 vs 중심차분
전진차분 (forward difference) — 정의를 그대로 옮긴 것
중심차분 (central difference) — 좌우로 대칭하게 재는 것
왜 중심차분이 더 정확한가? 전진차분은 오른쪽만 보므로 곡선의 휘어짐이 한쪽으로 치우쳐 반영됩니다. 중심차분은 좌우 오차가 서로 상쇄되어 정확도가 극적으로 올라갑니다. 오차가 에서 로 바뀐다는 것은, 를 100분의 1로 줄이면 오차가 10,000분의 1이 된다는 뜻입니다. 🎯
💻 코드 구현 — 수학공식을 그대로 파이썬으로
🐍 Python — 수치미분 두 가지 방식 비교
def forward_diff(f, x, h=1e-4):
    """
    전진차분: (f(x+h) - f(x)) / h
    비유: 앞쪽만 보고 경사를 재는 것 — 한쪽으로 치우친 측정
    """
    return (f(x + h) - f(x)) / h          # 공식 그대로!

def numerical_diff(f, x, h=1e-4):
    """
    중심차분: (f(x+h) - f(x-h)) / (2h)
    비유: 앞뒤로 똑같이 한 걸음씩 가서 재는 것 — 좌우 오차가 상쇄됨
    """
    return (f(x + h) - f(x - h)) / (2 * h)  # 공식 그대로!

def square(x):
    """f(x) = x^2  (참값 미분: f'(x) = 2x, 따라서 f'(3) = 6)"""
    return x ** 2

# h를 바꿔가며 두 방식의 오차를 비교합니다
true_value = 6.0
for h in [1e-2, 1e-4, 1e-8]:
    fwd = forward_diff(square, 3.0, h)
    cen = numerical_diff(square, 3.0, h)
    print(f"h={h:.0e} | 전진={fwd:.8f} (오차 {abs(fwd-true_value):.1e})"
          f" | 중심={cen:.8f} (오차 {abs(cen-true_value):.1e})")
🔗 GitHub에서 코드 보기 — 00_04_derivative_gradient_descent.py L16–L40
📘 코드 이해 — 수식과 코드 한 줄씩 대응
| 수학공식 | 파이썬 코드 | 설명 |
|---|---|---|
f(x + h) | 함수를 인자로 받아 호출 — 어떤 함수든 미분 가능 | |
(f(x+h)-f(x))/h | 전진차분 — 분자·분모가 수식과 1:1 | |
(f(x+h)-f(x-h))/(2*h) | 중심차분 — 분모의 2를 빼먹는 실수 주의 ⚠️ | |
h=1e-4 | 극한 대신 작은 값 하나로 근사 (너무 작으면 오히려 오차↑) |
🧩 코드 설명 — Python 기초
• 함수를 인자로 넘기기 —
numerical_diff(square, 3.0)처럼 함수 이름을 괄호 없이 넘기면 함수 자체가 전달됩니다.square()라고 쓰면 실행 결과가 넘어가버리니 주의하세요. 파이썬에서 함수는 숫자처럼 주고받을 수 있는 일급 객체입니다.\
\
• 기본 인자h=1e-4— 호출할 때 생략하면 자동으로 이 값이 쓰입니다.\
\
•1e-4표기 — 을 뜻하는 지수 표기입니다.1e-8은 입니다.\
\
• docstring (""" """) — 함수 설명서입니다.help(numerical_diff)로 볼 수 있습니다.\
\
• f-string 서식{fwd:.8f}는 소수점 8자리,{h:.0e}는 지수 표기,{abs(...):.1e}는 지수 1자리로 출력합니다.
✅🟩 실행 결과
h=1e-02 | 전진=6.01000000 (오차 1.0e-02) | 중심=6.00000000 (오차 1.3e-13)
h=1e-04 | 전진=6.00010000 (오차 1.0e-04) | 중심=6.00000000 (오차 1.3e-11)
h=1e-08 | 전진=6.00000000 (오차 3.7e-08) | 중심=6.00000000 (오차 3.7e-08)
🔍 결과 해석: 일 때 전진차분의 오차는 인데 중심차분은 — 약 10조 배 정확합니다. 그런데 에서는 둘 다 오차가 오히려 커졌습니다. 😮 가 너무 작으면 f(x+h)와 f(x-h)가 컴퓨터 소수점 정밀도 안에서 거의 같은 수가 되어버려, 뺄셈 결과가 뭉개지기 때문입니다(자릿수 손실). 그래서 실무에서는 정도를 씁니다. 📌
🛠️ 실습 1 🟢
①
numerical_diff(square, 5.0)을 실행해 결과가 참값 과 얼마나 가까운지 확인하세요.\
② 을 정의하고 에서 미분하세요. (정답: )\
③math.sin을 넘겨 에서 미분해보세요. (정답: )
🐞 디버깅 포인트 — 선택의 함정
❌ 왜 틀리나? "가 작을수록 정확하겠지"라며
h=1e-15를 쓰면 결과가0.0이나 엉뚱한 값이 나옵니다.\
❌ 원인: 파이썬float은 약 16자리까지만 표현합니다.f(x+h)와f(x)의 차이가 그 정밀도보다 작아지면 차이가 0으로 뭉개집니다.\
✅ 수정:h=1e-4부근을 쓰고, 정의를 그대로 옮긴 전진차분 대신 중심차분을 사용하세요.\
✅ 검산 습관: 손으로 구한 도함수와 수치미분 결과를abs(a-b) < 1e-5로 비교하는 테스트를 항상 붙이세요. (2단계에서 실제로 만듭니다)
📍 2단계 — 미분 공식과 연쇄법칙
🔎 ① 핵심 정의\
매번 극한을 계산하는 것은 너무 번거롭습니다. 다행히 몇 가지 패턴만 외우면 대부분의 함수를 즉시 미분할 수 있습니다.
❓ 왜 필요한가?\
신경망 하나에 미분해야 할 함수가 수백 개입니다. 매번 를 대입해 극한을 계산한다면 학습이 영원히 끝나지 않습니다. 공식은 속도이자 정확성입니다.
⏰ 언제 사용하는가?\
프레임워크의 backward() 안에는 이 공식들이 전부 하드코딩되어 있습니다. 우리가 손으로 유도한 공식이 곧 라이브러리 소스코드입니다.
💜 더 쉽게 이해하기 — 🧱 레고 조립 설명서
📖 레고 설명서에는 "2번 블록을 3번 자리에 끼운다"는 규칙만 그려져 있습니다. 매번 왜 그 자리가 맞는지 물리학으로 증명할 필요가 없죠.
미분 공식도 마찬가지입니다. "지수를 앞으로 내리고 1을 뺀다"는 규칙만 알면, 극한 계산 없이 즉시 답이 나옵니다. 🧱 단 한 번은 직접 유도해봐야 규칙이 하늘에서 떨어진 게 아님을 알 수 있습니다 — 바로 다음에 해봅니다.
🔬 수학공식 ③ — 의 미분 공식을 직접 유도하기
① 정의에 대입
② 이항정리로 전개 — 핵심은 가 몇 개 곱해졌는지입니다.
③ 이 소거됨
④ 로 나누기
⑤ — 뒤쪽 항들은 모두 를 최소 하나씩 갖고 있으므로 전부 사라집니다.
변수 정의: 은 지수, 는 입력값, 는 이항계수입니다.\
\
📌 로 확인: → . 1단계에서 손으로 구한 값과 정확히 일치합니다! ✅
📋 미분 규칙 종합표 — 이것만 알면 90%는 해결됩니다
| 규칙 | 예시 | 왜 그런가 | ||
|---|---|---|---|---|
| 거듭제곱 | 위에서 유도함 | |||
| 상수 | 수평선은 기울기가 0 | |||
| 상수배 | 배 늘리면 기울기도 배 | |||
| 합·차 | 각 항을 따로 미분 | |||
| 곱 | 번갈아 미분해서 더함 | |||
| 연쇄 ⭐ | 역전파의 심장 | |||
| 지수 | 자기 자신이 도함수 |
🔗 연쇄법칙(Chain Rule) — 이 장에서 가장 중요한 규칙 ⭐
💜 더 쉽게 이해하기 — ⚙️ 톱니바퀴 3개
톱니바퀴 A가 B를 돌리고, B가 C를 돌립니다. A가 2배 빨리 돌면 B는 2배, 그런데 B가 1 돌 때 C는 3바퀴 돈다면? C는 최종적으로 2 × 3 = 6배 빨라집니다. ⚙️
연쇄법칙은 정확히 이 "변화율끼리의 곱"입니다. 신경망은 층이 100개면 톱니바퀴가 100개인 기계이고, 역전파는 그 100개의 변화율을 순서대로 곱해 나가는 과정입니다.
🔬 수학공식 ④ — 연쇄법칙
라이프니츠 표기로 쓰면 "분수처럼 약분되는" 형태라 훨씬 외우기 쉽습니다.
변수 정의\
• : 안쪽 함수, : 바깥 함수, : 중간 결과\
• : 바깥 함수가 중간값에 대해 변하는 정도\
• : 중간값이 입력에 대해 변하는 정도\
\
📌 3중 합성이면 그냥 하나 더 곱합니다:
📐 예제로 익히기 — 세 가지 난이도
예제 ① 🟢 \
• 안쪽 → \
• 바깥 → \
• 곱하기 → \
• 검산: 전개하면 , 미분하면 ✅ 일치!
예제 ② 🔵 \
• 안쪽 → \
• 바깥 → \
• 곱하기 → \
• 전개해서 미분하려면 8차식이 나옵니다 — 연쇄법칙이 압도적으로 편합니다 😅
예제 ③ 🔴 (3중 합성 — 신경망 2층과 같은 구조) \
• → \
• → \
• → \
• 전부 곱하기 → \
• 대입: — 뒤에서 코드로 검증합니다 🔍
🔬 수학공식 ⑤ — 시그모이드 미분 유도 (AI에서 가장 유명한 미분) ⭐
① 연쇄법칙 적용 — 안쪽 , 바깥
② 안쪽 미분 — (여기에도 연쇄법칙!)
③ 대입하면 음수 두 개가 곱해져 양수
④ 마법의 변형 — 분자를 로 쪼갭니다.
⑤ 결론
📌 이 공식이 왜 위대한가? 도함수를 원래 함수값만으로 표현할 수 있습니다! 코드에서는 순전파에서 계산한
y를 저장해뒀다가 역전파에서y*(1-y)한 줄로 끝냅니다. 지수함수를 다시 계산할 필요가 없어 엄청나게 빠릅니다. 🚀\
\
📌 부수 효과: 는 0~1 사이이므로 의 최댓값은 에서 0.25입니다. 층이 깊어지면 0.25보다 작은 수가 계속 곱해져 기울기가 0으로 사라지는데, 이것이 그 유명한 기울기 소실(vanishing gradient) 문제입니다. ⚠️
📐 시각화 ③ — 순전파와 역전파(연쇄법칙)
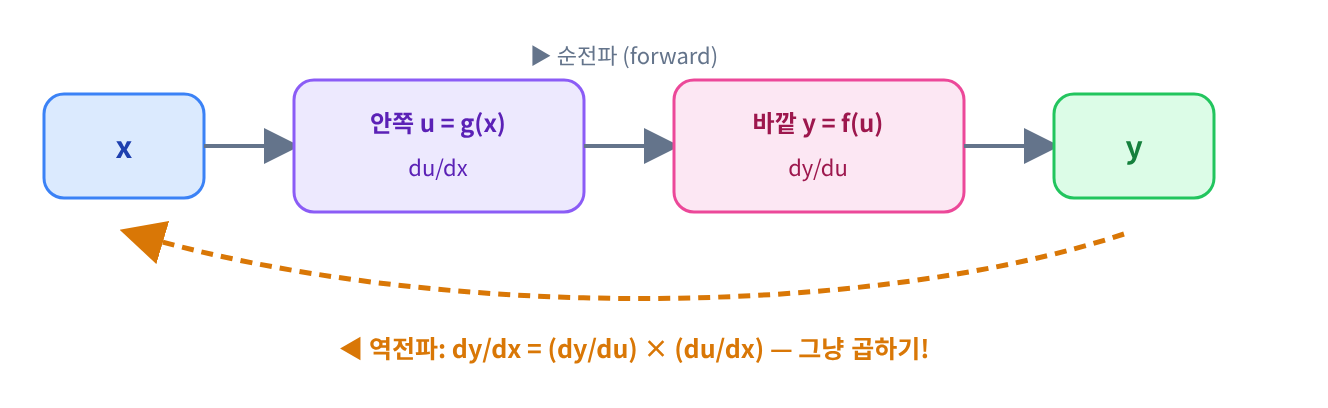
💻 코드 구현 — 손으로 유도한 공식을 코드로 옮기고, 수치미분으로 채점하기\
이것이 이 장에서 가장 중요한 습관입니다. 공식을 코드로 옮겼으면 반드시 수치미분과 비교해서 검증하세요.
🐍 Python — 해석미분 vs 수치미분 자동 채점기
import math

def numerical_diff(f, x, h=1e-4):
    """중심차분 수치미분 (1단계에서 만든 함수 재사용)"""
    return (f(x + h) - f(x - h)) / (2 * h)

def check_grad(name, f, df, x):
    """
    손으로 유도한 도함수 df 가 맞는지 수치미분으로 채점합니다.

    비유: 계산기로 검산하는 것과 같습니다.
    두 값이 거의 같으면 유도가 옳다는 강력한 증거입니다.
    """
    analytic = df(x)                      # 공식으로 구한 값
    numeric  = numerical_diff(f, x)       # 정의로 구한 값

    # ★ 절대오차가 아니라 '상대오차'로 비교합니다 (아래 디버깅 포인트 참고)
    #   기울기가 1536처럼 크면 절대오차도 커지는 게 정상이기 때문입니다
    rel_error = abs(analytic - numeric) / max(1.0, abs(analytic))
    ok = "✅" if rel_error < 1e-5 else "❌"
    print(f"{ok} {name:<22} 공식={analytic:12.6f}  수치={numeric:12.6f}"
          f"  상대오차={rel_error:.1e}")

# ── 예제 ①: y=(x+1)^2 → y'=2(x+1) ───────────────────────
check_grad("(x+1)^2",
           lambda x: (x + 1) ** 2,
           lambda x: 2 * (x + 1),          # 연쇄법칙 결과
           3.0)

# ── 예제 ②: y=(3x^2+1)^4 → y'=24x(3x^2+1)^3 ─────────────
check_grad("(3x^2+1)^4",
           lambda x: (3 * x**2 + 1) ** 4,
           lambda x: 24 * x * (3 * x**2 + 1) ** 3,
           1.0)

# ── 예제 ③: 3중 합성 y=((2x+1)^2+3)^2 → y'=8((2x+1)^2+3)(2x+1)
check_grad("((2x+1)^2+3)^2",
           lambda x: ((2*x + 1)**2 + 3) ** 2,
           lambda x: 8 * ((2*x + 1)**2 + 3) * (2*x + 1),
           0.0)

# ── 예제 ④: 시그모이드 → σ'(x)=σ(x)(1-σ(x)) ──────────────
def sigmoid(x):
    """σ(x) = 1 / (1 + e^-x)  — 0~1 사이로 눌러 담는 S자 함수"""
    return 1 / (1 + math.exp(-x))

def sigmoid_grad(x):
    """σ'(x) = σ(x)(1-σ(x)) — 순전파 결과만으로 계산! (유도 ⑤단계)"""
    y = sigmoid(x)
    return y * (1 - y)

check_grad("sigmoid (x=0)", sigmoid, sigmoid_grad, 0.0)
check_grad("sigmoid (x=2)", sigmoid, sigmoid_grad, 2.0)
🔗 GitHub에서 코드 보기 — 00_04_derivative_gradient_descent.py L44–L96
📘 코드 이해 — 유도한 수식이 코드 어디에 들어갔나
| 수학공식 | 코드 | 역할 |
|---|---|---|
2*(x+1), 24*x*(...)**3 | 손으로 유도한 결과를 그대로 타이핑 | |
1/(1+math.exp(-x)) | 분수·지수를 1:1로 옮김 | |
y = sigmoid(x); return y*(1-y) | 순전파 결과 재사용 — 속도의 비결 | |
rel_error < 1e-5 | 채점 기준 — 상대오차로 판정 (아래 디버깅 참고) |
🧩 코드 설명 — Python 기초
•
lambda x: ...— 이름 없는 한 줄짜리 함수입니다.lambda x: 2*(x+1)은def f(x): return 2*(x+1)과 완전히 같습니다. 짧은 수식을 인자로 넘길 때 편합니다.\
\
• 삼항 연산자"✅" if 조건 else "❌"— 조건이 참이면 앞의 값, 거짓이면 뒤의 값을 돌려줍니다. 한 줄 if-else입니다.\
\
• 정렬 서식{name:<22}— 문자열을 왼쪽 정렬하고 22칸을 차지하게 합니다.{analytic:10.6f}는 전체 10칸에 소수점 6자리. 표처럼 줄이 맞아 읽기 편해집니다.\
\
•math.exp(-x)— 입니다.math.e ** (-x)보다 정확하고 빠릅니다.\
\
• 왜1e-5로 비교하나? 수치미분에는 항상 미세한 오차가 있으므로==로 비교하면 절대 통과하지 못합니다. 부동소수점 비교는 항상 허용 오차와 함께 하세요.
✅🟩 실행 결과
✅ (x+1)^2                공식=    8.000000  수치=    8.000000  상대오차=1.1e-13
✅ (3x^2+1)^4             공식= 1536.000000  수치= 1536.000069  상대오차=4.5e-08
✅ ((2x+1)^2+3)^2         공식=   32.000000  수치=   32.000000  상대오차=1.0e-08
✅ sigmoid (x=0)          공식=    0.250000  수치=    0.250000  상대오차=2.1e-10
✅ sigmoid (x=2)          공식=    0.104994  수치=    0.104994  상대오차=6.5e-11
🎉 다섯 개 모두 통과했습니다. 예제 ③에서 손으로 예측했던 32가 정확히 나왔고, 시그모이드의 최댓값 0.25도 확인되었습니다. "유도 → 코드 → 검증"이라는 이 사이클이 앞으로 모든 장에서 반복됩니다. 🔁
👀 두 번째 줄을 주목하세요. 공식값 1536.000000과 수치값 1536.000069의 절대 차이는 약 로, 우리가 처음 쓰려던 기준 1e-5를 넘어섭니다. 유도는 완벽히 맞았는데도 ❌ 판정을 받게 되는 것이죠. 왜 이런 일이 생기고 어떻게 고쳐야 하는지는 바로 아래 디버깅 포인트에서 다룹니다. ⚠️
⚙️ 구현 관점 — 프레임워크는 이 규칙들을 클래스로 저장한다\
DeZero·PyTorch 같은 프레임워크는 미분 규칙 하나하나를 Function 클래스로 만들어두고, 순전파(forward)와 역전파(backward)를 한 쌍으로 정의합니다.
🐍 Python — DeZero 스타일: 공식이 클래스가 되는 순간
class Square(Function):
    """
    입력값을 제곱합니다.  f(x) = x^2,  f'(x) = 2x

    비유: 종이를 복사해서 두 장으로 만드는 것처럼
    같은 값을 한 번 더 곱합니다.
    """

    def forward(self, x):
        self.x = x              # 역전파에서 쓸 입력을 기억해둡니다
        return x ** 2           # 순전파: 공식 f(x)=x² 그대로

    def backward(self, gy):
        x = self.x
        gx = 2 * x * gy        # f'(x)=2x 에 연쇄법칙의 gy를 곱함
        return gx

class Sigmoid(Function):
    """
    σ(x) = 1/(1+e^-x),  σ'(x) = σ(x)(1-σ(x))

    비유: 아무리 큰 값이 들어와도 0~1 사이로 눌러 담는
    '압축 스펀지'와 같습니다.
    """

    def forward(self, x):
        y = 1 / (1 + np.exp(-x))
        self.y = y              # ★ 입력이 아니라 '출력'을 저장! (유도 ⑤ 덕분)
        return y

    def backward(self, gy):
        gx = gy * self.y * (1 - self.y)   # y(1-y) — 지수 재계산 불필요!
        return gx
🔗 GitHub에서 코드 보기 — 00_04_derivative_gradient_descent.py L100–L132
🔍 코드 상세 분석: forward는 우리가 쓴 공식 , backward는 유도한 입니다. gy는 "뒤쪽 층에서 흘러들어온 기울기"로, 연쇄법칙 에서 바깥쪽 곱셈 항을 담당합니다. Sigmoid가 입력 x가 아니라 출력 y를 저장하는 것이 핵심인데, 유도 ⑤단계에서 도함수를 만으로 표현했기 때문입니다. 수학적 정리 하나가 코드 성능을 바꾼 사례입니다. ⚡
🛠️ 실습 2 🔵
① 의 도함수를 손으로 유도하고
check_grad로 검증하세요. (정답: )\
② ReLU 의 도함수를 코드로 작성하고, 과 에서 검증하세요. (힌트: 은 미분 불가라 검증에서 제외)\
③Square를 본떠Cube(세제곱) 클래스를 만들어보세요. (backward는 `3*x2*gy`)**
🐞 실수하기 쉬운 부분 — 연쇄법칙의 "안쪽 미분" 누락
❌ 왜 틀리나? 를 미분하며 까지만 쓰고 끝내는 실수가 가장 흔합니다.\
❌ 원인: "바깥만 미분하면 된다"고 착각. 안쪽 를 곱하는 것을 잊음.\
✅ 수정: 항상 "바깥 미분 × 안쪽 미분" 두 개를 곱했는지 확인하세요. 괄호가 보이면 무조건 곱셈이 하나 더 있습니다.\
✅ 검산:check_grad로 돌려보면 즉시 ❌가 뜹니다 — 안쪽 미분을 빼먹으면 에서 공식값이 256, 수치값이 1536으로 6배나 차이 납니다.
🐞 디버깅 포인트 — 절대오차로 채점하면 멀쩡한 유도가 탈락한다 ⭐
❌ 왜 틀리나? 의 기울기는 1536이나 됩니다. 수치미분의 오차는 값의 크기에 비례해 커지므로, 절대오차가 가 나옵니다.
abs(a-b) < 1e-5로 채점하면 정답인데도 ❌가 됩니다.\
❌ 원인: 기울기가 0.25인 시그모이드와 1536인 다항식을 같은 잣대로 재려 했기 때문입니다. 키를 잴 때 개미와 코끼리에게 똑같이 "1mm 오차까지 허용"이라고 하는 셈입니다. 🐜🐘\
✅ 수정: 상대오차로 비교하세요.코드로는
abs(a-b)/max(1.0, abs(a)) < 1e-5입니다. 분모에max(1.0, ...)를 쓰는 이유는, 기울기가 0에 가까울 때 0으로 나누는 사고를 막기 위해서입니다.\
✅ 결과: 상대오차로 바꾸면 1536짜리도 로 여유 있게 통과합니다. PyTorch의torch.autograd.gradcheck도 정확히 이 방식(rtol/atol)을 씁니다. 🛡️
📍 3단계 — 편미분과 그래디언트
🔎 ① 핵심 정의\
신경망의 가중치는 하나가 아니라 수백만 개입니다. 변수가 여러 개인 함수에서 기울기를 구하려면 한 변수씩 따로 미분해야 하는데, 이것이 편미분(partial derivative)이고, 이를 전부 모아 벡터로 만든 것이 그래디언트(gradient)입니다.
❓ 왜 필요한가?\
"이 가중치 하나를 조금 키우면 손실이 얼마나 변하나?"를 가중치마다 따로 알아야, 각각을 얼마나 조정할지 정할 수 있기 때문입니다.
⏰ 언제 사용하는가?\
PyTorch에서 loss.backward()를 부르는 순간, 모든 파라미터의 편미분이 계산되어 .grad에 채워집니다. 그것이 곧 그래디언트입니다.
💜 더 쉽게 이해하기 — ⛰️ 등산로 갈림길과 나침반
🧭 산비탈에 서 있습니다. 동쪽으로 한 발 옮기면 1m 올라가고, 북쪽으로 한 발 옮기면 3m 올라간다고 해봅시다.
• "동쪽 방향 경사 = 1" ← 에 대한 편미분\
• "북쪽 방향 경사 = 3" ← 에 대한 편미분\
• 두 값을 화살표로 합친 ← 그래디언트 🏹이 화살표는 "가장 가파르게 올라가는 방향"을 정확히 가리킵니다. 우리는 내려가고 싶으니 그 반대쪽으로 걸으면 됩니다. 그게 다음 단계의 전부입니다. 🚶
🔢 진행 과정 — 편미분 계산 4단계
- 미분할 변수 하나를 고른다 (예: )
- 나머지 변수는 전부 숫자(상수)라고 생각한다 ← 핵심!
- 1변수 미분 공식을 그대로 적용한다
- 모든 변수에 대해 반복하고, 결과를 벡터로 묶는다 → 그래디언트
🔬 수학공식 ⑥ — 편미분과 그래디언트
편미분의 정의 — 한 변수만 흔들고 나머지는 고정
가 양쪽 모두에 그대로 들어있는 것에 주목하세요. 는 전혀 변하지 않습니다.\
\
그래디언트 — 편미분들을 모은 벡터변수 정의\
• : "파셜"이라 읽으며, 여러 변수 중 하나에만 미분한다는 표시\
• : "나블라(nabla)" — 그래디언트 기호\
• 결과는 숫자가 아니라 벡터입니다 (변수 개수만큼의 성분) ⚠️\
\
📌 1장과의 연결: 그래디언트는 벡터이므로, 00-01장에서 배운 크기(노름)를 잴 수 있습니다. 가 크면 경사가 가파르고, 0에 가까우면 평평한 지점입니다. 🔗
📐 예제로 익히기 — 세 가지
예제 ① 🟢 \
• 로 미분: 은 상수 → 미분하면 0. 따라서 \
• 로 미분: 은 상수 → 0. 따라서 \
• → 점 에서는 \
• 크기 — 00-01장의 3-4-5 삼각형이 여기서 다시 등장! 📐
예제 ② 🔵 (교차항이 있는 경우) \
• 로 미분: / 에서 는 상수이므로 / \
→ \
• 로 미분: / 에서 는 상수이므로 / \
→ \
• ⚠️ 교차항 는 양쪽 편미분 모두에 흔적을 남깁니다 — 빼먹기 쉬운 부분!
예제 ③ 🔴🚀 (실전! 선형회귀의 손실함수)\
00-03에서 배운 오차 제곱합을 데이터 개수로 나눈 것이 MSE 손실입니다.
• 안쪽 로 두면, 연쇄법칙으로:
• 이 두 식이 5단계에서 코드 두 줄이 됩니다. 지금 잘 봐두세요! 👀
📐 시각화 ④ — 등고선과 그래디언트 벡터장
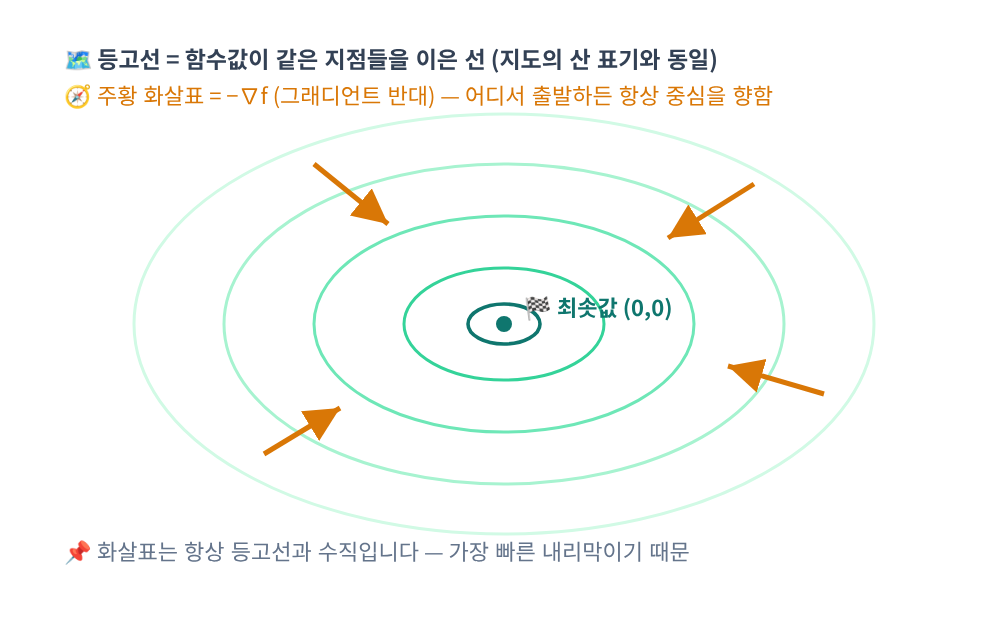
🔬 직관적 의미
그래디언트 는 함수 값이 가장 빠르게 증가하는 방향을 가리킵니다. 따라서 는 가장 빠르게 감소하는 방향이며, 이것이 다음 단계 경사하강법의 핵심 재료입니다. 🧭\
또 하나: 그래디언트는 항상 등고선과 직각입니다. 등고선을 따라가면 높이가 안 변하니, 높이를 가장 빨리 바꾸려면 그 선을 수직으로 가로질러야 하기 때문입니다.
⚙️ 구현 원리 — 벡터 버전 수치미분\
변수가 여러 개면, 각 성분을 하나씩 돌아가며 아주 조금 흔들어보고 함수값 변화를 측정합니다. 나머지 성분은 그대로 두는 것이 편미분의 정의 그 자체입니다.
🐍 Python — 그래디언트를 공식과 수치 두 방법으로
import numpy as np

def numerical_gradient(f, p, h=1e-4):
    """
    다변수 함수 f 의 점 p 에서의 그래디언트를 수치적으로 구합니다.

    비유: 엘리베이터 버튼을 하나씩 눌러보는 것과 같습니다.
    한 번에 하나의 성분만 살짝 움직여서 반응을 관찰합니다.
    """
    grad = np.zeros_like(p)              # 결과를 담을 빈 벡터 (p와 같은 모양)

    for i in range(p.size):        # 성분을 하나씩 순회 (= 편미분)
        tmp = p[i]                       # 원래 값을 잠시 보관

        p[i] = tmp + h                   # i번째만 +h
        f_plus  = f(p)

        p[i] = tmp - h                   # i번째만 -h
        f_minus = f(p)

        grad[i] = (f_plus - f_minus) / (2 * h)   # 중심차분
        p[i] = tmp                       # ★ 반드시 원상복구! (안 하면 다음 성분이 오염됨)

    return grad

# ── 예제 ①: f(x,y) = x² + y² ─────────────────────────────
def f_circle(p):
    """f(x,y) = x^2 + y^2  → ∇f = (2x, 2y)"""
    return p[0]**2 + p[1]**2

point = np.array([3.0, 4.0])
formula = np.array([2*point[0], 2*point[1]])   # 공식 ∇f=(2x,2y)
numeric = numerical_gradient(f_circle, point.copy())

print("[예제①] 공식 :", formula)
print("[예제①] 수치 :", np.round(numeric, 6))
print("[예제①] 크기 :", np.linalg.norm(formula), "← 00-01장의 노름!")

# ── 예제 ②: f(x,y) = 3x² + 2xy + y³ ──────────────────────
def f_cross(p):
    """∂f/∂x = 6x+2y,  ∂f/∂y = 2x+3y²"""
    x, y = p[0], p[1]
    return 3*x**2 + 2*x*y + y**3

p2 = np.array([1.0, 2.0])
formula2 = np.array([6*1 + 2*2, 2*1 + 3*2**2])   # (10, 14)
print("[예제②] 공식 :", formula2)
print("[예제②] 수치 :", np.round(numerical_gradient(f_cross, p2.copy()), 6))
🔗 GitHub에서 코드 보기 — 00_04_derivative_gradient_descent.py L136–L183
📘 코드 이해 — 편미분의 정의가 코드 어디에 있나
| 수학 | 코드 | 설명 |
|---|---|---|
| "한 변수만 흔든다" | p[i] = tmp + h | 번째 성분만 변경, 나머지는 그대로 |
| "나머지는 상수" | 다른 인덱스는 건드리지 않음 | 편미분의 정의가 그대로 구현됨 |
(f_plus-f_minus)/(2*h) | 1단계 중심차분을 성분마다 반복 | |
grad 배열 | 편미분들을 모은 벡터 | |
| — | p[i] = tmp | ⚠️ 원상복구 — 이 줄을 빼면 결과 전체가 틀어짐 |
🧩 코드 설명 — Python/NumPy 기초
•
np.zeros_like(p)—p와 같은 모양·같은 dtype의 0으로 채운 배열을 만듭니다. 결과 그릇을 미리 준비하는 관용구입니다.\
\
•p.size— 배열의 전체 원소 개수입니다. (모양을 알려주는.shape와 구분하세요)\
\
•point.copy()⚠️ — NumPy 배열은 함수에 넘길 때 참조가 전달됩니다. 복사하지 않고 넘기면 함수 안의p[i] = tmp + h가 원본까지 바꿔버립니다. 이런 버그를 "부수 효과(side effect)"라 하며 찾기가 매우 어렵습니다.\
\
•x, y = p[0], p[1]— 튜플 언패킹으로 두 변수를 한 줄에 꺼냅니다. 수식의 와 코드 변수명을 일치시키면 검증이 쉬워집니다.
✅🟩 실행 결과
[예제①] 공식 : [6. 8.]
[예제①] 수치 : [6. 8.]
[예제①] 크기 : 10.0 ← 00-01장의 노름!
[예제②] 공식 : [10 14]
[예제②] 수치 : [10. 14.]
✅ 손으로 유도한 과 가 수치미분과 정확히 일치합니다. 특히 예제 ②의 교차항 가 두 편미분 모두에 제대로 반영되었음이 확인되었습니다. 🎯
🛠️ 실습 3 🔵
① 의 그래디언트를 손으로 구하고 에서 검증하세요. (정답: )\
② 3변수 의 그래디언트를numerical_gradient로 구해보세요. (정답: )\
③p[i] = tmp줄을 일부러 지우고 실행해서 결과가 어떻게 망가지는지 관찰하세요. 🔍
🐞 실수하기 쉬운 부분
❌ 실수 ① 원상복구 누락 —
p[i] = tmp를 빼면 첫 성분이 만큼 어긋난 채로 다음 성분을 계산하게 되어 모든 결과가 조용히 틀립니다. 에러도 안 납니다.\
❌ 실수 ② 원본 배열 오염 —.copy()없이 넘기면 호출한 쪽의point까지 바뀝니다. 수정: 함수 첫 줄에서p = p.astype(float).copy()로 방어하는 것도 좋습니다.\
❌ 실수 ③ 정수 배열 —np.array([3, 4])는 정수형이라p[i] = tmp + 1e-4가 그냥 3으로 잘려버립니다. 그래디언트가 전부 0으로 나오면 이걸 의심하세요. 수정:np.array([3.0, 4.0])처럼 소수점을 붙이세요.\
❌ 실수 ④ 교차항 누락 — 를 로 미분할 때 를 상수로 보고 를 남겨야 하는데, 통째로 0으로 처리하는 실수가 흔합니다.
💻 GitHub 실습 — 코드로 직접 확인하기
📂 이 장의 코드 폴더: book/00-math-overview-for-beginners/00-04-derivative-gradient-descent
책에 실린 코드를 장(절)별로 모아 둔 폴더입니다. 아래 파일을 열어 보거나, Colab에서 바로 실행해 보세요.
| 파일 | 용도 | 링크 |
|---|---|---|
00_04_derivative_gradient_descent.py | 책의 코드 블록 10개를 순서대로 모은 실행 스크립트 (# %% 셀 구분) | 코드 보기 |
00_04_derivative_gradient_descent.ipynb | 같은 코드를 블록당 셀 1개로 담은 주피터 노트북 | 보기 · Colab |
README.md | 코드 블록 목록 · 실행 방법 · 검증 결과 | 보기 |
🎬 medium-series/06-1-derivatives/ | Medium 시리즈 예제 — 같은 주제를 블로그용으로 다듬은 실습 | 폴더 · Colab |
🧪 저장소 검증 상태: 🧩 문맥 필요(조각) —
Function이(가) 이 절 안에서 정의되지 않습니다 — 데이터·변수·클래스를 미리 준비했다고 가정한 설명용 코드 조각입니다.
🔑 핵심 코드 1 — 전진차분 vs 중심차분 수치미분
📄 00_04_derivative_gradient_descent.py L16–L40 · Block 1 (📍 1단계 — 미분(Derivative)이란 무엇인가?)
def forward_diff(f, x, h=1e-4):
    """
    전진차분: (f(x+h) - f(x)) / h
    비유: 앞쪽만 보고 경사를 재는 것 — 한쪽으로 치우친 측정
    """
    return (f(x + h) - f(x)) / h          # 공식 그대로!

def numerical_diff(f, x, h=1e-4):
    """
    중심차분: (f(x+h) - f(x-h)) / (2h)
    비유: 앞뒤로 똑같이 한 걸음씩 가서 재는 것 — 좌우 오차가 상쇄됨
    """
    return (f(x + h) - f(x - h)) / (2 * h)  # 공식 그대로!

def square(x):
    """f(x) = x^2  (참값 미분: f'(x) = 2x, 따라서 f'(3) = 6)"""
    return x ** 2

# h를 바꿔가며 두 방식의 오차를 비교합니다
true_value = 6.0
for h in [1e-2, 1e-4, 1e-8]:
    fwd = forward_diff(square, 3.0, h)
    cen = numerical_diff(square, 3.0, h)
    print(f"h={h:.0e} | 전진={fwd:.8f} (오차 {abs(fwd-true_value):.1e})"
          f" | 중심={cen:.8f} (오차 {abs(cen-true_value):.1e})")
▶ 실행 결과 — 위 코드를 실행한 출력 (직접 실행: Windows · Python 3.11.2 · numpy 2.4.6, 앞 블록부터 순서대로 실행)
h=1e-02 | 전진=6.01000000 (오차 1.0e-02) | 중심=6.00000000 (오차 1.3e-13)
h=1e-04 | 전진=6.00010000 (오차 1.0e-04) | 중심=6.00000000 (오차 1.3e-11)
h=1e-08 | 전진=5.99999996 (오차 3.6e-08) | 중심=5.99999996 (오차 3.6e-08)
🔑 핵심 코드 2 — 수치 그래디언트 numerical_gradient
📄 00_04_derivative_gradient_descent.py L138–L172 · Block 4 (📍 3단계 — 편미분과 그래디언트)
def numerical_gradient(f, p, h=1e-4):
    """
    다변수 함수 f 의 점 p 에서의 그래디언트를 수치적으로 구합니다.

    비유: 엘리베이터 버튼을 하나씩 눌러보는 것과 같습니다.
    한 번에 하나의 성분만 살짝 움직여서 반응을 관찰합니다.
    """
    grad = np.zeros_like(p)              # 결과를 담을 빈 벡터 (p와 같은 모양)

    for i in range(p.size):        # 성분을 하나씩 순회 (= 편미분)
        tmp = p[i]                       # 원래 값을 잠시 보관

        p[i] = tmp + h                   # i번째만 +h
        f_plus  = f(p)

        p[i] = tmp - h                   # i번째만 -h
        f_minus = f(p)

        grad[i] = (f_plus - f_minus) / (2 * h)   # 중심차분
        p[i] = tmp                       # ★ 반드시 원상복구! (안 하면 다음 성분이 오염됨)

    return grad

# ── 예제 ①: f(x,y) = x² + y² ─────────────────────────────
def f_circle(p):
    """f(x,y) = x^2 + y^2  → ∇f = (2x, 2y)"""
    return p[0]**2 + p[1]**2

point = np.array([3.0, 4.0])
formula = np.array([2*point[0], 2*point[1]])   # 공식 ∇f=(2x,2y)
numeric = numerical_gradient(f_circle, point.copy())

print("[예제①] 공식 :", formula)
print("[예제①] 수치 :", np.round(numeric, 6))
print("[예제①] 크기 :", np.linalg.norm(formula), "← 00-01장의 노름!")
▶ 실행 결과 — 위 코드를 실행한 출력 (직접 실행: Windows · Python 3.11.2 · numpy 2.4.6, 앞 블록부터 순서대로 실행)
[예제①] 공식 : [6. 8.]
[예제①] 수치 : [6. 8.]
[예제①] 크기 : 10.0 ← 00-01장의 노름!
📝 실행 메모
☁️ Colab에서 바로 실행
👉 Open in Colab — 00_04_derivative_gradient_descent.ipynb · 설치 없이 브라우저에서 셀을 위에서부터 순서대로 실행하세요.
🖥️ 내 컴퓨터에서 실행하기
git clone https://github.com/otoloism/Zero_to_ML_Master.git
cd Zero_to_ML_Master
python -m venv .venv
source .venv/bin/activate          # Windows: .venv\Scripts\activate
pip install -r book/requirements.txt   # 책 전체용 (PyTorch 등 포함, 용량 큼)
# 이 장만 실행한다면 이것만으로 충분합니다: pip install numpy
cd book/00-math-overview-for-beginners/00-04-derivative-gradient-descent
python 00_04_derivative_gradient_descent.py
📦 이 장의 일부 블록은 JAX, PyTorch, TensorFlow 이(가) 필요합니다. 설치하지 않으면 해당 블록만 오류가 나고 나머지는 정상 실행됩니다.
⭐ GitHub Star / Fork
⭐ 코드가 도움이 되셨다면 GitHub 저장소에 Star를 눌러 주세요. 새 장의 코드가 올라올 때 가장 먼저 알 수 있습니다.
🍴 직접 고쳐 보며 실험하고 싶다면 Fork 해서 내 저장소에서 마음껏 바꿔 보세요. 오류 제보·개선 제안은 Issues로 환영합니다!
🔮 다음 글 예고
다음 글은 00-04 미분·경사하강법 (2부) — 경사하강법 완전 정복 ⛰️ 입니다. 그래디언트의 반대 방향으로 한 걸음씩 내려가는 한 줄 공식 , 학습률에 따른 수렴·진동·발산과 발산 조건 유도, 선형회귀 학습, 그리고 PyTorch·TensorFlow·JAX의 자동미분까지 이어집니다.
⬅️ 이전 글: #04 최소제곱법과 정규방정식 — 선형회귀가 머신러닝의 첫 모델인 이유 (파이썬 NumPy) \
➡️ 다음 글: #06 경사하강법 완전 정복 — 학습률·발산 조건·선형회귀·자동미분 (딥러닝 수학, 2부)
📚 더 깊이 공부하고 싶다면
이 시리즈는 수학을 놓았던 비전공자가 AI를 직접 구현하기까지의 공부 기록을 그대로 옮긴 연재입니다. 원문 책, 코드, 개념 사전을 함께 보면 훨씬 빨리 늡니다. 🚀
| 바로가기 | 이런 분께 | |
|---|---|---|
| 📘 책 (위키독스, 무료) | Zero to 머신러닝 딥러닝 Master | 5권 · 20개 장 · 163개 절 전체를 순서대로 읽고 싶은 분 |
| 📄 이 글의 원문 | 00-04 미분·경사하강법 — 안개 낀 산에서 내려오기 (1부) | 연습문제·해설까지 전부 보고 싶은 분 |
| 💻 실습 코드 (GitHub) | otoloism/Zero_to_ML_Master | .py·.ipynb를 Colab에서 바로 돌려보고 싶은 분 |
| 🏠 머신러닝 백과사전 | mldict.net | 본문 속 핵심 개념을 카드로 다시 확인하고 싶은 분 |
| ✍️ 기술 블로그 | wikidocs.net/blog/@mldict | 새 글 알림을 가장 먼저 받고 싶은 분 |
⭐ 도움이 되셨다면 velog 팔로우와 GitHub Star를 눌러 주세요. 다음 글을 쓰는 가장 큰 힘이 됩니다. 궁금한 점은 댓글로 편하게 남겨 주세요! 🙌