[Zero to ML Master #04] 최소제곱법과 정규방정식 — 선형회귀가 머신러닝의 첫 모델인 이유 (파이썬 NumPy)
Zero to 머신러닝 딥러닝 Master
100명의 키와 몸무게 데이터로 "키가 cm이면 몸무게는 대략 얼마"를 예측하는 직선을 긋고 싶다고 해 봅시다. 식은 100개인데 미지수(기울기·절편)는 2개뿐이라, 모든 점을 정확히 지나는 직선은 존재하지 않습니다. 📏
이럴 때 "완벽한 정답" 대신 "전체 오차가 가장 작은 답" 을 찾는 방법이 최소제곱법이에요. 그리고 이게 바로 선형회귀, 머신러닝의 첫 번째 모델입니다.
📘 이 글은 위키독스 도서 Zero to 머신러닝 딥러닝 Master 의 00-03 연립방정식 — "x가 뭔지 맞춰보세요" 게임 을 블로그용으로 다듬은 글입니다.
💻 실습 코드: GitHub · 🏠 mldict.net · ✍️ 기술 블로그
💻 이 글의 코드:
00-03-linear-systems-guess-x· Open in Colab — 핵심 코드와 실제 실행 결과는 글 아래 💻 GitHub 실습 섹션에 있습니다.
⬅️ 이전 글: #03 행렬 쉽게 이해하기 — shape·행렬 곱셈·역행렬이 필요한 이유 (파이썬 NumPy) \
➡️ 다음 글: #05 미분 쉽게 이해하기 — 수치미분·연쇄법칙·그래디언트 (딥러닝 수학, 1부)
TL;DR — 3줄 요약
- 식이 미지수보다 많은 과결정계에서는 완벽한 해 대신 오차 제곱합이 최소인 해를 찾습니다.
- 잔차가 수직(직교) 일 때가 최단거리이고, 그 조건에서 정규방정식 가 나옵니다.
- 이것이 곧 선형회귀이며, 신경망 의 원형입니다.
🅶 최소제곱법 — "완벽한 답이 없을 때, 최선의 답 찾기" 🔴 심화 ⭐
00-03-Q1 🔴 "최선의 답"이라는 발상의 전환 — 과결정계(Overdetermined System)
① 핵심 정의 — 무엇인가?\
최소제곱법(Least Squares Method)은 모든 식을 정확히 만족하는 해가 존재하지 않을 때, "완벽한 정답" 대신 "전체 오차가 가장 작은 근사해"를 찾는 방법입니다.
왜 필요한가?\
앞에서 우리는 식 2개 · 미지수 2개인 깔끔한 상황만 다뤘습니다. 그런데 현실의 데이터 분석은 정반대입니다.
📏⚖️ "100명의 키와 몸무게 데이터가 있습니다. '키가 cm이면 몸무게는 대략 얼마'라고 예측하는 직선 하나를 긋고 싶습니다."
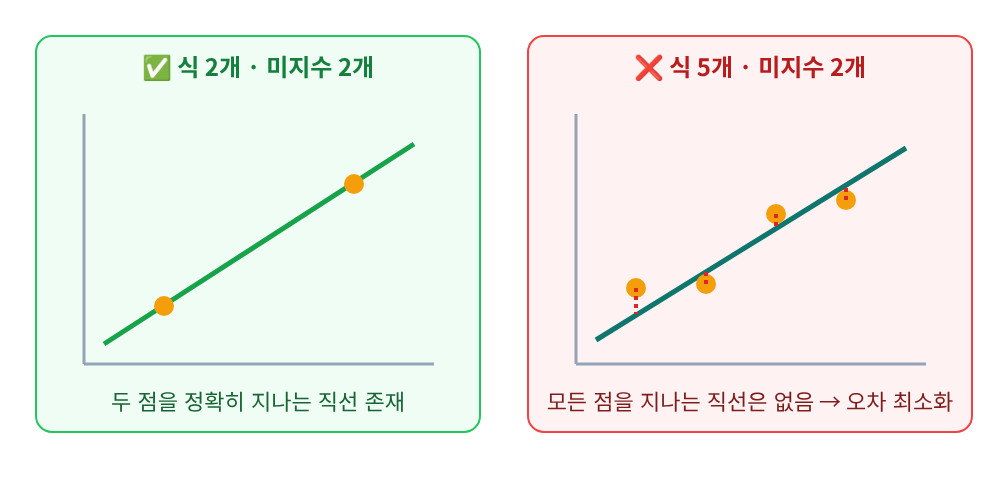
이 상황을 식으로 옮기면 식은 100개(사람 100명 각각이 직선 위에 정확히 놓여야 한다)인데, 미지수는 단 2개(기울기 , 절편 )뿐입니다. 이렇게 식의 개수 > 미지수의 개수인 시스템을 과결정계(overdetermined system)라고 부릅니다.
100명의 키·몸무게가 정확히 하나의 직선 위에 줄지어 놓일 리는 없습니다. 사람마다 체질이 다르니까요. 즉 완벽한 해는 "거의 항상" 존재하지 않습니다. ❌
언제 사용하는가?\
🔹 데이터에서 추세선(직선·곡선)을 찾을 때 → 선형회귀\
🔹 측정 오차가 섞인 관측값으로 물리 상수를 추정할 때\
🔹 머신러닝에서 MSE 손실을 최소화하는 모델을 학습할 때 🚀
🧸 더 쉽게 이해하기 — 👕 단체 티셔츠 비유
동아리 30명에게 단체 티셔츠 한 종류를 맞춰야 합니다. 30명의 몸에 전부 완벽히 맞는 사이즈는 세상에 없습니다. 그렇다고 포기할 수는 없죠.
그래서 우리는 "모두에게 완벽한 옷"이 아니라 "전체적으로 불편함이 가장 적은 옷"을 고릅니다. 👕 최소제곱법이 하는 일이 정확히 이것입니다. 여기서 "불편함"을 숫자로 잰 것이 오차이고, "전체 불편함의 총합"을 최소로 만드는 사이즈가 최소제곱해입니다.
🔢 진행 과정 — 최소제곱법의 5단계
- 직선을 하나 가정한다 (기울기 , 절편 는 아직 모름)
- 각 데이터마다 예측값을 계산한다 →
- 실제값과의 차이(잔차)를 구한다 →
- 잔차를 제곱해서 모두 더한다 → 오차 제곱합
- 를 가장 작게 만드는 를 찾는다 ← 이것이 정답 ✅
🔬 수학공식 ① — 과결정계와 잔차
등호()가 아니라 근사 기호()가 쓰인 점에 주목하세요. "정확히 같게 만들 수는 없고, 최대한 가깝게 맞춘다"는 뜻입니다.\
\
잔차 벡터는 "실제값과 예측값의 차이"를 모아놓은 벡터입니다.변수 정의\
• : 설계행렬(design matrix) — 각 행이 데이터 하나, 각 열이 미지수 하나\
• : 우리가 찾을 미지수 벡터 (예: 기울기·절편)\
• : 실제 관측값 벡터 (예: 실제 몸무게)\
• : 데이터(식)의 개수, : 미지수의 개수, 조건은 \
• : 잔차(residual) 벡터 — 각 성분 가 데이터 의 오차
📊 시각화 ①: 완벽한 해 vs 최선의 근사해
00-03-Q2 🔴 왜 오차를 하필 "제곱"해서 더할까? — 세 가지 이유
오차를 모으는 방법은 여러 가지가 있을 수 있습니다. 그냥 더할 수도 있고, 절댓값을 씌워 더할 수도 있습니다. 그런데 왜 하필 제곱일까요? 이유가 세 가지 있습니다. 🧩
🔬 수학공식 ② — 오차 제곱합(SSE)
행렬 표기로는 잔차 벡터의 길이(노름)의 제곱과 완전히 같습니다.
변수 정의\
• : 오차 제곱합(Sum of Squared Errors, SSE) — 우리가 최소화할 대상\
• : 번째 데이터의 실제 값\
• : 직선이 내놓은 예측 값 ( 기호는 "추정값"을 뜻함)\
• : 번째 잔차\
\
📌 1장과의 연결: 는 00-01장에서 배운 노름(벡터의 크기)입니다. 즉 "오차 제곱합을 최소화한다"는 말은 "잔차 벡터의 길이를 가장 짧게 만든다"는 말과 정확히 같습니다! 🔗
🧸 더 쉽게 이해하기 — ⛽ 연비 측정 비유
내비게이션이 "10분 후 도착"이라 했는데 실제로 5분 일찍 도착하기도 하고 5분 늦게 도착하기도 합니다. 두 오차를 그냥 더하면 → "내 내비게이션은 완벽하다!" 라는 황당한 결론이 납니다. 🚗💨
하지만 제곱해서 더하면 → 오차가 확실히 존재한다는 것이 드러납니다. 제곱은 "부호를 지우는 장치"인 셈입니다.
📖 이유 ① — 부호 상쇄를 막는다\
오차에는 양수(실제보다 낮게 예측)와 음수(높게 예측)가 섞여 있습니다. 그냥 더하면 서로 상쇄되어, 오차가 큰데도 합계가 0에 가깝게 나오는 착시가 생깁니다. 제곱하면 모든 값이 0 이상이 되어 "오차의 크기"만 순수하게 누적됩니다.
📖 이유 ② — 큰 오차에 더 큰 벌점을 준다\
오차 1은 제곱해도 1이지만, 오차 10은 제곱하면 100이 됩니다. 즉 제곱은 "크게 빗나간 예측"을 훨씬 강하게 처벌합니다. "작은 실수 열 번보다 큰 실수 한 번이 더 나쁘다"는 판단을 수식에 담은 것입니다. ⚖️
📖 이유 ③ — 미분이 가능하다 (가장 중요!) ⭐\
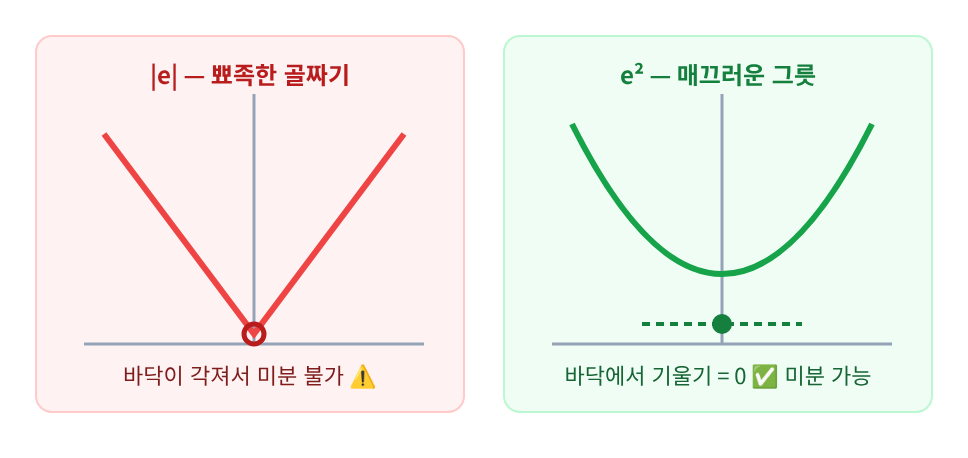
절댓값 함수 는 0인 지점에서 뾰족해서 미분이 되지 않습니다. 반면 제곱 함수 는 어디서나 매끄러워 미분이 깔끔하게 됩니다. 00-04장에서 배울 "미분해서 0이 되는 지점 찾기"를 쓰려면 반드시 매끄러운 함수여야 합니다. 그리고 이 성질 덕분에 깔끔한 공식 하나로 정답을 딱 구할 수 있게 됩니다. 🔑
📋 오차를 모으는 세 가지 방법 비교
| 방법 | 수식 | 부호 상쇄 | 미분 | 평가 |
|---|---|---|---|---|
| 그냥 합 | ❌ 발생 | ✅ | 사용 불가 (0이 되어버림) | |
| 절댓값 합 (L1/MAE) | ✅ 없음 | ⚠️ 0에서 불가 | 이상치에 강함, 공식해 없음 | |
| 제곱 합 (L2/SSE) ⭐ | ✅ 없음 | ✅ 매끄러움 | 공식 하나로 정답, 이상치엔 민감 |
👉 제곱합의 유일한 약점은 이상치(outlier)에 민감하다는 것입니다. 데이터 하나가 크게 튀면 그 제곱값이 전체를 지배해버리기 때문입니다. 이 문제를 다루는 방법(Huber 손실 등)은 뒤 권에서 다룹니다. 📌
📊 시각화 ②: 절댓값(뾰족) vs 제곱(매끄러움)
💡 직관적 의미 — 그릇의 바닥 찾기\
오차 제곱합 는 위 그림 오른쪽처럼 매끄러운 그릇(포물면) 모양입니다. 🥣 우리가 할 일은 이 그릇의 가장 낮은 바닥 지점을 찾는 것이고, 바닥에서는 기울기(미분값)가 정확히 0입니다. 00-04장에서 배울 경사하강법은 이 그릇을 한 걸음씩 굴러 내려가는 방법이고, 지금 배울 정규방정식은 계산 한 번으로 바닥 좌표를 바로 알아내는 지름길입니다. 🎯
00-03-R1 🔴⭐ 최소제곱법의 공식 — 정규방정식(Normal Equation) 유도
최소제곱법으로 구한 답은 다음 단 하나의 공식으로 표현됩니다.
처음 보면 무섭게 느껴지지만, 이미 배운 세 가지 도구의 조합일 뿐입니다. 🧩
- 🔄 — 전치행렬 (00-02장에서 배웠습니다: 행과 열을 맞바꾸기)
- ✖️ — 행렬 곱셈 (2장: 행과 열의 내적)
- 🔁 — 역행렬 (2장: 나눗셈 대용)
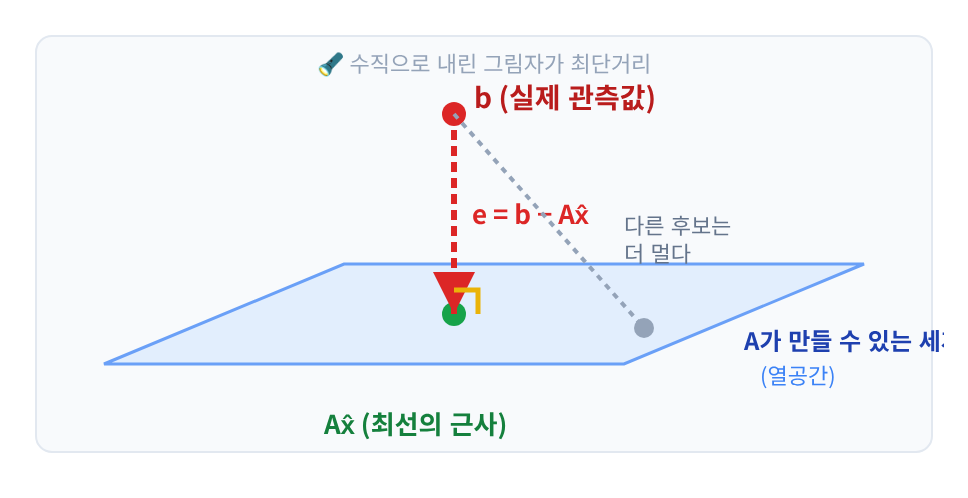
🧸 더 쉽게 이해하기 — 🔦 그림자(정사영) 비유
방 안에 평평한 벽이 하나 있고, 공중에 점 가 떠 있습니다. 점은 벽 위에 있지 않습니다(= 완벽한 해가 없음). 그렇다면 벽 위에서 그 점과 가장 가까운 자리는 어디일까요?
🔦 정답은 점에서 벽으로 수직으로 빛을 비췄을 때 생기는 그림자 지점입니다. 비스듬히 내려가면 언제나 더 멀어지고, 수직(직각)으로 내려갈 때가 최단거리입니다.
여기서 "벽"은 가 만들 수 있는 모든 값의 세계이고, "그림자"가 바로 최소제곱해 입니다. 그리고 "수직"이라는 조건 하나에서 공식이 통째로 튀어나옵니다. ✨
📊 시각화 ③: 잔차가 "수직"일 때 거리가 최소
🔬 수학공식 ③ — 정규방정식 단계별 유도 (직교 조건 방식)
① 조건 세우기 — 잔차 가 의 모든 열과 직각이어야 최단거리입니다. 00-01장에서 배웠듯 "직각 = 내적이 0"이므로:
② 괄호 풀기
③ 이항하기 — 이 식을 정규방정식(Normal Equation)이라 부릅니다. 여기서 "normal"은 "정상"이 아니라 "수직"이라는 뜻입니다! 📐
④ 양변 왼쪽에 곱하기 — 00-02장에서 배운 "역행렬로 떼어내기"입니다.
⑤ 이고 이므로
🔤 변수 정의 총정리
| 기호 | 이름 | 크기 | 키·몸무게 예제에서는 |
|---|---|---|---|
| 설계행렬 | 각 행이 (키, 1) | ||
| 관측 벡터 | 실제 몸무게들 | ||
| 최소제곱해 | (기울기 , 절편 ) | ||
| 그람 행렬 | 2×2 정사각행렬 (역행렬 가능!) | ||
| 잔차 벡터 | 실제 − 예측 |
📖 수학적 의미 — 가 등장하는 이유\
원래 는 (예: 100×2)인 세로로 긴 행렬이라 정사각행렬이 아니고, 따라서 역행렬 자체가 존재하지 않습니다. 🚫 그런데 양쪽에 를 곱해주면 는 (2×2)짜리 정사각행렬이 됩니다. 즉 를 곱하는 행위는 "역행렬을 쓸 수 있는 형태로 문제를 접어 넣는 마법"인 셈입니다. ✨
⚠️ 미분으로 유도해도 결과는 같습니다
위에서는 "직교 조건"으로 유도했지만, 를 로 미분해서 0으로 놓아도 정확히 같은 식 가 나옵니다. 즉 "그릇의 바닥"(미분)과 "수직 그림자"(기하)는 같은 이야기입니다. 미분 방식의 상세한 유도는 00-04장에서 다룹니다. 📌
00-03-R2 🔴 공식을 손으로 직접 굴려보기 — 데이터 3개 미니 예제
공식은 직접 한 번 굴려봐야 내 것이 됩니다. 아주 작은 데이터 세 개로 해봅시다. 데이터: , , — 즉 가 1,2,3일 때 가 2,3,5입니다.
찾을 직선은 이므로, 미지수 벡터는 이고 설계행렬은 다음과 같습니다.
📌 두 번째 열이 전부 1인 이유: 직선 식은 이므로, 절편 앞에 곱해지는 값이 항상 1이기 때문입니다. 이 열을 빼먹으면 원점을 억지로 지나는 직선만 찾게 됩니다! ⚠️
1단계 — 계산 (00-02 행렬 곱셈)
계산 과정
Aᵀ = [[1, 2, 3],
      [1, 1, 1]]        ← A의 행과 열을 맞바꾼 것 (2×3)

AᵀA (1행1열) = 1×1 + 2×2 + 3×3 = 14   ← Σx²
AᵀA (1행2열) = 1×1 + 2×1 + 3×1 =  6   ← Σx
AᵀA (2행1열) = 1×1 + 1×2 + 1×3 =  6   ← Σx
AᵀA (2행2열) = 1×1 + 1×1 + 1×1 =  3   ← 데이터 개수 m

AᵀA = [[14, 6],
       [ 6, 3]]         ← 2×2 정사각행렬 완성! ✅
2단계 — 계산
계산 과정
Aᵀb (1행) = 1×2 + 2×3 + 3×5 = 2 + 6 + 15 = 23   ← Σxy
Aᵀb (2행) = 1×2 + 1×3 + 1×5 = 2 + 3 +  5 = 10   ← Σy

Aᵀb = [23, 10]
3단계 — 역행렬 구하기 (2×2 역행렬 공식: )
계산 과정
행렬식 det = 14×3 - 6×6 = 42 - 36 = 6      ← 0이 아니므로 역행렬 존재 ✅

(AᵀA)⁻¹ = (1/6) × [[ 3, -6],
                    [-6, 14]]
4단계 — 최종 답
계산 과정
a = (1/6) × ( 3×23 + (-6)×10 ) = (1/6) × (69 - 60) = 9/6 = 1.5
b = (1/6) × ((-6)×23 +  14×10 ) = (1/6) × (-138 + 140) = 2/6 ≈ 0.3333

→ 찾은 직선:  y = 1.5x + 0.333
🟩 실행 결과 (검산)
x=1 → 예측 1.833 / 실제 2 → 잔차 +0.167
x=2 → 예측 3.333 / 실제 3 → 잔차 -0.333
x=3 → 예측 4.833 / 실제 5 → 잔차 +0.167

잔차의 합   = 0.000   ← 최소제곱해의 특징! ✅
오차 제곱합 = 0.1667  ← 이보다 작은 직선은 존재하지 않음
📌 주목할 점: 잔차의 합이 정확히 0이 되었습니다. 이것은 우연이 아니라, 절편 항(1로 채운 열)이 있는 최소제곱해라면 항상 성립하는 성질입니다. 유도 ①의 에서 두 번째 줄이 바로 ""을 뜻하기 때문입니다. 🔍
00-03-R3 🔴 구현 원리와 코드 — 공식·lstsq 두 방법 비교
⚙️ 구현 관점\
np.linalg.lstsq()는 방금 유도한 를 겉으로는 같은 답으로, 속으로는 더 안전하게 계산합니다. 실제로는 역행렬을 만들지 않고 QR 분해나 SVD라는 기법을 사용하는데, 를 직접 만들면 수치 오차가 제곱으로 증폭되기 때문입니다. 그래서 공식은 이해용, 실무 코드는 lstsq가 정석입니다. 🛡️
💻 코드 구현 (주석 포함) — 원고의 키·몸무게 데이터 5명으로 두 방법을 모두 돌려봅니다.
🐍 Python
import numpy as np

# ── 데이터: 5명의 키(cm)와 몸무게(kg) ──────────────────────
height = np.array([165, 170, 175, 180, 185], dtype=float)
weight = np.array([58,  65,  70,  75,  82],  dtype=float)

# ── 설계행렬 A 만들기 ─────────────────────────────────────
# 찾고 싶은 직선: weight = a×height + b×1
# → 각 행이 (height, 1)이 되도록 1로 채운 열을 붙입니다 (절편 항!)
A = np.column_stack([height, np.ones(len(height))])
b = weight

print("A shape:", A.shape, "| b shape:", b.shape)   # (5,2) (5,)

# ── 방법 1) 정규방정식 공식을 그대로 구현 (이해용) ──────────
# x̂ = (AᵀA)⁻¹ Aᵀb  ← 방금 유도한 공식 그 자체
x_formula = np.linalg.inv(A.T @ A) @ A.T @ b

# ── 방법 2) lstsq 사용 (실무 권장) ────────────────────────
# rcond=None: 버전 경고 방지 / [0]: 반환 튜플의 첫 원소가 해
x_lstsq = np.linalg.lstsq(A, b, rcond=None)[0]

a_hat, b_hat = x_lstsq          # 튜플 언패킹: 기울기, 절편
print("공식 방식 :", np.round(x_formula, 4))
print("lstsq     :", np.round(x_lstsq,   4))
print(f"찾은 직선: 몸무게 = {a_hat:.2f} × 키 + ({b_hat:.2f})")

# ── 잔차와 오차 제곱합 확인 ───────────────────────────────
pred     = A @ x_lstsq          # 예측값 ŷ = Ax̂
residual = b - pred             # 잔차 e = b - Ax̂
sse      = np.sum(residual ** 2)   # 오차 제곱합 S = Σeᵢ²

print("잔차      :", np.round(residual, 3))
print("잔차 합   :", round(residual.sum(), 10), "← 0이어야 정상")
print("오차제곱합:", round(sse, 4))

# ── 직교 조건 검증: Aᵀe = 0 이어야 함 (유도 ①단계) ─────────
print("Aᵀe (≈0?) :", np.round(A.T @ residual, 10))

# ── 예측해보기 ────────────────────────────────────────────
new_height = 168
print(f"키 {new_height}cm 예측 몸무게: {a_hat * new_height + b_hat:.1f}kg")
🔗 GitHub에서 코드 보기 — 00_03_linear_systems_guess_x.py L12–L53
📘 코드 이해 — 한 줄씩 공식과 맞춰보기
| 코드 | 대응하는 수식 | 하는 일 |
|---|---|---|
np.column_stack([height, np.ones(...)]) | 키 옆에 1로 채운 열을 붙여 설계행렬 완성 (절편 항) | |
A.T | 전치행렬 — 00-02장에서 배운 행↔열 교환 | |
A.T @ A | 2×2 정사각행렬로 접기 (역행렬 가능해짐) | |
np.linalg.inv(...) @ A.T @ b | 공식 그대로 계산 — 이해용 | |
np.linalg.lstsq(A, b, rcond=None)[0] | 같은 답을 더 안전하게 — 실무용 ⭐ | |
b - A @ x_lstsq | 잔차 벡터 계산 | |
np.sum(residual ** 2) | 오차 제곱합 — 이 값이 최소인 것이 최소제곱해 | |
A.T @ residual | 직교 조건 검증 — 0이면 유도가 맞았다는 증거 ✅ |
🧩 코드 설명 — Python 기초
•
np.column_stack([x, y])— 여러 1차원 배열을 열 방향으로 나란히 붙여 2차원 행렬을 만듭니다.np.ones(5)는[1,1,1,1,1]이므로, 결과는 각 행이(키, 1)인 5×2 행렬이 됩니다.\
\
•@— 행렬 곱셈 전용 연산자입니다.A @ B는np.matmul(A, B)와 같습니다.A * B(별표)는 성분별 곱이라 전혀 다른 연산이니 절대 혼동하면 안 됩니다! ⚠️\
\
•a_hat, b_hat = x_lstsq— 튜플 언패킹. 원소가 2개인 배열을 두 변수에 한 번에 나눠 담습니다.\
\
•f"...{a_hat:.2f}..."— f-문자열. 중괄호 안 변수를 문자열에 끼워 넣고,:.2f는 "소수점 둘째 자리까지 표시"라는 서식 지정입니다.\
\
•[0]—lstsq는 (해, 잔차합, 랭크, 특잇값) 4개짜리 튜플을 반환합니다. 우리가 원하는 해는 첫 번째이므로[0]으로 꺼냅니다.
🟩 실행 결과
A shape: (5, 2) | b shape: (5,)
공식 방식 : [   1.16 -133.  ]
lstsq     : [   1.16 -133.  ]
찾은 직선: 몸무게 = 1.16 × 키 + (-133.00)
잔차      : [-0.4  0.8  0.  -0.8  0.4]
잔차 합   : 0.0 ← 0이어야 정상
오차제곱합: 1.6
Aᵀe (≈0?) : [ 0.  0.]
키 168cm 예측 몸무게: 61.9kg
✅ 두 방법의 답이 소수점까지 정확히 일치하고, 잔차의 합과 가 모두 0으로 나왔습니다. 유도 과정이 코드로도 그대로 성립한다는 증거입니다. 🎯
📌 결과 해석: 기울기 은 "키가 1cm 커질 때 몸무게가 평균 1.16kg 늘어난다"는 뜻입니다. 반면 절편 은 "키 0cm인 사람의 몸무게가 −133kg"이라는 황당한 의미가 되는데, 이는 데이터 범위(165~185cm) 밖에서는 직선을 신뢰하면 안 된다는 것을 보여줍니다. 절편은 대개 직선의 높이를 맞추는 조절 장치로만 해석합니다. ⚠️
🔀 프레임워크 관점 — 같은 공식, 다른 이름
| 개념 | NumPy | SciPy | scikit-learn | PyTorch | TensorFlow |
|---|---|---|---|---|---|
| 최소제곱 | np.linalg.lstsq | scipy.linalg.lstsq | LinearRegression() | torch.linalg.lstsq | tf.linalg.lstsq |
| 다항식 적합 | np.polyfit | curve_fit | PolynomialFeatures | 직접 구현 | 직접 구현 |
| MSE 손실 | 직접 구현 | 직접 구현 | mean_squared_error | nn.MSELoss() | keras.losses.MSE |
| GPU 지원 | ❌ | ❌ | ❌ | ✅ | ✅ |
00-03-R4 🔴🚀 최소제곱법 = 선형회귀 = 머신러닝의 첫 모델
여기까지 오면 놀라운 사실을 하나 알게 됩니다. 우리가 방금 "연립방정식의 근사해"를 구한다고 생각하며 계산한 것이, 사실은 머신러닝의 가장 기본 모델인 선형회귀를 처음부터 끝까지 구현한 것입니다. 🎉
같은 대상을 통계학·선형대수학·머신러닝이 각자 다른 이름으로 부르고 있을 뿐입니다.
📋 같은 것을 부르는 세 가지 이름
| 선형대수 용어 | 통계학 용어 | 머신러닝 용어 | 기호 |
|---|---|---|---|
| 설계행렬 | 독립변수 / 설명변수 | 입력, 특징(feature) | 또는 |
| 미지수 벡터 | 회귀계수 | 가중치(weight) | 또는 |
| 1로 채운 열 | 절편(intercept) | 편향(bias) | |
| 오차 제곱합 | 잔차 제곱합(RSS) | MSE 손실함수 | 또는 |
| 최소화 | 최소제곱 추정 | 학습(training) | — |
👉 신경망의 라는 식이 낯익지 않으신가요? 그것이 바로 우리가 방금 푼 입니다. 선형회귀는 활성화 함수가 없는 1층짜리 신경망과 정확히 같습니다! 🤖
🧸 더 쉽게 이해하기 — 🗺️ 지름길 vs 등산로
최소제곱해를 찾는 길은 두 가지입니다.\
🚁 정규방정식(오늘 배운 것): 헬기를 타고 골짜기 바닥에 한 번에 착륙. 빠르지만 데이터 특징이 많아지면(이 커지면) 계산이 급격히 무거워집니다.\
🥾 경사하강법(00-04): 안개 속에서 발밑 기울기만 보고 한 걸음씩 내려가기. 느려 보이지만 데이터가 수백만 개, 특징이 수천 개여도 감당할 수 있습니다.\
그래서 딥러닝은 헬기(공식)를 버리고 등산화(경사하강법)를 신습니다. 👟
🗺️ 시각화 ④: 최소제곱법에서 딥러닝까지의 흐름
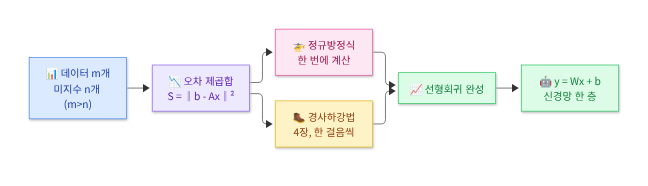
📌 실무에서는 언제 무엇을 쓰나? 특징이 수십~수백 개 정도로 적고 데이터도 메모리에 올라간다면 정규방정식(또는 lstsq)이 훨씬 빠르고 정확합니다. 반대로 특징이 수천 개 이상이거나 데이터가 계속 흘러 들어온다면 경사하강법이 유일한 선택지입니다. ⚖️
🛠️ 직접 해보는 실습
실습 4 🟢 — 미니 예제 를 코드로 풀어 손계산 결과 과 일치하는지 확인하세요.
실습 5 🔵 — 키·몸무게 데이터에서
np.ones(...)열을 일부러 빼고 돌려보세요. 기울기가 어떻게 달라지고, 왜 그런 일이 벌어지는지 설명해보세요. (힌트: 원점을 강제로 지나게 됨)실습 6 🔵 — 마지막 데이터를
(185, 82)에서(185, 130)으로 바꿔(이상치 투입!) 다시 돌려보세요. 기울기가 얼마나 흔들리는지 확인하고, "제곱합이 이상치에 민감하다"는 말의 의미를 체감해보세요.실습 7 🔴 — 를 −1부터 3까지 0.1 간격으로 바꿔가며 오차 제곱합 를 계산해 리스트로 출력하고, 가장 작은 를 주는 가 정말 1.16 부근인지 확인하세요. (그릇의 바닥 찾기를 손으로 재현하는 실험 🥣)
🐛 디버깅 포인트 & 실수하기 쉬운 부분
❌ 절편 열을 빠뜨림 — 왜 틀리나? 직선이 원점 을 강제로 지나게 되어 기울기가 크게 왜곡됩니다. 원인: 만 모델링한 셈. 수정:
np.column_stack([x, np.ones(len(x))])로 1 열을 반드시 추가하세요.❌
[0]인덱싱 누락 —lstsq는 튜플 4개를 반환합니다.[0]을 빼면 배열이 아닌 튜플이 들어와 이후 계산이 전부 깨집니다.❌
rcond생략 — NumPy 버전에 따라FutureWarning이 뜹니다.rcond=None을 명시하세요.❌ 정수 dtype — 정수 배열로 계산하면 나눗셈에서 소수점이 잘려 엉뚱한 값이 나옵니다.
dtype=float을 명시하세요.❌
LinAlgError: Singular matrix— 의 역행렬이 없는 경우입니다. 원인: 두 특징 열이 서로 완전히 비례하거나(다중공선성), 데이터 개수가 미지수보다 적을 때. 수정:np.linalg.matrix_rank(A)로 랭크를 확인하고,inv대신lstsq를 쓰세요(lstsq는 이 경우에도 답을 내줍니다).❌
@와*혼동 —A.T * A는 성분별 곱이라 shape 오류가 나거나 조용히 틀린 값을 만듭니다. 행렬 곱은 반드시@입니다.✅ 검산 습관 — 계산 후
A.T @ (b - A @ x)가 0에 가까운지 확인하세요. 0이 아니면 어딘가 잘못된 것입니다. 🔍
📝 연습문제 — 최소제곱법·선형회귀
Q5. (개념) 🔴 "과결정계"란 무엇이며, 이때 왜 완벽한 해가 존재하지 않는지 설명하세요.
💡 해설 보기
식의 개수 이 미지수의 개수 보다 많은() 시스템입니다. 미지수 개로 조절할 수 있는 자유도보다 만족시켜야 할 조건이 더 많기 때문에, 모든 조건을 동시에 정확히 맞출 수 없습니다. 예: 직선(자유도 2)으로 일직선 위에 있지 않은 점 5개를 모두 지나갈 수는 없습니다.
Q6. (개념) 🔴 오차를 절댓값이 아니라 제곱해서 더하는 이유 세 가지를 쓰세요.
💡 해설 보기
① 양수·음수 오차의 상쇄를 막는다. ② 큰 오차에 더 큰 벌점을 준다(). ③ 어디서나 미분 가능해서 "미분값=0"으로 공식 하나를 유도할 수 있다(절댓값은 0에서 뾰족해 미분 불가).
Q7. (계산) 🔴 데이터 에 대해 와 를 손으로 구하고, 최소제곱해를 구하세요.
💡 해설 보기
, \
, \
, \
\
→ . 이 경우 세 점이 정확히 직선 위에 있어 오차 제곱합이 0입니다(잔차 전부 0). ✅
Q8. (구현) 🔴 np.linalg.lstsq를 쓰지 않고, inv·@·.T만으로 최소제곱해를 구하는 함수 fit_least_squares(x, y)를 작성하세요.
💡 해설 보기
def fit_least_squares(x, y):\
A = np.column_stack([x, np.ones(len(x))])\
return np.linalg.inv(A.T @ A) @ A.T @ y\
반환값은[기울기, 절편]입니다. 단, 실무에서는 수치 안정성 때문에lstsq나np.linalg.solve(A.T@A, A.T@y)가 더 권장됩니다.
Q9. (사고 확장) 🔴🚀 데이터가 직선이 아니라 곡선 형태라면, 최소제곱법을 그대로 쓸 수 있을까요?
💡 해설 보기
쓸 수 있습니다! 설계행렬 의 열을 로 바꾸면 라는 포물선을 같은 공식으로 찾을 수 있습니다. 핵심은 "미지수 에 대해 식이 1차(선형)이기만 하면 된다"는 것입니다 — 에 대해 곡선이어도 상관없습니다. 그래서 이 방법의 이름이 "직선 회귀"가 아니라 선형 회귀인 것입니다. 📈
Q10. (사고 확장) 🔴 최소제곱해에서 잔차의 합이 항상 0이 되는 이유를 유도 과정과 연결해 설명하세요.
💡 해설 보기
직교 조건 에서, 의 두 번째 열이 전부 1이므로 그 줄을 풀어 쓰면 , 즉 이 됩니다. 단, 절편 항(1로 채운 열)이 있을 때만 성립합니다. 절편 없이 원점을 지나게 강제하면 잔차 합은 0이 아닐 수 있습니다. 📌
🎯 이 절에서 배운 내용
📊 과결정계 — 식이 미지수보다 많으면 완벽한 해가 없다\
📉 오차 제곱합 — 부호 상쇄 방지·큰 오차 처벌·미분 가능\
📐 정규방정식 — 잔차가 수직일 때 최단거리 → \
💻 구현 — 공식은 이해용, lstsq는 실무용\
🤖 연결 — 최소제곱법 = 선형회귀 = 1층 신경망
📌 핵심 문장 3가지
1) 완벽한 해가 없으면 오차가 가장 작은 해를 찾는다.\
2) 잔차가 수직(직교)일 때가 최단거리이고, 그 조건에서 가 나온다.\
3) 이것이 곧 선형회귀이며, 신경망 의 원형이다.
🧠 개념 체크리스트 (성취 기준)
☐과결정계가 무엇이고 왜 완벽한 해가 없는지 설명할 수 있다 🔴
☐오차를 제곱해서 더하는 이유 세 가지를 말할 수 있다 🔴
☐오차 제곱합이 잔차 벡터의 노름 제곱과 같음을 설명할 수 있다 🔴
☐정규방정식을 직교 조건에서 단계별로 유도할 수 있다 🔴⭐
☐를 만드는 이유(정사각행렬화)를 설명할 수 있다 🔴
☐2×2 미니 예제를 손으로 끝까지 계산할 수 있다 🔵
☐설계행렬에 1로 채운 열이 왜 필요한지 설명할 수 있다 🔵
☐최소제곱법·선형회귀·신경망 의 관계를 말할 수 있다 🚀
🚫 실수 방지 체크리스트
☐설계행렬에 절편용 1 열을 추가했는가
☐dtype=float으로 만들었는가
☐행렬 곱에 *가 아닌 @를 썼는가
☐lstsq 반환값에 [0]을 붙였는가 / rcond=None을 지정했는가
☐inv(A.T@A) 대신 lstsq/solve를 우선 고려했는가
☐계산 후 A.T @ residual ≈ 0으로 검산했는가
☐수식 기호()와 코드 변수명이 일치하는가
🚀 추가 학습
✏️ 설계행렬 열을 로 바꿔 2차 곡선 회귀 구현해보기\
🔬 np.polyfit(x, y, 1)과 결과가 같은지 비교해보기\
📊 scikit-learn LinearRegression()의 .coef_·.intercept_와 대조해보기\
⚡ PyTorch torch.linalg.lstsq로 GPU에서 실행해보기\
🎯 미리 보기: 00-04장에서 같은 문제를 경사하강법으로 풀고, 정규방정식과 답이 일치하는지 확인해보기
💻 GitHub 실습 — 코드로 직접 확인하기
📂 이 장의 코드 폴더: book/00-math-overview-for-beginners/00-03-linear-systems-guess-x
책에 실린 코드를 장(절)별로 모아 둔 폴더입니다. 아래 파일을 열어 보거나, Colab에서 바로 실행해 보세요.
| 파일 | 용도 | 링크 |
|---|---|---|
00_03_linear_systems_guess_x.py | 책의 코드 블록 1개를 순서대로 모은 실행 스크립트 (# %% 셀 구분) | 코드 보기 |
00_03_linear_systems_guess_x.ipynb | 같은 코드를 블록당 셀 1개로 담은 주피터 노트북 | 보기 · Colab |
README.md | 코드 블록 목록 · 실행 방법 · 검증 결과 | 보기 |
🎬 medium-series/05-least-squares/ | Medium 시리즈 예제 — 같은 주제를 블로그용으로 다듬은 실습 | 폴더 · Colab |
🧪 저장소 검증 상태: ✅ 실행 OK
🔑 핵심 코드 1 — 정규방정식 공식과 lstsq 두 방법 비교
📄 00_03_linear_systems_guess_x.py L14–L37 · Block 1 (00-03-R3 🔴 구현 원리와 코드 — 공식·lstsq 두 방법 비교)
# ── 데이터: 5명의 키(cm)와 몸무게(kg) ──────────────────────
height = np.array([165, 170, 175, 180, 185], dtype=float)
weight = np.array([58,  65,  70,  75,  82],  dtype=float)

# ── 설계행렬 A 만들기 ─────────────────────────────────────
# 찾고 싶은 직선: weight = a×height + b×1
# → 각 행이 (height, 1)이 되도록 1로 채운 열을 붙입니다 (절편 항!)
A = np.column_stack([height, np.ones(len(height))])
b = weight

print("A shape:", A.shape, "| b shape:", b.shape)   # (5,2) (5,)

# ── 방법 1) 정규방정식 공식을 그대로 구현 (이해용) ──────────
# x̂ = (AᵀA)⁻¹ Aᵀb  ← 방금 유도한 공식 그 자체
x_formula = np.linalg.inv(A.T @ A) @ A.T @ b

# ── 방법 2) lstsq 사용 (실무 권장) ────────────────────────
# rcond=None: 버전 경고 방지 / [0]: 반환 튜플의 첫 원소가 해
x_lstsq = np.linalg.lstsq(A, b, rcond=None)[0]

a_hat, b_hat = x_lstsq          # 튜플 언패킹: 기울기, 절편
print("공식 방식 :", np.round(x_formula, 4))
print("lstsq     :", np.round(x_lstsq,   4))
print(f"찾은 직선: 몸무게 = {a_hat:.2f} × 키 + ({b_hat:.2f})")
▶ 실행 결과 — 위 코드를 실행한 출력 (직접 실행: Windows · Python 3.11.2 · numpy 2.4.6, 앞 블록부터 순서대로 실행)
A shape: (5, 2) | b shape: (5,)
공식 방식 : [   1.16 -133.  ]
lstsq     : [   1.16 -133.  ]
찾은 직선: 몸무게 = 1.16 × 키 + (-133.00)
🔑 핵심 코드 2 — 잔차·오차제곱합과 직교 조건 Aᵀe = 0 검증
📄 00_03_linear_systems_guess_x.py L39–L49 · Block 1 (00-03-R3 🔴 구현 원리와 코드 — 공식·lstsq 두 방법 비교)
# ── 잔차와 오차 제곱합 확인 ───────────────────────────────
pred     = A @ x_lstsq          # 예측값 ŷ = Ax̂
residual = b - pred             # 잔차 e = b - Ax̂
sse      = np.sum(residual ** 2)   # 오차 제곱합 S = Σeᵢ²

print("잔차      :", np.round(residual, 3))
print("잔차 합   :", round(residual.sum(), 10), "← 0이어야 정상")
print("오차제곱합:", round(sse, 4))

# ── 직교 조건 검증: Aᵀe = 0 이어야 함 (유도 ①단계) ─────────
print("Aᵀe (≈0?) :", np.round(A.T @ residual, 10))
▶ 실행 결과 — 위 코드를 실행한 출력 (직접 실행: Windows · Python 3.11.2 · numpy 2.4.6, 앞 블록부터 순서대로 실행)
잔차      : [-0.4  0.8  0.  -0.8  0.4]
잔차 합   : 0.0 ← 0이어야 정상
오차제곱합: 1.6
Aᵀe (≈0?) : [1.e-10 0.e+00]
☁️ Colab에서 바로 실행
👉 Open in Colab — 00_03_linear_systems_guess_x.ipynb · 설치 없이 브라우저에서 셀을 위에서부터 순서대로 실행하세요.
🖥️ 내 컴퓨터에서 실행하기
git clone https://github.com/otoloism/Zero_to_ML_Master.git
cd Zero_to_ML_Master
python -m venv .venv
source .venv/bin/activate          # Windows: .venv\Scripts\activate
pip install -r book/requirements.txt   # 책 전체용 (PyTorch 등 포함, 용량 큼)
# 이 장만 실행한다면 이것만으로 충분합니다: pip install numpy
cd book/00-math-overview-for-beginners/00-03-linear-systems-guess-x
python 00_03_linear_systems_guess_x.py
⭐ GitHub Star / Fork
⭐ 코드가 도움이 되셨다면 GitHub 저장소에 Star를 눌러 주세요. 새 장의 코드가 올라올 때 가장 먼저 알 수 있습니다.
🍴 직접 고쳐 보며 실험하고 싶다면 Fork 해서 내 저장소에서 마음껏 바꿔 보세요. 오류 제보·개선 제안은 Issues로 환영합니다!
🔮 다음 글 예고
다음 글은 00-04 미분·경사하강법 (1부) — 미분·연쇄법칙·그래디언트 🌫️ 입니다. 자동차 속도계로 "지금 이 순간의 변화 속도"인 미분을 이해하고, 수치미분(전진차분 vs 중심차분), 연쇄법칙, 여러 변수를 한꺼번에 다루는 그래디언트까지 코드로 검산합니다. 최소제곱 문제를 공식 없이 "조금씩 고쳐 가며" 푸는 경사하강법의 준비 단계예요.
⬅️ 이전 글: #03 행렬 쉽게 이해하기 — shape·행렬 곱셈·역행렬이 필요한 이유 (파이썬 NumPy) \
➡️ 다음 글: #05 미분 쉽게 이해하기 — 수치미분·연쇄법칙·그래디언트 (딥러닝 수학, 1부)
📚 더 깊이 공부하고 싶다면
이 시리즈는 수학을 놓았던 비전공자가 AI를 직접 구현하기까지의 공부 기록을 그대로 옮긴 연재입니다. 원문 책, 코드, 개념 사전을 함께 보면 훨씬 빨리 늡니다. 🚀
| 바로가기 | 이런 분께 | |
|---|---|---|
| 📘 책 (위키독스, 무료) | Zero to 머신러닝 딥러닝 Master | 5권 · 20개 장 · 163개 절 전체를 순서대로 읽고 싶은 분 |
| 📄 이 글의 원문 | 00-03 연립방정식 — "x가 뭔지 맞춰보세요" 게임 | 연습문제·해설까지 전부 보고 싶은 분 |
| 💻 실습 코드 (GitHub) | otoloism/Zero_to_ML_Master | .py·.ipynb를 Colab에서 바로 돌려보고 싶은 분 |
| 🏠 머신러닝 백과사전 | mldict.net | 본문 속 핵심 개념을 카드로 다시 확인하고 싶은 분 |
| ✍️ 기술 블로그 | wikidocs.net/blog/@mldict | 새 글 알림을 가장 먼저 받고 싶은 분 |
⭐ 도움이 되셨다면 velog 팔로우와 GitHub Star를 눌러 주세요. 다음 글을 쓰는 가장 큰 힘이 됩니다. 궁금한 점은 댓글로 편하게 남겨 주세요! 🙌