[Zero to ML Master #16] 내적·외적·유사도 행렬 — 코사인 유사도 추천부터 어텐션 QKᵀ까지 (파이썬 NumPy)
Zero to 머신러닝 딥러닝 Master
내적, 벡터 외적, 외적(outer)… 이름은 비슷한데 결과는 완전히 다릅니다. 🤯 하나는 숫자, 하나는 벡터, 하나는 행렬을 돌려주거든요. 이름 대신 "무엇이 나오는가"로 구분하면 다시는 헷갈리지 않습니다.
이번 글에서는 내적이 각도를 말한다는 사실, 내적이 길이에 속는 함정과 코사인 유사도, 모든 쌍의 내적을 한 번에 구하는 유사도 행렬 , 그리고 ChatGPT 어텐션의 첫 단계 까지 파이썬 NumPy로 직접 계산합니다.
📘 이 글은 위키독스 도서 Zero to 머신러닝 딥러닝 Master 의 01-05 행렬내적·외적·유사도 행렬 을 블로그용으로 다듬은 글입니다.
💻 실습 코드: GitHub · 🏠 mldict.net · ✍️ 기술 블로그
💻 이 글의 코드:
01-05-dot-outer-similarity-matrix· Open in Colab — 핵심 코드와 실제 실행 결과는 글 아래 💻 GitHub 실습 섹션에 있습니다.
⬅️ 이전 글: #15 행렬의 두 얼굴 — 숫자 표이자 공간을 움직이는 함수, AB ≠ BA인 이유까지 (파이썬 NumPy) \
➡️ 다음 글: #17 텐서(Tensor)란? 스칼라·벡터·행렬부터 이미지 배치까지 — rank·shape·reshape 쉽게 이해하기 (NumPy·PyTorch)
TL;DR — 3줄 요약
- 내적은 숫자 하나(방향 일치도), 벡터 외적(cross)은 수직인 벡터, 외적(outer)은 행렬이 나옵니다. 세 곱은 이름이 아니라 결과의 모양으로 구분하세요.
- 내적은 길이에 휘둘리므로, 방향만 비교하려면 길이로 나눈 코사인 유사도를 씁니다. 행을 미리 정규화하면 한 줄이 코사인 유사도 행렬이 됩니다.
- 는 모든 쌍의 내적표이고, 어텐션의 + softmax도 정확히 같은 연산입니다. 단, 칸 수가 으로 늘어 긴 문맥일수록 비싸집니다.
🔗 지난 글 복습: #15 행렬의 두 얼굴에서 행렬 곱이 행과 열의 내적이라는 것과 전치 를 배웠습니다. 이번 글의 유사도 행렬 는 바로 그 두 가지를 합친 계산이에요.
📋 선행지식 — 🔗 01-03(벡터의 내적과 코사인 유사도), 🔗 01-04(행렬 곱과 전치 ). 특히 01-04의 "행렬 곱 = 행과 열의 내적"을 기억하고 있으면 5단계가 저절로 풀립니다. 🟢 초급 → 🔵 중급 · ⭐ 필수
✏️ 꼭 알아야 할 TIP
이름은 비슷하지만, "무엇이 나오는가"로 구분하면 절대 안 헷갈립니다\
🔹 내적 — 벡터 둘을 넣으면 숫자 하나가 나옵니다 (관계의 요약)\
🔹 벡터 외적(cross) — 3차원 벡터 둘을 넣으면 수직인 벡터가 나옵니다 (새 방향)\
🔹 외적(outer) — 벡터 둘을 넣으면 행렬이 나옵니다 (정보의 펼침)\
🔹 유사도 행렬 — 행렬 하나로 모든 쌍의 내적을 한 번에 얻습니다: \
\
실무에서 왜 중요한가? 유튜브·넷플릭스 추천, 검색, RAG, 그리고 ChatGPT의 어텐션까지 — 전부 "누가 누구와 얼마나 비슷한가"를 재는 이 한 연산 위에 서 있습니다.
🎯 학습 목표
☐ 내적을 성분식과 기하식 두 가지로 계산하고, 둘이 같음을 확인할 수 있다.\
☐ 내적이 길이에 휘둘리는 구체적 사례를 들고, 코사인 유사도로 바로잡을 수 있다.\
☐ 벡터 외적의 방향(수직)과 크기(평행사변형 넓이)를 설명할 수 있다.\
☐ 내적 · 벡터 외적 · 외적(outer)을 입력과 출력의 모양으로 구분할 수 있다.\
☐ 가 왜 모든 쌍의 내적인지 설명하고, 대각선·대칭성을 읽을 수 있다.\
☐ 코사인 유사도 행렬을 만들어 가장 비슷한 항목을 찾을 수 있다.\
☐ 어텐션의 가 유사도 행렬임을 이해하고, softmax까지 손으로 따라갈 수 있다.
⚙ 핵심 학습 내용
| 단계 | 학습 내용 | 여기까지 하면 이런 것이 됩니다 |
|---|---|---|
| 1 | 내적의 두 얼굴 | 계산이 각도를 뜻한다는 걸 알게 됩니다 |
| 2 | 크기의 함정과 코사인 | 언제 내적을, 언제 코사인을 쓸지 정합니다 |
| 3 | 벡터 외적 (cross) | 수직 방향과 넓이를 구합니다 |
| 4 | 외적 (outer) + 세 곱 총정리 | 이름 혼동이 완전히 사라집니다 |
| 5 | 유사도 행렬 | 모든 쌍을 한 번에 계산합니다 |
| 6 | 코사인 유사도 행렬과 추천 | 추천 시스템을 직접 굴려 봅니다 |
| 7 | 어텐션 🚀 | ChatGPT의 첫 단계를 손으로 계산합니다 |
| 8 | 실무 감각 — shape과 메모리 | 왜 긴 문맥이 비싼지 알게 됩니다 |
🗺 이 장의 전체 흐름 — 둘의 관계에서 모두의 관계로
| 단계 | 모습 | 연산 | 하는 일 |
|---|---|---|---|
| 1~2단계 | 🤝 | 내적 | 둘의 관계 → 숫자 1개 |
| 3~4단계 | 🧭 | 외적 | 벡터 또는 행렬로 |
| 5~6단계 | 🔢 | 유사도 행렬 | 모든 쌍 → 표 1장 |
| 7~8단계 | 🤖 | 어텐션 | 그 자체 |
왼쪽 끝의 "숫자 하나"가 오른쪽 끝의 "ChatGPT"까지 끊기지 않고 이어집니다.
1단계 🟢⭐ 내적의 두 얼굴 — 계산식과 각도식은 왜 같은가 (기계적 계산 격파)
① 핵심 정의
내적은 벡터 둘을 넣으면 숫자 하나가 나오는 연산입니다. 계산은 허무할 만큼 단순합니다 — 같은 자리끼리 곱해서 전부 더합니다.
여기서 대부분의 학습자가 멈춥니다. "그래서 24가 뭔데?"라는 질문에 답을 못 얻은 채로요. 이 단계의 목표는 오직 하나, 이 숫자가 각도를 말하고 있다는 것을 납득하는 것입니다.
🔍 더 쉽게 이해하기 — 함께 미는 수레
수레를 미는 힘의 방향과 수레가 실제로 가는 방향을 생각해 보세요. 같은 힘을 써도 어느 쪽으로 미느냐에 따라 도움이 되기도, 헛수고가 되기도, 방해가 되기도 합니다.
⇉ 나란히 밀기 → 힘이 온전히 전달 → 내적 최대
⇗ 직각으로 밀기 → 전혀 도움 안 됨 → 내적 0
⇄ 반대로 당기기 → 오히려 방해 → 내적 음수
즉 내적은 처음부터 끝까지 "방향이 얼마나 맞느냐"를 재는 도구였습니다. 곱하고 더하는 절차는 그 답을 구하는 수단일 뿐입니다.
📐 수학적 의미 — 같은 값을 부르는 두 이름
②를 소리 내어 읽으면 "a의 길이 × b의 길이 × 방향 일치도"입니다. 이 세 조각이 곱해져 하나의 숫자가 된다는 것이 내적의 전부입니다.
직접 확인해 봅시다. , \
① 성분식: \
② 기하식: , , → ✔\
사잇각은 — 거의 같은 방향입니다🔗 01-02의 공식 51(성분식)과 20(기하식)이 사실 같은 식의 앞뒷면이었던 것입니다.
💡 직관적 의미 — 부호만 봐도 절반은 안다
| 내적 | 사잇각 | 해석 | |
|---|---|---|---|
| 양수 | 0°~90° | 비슷한 방향 — 관련 있음 | |
| 0 | 정확히 90° | 직교 — 서로 무관(겹치는 정보 없음) | |
| 음수 | 90°~180° | 반대 방향 — 상반됨 |
"직교 = 무관"이라는 감각은 나중에 PCA·임베딩·정규직교 기저를 배울 때 그대로 쓰입니다. 벡터가 직교한다는 말은 서로 겹치는 정보가 하나도 없다는 뜻입니다.
🧩 구현 관점
Python — 두 얼굴이 같은 값인지 확인
import numpy as np

a = np.array([3, 4])
b = np.array([4, 3])

dot = np.dot(a, b)                      # 성분끼리 곱해서 더하기
cos = dot / (np.linalg.norm(a) * np.linalg.norm(b))
angle = np.degrees(np.arccos(cos))

print("내적 a·b      :", dot)
print("|a|, |b|      :", np.linalg.norm(a), np.linalg.norm(b))
print("cos(theta)    :", round(float(cos), 4))
print("사잇각(도)     :", round(float(angle), 2))
print("|a||b|cos(θ)  :", round(float(np.linalg.norm(a) * np.linalg.norm(b) * cos), 4), "← 내적과 같다")
🔗 GitHub에서 코드 보기 — 01_05_dot_outer_similarity_matrix.py L12–L25
실행 결과
내적 a·b      : 24
|a|, |b|      : 5.0 5.0
cos(theta)    : 0.96
사잇각(도)     : 16.26
|a||b|cos(θ)  : 24.0 ← 내적과 같다
🔎 코드 이해 — 한 줄씩
np.dot(a, b) — 성분식. a @ b로도 같은 결과를 얻습니다\
np.linalg.norm(a) — 벡터의 길이 \
np.arccos(cos) — 코사인 값을 각도(라디안)로 되돌립니다\
np.degrees(...) — 라디안을 우리가 쓰는 도(°)로 바꿉니다\
round(float(x), 4) — 보기 좋게 소수점 넷째 자리까지 자릅니다
📖 코드 설명
첫 줄의 24와 마지막 줄의 24.0이 같습니다. 곱하고 더해서 나온 24가, 실은 "길이 5짜리 두 벡터가 16.26도 차이로 놓여 있다"는 기하학적 사실을 압축한 숫자였던 것입니다. 이제 내적을 볼 때마다 각도를 떠올릴 수 있게 되었습니다.
2단계 🟢⭐ 크기의 함정 — 내적이 거짓말을 할 때 (크기의 혼란 격파)
내적에는 치명적인 약점이 하나 있습니다. 기하식 를 다시 보세요. 방향()뿐 아니라 길이 두 개가 함께 곱해집니다. 그래서 방향이 엉뚱해도 길기만 하면 값이 커집니다.
😱 실제로 속아 봅시다 — 영화 추천 실패 사례
| 영화 | 액션 | 로맨스 | 한 줄 설명 |
|---|---|---|---|
| A (기준) | 5 | 1 | 내가 좋아한 액션 영화 |
| B | 4 | 2 | 비슷한 액션 영화 ← 이게 정답 |
| C | 0 | 50 | 액션이 0인 초대형 로맨스 |
내적으로 재면 A·B = 22, A·C = 50\
→ "A를 좋아한 사람에게 C를 추천하세요!" 😱 액션이 0점인 영화를 말입니다.
C가 이긴 이유는 단 하나, 숫자가 크기 때문입니다. 방향은 정반대에 가까운데도요. 이것이 "내적은 크기에 휘둘린다"는 말의 실체입니다.
🔍 더 쉽게 이해하기 — 목소리 큰 사람 비유
회의실에서 목소리가 큰 사람의 의견이 더 옳게 들리는 착시와 같습니다. 내용(방향)이 아니라 음량(크기)이 판단을 흐리는 것이죠.
해결책도 똑같습니다. 모두의 음량을 똑같이 맞춘 뒤 내용만 비교하면 됩니다. 벡터에서는 길이를 전부 1로 맞추는 것이 그 작업이고, 이것을 정규화라고 부릅니다.
📐 수학적 의미 — 길이를 나눠 없앤다
가운데 식에서 길이 두 개가 위아래로 약분되어 사라지는 것을 눈으로 확인하세요. 남는 것은 순수한 방향 정보 뿐이고, 값은 항상 −1 이상 1 이하입니다.
다시 계산해 봅시다.\
A와 B: ← 거의 같은 방향\
A와 C: ← 거의 무관\
→ 정답인 B가 제자리를 찾았습니다.
💡 직관적 의미 — 그럼 내적은 쓸모없나요?
전혀 아닙니다. 크기에 의미가 있을 때는 내적이 정답입니다.
| 이럴 때 | 선택 | 이유 |
|---|---|---|
| 문서 길이·평점 스케일이 제각각 | 코사인 | 길이가 착시를 만듦 |
| 신경망 내부 계산 (가중치×입력) | 내적 | 크기 자체가 신호의 세기 |
| 이미 모든 벡터를 정규화해 둠 | 둘 다 같음 | 길이가 1이면 내적 = 코사인 |
마지막 줄이 실무의 요령입니다. 벡터를 미리 정규화해 저장해 두면, 그 뒤로는 빠른 내적만 써도 코사인 유사도를 얻습니다. 벡터 검색 DB가 실제로 쓰는 방법입니다.
🧩 구현 관점 — 속는 장면과 바로잡는 장면
Python — 내적 vs 코사인 유사도
import numpy as np

영화A = np.array([5, 1])      # 액션 5, 로맨스 1
영화B = np.array([4, 2])      # 액션 4, 로맨스 2  ← A와 비슷한 취향
영화C = np.array([0, 50])     # 액션 0, 로맨스 50 ← 완전히 다른데 점수만 큼

def 코사인(u, v):
    return np.dot(u, v) / (np.linalg.norm(u) * np.linalg.norm(v))

print("내적   A·B =", np.dot(영화A, 영화B), " | A·C =", np.dot(영화A, 영화C))
print("→ 내적만 보면 C가 더 비슷해 보인다:", np.dot(영화A, 영화C) > np.dot(영화A, 영화B))
print()
print("코사인 A,B =", round(float(코사인(영화A, 영화B)), 4),
      "| A,C =", round(float(코사인(영화A, 영화C)), 4))
print("→ 코사인으로 보면 B가 훨씬 비슷하다:", 코사인(영화A, 영화B) > 코사인(영화A, 영화C))
🔗 GitHub에서 코드 보기 — 01_05_dot_outer_similarity_matrix.py L29–L43
실행 결과
내적   A·B = 22  | A·C = 50
→ 내적만 보면 C가 더 비슷해 보인다: True

코사인 A,B = 0.9648 | A,C = 0.1961
→ 코사인으로 보면 B가 훨씬 비슷하다: True
🔎 코드 이해 — 한 줄씩
def 코사인(u, v): — 파이썬은 한글 변수·함수 이름도 허용합니다(실무에선 영문 권장)\
np.dot(u, v) / (norm(u) * norm(v)) — 수식을 그대로 옮긴 한 줄\
A > B 형태의 비교 — 결과가 True/False로 나와 주장을 검증해 줍니다\
print() — 인자 없이 쓰면 빈 줄을 출력해 결과를 두 덩어리로 나눕니다
📖 코드 설명 — 두 개의 True를 보세요
위쪽
True는 "내적만 보면 C가 더 비슷해 보인다"는 잘못된 결론이고, 아래쪽True는 "코사인으로 보면 B가 비슷하다"는 옳은 결론입니다. 같은 데이터, 다른 자(尺). 무엇을 재는 도구인지 아는 것이 계산법을 아는 것보다 중요합니다.
3단계 🔵⭐ 벡터 외적(cross) — 숫자가 아니라 방향이 나온다 (차원 혼란 격파)
내적은 벡터 둘을 넣으면 숫자가 나왔습니다. 그런데 벡터 외적은 벡터 둘을 넣으면 또 다른 벡터가 나옵니다. 이 지점에서 많은 사람이 멈칫합니다 — "왜 결과의 종류가 달라지지?"
답은 간단합니다. 묻는 질문이 다르기 때문입니다.
🤝 내적이 묻는 것 — "너희 둘, 얼마나 같은 쪽을 보고 있니?" → 답은 정도(숫자)
🧭 외적이 묻는 것 — "너희 둘이 만든 평면은 어느 쪽을 향하니?" → 답은 방향(벡터)
"방향"을 물었으니 답도 방향이어야 합니다. 질문의 종류가 답의 종류를 결정합니다. 이 한 줄만 잡으면 차원 혼란은 사라집니다.
🔍 더 쉽게 이해하기 — 병뚜껑과 오른손
음료수 병뚜껑을 여는 방향으로 돌리면 뚜껑이 위로 올라오고, 잠그는 방향으로 돌리면 아래로 내려갑니다. 돌리는 것은 평면 위의 회전인데, 결과는 평면과 수직인 위아래 이동입니다.
벡터 외적이 정확히 이것입니다. 에서 쪽으로 돌리는 시늉을 하면, 그 회전이 밀어 올리는 방향이 입니다.
✋ 오른손 법칙 — 오른손 네 손가락을 에서 쪽으로 감아쥐면, 엄지가 가리키는 쪽이 입니다.\
🔄 그래서 순서를 바꾸면 방향이 정반대가 됩니다:🔗 01-04에서 배운 "행렬 곱은 순서를 못 바꾼다"에 이어, 외적도 순서에 민감합니다. 다만 여기서는 부호만 뒤집힌다는 점이 다릅니다.
📐 수학적 의미 — 방향과 크기를 따로 읽기
외적 결과는 방향과 크기 두 정보를 담습니다. 각각 따로 외우면 훨씬 쉽습니다.
방향 — 와 가 만든 평면에 수직. 즉 이고 \
크기 — = 두 벡터가 만드는 평행사변형의 넓이기억 요령 — 각 성분을 구할 때 자기 자리를 건너뛰고 나머지 둘을 X자로 곱해 뺍니다.\
1번 성분 → 2, 3번 자리만 사용 · 2번 성분 → 3, 1번 자리 · 3번 성분 → 1, 2번 자리⚠️ 내적과 정반대의 성질도 눈여겨보세요. 내적은 이라 나란할 때 최대지만, 외적은 이라 수직일 때 최대이고 나란하면 0입니다(넓이가 없는 납작한 평행사변형).
💡 직관적 의미 — 3차원 전용이라는 사실
벡터 외적은 3차원에서만 정의됩니다. 2차원 평면 위에서는 "평면에 수직인 방향"이 평면 밖에 있어서 표현할 곳이 없기 때문입니다.
그래서 딥러닝 본류에서는 벡터 외적을 거의 쓰지 않습니다. 대신 3D 그래픽스·게임 엔진·로보틱스·물리 시뮬레이션에서 면의 방향(법선 벡터)과 회전(토크·각운동량)을 다루는 핵심 도구입니다. 다음 4단계에서 볼 외적(outer)이 오히려 딥러닝의 단골입니다.
📊 시각화 1 — 두 벡터가 만든 평면과, 거기서 솟아오르는 외적
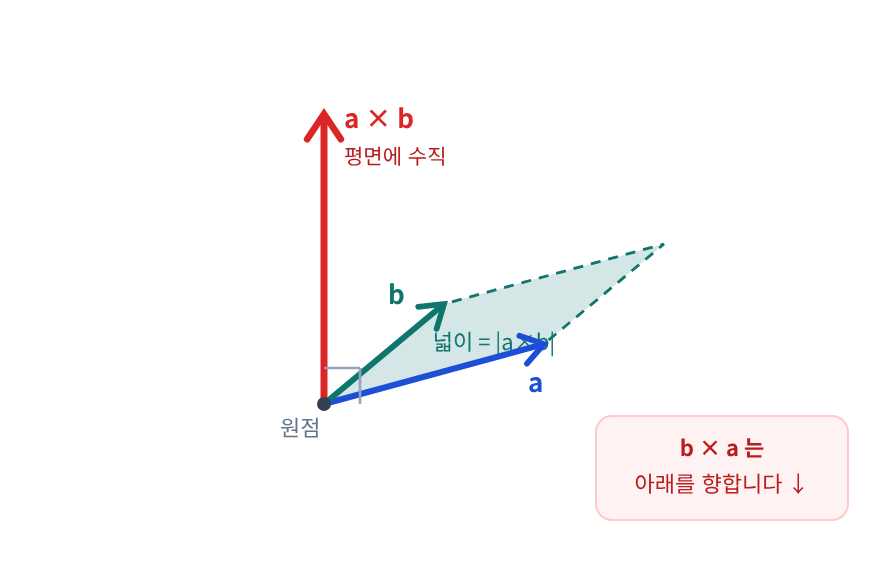
점선 평행사변형의 넓이가 곧 이고, 빨간 화살표의 방향이 그 평면에 수직입니다.
🧩 구현 관점
Python — 벡터 외적과 수직성 검증
import numpy as np

a = np.array([2, 3, 4])
b = np.array([5, 6, 7])

c = np.cross(a, b)            # 벡터 외적 — 결과도 벡터(3차원)
print("a × b =", c, " shape:", c.shape)
print("a와 수직인가? a·(a×b) =", np.dot(a, c))
print("b와 수직인가? b·(a×b) =", np.dot(b, c))
print("평행사변형 넓이 |a×b| =", round(float(np.linalg.norm(c)), 4))
print()
x, y = np.array([1, 0, 0]), np.array([0, 1, 0])
print("x축 × y축 =", np.cross(x, y), "← z축이 나온다")
print("y축 × x축 =", np.cross(y, x), "← 순서를 바꾸면 방향이 반대")
🔗 GitHub에서 코드 보기 — 01_05_dot_outer_similarity_matrix.py L47–L60
실행 결과
a × b = [-3  6 -3]  shape: (3,)
a와 수직인가? a·(a×b) = 0
b와 수직인가? b·(a×b) = 0
평행사변형 넓이 |a×b| = 7.3485

x축 × y축 = [0 0 1] ← z축이 나온다
y축 × x축 = [ 0  0 -1] ← 순서를 바꾸면 방향이 반대
🔎 코드 이해 — 한 줄씩
np.cross(a, b) — 벡터 외적. 3차원 벡터 두 개를 받아 3차원 벡터를 돌려줍니다\
np.dot(a, c) — 결과가 0이면 두 벡터가 수직이라는 뜻(1단계의 부호 판정표)\
np.linalg.norm(c) — 외적 벡터의 길이 = 평행사변형 넓이\
c.shape — (3,). 내적이 스칼라였던 것과 결정적으로 다른 점입니다
📖 코드 설명 — 0 두 개와 부호 반전
a·(a×b)와b·(a×b)가 둘 다 정확히 0입니다. 말로만 듣던 "평면에 수직"이 숫자로 증명된 것입니다. 그리고x축 × y축 = [0 0 1](z축),y축 × x축 = [0 0 -1]— 순서를 바꾸니 방향이 뒤집혔습니다. 오른손 법칙 그대로입니다.
4단계 🔵⭐ 외적(outer) — 같은 이름, 완전히 다른 연산 (정의 혼재 격파)
🚨 혼동의 진짜 원인 — 한국어 번역이 겹칩니다
영어로는 cross product와 outer product로 명확히 구분되는 서로 다른 두 연산이, 한국어로는 둘 다 "외적"으로 번역됩니다. 여러분이 헷갈린 것은 실력 문제가 아니라 용어 문제입니다.
해결법은 하나뿐입니다. "무엇이 나오는가"로 부르는 습관을 들이는 것입니다.
① 핵심 정의
외적(outer product)은 벡터 둘을 넣으면 행렬이 나오는 연산입니다. 규칙은 놀랍도록 단순합니다 — 모든 짝을 다 곱해서 표를 채웁니다. 내적처럼 더하는 단계가 없습니다.
🔍 더 쉽게 이해하기 — 구구단 표 만들기
구구단 표를 떠올려 보세요. 가로에 1~9, 세로에 1~9를 놓고 만나는 칸마다 곱셈 결과를 적습니다. 그것이 정확히 외적(outer)입니다.
🤝 내적: 곱한 뒤 전부 더해서 숫자 하나로 뭉칩니다 → 정보가 압축됨\
🧮 외적: 곱한 결과를 더하지 않고 그대로 펼쳐 놓습니다 → 정보가 확장됨같은 재료(곱셈)를 쓰지만, 마지막에 더하느냐 마느냐가 둘을 완전히 갈라놓습니다. 이 한 문장이 4단계의 핵심입니다.
📐 수학적 의미 — 손으로 표 채우기
shape을 보세요. 차원과 차원을 넣었더니 행렬이 나왔습니다. 🔗 01-04의 표기로 쓰면 — 가운데가 1인 행렬 곱입니다. 그래서 길이가 달라도 됩니다(내적은 반드시 같아야 했습니다).
특별한 성질: 이렇게 만든 행렬은 언제나 랭크 1입니다. 모든 행이 의 배수라서 독립적인 정보가 한 줄뿐이기 때문입니다. 겉보기엔 숫자 6개지만 실제 정보량은 벡터 두 개가 전부입니다.
📊 시각화 2 — 외적은 구구단 표를 채우는 일
| 1×4 = 4 | 1×5 = 5 | |
| 2×4 = 8 | 2×5 = 10 | |
| 3×4 = 12 | 3×5 = 15 |
가로줄의 값과 세로줄의 값을 곱해서 칸을 채우는 구구단 표입니다. 더하는 단계가 없어서 숫자가 뭉치지 않고 그대로 펼쳐집니다.
💡 직관적 의미 — 딥러닝에서 외적이 나타나는 순간
외적은 이론 속 장식이 아닙니다. 역전파의 심장부에서 매 스텝 등장합니다.
가중치 의 기울기는 입력 벡터와 오차 벡터의 외적입니다:\
\
입력이 차원, 출력이 차원이면 기울기는 — 가중치와 똑같은 모양이 나옵니다.
"왜 기울기의 shape이 가중치와 같아야 하는가?"의 답이 바로 이것입니다. 그리고 LoRA 같은 최신 미세조정 기법도 "큰 가중치 행렬의 변화량을 랭크 1짜리 외적 몇 개로 근사한다"는 아이디어 위에 서 있습니다.
🗂 세 가지 곱 총정리 — 이 표 하나면 다시는 안 헷갈립니다
| 구분 | 기호 | 넣으면 | 나오면 | 한 줄 요약 | NumPy |
|---|---|---|---|---|---|
| 내적 dot | 벡터 2개 (길이 같아야) | 숫자 1개 | 곱해서 더함 → 관계를 압축 | np.dot | |
| 벡터 외적 cross | 3차원 벡터 2개 | 벡터 (3차원) | 평면에 수직인 방향 → 3D 그래픽스 | np.cross | |
| 외적 outer | 벡터 2개 (길이 달라도 됨) | 행렬 | 곱하고 안 더함 → 정보를 펼침 | np.outer |
👉 기억법: 헷갈릴 때는 이름 대신 "결과가 숫자냐, 벡터냐, 행렬이냐"를 물으세요. 코드에서는 .shape을 찍으면 1초 만에 확인됩니다.
🧩 구현 관점
Python — 외적(outer)과 내적의 결과 비교
import numpy as np

a = np.array([1, 2, 3])       # 길이 3
b = np.array([4, 5])          # 길이 2

outer = np.outer(a, b)        # 외적(outer) — 결과는 행렬!
print("a ⊗ b =\n", outer)
print("shape:", outer.shape, "→ (3, 2) 행렬")
print("랭크 :", np.linalg.matrix_rank(outer), "← 항상 1 (모든 행이 b의 배수)")
print()
print("내적 a·a =", np.dot(a, a), "→ 스칼라 (숫자 하나)")
print("외적 shape =", np.outer(a, a).shape, "→ 행렬")
🔗 GitHub에서 코드 보기 — 01_05_dot_outer_similarity_matrix.py L64–L75
실행 결과
a ⊗ b =
 [[ 4  5]
 [ 8 10]
 [12 15]]
shape: (3, 2) → (3, 2) 행렬
랭크 : 1 ← 항상 1 (모든 행이 b의 배수)

내적 a·a = 14 → 스칼라 (숫자 하나)
외적 shape = (3, 3) → 행렬
🔎 코드 이해 — 한 줄씩
np.outer(a, b) — 외적(outer). 길이 3과 길이 2를 넣어 행렬을 얻습니다\
np.linalg.matrix_rank(...) — 행렬의 독립적인 줄 수. 외적 결과는 언제나 1입니다\
np.dot(a, a) vs np.outer(a, a).shape — 같은 벡터를 넣어도 결과의 종류가 전혀 다릅니다
📖 코드 설명 — 마지막 두 줄이 결론입니다
똑같은 벡터
a를 넣었는데 내적은 14(숫자 하나), 외적은 (3, 3)(행렬)이 나옵니다. 그리고 랭크가 1이라는 것은 "칸은 6개지만 진짜 정보는 한 줄뿐"이라는 뜻입니다. 이 성질이 나중에 모델 압축·LoRA의 출발점이 됩니다.
5단계 🔵⭐ 유사도 행렬 — 모든 쌍을 한 번에 (관계 압축 격파)
① 핵심 정의 — 왜 필요한가
지금까지는 둘씩 비교했습니다. 그런데 영화가 1,000편이면 비교할 쌍이 몇 개일까요? 약 50만 쌍입니다. 하나씩 계산해서 적어 두는 것은 현실적이지 않습니다.
놀랍게도 행렬 곱 한 번이면 끝납니다. 각 항목을 벡터로 만들어 행으로 쌓은 행렬 를 자기 자신의 전치와 곱하는 것입니다.
🔍 더 쉽게 이해하기 — 학급 친밀도 조사표
반 아이들이 서로 얼마나 친한지를 표로 만든다고 해봅시다. 가로줄에도 아이들 이름, 세로줄에도 같은 이름을 적고, 만나는 칸에 친밀도 점수를 씁니다.
📐 대각선 — "나와 나"의 칸입니다. 당연히 가장 높습니다\
🪞 대칭 — "철수·영희" 칸과 "영희·철수" 칸은 같은 값입니다\
🔍 한 줄 읽기 — 철수의 가로줄만 보면 철수와 모두의 관계가 한눈에 들어옵니다유사도 행렬을 읽는 요령이 정확히 이 셋입니다. 표 전체를 한꺼번에 이해하려 하지 말고, 대각선 → 대칭 → 한 줄 순서로 보세요. 그러면 1000×1000짜리도 겁나지 않습니다.
📐 수학적 의미 — 왜 하필 전치를 곱하는가
🔗 01-04에서 배운 사실을 그대로 씁니다. 행렬 곱의 칸 = 왼쪽 행렬의 행 · 오른쪽 행렬의 열의 내적.
1. 의 행은 → 번째 항목의 벡터입니다\
2. 의 열은 → 원래 의 행, 즉 번째 항목의 벡터입니다\
3. 따라서 칸 — 정확히 우리가 원하던 그 내적전치를 곱하는 이유는 "행끼리 비교"를 하려면 오른쪽 행렬에서는 그것이 열로 서 있어야 하기 때문입니다. 전치는 그 방향을 돌려 놓는 작업일 뿐입니다.
shape 확인: 가 면 는 이므로 는 — 항목 수 × 항목 수입니다. 특징이 몇 개든(2개든 300개든) 결과 크기는 항목 수만 따릅니다.
🔤 변수 정의
— 항목을 행으로 쌓은 데이터 행렬. (항목 수 × 특징 수)\
— 의 번째 행. 번째 항목의 특징 벡터\
— 전치행렬. 행과 열이 뒤바뀝니다\
— 유사도 행렬. (항목 수 × 항목 수), 대각선 기준 대칭\
— 번째와 번째 항목의 내적
📶 진행 과정 — 영화 3편으로 직접
- 각 영화를 (액션, 로맨스) 벡터로: A, B, C
- 행으로 쌓아
- 전치를 만들면
- 곱합니다:
- 완성:
검산해 봅시다. ✔ ✔ (자기 자신과의 내적 = 길이의 제곱)
📊 시각화 3 — 내적 유사도 행렬 (색이 진할수록 큰 값)
| 영화A | 영화B | 영화C | |
|---|---|---|---|
| 영화A | 26 | 22 | 5 |
| 영화B | 22 | 20 | 10 |
| 영화C | 5 | 10 | 25 |
색이 진할수록 내적이 큽니다. 주황 테두리(대각선)는 자기 자신과의 내적이며, 표는 대각선을 기준으로 완벽히 대칭입니다.
🧩 구현 관점
Python — 행렬 곱 한 줄로 모든 쌍 계산
import numpy as np

X = np.array([[5, 1],     # 영화A (액션, 로맨스)
              [4, 2],     # 영화B
              [0, 5]])    # 영화C

S = X @ X.T               # 모든 쌍의 내적을 한 번에!
print("유사도 행렬 S =\n", S)
print("shape:", X.shape, "@", X.T.shape, "→", S.shape)
print()
print("S[0,1] =", S[0, 1], "= A·B =", np.dot(X[0], X[1]))
print("대각선 S[0,0] =", S[0, 0], "= |A|² =", np.dot(X[0], X[0]))
print("대칭인가? S == S.T :", np.array_equal(S, S.T))
🔗 GitHub에서 코드 보기 — 01_05_dot_outer_similarity_matrix.py L79–L91
실행 결과
유사도 행렬 S =
 [[26 22  5]
 [22 20 10]
 [ 5 10 25]]
shape: (3, 2) @ (2, 3) → (3, 3)

S[0,1] = 22 = A·B = 22
대각선 S[0,0] = 26 = |A|² = 26
대칭인가? S == S.T : True
🔎 코드 이해 — 한 줄씩
X.T — 전치. 점 하나로 가 이 됩니다\
X @ X.T — 이 한 줄이 50만 쌍도 처리합니다. 반복문이 전혀 없습니다\
S[0, 1] — 0번째와 1번째 항목의 내적. 파이썬은 0부터 셉니다\
np.array_equal(S, S.T) — 대칭성 확인. True가 나와야 정상입니다
📖 코드 설명 — 표를 읽는 세 가지 눈
①
S[0,1] = 22가 손으로 구한 A·B와 같습니다 — 행렬 곱이 정말 내적을 모아 놓은 것임을 확인\
② 대각선26, 20, 25는 각자의 길이의 제곱. 값이 클수록 그 항목의 점수 규모가 큽니다\
③S == S.T가True— 절반만 계산해도 되는 대칭 구조이며, 실무에서는 이를 이용해 계산량을 아낍니다
6단계 🔵 코사인 유사도 행렬 — 추천 시스템을 굴려 보다
5단계의 에는 2단계에서 본 크기의 함정이 그대로 남아 있습니다. 대각선 값이 26, 20, 25로 제각각인 것이 그 증거입니다. 이제 두 단계를 합칩니다.
📐 수학적 의미 — 먼저 정규화, 그다음 한 번에
1단계 각 행을 자기 길이로 나눕니다: (모든 행의 길이가 1이 됨)\
2단계 정규화된 행렬끼리 곱합니다:길이가 이미 1이므로 내적이 곧 코사인 유사도가 됩니다(2단계 표의 마지막 줄). 항목이 100만 개여도 나눗셈 한 번 + 곱셈 한 번이면 끝납니다.
🔗 01-03에서 배운 단위벡터가 바로 이 정규화입니다. 그때 배운 이 여기서 실전에 쓰입니다.
💡 직관적 의미 — 결과 표가 확 달라집니다
| 항목 | 내적 행렬 | 코사인 행렬 |
|---|---|---|
| 값의 범위 | 제한 없음 (0 ~ ∞) | −1 ~ 1 |
| 대각선 | 제각각 (26, 20, 25) | 모두 1.000 |
| 비교 가능성 | 크기에 흔들림 | 공정한 비교 |
대각선이 전부 1.000이라는 것은 "나와 나의 방향은 완전히 같다"는 당연한 사실입니다. 이 대각선을 정상 작동 확인용 신호로 쓰세요. 1이 아니면 정규화가 잘못된 것입니다.
📊 시각화 4 — 코사인 유사도 행렬 (0 ~ 1로 정돈된 표)
| 영화A | 영화B | 영화C | |
|---|---|---|---|
| 영화A | 1.000 | 0.965 | 0.196 |
| 영화B | 0.965 | 1.000 | 0.447 |
| 영화C | 0.196 | 0.447 | 1.000 |
길이의 영향을 지운 뒤라 대각선이 모두 1.000이고, 모든 값이 0~1 사이에 놓입니다.
🧩 구현 관점 — 추천 한 줄 완성
Python — 코사인 유사도 행렬과 추천
import numpy as np

X = np.array([[5, 1], [4, 2], [0, 5]])
이름 = ["영화A", "영화B", "영화C"]

크기 = np.linalg.norm(X, axis=1, keepdims=True)   # 각 행의 길이
X_정규화 = X / 크기                                # 길이를 1로 맞춤
C = X_정규화 @ X_정규화.T                          # 코사인 유사도 행렬

print("각 행의 크기:\n", 크기.round(4))
print("\n코사인 유사도 행렬:\n", C.round(3))

기준 = 0
후보 = [(C[기준, j], 이름[j]) for j in range(3) if j != 기준]
print(f"\n{이름[기준]}와 가장 비슷한 영화 →", max(후보)[1], f"(유사도 {max(후보)[0]:.3f})")
🔗 GitHub에서 코드 보기 — 01_05_dot_outer_similarity_matrix.py L95–L109
실행 결과
각 행의 크기:
 [[5.099 ]
 [4.4721]
 [5.    ]]

코사인 유사도 행렬:
 [[1.    0.965 0.196]
 [0.965 1.    0.447]
 [0.196 0.447 1.   ]]

영화A와 가장 비슷한 영화 → 영화B (유사도 0.965)
🔎 코드 이해 — 한 줄씩
axis=1 — 행 방향으로 계산하라는 뜻. 각 행(항목)의 길이를 따로 구합니다\
keepdims=True — 결과를 모양으로 유지합니다. 이래야 행마다 다른 값으로 나누기가 됩니다\
X / 크기 — 브로드캐스팅. 를 로 나누면 각 행이 자기 길이로 나뉩니다\
[... for j in range(3) if j != 기준] — 리스트 컴프리헨션. 자기 자신(유사도 1)을 빼고 후보를 모읍니다\
max(후보) — (값, 이름) 쌍의 목록에서 값이 가장 큰 쌍을 고릅니다
📖 코드 설명 — 방금 추천 엔진을 만들었습니다
대각선이 전부
1.이고, 영화A의 추천 결과로 영화B(0.965)가 나왔습니다. 2단계에서 내적이 잘못 골랐던 그 문제가 완전히 해결된 것입니다.놀라운 사실은 이 열 몇 줄이 넷플릭스·유튜브 추천의 핵심 골격과 같다는 점입니다. 실무에서는 영화가 수백만 개이고 특징이 수백 차원일 뿐, 연산은 정확히 이것입니다.
⚠️ 자기 자신 제외를 잊지 마세요. 대각선은 항상 1이라서, 빼놓지 않으면 "영화A와 가장 비슷한 영화는 영화A"라는 무의미한 답이 나옵니다. 실무에서 가장 흔한 버그 중 하나입니다.
7단계 🔵🚀 어텐션 — AI는 왜 이 거대한 표를 만드는가 (응용 복잡성 격파)
"ChatGPT가 문맥을 이해한다"는 말은 신비롭게 들립니다. 그러나 그 첫걸음은 여러분이 방금 만든 영화 추천 표와 완전히 같은 연산입니다. 영화가 단어로, 액션·로맨스 점수가 의미를 나타내는 수백 개의 숫자로 바뀌었을 뿐입니다.
🔍 더 쉽게 이해하기 — 도서관 사서 비유
"그 동물은 배가 고파서 그것을 먹었다"에서 '그것'이 무엇인지 알려면, 문장 안의 다른 단어들을 둘러봐야 합니다. 어텐션은 단어마다 도서관 사서를 한 명씩 붙여 주는 장치입니다.
🙋 Query (질문) — "나는 이런 걸 찾고 있어요" (사서에게 건네는 요청서)\
🏷️ Key (색인) — "저는 이런 걸 담고 있어요" (책등에 붙은 라벨)\
📖 Value (내용) — 실제로 가져올 알맹이 (책의 본문)사서는 요청서(Q)와 라벨(K)을 맞춰 보고, 관련도가 높은 책의 내용(V)을 더 많이 가져옵니다. 그 "맞춰 보는" 작업이 바로 내적이고, 모든 단어 쌍에 대해 한꺼번에 하면 유사도 행렬 가 됩니다.
📐 수학적 의미 — 세 단계로 쪼개 보기
① — 이 장의 5단계 그대로입니다. 모든 단어 쌍의 내적 = 유사도 행렬\
② 와 softmax — 값이 너무 커지지 않게 나눈 뒤, 행마다 합이 1인 비율로 바꿉니다\
③ — 그 비율대로 내용을 섞습니다(가중평균)왜 로 나누나요? 차원이 커질수록 내적의 값이 커지는데(더할 항이 많아지니까요), 그러면 softmax가 한 곳에만 1을 몰아주는 극단적인 상태가 되어 학습이 멈춥니다. 크기를 미리 줄여 그것을 막는 안전장치입니다 — 2단계의 "크기의 함정"이 여기서도 등장하는 셈입니다.
🔗 01-02의 공식 71이 바로 이 식이고, 공식 36(softmax)과 78(어텐션 가중치)이 ②에 해당합니다.
📶 진행 과정 — 단어 3개로 끝까지 계산
단어를 (동물성, 기계성) 2차원으로 채점했다고 해봅시다. 고양이, 야옹, 자동차.
- 로 둡니다 — 같은 문장 안에서 서로를 보므로 셀프 어텐션이라 부릅니다
- 로 모든 쌍의 내적을 구합니다 (5단계와 완전히 같은 계산)
- 로 나눕니다
- 각 행에 softmax를 적용해 합이 1인 비율로 만듭니다
- 그 비율로 를 가중평균해 새 벡터를 얻습니다
📊 시각화 5 — 어텐션 가중치 (각 단어가 누구를 얼마나 보는가)
| 고양이 | 야옹 | 자동차 | |
|---|---|---|---|
| 고양이 | 0.742 | 0.257 | 0.001 |
| 야옹 | 0.663 | 0.327 | 0.010 |
| 자동차 | 0.002 | 0.005 | 0.993 |
각 행의 합이 정확히 1입니다. '고양이' 행은 '야옹'에 0.257을 주지만 '자동차'에는 0.001밖에 주지 않습니다.
🐱 '고양이' 행을 왼쪽에서 오른쪽으로 읽어 보세요 — 자기 자신 0.742, '야옹' 0.257, 자동차 0.001.\
🚗 '자동차' 행은 자기 자신에게 0.993을 몰아줍니다. 문장에서 혼자 떨어져 있다는 뜻입니다.\
👉 모델이 "고양이와 야옹은 관련 있고, 자동차는 아니다"를 스스로 알아냈습니다. 우리가 알려준 적은 없습니다.
🧩 구현 관점 — 어텐션을 처음부터 끝까지
Python — 셀프 어텐션 직접 구현
import numpy as np

단어 = ["고양이", "야옹", "자동차"]
X = np.array([[3.0, 0.0],      # 고양이 (동물성 3, 기계성 0)
              [2.5, 0.5],      # 야옹
              [0.0, 3.0]])     # 자동차

Q = K = V = X                  # 셀프 어텐션: 셋 다 같은 입력에서 출발
d_k = X.shape[1]

scores = Q @ K.T / np.sqrt(d_k)                    # ① 유사도 행렬 + 스케일
exp = np.exp(scores - scores.max(axis=1, keepdims=True))
weights = exp / exp.sum(axis=1, keepdims=True)     # ② 행마다 합이 1이 되게
output = weights @ V                               # ③ 가중평균으로 섞기

print("① 점수 QKᵀ/√d :\n", scores.round(3))
print("\n② 어텐션 가중치 (행 합 = 1):\n", weights.round(3))
print("   행 합 확인:", weights.sum(axis=1).round(6))
for i, w in enumerate(weights):
    w_others = w.copy()
    w_others[i] = -1                               # 자기 자신은 제외
    top = int(np.argmax(w_others))
    print(f"   '{단어[i]}' → 가장 주목한 다른 단어: '{단어[top]}' ({w[top]:.3f})")
print("\n③ 최종 출력:\n", output.round(3))
🔗 GitHub에서 코드 보기 — 01_05_dot_outer_similarity_matrix.py L113–L136
실행 결과
① 점수 QKᵀ/√d :
 [[6.364 5.303 0.   ]
 [5.303 4.596 1.061]
 [0.    1.061 6.364]]

② 어텐션 가중치 (행 합 = 1):
 [[0.742 0.257 0.001]
 [0.663 0.327 0.01 ]
 [0.002 0.005 0.993]]
   행 합 확인: [1. 1. 1.]
   '고양이' → 가장 주목한 다른 단어: '야옹' (0.257)
   '야옹' → 가장 주목한 다른 단어: '고양이' (0.663)
   '자동차' → 가장 주목한 다른 단어: '야옹' (0.005)

③ 최종 출력:
 [[2.868 0.132]
 [2.808 0.192]
 [0.017 2.983]]
🔎 코드 이해 — 한 줄씩
Q = K = V = X — 셋을 같은 값으로 두는 것이 셀프 어텐션. 실제 모델은 각각 다른 가중치를 곱해 만듭니다\
Q @ K.T / np.sqrt(d_k) — 유사도 행렬 + 스케일 조정. 5단계의 와 같은 뼈대\
scores - scores.max(axis=1, keepdims=True) — 각 행의 최댓값을 빼는 오버플로 방지 기법. 결과는 바뀌지 않습니다\
exp / exp.sum(axis=1, keepdims=True) — 행별 softmax. 각 행의 합이 정확히 1이 됩니다\
weights @ V — 비율대로 내용을 섞는 가중평균. 🔗 01-04의 "열 가중합" 관점 그대로\
w_others[i] = -1 — 자기 자신을 후보에서 빼기 위한 마스킹 기법
📖 코드 설명 — 세 개의 출력이 말해 주는 것
① 점수 행렬의
[0,1]=5.303은 높고[0,2]=0.000은 바닥입니다 — 고양이·야옹은 관련, 고양이·자동차는 무관\
② 가중치 행마다 합이 정확히1.입니다 — "관심을 100% 나눠 쓴다"는 뜻\
③ 최종 출력에서 '고양이'는[2.868, 0.132]로, 원래[3.0, 0.0]에서 '야옹' 쪽으로 살짝 이동했습니다. 문맥을 반영해 의미가 업데이트된 것입니다이것이 "문맥을 이해한다"의 수학적 실체입니다. 주변 단어들의 벡터를 관련도만큼 섞어 자기 벡터를 갱신하는 것 — 그 이상도 이하도 아닙니다.
8단계 🔵 실무 감각 — 표가 커지면 무슨 일이 벌어지는가
유사도 행렬에는 치명적인 대가가 하나 따라옵니다. 항목이 개면 표의 칸은 개라는 사실입니다.
📈 의 무서움 — 문맥이 길어질수록 비싸지는 이유
| 단어 수 | 표의 칸 수 | 체감 |
|---|---|---|
| 100 | 10,000 | 가볍습니다 |
| 1,000 | 1,000,000 | 10배 늘렸더니 100배 |
| 10,000 | 100,000,000 | 1억 칸 — 메모리 압박 |
긴 문서를 넣을수록 AI 서비스 요금이 급격히 오르고 속도가 느려지는 이유가 바로 이것입니다. 단어 수에 비례가 아니라 제곱으로 늘기 때문입니다. FlashAttention·희소 어텐션 같은 최신 기법들은 전부 이 을 줄이려는 시도입니다.
🛡 실무에서 쓰는 세 가지 요령
① 미리 정규화해 저장 — 벡터를 넣을 때 길이를 1로 맞춰 두면, 이후로는 빠른 내적만으로 코사인 유사도를 얻습니다\
② 전체 표를 만들지 않기 — 100만 개 중 상위 10개만 필요하다면 근사 최근접 이웃(ANN) 검색을 씁니다. 벡터 DB가 하는 일입니다\
③ 대칭성 활용 — 이므로 절반만 계산해도 됩니다
🧭 프레임워크 관점
| 개념 | NumPy | PyTorch | scikit-learn |
|---|---|---|---|
| 내적 | np.dot(a, b) | torch.dot(a, b) | — |
| 벡터 외적 | np.cross(a, b) | torch.cross(a, b) | — |
| 외적(outer) | np.outer(a, b) | torch.outer(a, b) | — |
| 유사도 행렬 | X @ X.T | X @ X.T | cosine_similarity(X) |
| 어텐션 | 직접 구현 | F.scaled_dot_product_attention | — |
scikit-learn의 cosine_similarity(X) 한 줄은 이 장의 6단계를 통째로 대신합니다. 하지만 그 안에서 무슨 일이 일어나는지 아는 것과 모르는 것은, 결과가 이상할 때 완전히 다른 대응으로 이어집니다.
✏️ 실습
실습 1 (손 계산). , 의 내적과 코사인 유사도를 손으로 구하세요.\
→ 내적 , , , 코사인 (정확히 45°)
실습 2 (함정 재현). 영화 C를 에서 으로 바꿔도 코사인 유사도는 그대로인지 코드로 확인하세요. 내적은 어떻게 되나요?
실습 3 (외적 구분). , 에 대해 np.dot, np.cross, np.outer를 모두 실행하고 각각의 .shape을 출력해 비교하세요.
실습 4 (나만의 추천). 좋아하는 영화 5편을 (액션, 로맨스, 코미디) 점수로 적고 코사인 유사도 행렬을 만들어, 각 영화와 가장 비슷한 영화를 찾아보세요.
실습 5 (어텐션 변형). 7단계 코드에서 np.sqrt(d_k)로 나누는 부분을 지우면 가중치가 어떻게 변하는지 확인하세요. 왜 스케일 조정이 필요한지 눈으로 보게 됩니다.
📝 연습문제
[개념 문제] 내적 · 벡터 외적 · 외적(outer)을 "무엇을 넣으면 무엇이 나오는가"로 각각 한 문장씩 구분해 설명하시오. 또 내적과 외적(outer)의 결정적 차이를 계산 절차 관점에서 말하시오.
[계산 문제] 일 때 를 구하고, 의 대각선이 무엇을 의미하는지 설명하시오.
[구현 문제] 위 의 코사인 유사도 행렬을 구하는 NumPy 코드를 세 줄 이내로 작성하시오.
[사고 확장 문제] 어텐션에서 softmax를 행 방향으로 적용하는 이유는 무엇인가? 만약 열 방향으로 적용하면 의미가 어떻게 달라지는가?
💡 해설 보기
개념 문제 — 내적: 벡터 2개 → 숫자 1개(방향 일치도). 벡터 외적: 3차원 벡터 2개 → 두 벡터에 수직인 3차원 벡터. 외적(outer): 벡터 2개 → 행렬.\
계산 절차의 차이는 마지막에 더하느냐입니다. 내적은 곱한 뒤 모두 더해 하나로 뭉치고, 외적은 곱한 결과를 더하지 않고 그대로 펼칩니다.\
\
계산 문제 — 행은 각각 , , 입니다.\은 1행과 2행이 직교한다는 뜻이고, 대각선 는 각 행의 길이의 제곱입니다().\
\
구현 문제 —\
X = np.array([[1,0],[0,1],[1,1]])\
Xn = X / np.linalg.norm(X, axis=1, keepdims=True)\
C = Xn @ Xn.T\
\
사고 확장 문제 — 어텐션 행렬의 행은 "번째 단어가 다른 단어들을 얼마나 볼지"를 담습니다. 한 단어가 나눠 쓸 관심의 총량을 100%로 정해야 하므로 행 방향 softmax가 맞습니다.\
열 방향으로 적용하면 "번째 단어가 다른 단어들에게 얼마나 보여질지"의 비율이 되어, 의미가 완전히 뒤바뀝니다. 실제로 이 축을 헷갈리는 것이 어텐션 구현에서 가장 흔한 버그이며, 행 합이 1인지 확인하는 것으로 즉시 잡을 수 있습니다.
⚠️ 실수하기 쉬운 부분
① 내적 값만 보고 "비슷하다"고 결론 낸다\
왜 틀리는가? 값이 크기에 휘둘립니다(2단계의 영화 C).\
올바른 수정 — 크기가 제각각인 데이터라면 반드시 코사인을 쓰거나 미리 정규화하세요.② 두 종류의 "외적"을 뒤섞는다\
왜 틀리는가? 한국어 번역이 같습니다.\
올바른 수정 —np.cross(벡터가 나옴)와np.outer(행렬이 나옴)를 결과의 shape으로 구분하세요.③ 추천에서 자기 자신을 빼지 않는다\
왜 틀리는가? 대각선은 항상 1(또는 최댓값)입니다.\
올바른 수정 — 후보에서 자기 인덱스를 제외하거나, 대각선을-1로 덮어쓰세요.④ 정규화 방향(axis)을 틀린다\
왜 틀리는가?axis=0은 열 방향,axis=1은 행 방향입니다.\
올바른 수정 — 항목이 행에 있으면axis=1입니다. 대각선이 전부 1인지 확인하면 즉시 검증됩니다.⑤ 와 를 혼동한다\
왜 틀리는가? 둘 다 정사각 행렬이라 그럴듯해 보입니다.\
올바른 수정 — 는 (항목 × 항목) 유사도이고, 는 (특징 × 특징) 관계(공분산 계열)입니다. 결과 크기를 보면 바로 구분됩니다.
🛠️ 디버깅 팁
☐ 코사인 유사도 행렬의 대각선이 모두 1인가? 아니면 정규화가 잘못된 것입니다\
☐ 유사도 행렬이 대칭인가? np.allclose(S, S.T)로 확인하세요\
☐ 값이 −1 ~ 1 범위를 벗어났는가? 분모(길이) 계산을 다시 보세요\
☐ 어텐션 가중치의 행 합이 1인가? weights.sum(axis=1)을 찍어 보세요\
☐ np.outer의 결과가 예상 shape인가? 이어야 합니다\
☐ 영벡터(길이 0)를 정규화하고 있지 않은가? 0으로 나누기가 발생합니다 — 🔗 01-02의 을 더해 막습니다\
☐ np.cross에 2차원 벡터를 넣지 않았는가? 벡터 외적은 3차원 전용입니다
🎯 이 장에서 배운 내용
내적은 방향 일치도를 숫자 하나로 압축하지만 길이에 휘둘리므로 코사인 유사도로 바로잡습니다. 벡터 외적은 수직 방향을, 외적(outer)은 행렬을 만듭니다. 그리고 한 줄이면 모든 쌍의 관계가 표 한 장으로 나오며, 이 표가 곧 추천 시스템이자 어텐션의 입니다.
📌 핵심 문장 3가지
① 내적은 각도를 말하고, 코사인은 거기서 길이의 착시를 지운다.\
② 세 가지 곱은 이름이 아니라 결과의 모양(숫자·벡터·행렬)으로 구분한다.\
③ 는 모든 쌍의 내적표이며, ChatGPT의 도 정확히 같은 연산이다.
🧱 여섯 개의 벽, 다시 확인
✅ 내적의 기계적 계산 → 성분식과 기하식이 같은 값임을 코드로 확인했습니다\
✅ 내적의 크기 혼란 → 내적이 실제로 틀린 추천을 하는 장면을 보고 코사인으로 고쳤습니다\
✅ 외적의 차원 변화 → 병뚜껑·오른손으로 방향을, 평행사변형으로 크기를 잡았습니다\
✅ 외적의 정의 혼재 → 세 가지 곱을 입출력 모양으로 한 표에 정리했습니다\
✅ 유사도 행렬의 압축 → 대각선 → 대칭 → 한 줄 읽기 순서로 표 읽는 법을 익혔습니다\
✅ 응용의 복잡성 → 단어 3개짜리 어텐션을 처음부터 끝까지 손과 코드로 계산했습니다
✅ 개념 체크리스트 (성취 기준)
☐ 내적을 성분식과 기하식 두 가지로 계산하고 같음을 보일 수 있다\
☐ 내적이 크기에 휘둘리는 사례를 들고 코사인으로 해결할 수 있다\
☐ 벡터 외적의 방향(수직)과 크기(넓이)를 설명할 수 있다\
☐ 내적 · 벡터 외적 · 외적(outer)을 결과의 모양으로 구분할 수 있다\
☐ 가 왜 모든 쌍의 내적인지 설명할 수 있다\
☐ 유사도 행렬의 대각선과 대칭성이 무엇을 뜻하는지 말할 수 있다\
☐ 코사인 유사도 행렬로 가장 비슷한 항목을 찾을 수 있다\
☐ 어텐션의 ·softmax· 세 단계를 설명할 수 있다
🔁 실수 방지 체크리스트
☐ 크기가 제각각인 데이터에 내적을 그대로 쓰지 않았는가?\
☐ np.cross와 np.outer를 결과 shape으로 구분했는가?\
☐ 추천에서 자기 자신(대각선)을 제외했는가?\
☐ 정규화 axis가 항목 방향(행)이 맞는가?\
☐ 와 를 혼동하지 않았는가?\
☐ 어텐션 softmax를 행 방향으로 적용했는가?\
☐ 수식의 기호()가 코드 변수명과 일치하는가?
📖 추가 학습
• 직접 구현: 이중 for 반복문으로 유사도 행렬을 만들고, X @ X.T와 결과가 같은지 · 속도가 얼마나 차이 나는지 재 보세요\
• 실전 데이터: 뉴스 기사 몇 편을 단어 빈도 벡터로 만들어 코사인 유사도로 묶어 보세요(간단한 문서 군집화)\
• PyTorch 비교: 7단계 코드를 F.scaled_dot_product_attention으로 바꿔 결과가 같은지 확인해 보세요\
• 심화: 🔗 01-02의 공식 51(내적), 68(코사인), 71(어텐션), 78(어텐션 가중치)을 다시 읽어 보세요. 이제 전부 읽힐 것입니다
🔜 다음 절 예고 — 01-05-01. 텐서(Tensor)란 뭘까
지금까지 숫자 한 줄(벡터)과 숫자 표(행렬)를 다뤘습니다. 그런데 컬러 사진 한 장은 표 3장을 겹친 것이고, 사진 32장 묶음은 그것을 또 한 번 쌓은 것입니다.
다음 절에서는 이렇게 몇 겹이든 쌓을 수 있는 숫자 상자, 텐서를 만납니다. 딥러닝 코드에서 가장 자주 만나는
shape오류가 이 차원 감각 하나로 풀립니다.
💻 GitHub 실습 — 코드로 직접 확인하기
📂 이 장의 코드 폴더: book/01-ml-math-basics-python/01-05-dot-outer-similarity-matrix
책에 실린 코드를 장(절)별로 모아 둔 폴더입니다. 아래 파일을 열어 보거나, Colab에서 바로 실행해 보세요.
| 파일 | 용도 | 링크 |
|---|---|---|
01_05_dot_outer_similarity_matrix.py | 책의 코드 블록 7개를 순서대로 모은 실행 스크립트 (# %% 셀 구분) | 코드 보기 |
01_05_dot_outer_similarity_matrix.ipynb | 같은 코드를 블록당 셀 1개로 담은 주피터 노트북 | 보기 · Colab |
README.md | 코드 블록 목록 · 실행 방법 · 검증 결과 | 보기 |
01-05-01-tensors/ | 하위 절 코드 폴더 | 폴더 |
🎬 medium-series/14-dot-cross-outer-similarity/ | Medium 시리즈 예제 — 같은 주제를 블로그용으로 다듬은 실습 | 폴더 · Colab |
🧪 저장소 검증 상태: ✅ 실행 OK
🔑 핵심 코드 1 — 유사도 행렬 S = X @ X.T — 모든 쌍의 내적을 한 번에
📄 01_05_dot_outer_similarity_matrix.py L79–L91 · Block 5 (5단계 🔵⭐ 유사도 행렬 — 모든 쌍을 한 번에 (관계 압축 격파))
import numpy as np

X = np.array([[5, 1],     # 영화A (액션, 로맨스)
              [4, 2],     # 영화B
              [0, 5]])    # 영화C

S = X @ X.T               # 모든 쌍의 내적을 한 번에!
print("유사도 행렬 S =\n", S)
print("shape:", X.shape, "@", X.T.shape, "→", S.shape)
print()
print("S[0,1] =", S[0, 1], "= A·B =", np.dot(X[0], X[1]))
print("대각선 S[0,0] =", S[0, 0], "= |A|² =", np.dot(X[0], X[0]))
print("대칭인가? S == S.T :", np.array_equal(S, S.T))
▶ 실행 결과 — 위 코드를 실행한 출력 (직접 실행: Linux · Python 3.13.5 · numpy 2.5.3, 앞 블록부터 순서대로 실행)
유사도 행렬 S =
 [[26 22  5]
 [22 20 10]
 [ 5 10 25]]
shape: (3, 2) @ (2, 3) → (3, 3)

S[0,1] = 22 = A·B = 22
대각선 S[0,0] = 26 = |A|² = 26
대칭인가? S == S.T : True
🔑 핵심 코드 2 — 셀프 어텐션 — QKᵀ/√d_k, softmax, 가중평균
📄 01_05_dot_outer_similarity_matrix.py L113–L136 · Block 7 (7단계 🔵🚀 어텐션 — AI는 왜 이 거대한 표를 만드는가 (응용 복잡성 격파))
import numpy as np

단어 = ["고양이", "야옹", "자동차"]
X = np.array([[3.0, 0.0],      # 고양이 (동물성 3, 기계성 0)
              [2.5, 0.5],      # 야옹
              [0.0, 3.0]])     # 자동차

Q = K = V = X                  # 셀프 어텐션: 셋 다 같은 입력에서 출발
d_k = X.shape[1]

scores = Q @ K.T / np.sqrt(d_k)                    # ① 유사도 행렬 + 스케일
exp = np.exp(scores - scores.max(axis=1, keepdims=True))
weights = exp / exp.sum(axis=1, keepdims=True)     # ② 행마다 합이 1이 되게
output = weights @ V                               # ③ 가중평균으로 섞기

print("① 점수 QKᵀ/√d :\n", scores.round(3))
print("\n② 어텐션 가중치 (행 합 = 1):\n", weights.round(3))
print("   행 합 확인:", weights.sum(axis=1).round(6))
for i, w in enumerate(weights):
    w_others = w.copy()
    w_others[i] = -1                               # 자기 자신은 제외
    top = int(np.argmax(w_others))
    print(f"   '{단어[i]}' → 가장 주목한 다른 단어: '{단어[top]}' ({w[top]:.3f})")
print("\n③ 최종 출력:\n", output.round(3))
▶ 실행 결과 — 위 코드를 실행한 출력 (직접 실행: Linux · Python 3.13.5 · numpy 2.5.3, 앞 블록부터 순서대로 실행)
① 점수 QKᵀ/√d :
 [[6.364 5.303 0.   ]
 [5.303 4.596 1.061]
 [0.    1.061 6.364]]

② 어텐션 가중치 (행 합 = 1):
 [[0.742 0.257 0.001]
 [0.663 0.327 0.01 ]
 [0.002 0.005 0.993]]
   행 합 확인: [1. 1. 1.]
   '고양이' → 가장 주목한 다른 단어: '야옹' (0.257)
   '야옹' → 가장 주목한 다른 단어: '고양이' (0.663)
   '자동차' → 가장 주목한 다른 단어: '야옹' (0.005)

③ 최종 출력:
 [[2.868 0.132]
 [2.808 0.192]
 [0.017 2.983]]
☁️ Colab에서 바로 실행
👉 Open in Colab — 01_05_dot_outer_similarity_matrix.ipynb · 설치 없이 브라우저에서 셀을 위에서부터 순서대로 실행하세요.
🖥️ 내 컴퓨터에서 실행하기
git clone https://github.com/otoloism/Zero_to_ML_Master.git
cd Zero_to_ML_Master
python -m venv .venv
source .venv/bin/activate          # Windows: .venv\Scripts\activate
pip install -r book/requirements.txt   # 책 전체용 (PyTorch 등 포함, 용량 큼)
# 이 장만 실행한다면 이것만으로 충분합니다: pip install numpy
cd book/01-ml-math-basics-python/01-05-dot-outer-similarity-matrix
python 01_05_dot_outer_similarity_matrix.py
⭐ GitHub Star / Fork
⭐ 코드가 도움이 되셨다면 GitHub 저장소에 Star를 눌러 주세요. 새 장의 코드가 올라올 때 가장 먼저 알 수 있습니다.
🍴 직접 고쳐 보며 실험하고 싶다면 Fork 해서 내 저장소에서 마음껏 바꿔 보세요. 오류 제보·개선 제안은 Issues로 환영합니다!
🔮 다음 글 예고
다음 글은 01-05-01 텐서(Tensor)란 뭘까 — 숫자 상자의 차원 여행 📦 입니다. 스칼라·벡터·행렬을 넘어 3차원·4차원 숫자 상자로, 이미지 배치와 딥러닝 프레임워크가 다루는 텐서의 shape를 파이썬으로 확인합니다.
⬅️ 이전 글: #15 행렬의 두 얼굴 — 숫자 표이자 공간을 움직이는 함수, AB ≠ BA인 이유까지 (파이썬 NumPy) \
➡️ 다음 글: #17 텐서(Tensor)란? 스칼라·벡터·행렬부터 이미지 배치까지 — rank·shape·reshape 쉽게 이해하기 (NumPy·PyTorch)
📚 더 깊이 공부하고 싶다면
이 시리즈는 수학을 놓았던 비전공자가 AI를 직접 구현하기까지의 공부 기록을 그대로 옮긴 연재입니다. 원문 책, 코드, 개념 사전을 함께 보면 훨씬 빨리 늡니다. 🚀
| 바로가기 | 이런 분께 | |
|---|---|---|
| 📘 책 (위키독스, 무료) | Zero to 머신러닝 딥러닝 Master | 5권 · 20개 장 · 163개 절 전체를 순서대로 읽고 싶은 분 |
| 📄 이 글의 원문 | 01-05 행렬내적·외적·유사도 행렬 | 연습문제·해설까지 전부 보고 싶은 분 |
| 💻 실습 코드 (GitHub) | otoloism/Zero_to_ML_Master | .py·.ipynb를 Colab에서 바로 돌려보고 싶은 분 |
| 🏠 머신러닝 백과사전 | mldict.net | 본문 속 핵심 개념을 카드로 다시 확인하고 싶은 분 |
| ✍️ 기술 블로그 | wikidocs.net/blog/@mldict | 새 글 알림을 가장 먼저 받고 싶은 분 |
⭐ 도움이 되셨다면 velog 팔로우와 GitHub Star를 눌러 주세요. 다음 글을 쓰는 가장 큰 힘이 됩니다. 궁금한 점은 댓글로 편하게 남겨 주세요! 🙌